Jika Anda pernah mendengar narasi YouTube yang mulus atau pelajaran e-learning yang jernih dan bertanya-tanya apakah seseorang benar-benar merekamnya, Anda sudah bertemu dengan teknologi di balik pertanyaan ini. Apa itu generator suara AI? Secara sederhana, ini adalah perangkat lunak yang mengubah teks tertulis atau referensi audio menjadi audio ucapan menggunakan model pembelajaran mesin, sehingga Anda dapat memproduksi narasi tanpa menyewa studio, mikrofon, atau pengisi suara untuk setiap perubahan naskah. Kemampuan tunggal itu mengubah cara kreator, pemasar, pembuat kursus, dan pengembang merencanakan pekerjaan audio mereka.
Panduan ini menjelaskan apa itu generator suara AI sebenarnya, bagaimana ia menghasilkan ucapan, bagaimana kaitannya dengan text to speech dan kloning suara, serta kriteria yang benar-benar penting saat Anda memilihnya. Kami fokus pada keputusan, bukan hype: realisme saja adalah alasan yang lemah untuk memilih sebuah alat, karena kontrol pelafalan, cakupan bahasa, hak penggunaan, dan privasi biasanya yang menentukan apakah sebuah proyek dapat diluncurkan dengan mulus.
Daftar isi
Bagaimana generator suara AI benar-benar menghasilkan ucapan
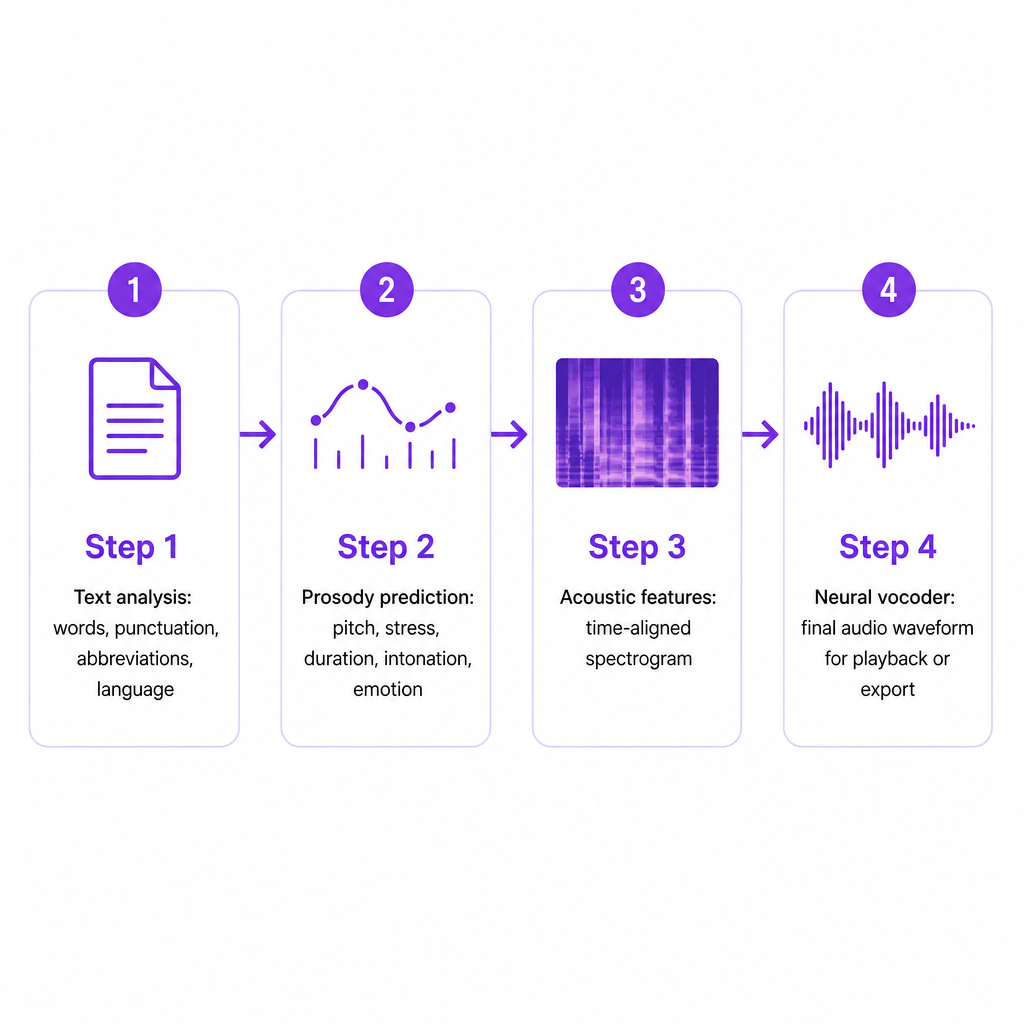
Sebagian besar generator suara AI berjalan pada model text-to-speech, atau TTS, dan prosesnya terjadi dalam dua tahap besar: sistem menganalisis teks Anda, lalu mensintesis audio dari analisis tersebut. IBM menggambarkan sistem TTS sebagai menganalisis kata, tanda baca, struktur kalimat, pelafalan, pengaturan waktu, dan prosodi sebelum mengonversi hasilnya menjadi gelombang audio.
Pada tahap analisis, model membaca lebih dari sekadar huruf mentah. Model mengidentifikasi batas kalimat, tanda baca dan jeda, singkatan dan angka, serta bahasa atau aksen yang dimaksud. Hal ini penting karena teks tertulis jarang memberi tahu Anda bagaimana seharusnya terdengar. "Dr." mungkin perlu menjadi "Dokter," dan nama produk atau akronim teknis mungkin memerlukan pelafalan kustom yang tidak akan ditebak oleh aturan default mana pun.
Berikutnya, model memprediksi penyampaian: nada, tekanan, durasi fonem, ritme, intonasi, dan nada emosional. Secara kolektif, ini disebut prosodi, dan inilah yang membedakan pembacaan datar dari narasi yang membedakan pertanyaan dari pernyataan. Sistem kemudian mengonversi analisis itu menjadi fitur akustik yang selaras waktu, sering direpresentasikan sebagai spektrogram yang memetakan perubahan frekuensi dari waktu ke waktu.
Akhirnya, vocoder neural mengubah fitur akustik tersebut menjadi gelombang audio digital yang dapat diputar atau diekspor oleh editor Anda. IBM mencatat bahwa sistem TTS neural mempelajari hubungan antara bahasa dan fitur akustik dari data pelatihan yang berisi rekaman dan transkripsi yang cocok. Jika Anda ingin mekanisme yang lebih mendalam dari tahap ini, penjelasan kami tentang bagaimana text to speech neural bekerja menguraikan alurnya lebih jauh.
Generator suara AI vs text to speech vs kloning suara
Istilah-istilah ini berjalan bersama, jadi orang menganggapnya sama. Padahal tidak, dan perbedaannya mengubah apa yang dapat Anda lakukan secara legal dan praktis dengan outputnya.
| Teknologi | Apa yang dilakukannya | Input tipikal | Paling cocok untuk |
|---|---|---|---|
| Generator suara AI | Istilah payung untuk perangkat lunak yang membuat ucapan sintetis | Teks, pengaturan suara, atau referensi audio | Sulih suara, narasi, asisten, konten |
| Text to speech | Mengonversi naskah tertulis menjadi audio ucapan | Naskah tertulis | Narasi, aksesibilitas, e-learning, podcast |
| Kloning suara | Membangun suara sintetis yang dimodelkan pada pembicara tertentu | Rekaman suara yang diotorisasi | Narasi merek atau kreator yang konsisten, karakter |
| Speech to speech | Menciptakan ulang audio ucapan sambil mempertahankan penyampaian | Ucapan terekam | Dubbing, konversi suara, transfer pertunjukan |
| AI dubbing | Menerjemahkan dan menyulihsuarakan media yang sudah ada dalam bahasa lain | Video atau audio | Publikasi multibahasa dan lokalisasi |
Perbedaan praktisnya terletak pada input dan izin yang melekat padanya. Suara TTS standar dipilih dari pustaka penyedia, jadi Anda dapat langsung menggunakannya. Suara kloning dibangun dari rekaman orang tertentu, yang berarti persetujuan dan hak penggunaan ikut berperan sebelum Anda menghasilkan satu kata pun. Memperlakukan keduanya sebagai dapat dipertukarkan adalah kesalahan pemula yang paling umum, dan itulah yang memiliki konsekuensi hukum terbesar.
Apa yang bisa Anda buat dengannya
Rentang outputnya luas: narasi YouTube, sulih suara media sosial pendek, intro podcast, draf buku audio, demo produk, pelajaran kursus online, modul pelatihan korporat, video penjelasan, dialog game, prompt layanan pelanggan, audio aksesibilitas, dan versi multibahasa dari semua yang di atas.
Nilainya melonjak tajam ketika konten sering berubah, membutuhkan beberapa bahasa, atau memerlukan beberapa versi untuk audiens yang berbeda. Bisnis kecil dapat menulis satu naskah produk dan menghasilkan varian lokal. Kreator YouTube dapat mengganti pengantar yang direvisi tanpa merekam ulang seluruh video. Tim e-learning dapat memperbarui pelajaran setelah mengedit beberapa kalimat, alih-alih memesan ulang narator. Jika audio Anda diproduksi sekali dan tidak pernah disentuh lagi, generator kurang membantu; jika sering berubah, sangat membantu. Panduan langkah demi langkah kami tentang mengonversi text to speech secara online dengan cepat menunjukkan bagaimana draf pertama itu tersusun dalam praktik.
Jenis umum suara yang dihasilkan AI
Tidak setiap opsi suara memiliki biaya penyiapan yang sama atau kewajiban hak yang sama, jadi ada baiknya memisahkan tiga kategori praktis sebelum Anda memutuskan.
Suara bawaan adalah suara sintetis siap pakai yang disediakan oleh platform, biasanya diurutkan berdasarkan gaya, penampilan gender, rentang usia, aksen, bahasa, energi, dan jenis narasi. Suara ini tersedia secara instan dan tidak memerlukan dokumen persetujuan, yang menjadikannya default yang tepat ketika kecepatan dan konsistensi lebih penting daripada mencocokkan satu orang tertentu.
Suara kustom atau kloning dihasilkan dari rekaman pembicara tertentu, sehingga kreator, merek, atau organisasi dapat mempertahankan satu narator yang dikenali di banyak video. Karena suara dapat terikat pada identitas dan reputasi seseorang yang nyata, kloning hanya boleh dilakukan dengan izin yang diinformasikan dari pembicara dan sesuai aturan penggunaan penyedia.
Suara karakter dan ekspresif menargetkan penceritaan, game, animasi, atau pemasaran, dan sering kali menyediakan kontrol yang lebih halus atas tempo, penekanan, emosi, dan gaya berbicara. Ekspresivitas dapat meningkatkan keterlibatan, tetapi harus sesuai dengan pekerjaannya: pembacaan dramatis cocok untuk trailer fiksi dan secara aktif merugikan instruksi medis atau pemberitahuan kepatuhan.
Kriteria yang menentukan alat mana yang cocok
Generator suara AI terbaik bergantung pada output yang Anda butuhkan, bukan pada seberapa bagus klip demo terdengar. Berikut adalah hal yang sebenarnya memisahkan alat yang dapat Anda publikasikan dari alat yang membuat Anda kerepotan.
Kualitas suara, diuji dengan jujur. Jalankan naskah yang representatif melaluinya, bukan kalimat promosi pendek. Sertakan nama, terminologi, tanda baca, dan panjang kalimat yang nyata dari proyek Anda, lalu dengarkan nama yang salah diucapkan, jeda yang canggung, penekanan yang tidak alami, kata yang berulang, serta emosi yang datar atau berlebihan.
Cakupan bahasa dan aksen. Pastikan alat mendukung bahasa dan aksen regional yang persis Anda butuhkan. Sebuah platform mungkin mendukung bahasa dalam antarmukanya namun menawarkan lebih sedikit suara atau pelafalan yang lebih lemah di dalamnya. Untuk lokalisasi, periksa juga apakah ia menangani terjemahan, dubbing, konsistensi suara antarbahasa, dan penyelarasan waktu.
Kontrol pelafalan dan penyampaian. Anda memerlukan cara yang andal untuk memperbaiki nama, akronim, dan angka melalui kamus pelafalan, ejaan fonetik, atau format yang dapat diedit, ditambah kontrol untuk kecepatan, jeda, penekanan, nada, intonasi, dan penyampaian emosional. Alat Text to Speech kami memungkinkan Anda memilih dari 300+ suara AI, menyesuaikan laju bicara, menambahkan emosi melalui tag dialog, menekankan kata, dan menuliskan angka secara lengkap ketika pelafalan perlu dikoreksi.
Opsi pengeditan, ekspor, dan API. Editor berbasis browser mungkin cukup untuk kreator. Pengembang dan agensi sering lebih peduli dengan menghasilkan audio secara otomatis di dalam aplikasi atau alur video, di mana autentikasi, format yang didukung, generasi sinkron versus asinkron, batas laju, dan harga yang dapat diprediksi semuanya penting. Jika Anda mempertimbangkan penggunaan programatik, pengantar kami tentang apa itu voice AI API membahas poin-poin evaluasi tersebut secara rinci.
Hak komersial dan ketentuan penggunaan. Sebelum memublikasikan, pastikan apakah penggunaan komersial diizinkan, apakah audio dapat ditayangkan dalam iklan berbayar, apakah kloning memerlukan dokumentasi persetujuan, dan apakah lisensi berubah setelah langganan berakhir. Jangan berasumsi bahwa paket gratis memberikan hak komersial tanpa batas.
Privasi dan penanganan data. Rekaman suara dapat membawa informasi biometrik, pribadi, atau komersial yang sensitif. Tinjau durasi penyimpanan, kontrol penghapusan, enkripsi, dan kebijakan data pelatihan, terutama untuk rekaman karyawan, panggilan pelanggan, media yang belum dirilis, dan suara kloning.
Keterbatasan dan risiko yang patut dianggap serius
Pembuatan suara AI berguna, tetapi tidak sempurna, dan beberapa risiko layak mendapat perhatian nyata.
Kesalahan pelafalan dan konteks adalah hal rutin: model salah membaca nama, homograf, angka, dan istilah industri, sehingga konten hukum, keuangan, medis, pendidikan, dan teknis selalu memerlukan pendengaran menyeluruh sebelum dirilis. Emosi juga bisa meleset; suara dapat terdengar alami kalimat demi kalimat namun memberi penekanan yang salah, yang terbaca mengganggu atau bahkan menyesatkan.
Risiko yang lebih berat melibatkan identitas. Kloning suara dapat disalahgunakan untuk meniru anggota keluarga, eksekutif, atau tokoh publik. Federal Trade Commission memperingatkan bahwa penipu menggunakan suara kloning untuk membuat permintaan uang atau informasi pribadi terdengar lebih meyakinkan, dan merekomendasikan untuk secara independen menghubungi pembicara yang diduga melalui nomor tepercaya atau saluran lain yang dikenal. NIST serupa mengidentifikasi konten sintetis, termasuk audio, sebagai materi yang dapat digunakan untuk menyesatkan orang atau mendukung penipuan, termasuk upaya untuk mengalahkan autentikasi biometrik.
Itu mengarah pada seperangkat tanggung jawab praktis: hasilkan suara hanya dari teks dan rekaman yang Anda berwenang gunakan, dapatkan persetujuan yang jelas sebelum mengkloning siapa pun, simpan catatan izin, dan jangan pernah menggunakan suara kloning untuk menipu. Periksa fakta naskah sebelum generasi akhir, ungkapkan narasi sintetis ketika transparansi sesuai atau diperlukan, lindungi rekaman yang diunggah, dan tugaskan peninjau manusia untuk konten berdampak tinggi. Otomatisasi menghasilkan audio; ia tidak menjamin akurasi, kesesuaian budaya, atau keamanan.
Suara AI atau pengisi suara manusia?
Keduanya bukan pengganti otomatis, dan jawaban yang jujur untuk banyak tim adalah "keduanya, untuk pekerjaan yang berbeda."
| Pertimbangan | Generator suara AI | Pengisi suara manusia |
|---|---|---|
| Kecepatan produksi | Cepat untuk revisi dan beberapa versi | Membutuhkan penjadwalan dan perekaman |
| Struktur biaya | Biasanya berdasarkan penggunaan atau langganan | Biaya talenta dan studio |
| Konsistensi | Dapat diulang dalam volume besar | Bergantung pada kondisi dan arahan |
| Nuansa emosional | Terus membaik, bervariasi menurut alat dan naskah | Merespons secara dinamis terhadap arahan |
| Manajemen hak | Membutuhkan tinjauan suara sintetis dan lisensi | Membutuhkan perjanjian talenta dan penggunaan |
| Kasus penggunaan terbaik | Konten volume tinggi, direvisi, multibahasa | Pekerjaan premium dan kompleks secara emosional |
Pembagian yang umum: biarkan suara AI menangani draf, pelatihan internal, versi lokal, dan pembaruan rutin, sementara pemain manusia membawakan kampanye unggulan atau materi yang sensitif secara emosional. Putuskan berdasarkan kebutuhan kualitas, hak, privasi, kapasitas peninjauan, cakupan bahasa, dan total biaya produksi, bukan hanya kemewahan demo. Ketika lokalisasi adalah tujuannya, alur kerja AI Dubbing kami menyulihsuarakan konten yang sudah ada ke dalam 33 bahasa sehingga satu sumber dapat menjangkau beberapa pasar.
Pertanyaan yang sering diajukan
Apa itu generator suara AI secara sederhana?
Ini adalah alat yang membuat audio ucapan dari teks atau input suara lainnya. Sebagian besar berjalan pada model text-to-speech yang dilatih pada rekaman ucapan dan transkripsi untuk menghasilkan narasi sintetis.
Apakah generator suara AI sama dengan text to speech?
Tidak selalu. Text to speech adalah salah satu jenis pembuatan suara AI. Kategori yang lebih luas juga mencakup kloning suara, konversi speech-to-speech, dan AI dubbing.
Bisakah suara AI terdengar seperti manusia?
Suara-suara ini bisa terdengar sangat alami, tetapi kualitasnya bervariasi menurut penyedia, bahasa, suara, naskah, dan penyampaian. Akurasi pelafalan dan emosional masih memerlukan tinjauan manusia sebelum Anda memublikasikan.
Bisakah saya menggunakan suara yang dihasilkan AI di YouTube?
Sering kali ya, asalkan lisensi alat mengizinkan penggunaan yang Anda maksudkan dan konten mengikuti kebijakan YouTube. Periksa ketentuan penggunaan komersial, aturan pengungkapan, dan kebijakan tentang konten yang menyesatkan atau meniru.
Apakah suara yang dihasilkan AI gratis?
Beberapa layanan menawarkan akses gratis atau kredit gratis; yang lain mengenakan biaya berdasarkan karakter, durasi, kredit, langganan, atau penggunaan API. Bandingkan total biaya volume produksi yang Anda harapkan daripada jatah gratis yang diiklankan.