API suara AI adalah koneksi terprogram yang memungkinkan aplikasi Anda membuat, memahami, mengubah, atau melokalkan audio ucapan menggunakan model AI yang tidak perlu Anda bangun sendiri. Anda mengirim teks, audio, atau video ke sebuah endpoint dan mendapatkan sesuatu yang berguna: narasi sintetis, transkrip, suara khusus, atau video yang telah di-dubbing sepenuhnya. Pertanyaan sebenarnya saat Anda memulai bukanlah apakah Anda membutuhkan "suara AI"—melainkan kemampuan suara mana yang sebenarnya dibutuhkan produk Anda, karena pembuatan ucapan, pengenalan ucapan, kloning suara, dan dubbing adalah produk-produk berbeda yang kebetulan berbagi nama kategori yang sama.
Panduan ini membahas apa arti istilah tersebut, jenis-jenis API utama dan perbedaannya, bagaimana sebuah permintaan bergerak melalui pipeline, kriteria keputusan yang memisahkan kecocokan yang baik dari kesalahan yang mahal, dan risiko yang layak dikelola sebelum Anda merilis. Ini adalah pusat untuk seri developer dan API kami, jadi Anda akan menemukan tautan ke panduan integrasi yang lebih mendalam di tempat-tempat yang bermanfaat.
Daftar isi
Apa arti sebenarnya dari "API suara AI"
Frasa ini menggabungkan tiga gagasan. Suara AI adalah kecerdasan buatan yang bekerja dengan ucapan manusia atau menghasilkan ucapan sintetis. API adalah antarmuka pemrograman aplikasi—cara terdefinisi bagi dua sistem perangkat lunak untuk bertukar permintaan dan respons. Kombinasi tersebut berarti pemrosesan model yang berat terjadi di sisi penyedia, sementara aplikasi Anda menangani pengalaman pengguna, aturan bisnis Anda, dan konten akhir.
Sebuah permintaan bisa sesederhana payload JSON singkat berisi teks yang ingin Anda ucapkan, pengidentifikasi suara, dan kode bahasa. Respons biasanya mengembalikan pengidentifikasi proyek, status pemrosesan, dan URL ke audio yang dihasilkan setelah siap. Untuk pelokalan video, permintaan tersebut justru merujuk pada file yang diunggah dan daftar bahasa target.
Struktur itulah yang memisahkan API dari generator suara berbasis browser. Aplikasi web dibangun agar seseorang mengoperasikannya secara manual, satu pekerjaan dalam satu waktu. API dibangun agar perangkat lunak memanggilnya berulang kali, secara otomatis, dan dalam skala besar. Jika Anda memproduksi satu voiceover sesekali, alat web sering kali lebih cepat. Jika Anda melokalkan setiap video yang Anda terbitkan, API adalah intinya.
Lima jenis API suara AI utama
"API suara AI" adalah sebuah kategori, bukan satu teknologi. Lima jenis umum menerima input yang berbeda dan mengembalikan output yang berbeda, dan memilih yang salah akan membuang waktu integrasi. Tabel di bawah ini memetakannya sehingga Anda dapat mencocokkan materi awal Anda dengan hasil yang Anda inginkan.
| Jenis API | Input | Output | Penggunaan umum |
|---|---|---|---|
| Text-to-speech | Teks tertulis | Audio ucapan sintetis | Narasi, aksesibilitas, prompt aplikasi, pelatihan |
| Speech-to-text | Ucapan atau video | Transkrip tertulis | Teks, pencarian, catatan rapat, pemanfaatan ulang |
| Kloning suara | Sampel suara yang diizinkan | Suara sintetis khusus | Suara merek, presenter berulang, narasi multibahasa |
| Dubbing AI | Video atau audio | Media yang diterjemahkan dan disuarakan | Pelokalan YouTube, kursus, film, podcast |
| Speech-to-speech | Ucapan terekam | Ucapan yang diubah atau diterjemahkan | Konversi suara, produksi multibahasa |
Aturan pemilihannya sederhana. Jika Anda sudah memiliki naskah, text to speech biasanya adalah jalur paling sederhana. Jika Anda memiliki rekaman yang membutuhkan transkrip, Anda memerlukan speech to text. Jika Anda menginginkan identitas presenter yang sama di beberapa bahasa, kloning suara atau dubbing lebih tepat. Untuk penjelasan terfokus hanya pada sisi TTS, panduan pendamping kami tentang apa itu API text to speech membahas pipeline sintesis secara lebih mendalam.
Satu perbedaan yang layak dicatat: kloning suara bukanlah pengubah suara. Pengubah suara mengubah performa yang sudah ada secara langsung, sementara kloning menciptakan model suara yang dapat digunakan kembali untuk menghasilkan ucapan baru dari teks atau input terkontrol lainnya.
Bagaimana permintaan bergerak melalui pipeline
Implementasinya bervariasi, tetapi sebagian besar API suara mengikuti empat tahap yang sama. Memahami bentuk alurnya menghemat berjam-jam menebak-nebak ketika sesuatu mengembalikan status yang tidak terduga.
Pertama, aplikasi Anda melakukan autentikasi. Ia mengirim kunci API atau bearer token di header permintaan. API TTS DubSmart, misalnya, menggunakan endpoint REST dengan autentikasi bearer-token dan permintaan JSON terhadap URL dasar https://dubsmart.ai/api/v1. Sebuah aturan yang lebih penting dari kedengarannya: jangan pernah menempatkan kunci privat dalam JavaScript sisi browser atau aplikasi seluler yang terdistribusi. Simpan di server yang aman dan minta klien Anda memanggil server tersebut.
Kedua, aplikasi Anda mengirim konten dan pengaturan. Sebuah permintaan biasanya membawa kombinasi teks atau referensi file, bahasa sumber dan target, ID suara, kecepatan atau nada, informasi pembicara, preferensi output, dan metadata proyek. Untuk TTS sederhana, kontennya adalah teks. Untuk dubbing, API sering kali membutuhkan unggahan video terlebih dahulu, kemudian permintaan terpisah untuk membuat proyek.
Ketiga, layanan memproses konten. Tergantung tugasnya, itu bisa berarti menormalisasi dan menafsirkan teks, memprediksi pelafalan dan prosodi, menerjemahkan konten ucapan, memisahkan pembicara atau mengisolasi ucapan dari audio latar belakang, menghasilkan audio dengan suara standar atau khusus, dan menyinkronkan hasilnya ke linimasa video. Pekerjaan yang lebih panjang berjalan secara asinkron: alih-alih mengembalikan file yang selesai, API mengembalikan ID proyek.
Keempat, aplikasi Anda mengambil hasilnya—URL audio atau video, URL segmen individual, transkrip, teks terjemahan, data waktu, dan bidang status atau error. API TTS DubSmart mendokumentasikan status proyek seperti pending, processing, completed, dan failed, dan proyek yang selesai dapat mengembalikan URL MP3 di tingkat proyek atau segmen.
Sinkron versus asinkron: perbedaan yang membentuk pembangunan Anda
Cara API mengembalikan hasil menentukan bagaimana Anda merancang arsitektur di sekitarnya, jadi putuskan ini sebelum Anda menulis kode integrasi.
API sinkron menahan permintaan tetap terbuka sampai pemrosesan selesai, lalu mengembalikan hasilnya. Itu bekerja baik untuk teks pendek, prompt suara singkat, cuplikan audio kecil, dan fitur interaktif dengan latensi rendah. Kelemahannya adalah pekerjaan panjang dapat melampaui batas waktu permintaan.
API asinkron segera mengembalikan ID proyek atau pekerjaan. Aplikasi Anda kemudian melakukan polling pada endpoint status atau menerima webhook saat pekerjaan selesai. Model ini cocok untuk narasi panjang, dubbing video, beberapa bahasa target, pembuatan secara batch, dan file besar. Alur kerja TTS dan dubbing DubSmart yang terdokumentasi menggunakan status proyek dan pengambilan hasil, yang merupakan pola asinkron yang dibangun untuk pekerjaan media.
Saat Anda mengevaluasi sebuah opsi, periksa apakah ia mendukung webhook. Polling setiap beberapa detik sepele untuk diimplementasikan, tetapi webhook memangkas permintaan yang tidak perlu dan berskala lebih baik begitu Anda menjalankan banyak pekerjaan sekaligus.
Apa yang perlu dievaluasi sebelum Anda berkomitmen
API yang tepat tergantung pada pekerjaannya, tetapi segelintir kriteria berlaku untuk hampir setiap proyek. Telusuri kriteria tersebut dengan sengaja, bukan mempercayai demo singkat.
Kecocokan kemampuan. Pastikan API mendukung tugas yang tepat—text to speech, speech to text, kloning suara, dubbing, beberapa pembicara, output audio-saja atau video, real-time atau batch. Jangan mengasumsikan bahwa apa pun yang dipasarkan sebagai "suara AI" mencakup semuanya.
Cakupan bahasa. Periksa bahasa sumber dan target. "Mendukung 30 bahasa" bisa berarti 30 suara TTS, 30 target terjemahan, atau campuran bahasa dan dialek. Untuk saluran multibahasa, pertimbangkan juga kualitas aksen, pelafalan nama dan tempat, kosakata regional, ketersediaan suara per bahasa, dan apakah satu suara yang dikloning dapat diterapkan lintas bahasa.
Dukungan output dan media. Verifikasi format audio, kontainer video, sample rate dan bitrate, unduhan tingkat segmen, video yang sudah dirender penuh, ketersediaan transkrip atau subtitle, dan ukuran file maksimum. Hal-hal ini membentuk alur kerja pengeditan dan biaya penyimpanan Anda.
Kualitas dan kontrolabilitas. Dengarkan jeda yang alami, pelafalan yang benar, volume yang stabil, identitas pembicara yang konsisten, penekanan yang tepat, dan pengaturan waktu yang akurat. Sebuah suara bisa terdengar sempurna dalam sampel sepuluh detik tetapi tersandung pada istilah teknis, paragraf panjang, angka, atau nama yang tidak biasa. Uji konten yang representatif, bukan klip pilihan terbaik dari vendor.
Latensi dan throughput. Ukur waktu terhadap beban kerja nyata Anda. Satu voiceover pendek dan ratusan video terlokalisasi adalah masalah yang berbeda. Tanyakan apakah pemrosesan bersifat real-time atau async, berapa batasan lajunya, apakah pekerjaan berjalan secara paralel, apakah ada pemrosesan prioritas, dan bagaimana kegagalan dicoba ulang. DubSmart menyatakan bahwa video lima menit tipikal membutuhkan sekitar satu menit untuk diproses, dengan catatan bahwa waktunya tergantung pada panjang dan ukuran file.
Model harga. API suara dapat menagih berdasarkan karakter, kata, durasi audio atau video, kredit, permintaan, penyimpanan, atau pekerjaan bersamaan. Untuk dubbing, jumlah bahasa target melipatgandakan biaya efektif. Hitung alur kerja yang lengkap—percobaan ulang, segmen yang dibuat ulang, tinjauan terjemahan, penyimpanan—bukan hanya panggilan pertama. Uraian kami tentang harga API suara AI membahas perhitungan kredit secara mendetail.
Risiko yang layak dikelola sejak dini
Suara AI memperkenalkan mode kegagalan yang tidak ada dalam perangkat media biasa. Mengatasinya saat perancangan jauh lebih murah daripada setelah kesalahan publik.
Penggunaan suara tanpa izin. Mengkloning suara seseorang tanpa izin menciptakan risiko hukum, etika, dan reputasi. Gunakan proses persetujuan tertulis yang menyebutkan siapa yang memiliki rekaman, apa yang boleh dihasilkan, di mana suara boleh digunakan, apakah penggunaan komersial diizinkan, bagaimana suara dihapus, dan apa yang terjadi saat perjanjian berakhir.
Terjemahan atau pelafalan yang salah. Ucapan yang dihasilkan dapat salah menangani nama, akronim, alamat, dan istilah industri. Pertahankan tinjauan manusia untuk konten yang menghadap publik: pembacaan naskah terjemahan, pendengaran oleh penutur asli, pemeriksaan pelafalan, tinjauan pengaturan waktu dan gerakan bibir, serta tinjauan akhir pada media yang diekspor.
Peniruan identitas dan penipuan. Suara sintetis dapat disalahgunakan untuk penipuan atau dukungan palsu. Hindari menghasilkan apa pun yang dapat membuat pendengar yang wajar percaya bahwa orang nyata mengatakan sesuatu yang tidak mereka katakan. Untuk komunikasi sensitif, tambahkan pengungkapan, kontrol persetujuan, dan log audit.
Privasi suara dan data. Sampel dapat berisi data pribadi. Sebelum mengunggah, selesaikan persetujuan, aturan retensi, pembatasan akses, prosedur penghapusan, ketentuan pemrosesan data vendor, dan kebijakan penggunaan sekunder apa pun. DubSmart menyatakan bahwa file kloning yang diunggah dienkripsi dan bahwa pengguna dapat menghapus suara khusus serta data audio terkait, meskipun tim tetap harus mengonfirmasi ketentuan dan kontrol terkini untuk paket spesifik mereka.
Perubahan vendor dan model. ID suara, dukungan bahasa, format output, dan batasan laju dapat berubah. Perlakukan API sebagai dependensi eksternal: tetapkan konfigurasi di mana Anda bisa, simpan naskah sumber, simpan audio yang disetujui, pantau tingkat error, pertahankan alur kerja cadangan, dan uji ulang setelah pembaruan besar vendor. Untuk tim yang menginginkan lebih sedikit komponen yang bergerak, ringkasan kami tentang alat video AI serba-ada menjelaskan pertimbangan untuk mengonsolidasikan kemampuan-kemampuan ini.
Kapan API mengungguli alur kerja manual
API suara AI layak dengan biaya integrasinya ketika Anda membutuhkan produksi yang dapat diulang dan terprogram. Ini merupakan kecocokan yang kuat ketika seorang kreator menerbitkan versi terlokalisasi dari setiap video, bisnis kecil menghasilkan narasi produk di beberapa bahasa, perusahaan e-learning memperbarui ratusan pelajaran, podcast merilis edisi terjemahan, produk perangkat lunak menambahkan aksesibilitas suara, atau agensi menghubungkan pembuatan suara ke dalam sistem manajemen kontennya.
Alur kerja studio manual masih bisa menang dalam kasus tertentu: ketika sebuah proyek bergantung pada performa manusia yang sangat bernuansa, ketika persetujuan hukum membutuhkan aktor profesional, ketika konten membawa klaim sensitif, ketika rekaman satu kali lebih cepat daripada membangun integrasi, atau ketika hasilnya membutuhkan arahan artistik yang intensif. Intinya bukan untuk menggantikan setiap suara manusia. Intinya adalah mengotomatiskan bagian-bagian di mana konsistensi, kecepatan, skala, atau output multibahasa paling penting.
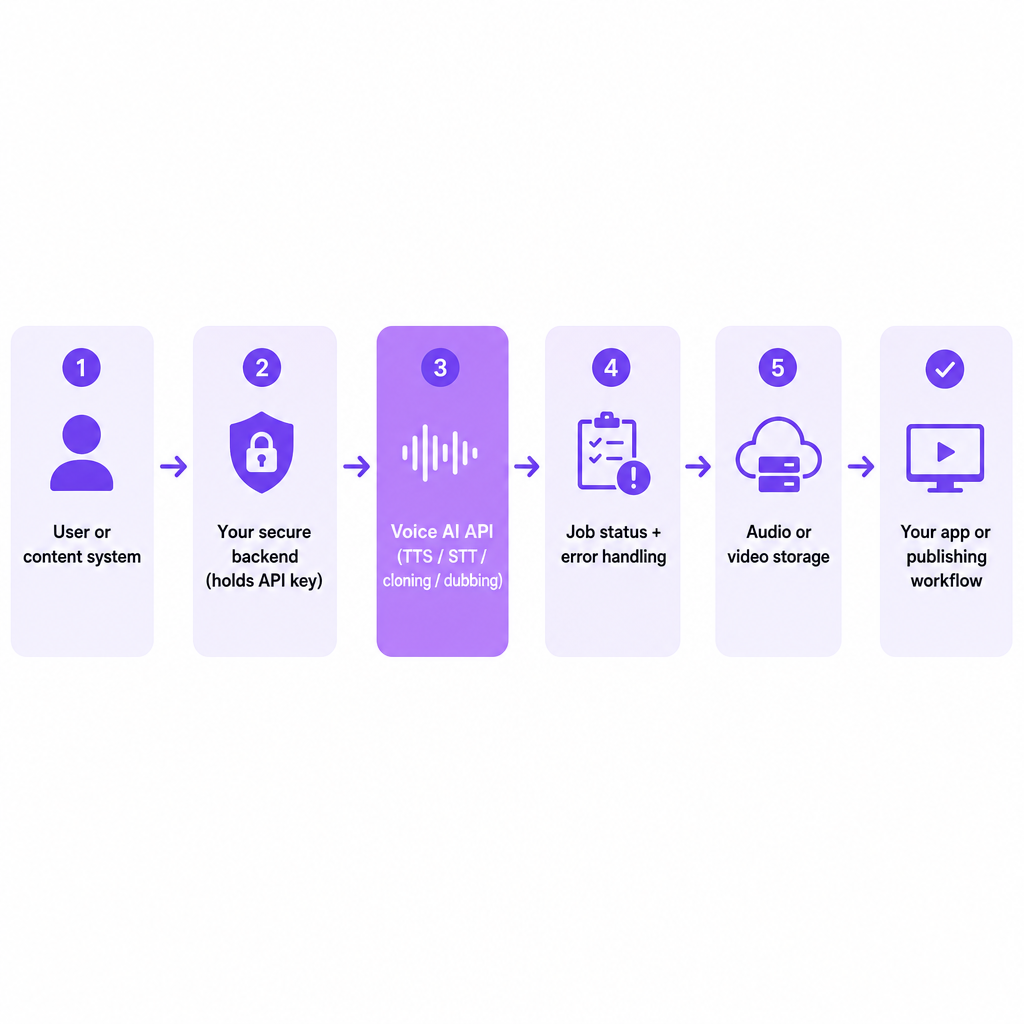
Untuk pembangunan kecil, pertahankan arsitektur yang sederhana. Backend yang aman berada di antara pengguna atau sistem konten Anda dan API suara. Backend tersebut menjaga kredensial tetap privat, memvalidasi input, membuat proyek, menyimpan ID pekerjaan, melakukan polling status atau menerima webhook, mencoba ulang kegagalan sementara, menyimpan URL hasil dan metadata, menerapkan batasan penggunaan, dan mencatat persetujuan untuk suara apa pun yang dikloning. Versi yang menghadap kreator mungkin menerima video bahasa Inggris yang sudah selesai, mengirimnya ke endpoint dubbing untuk bahasa yang dipilih, menunggu penyelesaian, mengarahkan hasil ke folder tinjauan, dan menerbitkan hanya setelah persetujuan.
Di mana DubSmart berperan
Kami membangun beberapa kemampuan API terkait suara ke dalam satu platform media AI, yang paling penting ketika Anda ingin menghubungkan pembuatan dan pelokalan ke alur kerja yang sudah ada alih-alih menjalankan setiap pekerjaan secara manual.
API Text to Speech kami menyediakan pembuatan ucapan terprogram dengan suara neural, kloning suara, dukungan multibahasa, pelacakan status proyek, dan hasil MP3—contoh permintaannya menggunakan segmen teks dengan ID suara, bahasa, kecepatan, dan nada. API Voice Cloning kami mengikuti pola tiga langkah: minta URL unggah presigned, unggah sampel audio, lalu buat suara khusus dari key file yang diunggah; ia menerima MP3, WAV, AAC, M4A, dan FLAC, dan kami merekomendasikan setidaknya 20 detik audio bersih untuk hasil yang lebih baik. API AI Dubbing kami menangani pelokalan video dengan pembuatan proyek multibahasa, pengaturan pembicara, segmen terjemahan, dan output dubbing yang dapat diunduh, menerima input seperti MP4, MOV, AVI, MKV, dan WebM hingga 5GB.
Jika Anda menimbang endpoint mana yang akan dimulai, cocokkan dengan konten Anda: narasi bernaskah mengarah ke TTS, suara berulang yang diizinkan mengarah ke kloning, dan video multibahasa mengarah ke dubbing.
Pertanyaan yang sering diajukan
Apa itu API suara AI dalam istilah sederhana?
Ini adalah koneksi yang memungkinkan perangkat lunak menghasilkan, mengenali, mengkloning, menerjemahkan, atau mengubah ucapan tanpa membangun sistem suara AI-nya sendiri. Aplikasi Anda mengirim permintaan dan menerima audio, teks, atau video yang telah diproses.
Apakah API suara AI sama dengan text to speech?
Tidak. Text to speech adalah salah satu jenis API suara AI. Kategori ini juga mencakup pengenalan ucapan, kloning suara, dubbing, dan fungsi speech-to-speech.
Apakah saya membutuhkan pengalaman coding untuk menggunakannya?
Biasanya sedikit, karena API melibatkan autentikasi, permintaan HTTP, JSON, unggahan file, dan penanganan status. Untuk pekerjaan manual sesekali, aplikasi web tanpa kode sering kali lebih mudah.
Dapatkah API suara AI menerjemahkan video YouTube?
API dubbing dapat menerjemahkan dan menghasilkan audio baru untuk sebuah video ketika ia mendukung bahasa sumber dan target, format file, dan alur kerja output yang diperlukan. Tinjau hasilnya sebelum menerbitkan.
Dapatkah saya mengkloning suara siapa saja?
Secara teknis mungkin tidak sama dengan diizinkan secara hukum atau etika. Kloning suara hanya dengan izin yang sesuai, dan ikuti aturan penyedia, kontrak Anda, serta persyaratan privasi dan publisitas yang berlaku.