Anda dapat mengonversi teks menjadi ucapan secara online dalam waktu yang dibutuhkan untuk menempelkan naskah, memilih suara, dan mengeklik hasilkan. Tanpa mikrofon, tanpa bilik rekaman, tanpa ruang penyuntingan—hanya alat berbasis browser yang mengubah kata-kata tertulis menjadi narasi bernada alami yang bisa Anda unduh dan masukkan ke dalam video, kursus, podcast, atau iklan. Pekerjaan sesungguhnya bukanlah mengeklik; melainkan segelintir pilihan yang menentukan apakah audionya terdengar seperti seseorang atau seperti kios otomatis.
Panduan ini membahas keputusan tersebut dengan cepat: apa yang terjadi saat Anda mengonversi teks menjadi ucapan secara online, cara mendapatkan file yang bisa digunakan dengan cepat, cara memilih suara yang tepat, dan di mana batasan jujurnya. Kami membangun DubSmart AI untuk menangani seluruh alur kerja ini di satu tempat, jadi contoh-contoh di sini berasal dari cara alat Text to Speech, kloning suara, dan sulih suara kami sendiri benar-benar bekerja.
Daftar isi
Apa arti sebenarnya dari “mengonversi teks menjadi ucapan secara online”
Text to speech, atau TTS, adalah teknologi yang mengonversi bahasa tertulis menjadi audio ucapan. Sistem AI modern membaca teks, menafsirkan pengucapan dan struktur kalimat, serta menyintesis suara dengan tempo, penekanan, dan nada. Melakukannya “secara online” berarti sintesisnya berjalan di cloud: Anda tidak memasang perangkat lunak atau merekam apa pun sendiri.
Pergeseran itu penting karena mengubah siapa yang bisa memproduksi sulih suara. Seorang YouTuber yang menulis naskah Short, seorang pelatih yang memperbarui modul kepatuhan, seorang pemasar yang menulis ulang iklan untuk ketiga kalinya dalam minggu itu—tak satu pun dari mereka membutuhkan peralatan rekaman atau pengisi suara yang siap siaga. Naskah yang sama yang ditempelkan dapat menjadi narasi untuk tutorial, demo produk, kursus, podcast, presentasi, audio aksesibilitas, pesan layanan pelanggan, dan versi lokal dalam bahasa lain.
Jika Anda ingin mendalami mekanisme bagaimana pipeline sintesis mengubah fonem menjadi prosodi, kami membahasnya secara terpisah di bagaimana neural text to speech bekerja. Untuk panduan ini, model mental yang berguna cukup singkat: naskah masukan yang baik ditambah suara yang tepat sama dengan audio yang bisa Anda publikasikan.
Jalur cepat dari naskah ke audio yang dapat diunduh
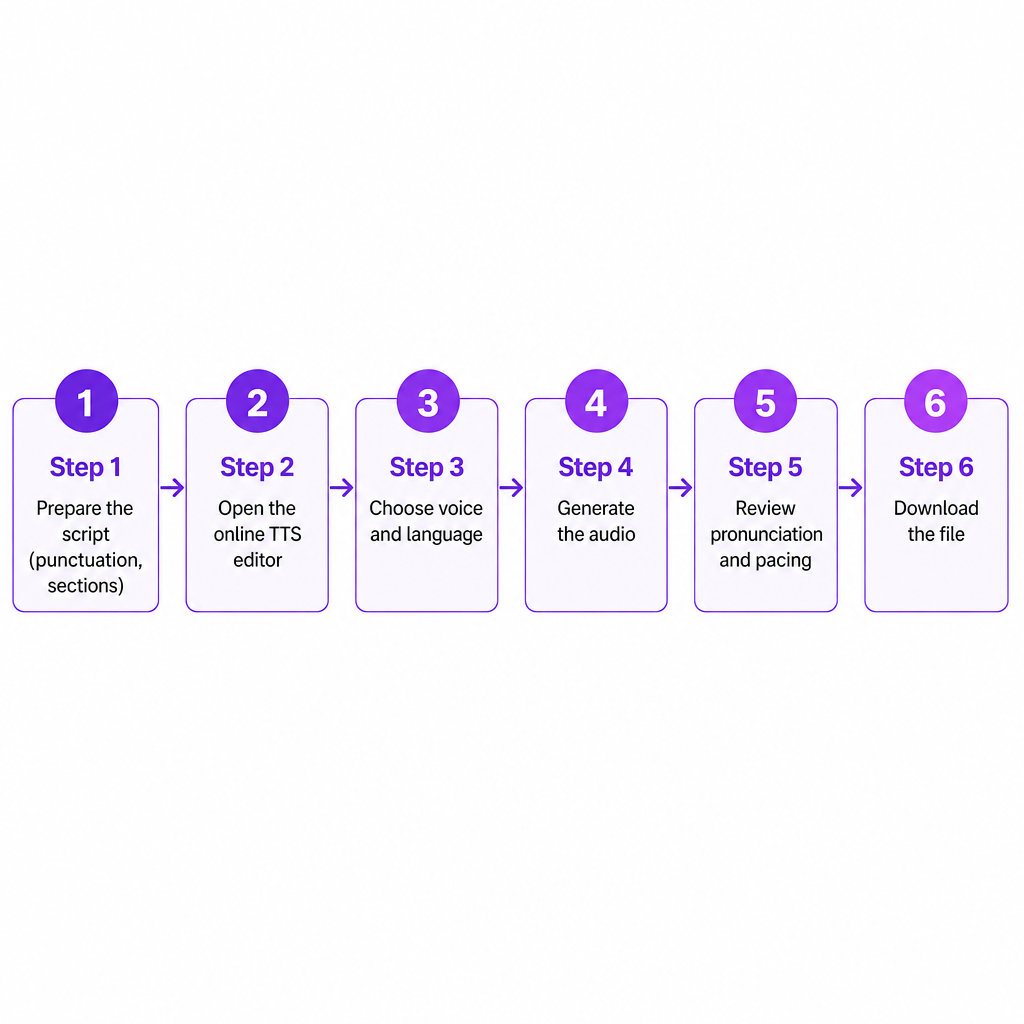
Urutannya cukup singkat untuk dihafal: siapkan teks, buka alatnya, pilih suara dan bahasa, hasilkan, tinjau, unduh. Langkah yang sering dilewati orang adalah yang pertama, dan itulah yang paling menghemat waktu.
Mulailah dengan naskah yang sudah jadi, bukan catatan kasar. Tambahkan tanda baca, pecah paragraf panjang menjadi bagian-bagian yang logis, dan bacalah dengan lantang sekali. Suara AI menyampaikan apa yang Anda berikan, jadi membersihkan teks di awal mencegah pembuatan ulang di kemudian hari. Dari sana, tempelkan ke alat Text to Speech DubSmart, pilih suara yang cocok dengan konten dan audiens, lalu hasilkan audionya. Halaman TTS kami menawarkan 300+ suara AI—pria, wanita, dan netral—ditambah kontrol untuk kecepatan bicara, arahan emosi, penekanan, dan pengucapan angka.
Lalu tinjau sebelum Anda mengekspor. Dengarkan secara khusus adanya nama yang salah diucapkan, jeda yang tidak alami, penekanan yang salah tempat, atau nada yang tidak cocok dengan video. Perbaiki hal-hal itu di naskah dan hasilkan ulang bagian yang terpengaruh alih-alih seluruh file. Jika sudah terdengar pas, unduh dan masukkan ke proyek Anda.
Satu catatan praktis: editor kami menampilkan opsi ekspor secara langsung, dan kami tidak menerbitkan daftar format lengkap sebelumnya, jadi periksa format yang tersedia di editor sebelum Anda memulai pekerjaan batch besar. Pemeriksaan lima detik itu lebih baik daripada menemukan ketidakcocokan format setelah merender satu jam narasi.
Memilih suara yang bertahan untuk keseluruhan proyek
Memilih suara yang terdengar paling realistis dalam pratinjau singkat adalah kesalahan umum. Suara yang mengesankan dalam klip sepuluh detik bisa menjadi melelahkan sepanjang penjelasan dua puluh menit. Pengujian yang lebih baik adalah menjalankan satu paragraf representatif dari naskah Anda yang sebenarnya—nama, angka, dan semuanya—sebelum memproduksi apa pun.
Cocokkan suara dengan tugasnya. Hangat dan percakapan cocok untuk tutorial, podcast, dan konten kreator. Jelas dan berwibawa cocok untuk presentasi bisnis dan pelatihan. Energik cocok untuk iklan dan video sosial; tenang dan terukur cocok untuk meditasi, aksesibilitas, dan materi edukatif; khas atau ekspresif membantu fiksi dan animasi. Jika Anda ingin daftar pilihan yang disesuaikan untuk platform tertentu, panduan kami tentang suara text to speech terbaik untuk YouTube mempersempit pilihannya.
Bahasa layak mendapat perhatian yang sama. Untuk konten multibahasa, pilih suara yang dibangun untuk bahasa target alih-alih memaksa suara berbahasa Inggris membaca teks asing—pengucapan, ritme, dan penekanan sangat berbeda antarbahasa dan aksen. API Text to Speech kami mencantumkan dukungan untuk 33+ bahasa dan dialek serta menyebut Inggris, Portugis, Spanyol, Prancis, Jerman, Mandarin, dan Jepang di antaranya, dan kloning suara kami bekerja di 33 bahasa.
Konsistensi adalah pembeda yang diam-diam. Gunakan kembali suara, gaya pengucapan, dan pengaturan penyampaian yang sama di seluruh video terkait agar sebuah channel, kursus, atau merek tetap dapat dikenali. Untuk dialog, ganti suara hanya ketika perubahan itu benar-benar membantu pemahaman; terlalu banyak suara membuat penjelasan singkat terasa berantakan.
Membuat ucapan AI terdengar tidak seperti mesin
Sebagian besar keluaran yang “robotik” berasal dari naskah, bukan mesinnya. Bahasa tertulis dan bahasa lisan adalah register yang berbeda, dan suara membaca persis apa yang Anda ketik.
Tulislah untuk telinga. Kalimat yang lebih pendek terdengar lebih alami daripada klausa yang padat. Bandingkan kedua ini:
Implementasi fitur ini memberikan pengguna kemampuan untuk menghasilkan konten audio tanpa persyaratan akan peralatan rekaman.
Fitur ini memungkinkan Anda membuat audio tanpa peralatan rekaman.
Yang kedua lebih mengalir. Gunakan tanda baca sebagai kontrol penyampaian juga: koma menciptakan jeda singkat, titik dan pergantian paragraf menciptakan transisi yang lebih kuat. Jika suara mulai terburu-buru atau datar, pecah kalimatnya.
Angka, tanggal, mata uang, dan akronim adalah jebakan pengucapan yang biasa. Ketika keluarannya terdengar salah, ejakan pengucapannya ke dalam naskah—itulah rekomendasi tetap kami ketika angka yang dihasilkan keluar dengan salah:
| Anda menulis | Tulis sebagai |
|---|---|
| 2026 | dua ribu dua puluh enam |
| $49.99 | empat puluh sembilan dolar dan sembilan puluh sembilan sen |
| API | A-P-I |
| SQL | pengucapan yang diharapkan audiens Anda |
Arahan emosi bisa membantu, jika digunakan secukupnya. Isyarat seperti “ucapnya dengan gembira” mungkin mencerahkan penyampaian, sementara “teriaknya dengan marah” mendorong nada yang lebih tegas—tetapi jika setiap kalimat membawa instruksi, narasinya berubah menjadi teatrikal. Kecepatan adalah tuas lainnya: tempo yang sedikit lebih lambat membantu pemahaman dalam kursus dan audio aksesibilitas, sementara penyampaian lebih cepat cocok untuk klip sosial singkat sampai mulai mengorbankan kejelasan. Editor kami menampilkan kontrol kecepatan bicara (misalnya, nilai seperti 1.00x) yang bisa Anda geser ke salah satu arah. Ketika sebuah kata kunci hilang, perbaiki struktur kalimat sebelum beralih ke pemformatan yang tidak biasa; penekanan harus melayani makna, bukan mengiklankan bahwa mesin yang membuatnya.
TTS standar, kloning suara, atau API: mana yang cocok
Tiga rute mengarah ke audio ucapan, dan masing-masing menyelesaikan masalah yang berbeda. Text to speech standar menggunakan suara AI yang sudah dibuat. Kloning suara membuat suara sintetis yang dapat digunakan kembali dari sampel audio. API membuat salah satunya dapat diprogram.
Pilih suara AI standar ketika Anda membutuhkan sulih suara sekali pakai yang cepat, beberapa gaya untuk dicoba, narator serbaguna, atau suara dalam bahasa yang tidak bisa Anda rekam sendiri. Pilih kloning suara ketika Anda membutuhkan suara kreator atau merek yang konsisten, episode berulang dengan narator yang sama, pembaruan audio tanpa merekam ulang, atau versi multibahasa yang mempertahankan identitas suara yang dapat dikenali. Kami menawarkan kloning suara tak terbatas pada paket TTS, dan suara kloning bekerja di Text to Speech maupun AI Dubbing di 33 bahasa.
API adalah keputusan yang sama sekali berbeda. Editor browser paling cepat untuk file individual dan batch kecil. API mendapatkan tempatnya ketika pembuatan harus terjadi secara otomatis—platform yang menarasikan naskah yang dikirimkan pengguna, sistem pembelajaran yang membangun pelajaran audio, produk dukungan yang mengirim pesan yang dipersonalisasi, atau agensi yang memproses banyak variasi lokal. API Text to Speech kami menggunakan antarmuka REST dengan manajemen proyek dan segmen, pemilihan suara dan bahasa, parameter kecepatan dan nada, status kemajuan, serta URL audio setelah pemrosesan; ia mengembalikan MP3, dan segmen satu hingga dua kalimat biasanya memakan waktu sekitar 10–30 detik tergantung panjang dan kompleksitas. Perlu diingat: API mengotomatiskan volume, tetapi tidak akan membuat satu sulih suara singkat lebih cepat daripada editor visual. Jika Anda sedang mempertimbangkan rute terprogram secara umum, apa itu voice AI API menjelaskan kategori tersebut sebelum Anda mengintegrasikan apa pun.
Apa yang perlu diperiksa sebelum Anda memutuskan sebuah alat
Sebagian besar penyesalan datang dari melewatkan uji coba singkat. Jalankan paragraf yang sama melalui beberapa suara, sertakan nama dan angka nyata dari alur kerja Anda, dan dengarkan di perangkat yang benar-benar digunakan audiens Anda. Berikut kriteria yang layak dinilai saat Anda melakukannya.
| Kriteria keputusan | Apa yang diperiksa |
|---|---|
| Kualitas suara | Apakah tetap alami dalam kalimat panjang dan kata-kata sulit? |
| Pengucapan | Bisakah Anda mengoreksi nama, akronim, dan angka? |
| Dukungan bahasa | Apakah bahasa target dan aksen Anda yang tepat tercakup? |
| Konsistensi | Bisakah Anda menggunakan kembali suara yang sama di seluruh proyek? |
| Kontrol penyuntingan | Apakah kecepatan, nada, jeda, dan penekanan dapat disesuaikan? |
| Keluaran dan kecepatan | Apakah format tersedia dan pembuatannya cukup cepat? |
| Otomatisasi | Apakah ada API jika Anda membutuhkan pembuatan terprogram? |
| Hak dan biaya | Apakah syarat penggunaan, hak komersial, dan ketentuan kredit jelas? |
Tabel ini memadatkan daftar periksa pembelian ke dalam satu layar, tetapi uji coba itulah yang memvalidasinya. Tingkatan gratis atau uji kecil memberi tahu Anda lebih banyak dalam sepuluh menit daripada daftar fitur apa pun, karena satu-satunya keluaran yang penting adalah bagaimana naskah Anda terdengar dalam suara yang benar-benar akan Anda rilis.
Menggunakan ucapan AI secara bertanggung jawab
Ucapan sintetis benar-benar berguna, dan membawa kewajiban yang nyata. Hanya kloning suara ketika Anda memiliki izin pembicara dan hak atas rekaman tersebut. Jangan menyamarkan audio sintetis sebagai rekaman otentik, dan jangan pernah menggunakan suara yang terdengar familier untuk meminta uang atau informasi sensitif.
Ini bukan kehati-hatian abstrak. Federal Trade Commission memperingatkan bahwa kloning suara dapat membuat permintaan penipuan terdengar seolah-olah berasal dari anggota keluarga, kolega, atau eksekutif tepercaya, dan merekomendasikan memverifikasi identitas secara independen alih-alih memercayai suara yang familier saja.
Untuk pekerjaan komersial atau yang menghadap publik, beberapa kebiasaan menjaga Anda tetap aman: simpan catatan yang menunjukkan izin untuk menggunakan suara kloning, tinjau ketentuan penyedia untuk penggunaan komersial dan penanganan data, ungkapkan narasi sintetis ketika transparansi penting bagi audiens Anda, dan tambahkan tinjauan manusia untuk konten hukum, medis, keuangan, atau kritis keselamatan. Perlakukan suara sebagai kemudahan, bukan sebagai bukti identitas.
Pertanyaan yang sering diajukan
Apa cara tercepat untuk mengonversi teks menjadi ucapan secara online?
Gunakan editor TTS berbasis browser: tempelkan naskah yang sudah disiapkan, pilih suara, hasilkan, tinjau pengucapan, dan unduh. Menyiapkan naskah sebelum Anda membuka alat biasanya merupakan penghemat waktu terbesar, karena masukan yang bersih berarti lebih sedikit pembuatan ulang.
Bisakah saya mengonversi teks menjadi ucapan secara gratis?
Beberapa platform, termasuk milik kami, menawarkan akses gratis atau kredit uji coba, tetapi batasannya bervariasi menurut paket. Periksa ketentuan saat ini untuk karakter, kredit, unduhan, penggunaan komersial, dan kloning suara sebelum Anda mempublikasikan.
Bisakah saya menggunakan text to speech online untuk YouTube?
Ya. TTS online dapat menarasikan video, Shorts, tutorial, dan versi multibahasa. Konfirmasikan ketentuan lisensi penyedia agar suara dan audio yang dihasilkan diizinkan untuk penggunaan yang Anda maksudkan.
Bisakah saya mengonversi teks menjadi ucapan dalam bahasa lain?
Ya, ketika platform mendukung bahasa itu dan suara yang sesuai. Untuk hasil yang alami, terjemahkan dan sunting naskah terlebih dahulu, lalu pilih suara yang dirancang untuk bahasa atau aksen target alih-alih menggunakan kembali suara berbahasa Inggris.
Format file apa yang harus saya gunakan?
MP3 cocok untuk sebagian besar video, podcast, dan proyek web karena didukung secara luas dan ringkas. Untuk pascaproduksi profesional, periksa apakah editor Anda membutuhkan format sumber yang berbeda atau berkualitas lebih tinggi.
Apakah TTS online cukup baik untuk konten profesional?
Untuk penjelasan, pelatihan, audio aksesibilitas, draf, media lokal, dan narasi yang diperbarui secara berkala, ya. Untuk proyek yang mengutamakan performa atau berisiko tinggi di mana penentuan waktu halus membawa makna, dengarkan dengan saksama dan pertimbangkan bakat suara manusia.