Memilih suara text to speech terbaik untuk YouTube bukan soal mengejar satu suara yang "sempurna", melainkan lebih pada menyelaraskan pengaturan suara yang tepat dengan niche saluran Anda, rencana bahasa, dan cara Anda benar-benar memproduksi video. Di DubSmart AI, pilihan tersebut mengerucut menjadi empat opsi praktis dalam satu ruang kerja: pustaka 300+ suara AI siap pakai, suara yang Anda klon dari audio Anda sendiri, suara yang sama yang diterapkan pada dubbing multibahasa, dan suara berbasis API untuk alur kerja otomatis. Masing-masing menyelesaikan masalah yang berbeda, dan pilihan terbaik biasanya menggabungkan beberapa di antaranya seiring pertumbuhan saluran Anda.
Panduan ini menelusuri apa yang dilakukan setiap pengaturan suara dengan baik, di mana ia cocok, dan di mana ia memiliki kekurangan, sehingga Anda dapat memutuskan dengan percaya diri alih-alih menebak dari peringkat umum.
Daftar isi
Cara kami memilih suara text to speech terbaik untuk YouTube
Kami memilih suara dan pengaturan suara yang bertahan di saluran YouTube yang nyata, bukan berdasarkan peringkat pasar yang abstrak. Lima kriteria membentuk setiap pilihan di bawah ini.
Kealamian adalah yang paling utama, karena sebagian besar waktu tonton terjadi di ponsel dengan volume yang bervariasi. Sebuah suara harus terdengar manusiawi dan tetap jelas melalui audio terkompresi dan kebisingan latar belakang saat perjalanan. Cakupan bahasa dan aksen menyusul: sebuah suara hanya berguna untuk pertumbuhan jika Anda dapat membawanya ke wilayah baru tanpa merekam ulang katalog lama Anda. Konsistensi merek adalah filter ketiga, karena suara yang sama harus dapat digunakan kembali di studio Text to Speech kami dan dubbing, termasuk suara klon yang terdengar seperti Anda. Kecocokan alur kerja menentukan apakah sebuah suara praktis untuk dihasilkan, diedit, dan diekspor dalam jadwal produksi yang nyata. Terakhir, potensi otomatisasi menentukan apakah pengembang dan agensi dapat memanggil suara yang sama melalui API untuk output bertemplat atau berskala besar.
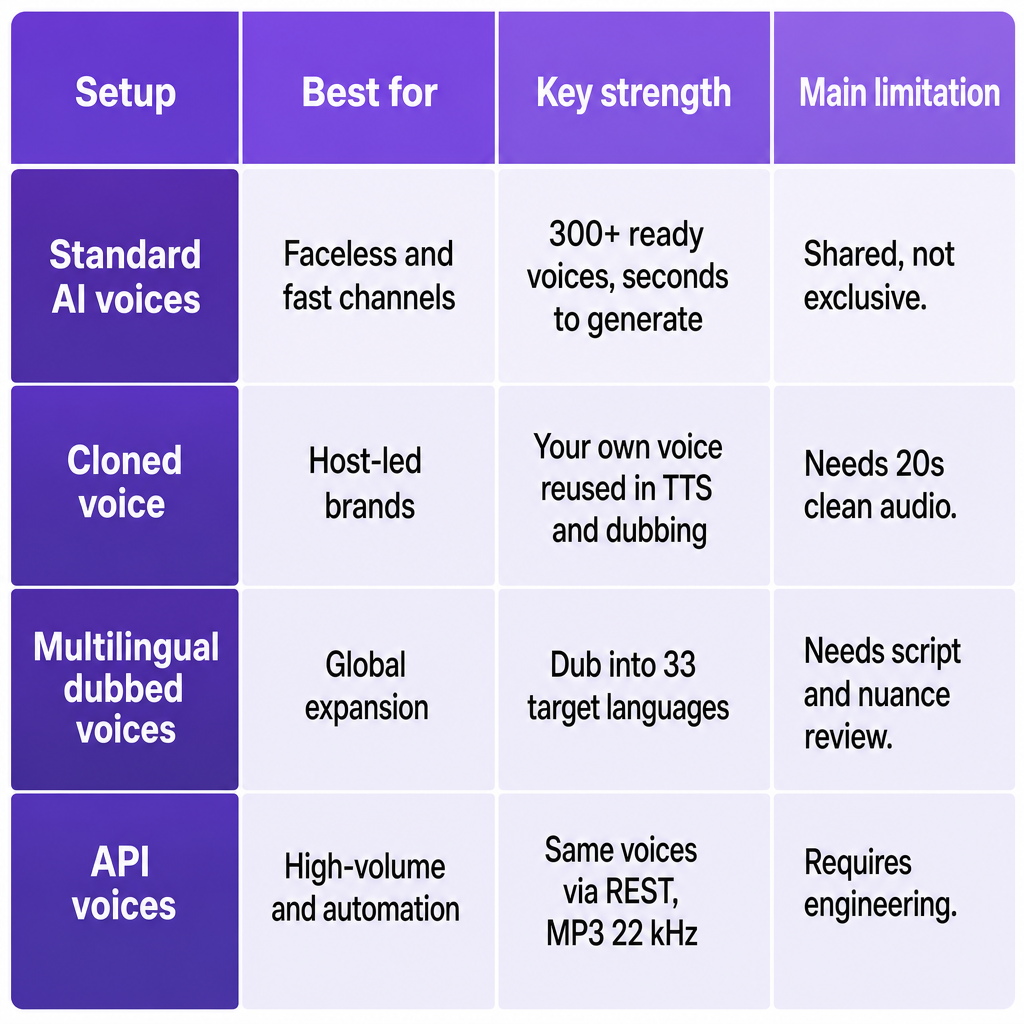
Setiap item di bawah ini mendapatkan satu bagian dengan keistimewaannya, kecocokannya yang terbaik di YouTube, dan keterbatasannya yang jujur, yang diambil dari cara kerja alat-alat ini di dalam platform kami.
Pustaka suara AI standar: narasi cepat dan siap dipublikasikan
Jalur tercepat menuju voiceover yang jadi adalah mesin Text to Speech kami: tempel skrip dalam bahasa Anda, pilih dari lebih dari 300 suara AI, pratinjau, dan hasilkan ucapan yang realistis dalam hitungan detik. Anda dapat memilih pembicara, menyesuaikan pengaturan dasar, dan mengekspor audio standar yang langsung Anda masukkan ke dalam editan YouTube. Katalog yang sama tersedia melalui TTS API kami, sehingga setiap suara siap pakai ada baik di studio web maupun di alur kerja terprogram.
Pengaturan ini cocok untuk saluran tanpa wajah dan komentar yang mengutamakan kecepatan dan konsistensi daripada satu kepribadian yang dikenali. Ia cocok untuk ulasan berita, listicle, penjelasan, dan slideshow yang membutuhkan narasi yang bersih dengan jadwal ketat, serta saluran e-learning, korporat, dan pemasaran yang lebih menyukai nada profesional yang netral. Seorang kreator dapat menempel skrip, memilih suara, menghasilkan, dan mengunduhnya untuk editor seperti Premiere atau Final Cut tanpa menyentuh peralatan rekaman. Untuk tim teknis, Text to Speech API kami mengembalikan file MP3 pada 22 kHz setelah permintaan sederhana dengan teks dan preferensi suara, yang cocok dengan rapi ke dalam alur produksi video berbasis template atau data. Jika Anda ingin mekanisme yang lebih mendalam, penjelasan kami tentang cara kerja neural text to speech membahas apa yang terjadi di balik setiap render.
Imbal baliknya adalah eksklusivitas. Suara standar dibagikan ke seluruh pengguna, sehingga saluran dengan branding kuat dan dipimpin kepribadian pada akhirnya mungkin menginginkan sesuatu yang lebih khas. Anda dapat menyetel bahasa, pembicara, dan beberapa parameter, tetapi Anda tidak akan mendapatkan keunikan halus dari suara Anda sendiri tanpa kloning. Dan karena katalognya luas, menemukan suara yang benar-benar cocok dengan audiens Anda masih membutuhkan beberapa uji dengar alih-alih satu pilihan beruntung.
Suara kreator yang diklon: pembawa acara yang dikenali dalam skala besar
Ketika suara Anda menjadi bagian dari merek Anda, kloning mengubah perhitungannya. Voice cloning kami membangun suara AI khusus dari sampel singkat, lalu menjadikan suara tersebut dapat dipilih di mana pun suara standar muncul, baik di Text to Speech maupun dubbing. Anda mengunggah setidaknya 20 detik audio bersih tanpa kebisingan latar belakang, dan sistem menghasilkan klon yang dapat digunakan kembali. Kami mendukung kloning berapa pun jumlah suara, sehingga sebuah merek tidak terkunci pada satu pembawa acara: Anda dapat mengklon beberapa juru bicara atau suara karakter sesuai kebutuhan.
Suara yang diklon adalah pilihan terkuat untuk saluran yang digerakkan kepribadian di mana pemirsa berlangganan karena orang tertentu. Ia juga cocok untuk kreator yang ingin mempertahankan suara mereka sendiri sambil mengotomatiskan sebagian produksi, seperti narasi B-roll, trek bahasa alternatif, atau shorts berskrip. Dan ia adalah tulang punggung saluran multibahasa yang menginginkan satu identitas pembicara yang konsisten di berbagai bahasa ketika dipasangkan dengan dubbing. Setelah diklon, suara Anda menjadi opsi normal di studio, siap untuk narasi berskrip atau untuk menyuarakan ulang video penuh ke bahasa lain sambil mempertahankan identitas Anda.
Kualitas bergantung pada audio sumber Anda. Sampel yang berisik atau bergema menghasilkan klon yang lebih lemah dan dapat menimbulkan artefak, sehingga banyak kreator merekam sampel bersih khusus alih-alih menggunakan kembali audio livestream atau vlog. Lintas bahasa, aksen dan prosodi mengikuti model sintesis, sehingga pengucapan mungkin tidak sempurna cocok dengan penutur asli di setiap bahasa target. Kloning juga menambahkan langkah penyiapan sebelum penggunaan pertama, yang membuatnya paling cocok untuk saluran yang berkomitmen pada konsistensi jangka panjang alih-alih sekadar uji coba sekali.
Suara dubbing multibahasa: mengubah satu saluran menjadi banyak
Rute paling langsung menuju saluran global adalah dubbing. Dengan AI Dubbing kami, Anda mengunggah video, menerjemahkan dan menyuarakan ulang ke salah satu dari 33 bahasa target, dan secara opsional menerapkan suara klon ke trek yang di-dubbing tersebut. Detail pentingnya adalah bahwa dubbing menggunakan katalog suara yang sama dan suara klon yang digunakan untuk Text to Speech, sehingga suara dubbing "terbaik" Anda hanyalah suara pilihan Anda yang dikonfigurasi untuk skrip terjemahan. Karena ruang kerja juga mencakup Speech to Text, Speech Separator, serta alat gambar dan video, Anda terhindar dari menyatukan pemasok terpisah untuk transkripsi, terjemahan, voiceover, dan visual.
Ini cocok untuk saluran yang sudah sukses dalam satu bahasa dan siap berkembang tanpa merekam ulang. Tutorial, ulasan produk, dokumenter, dan konten berdurasi panjang dengan nilai tonton ulang tinggi membenarkan upayanya, begitu pula bisnis, penyedia e-learning, dan tim pemasaran yang membutuhkan narasi bermerek yang konsisten di berbagai wilayah. Anda dapat memulai dari video yang sudah ada, menghasilkan skrip terjemahan, dan menerapkan suara standar atau suara klon Anda ke audio yang di-dubbing, menciptakan versi lokal dari saluran Anda yang mempertahankan kepribadian yang sama. Menjaga Text to Speech dan dubbing dalam satu ruang kerja memudahkan menyelaraskan gaya narasi antara versi asli dan terjemahan. Jika Anda sedang menimbang format lokalisasi, penjabaran kami tentang dubbing versus subtitle membantu membingkai keputusannya.
Dubbing menambahkan pekerjaan yang tidak ada pada narasi satu bahasa. Bahkan dengan terjemahan dan sintesis yang kuat, Anda tetap perlu meninjau skrip untuk nuansa budaya, menyesuaikan contoh, dan memastikan gaya suara cocok dengan audiens target. Ia juga mengonsumsi lebih banyak kredit dan pengelolaan ekspor dibandingkan klip sekali pakai. Suara klon mempertahankan identitas, tetapi sinkronisasi bibir dan waktu mungkin tidak sempurna cocok dengan visual asli pada konten yang berbicara cepat atau sangat beranimasi, jadi perkirakan ada sejumlah editan manual di editor video Anda.
Suara berbasis API: produksi otomatis bervolume tinggi
Untuk tim yang berproduksi dalam volume besar, suara yang sama tersedia secara terprogram melalui tiga endpoint. Text to Speech API kami mengonversi teks menjadi ucapan alami menggunakan set lengkap 300+ suara dan mengembalikan file MP3 yang dapat diunduh pada 22 kHz saat pemrosesan selesai. Voice Cloning API kami memungkinkan Anda mengunggah sampel dan membuat suara khusus yang dapat digunakan di TTS atau dubbing. AI Dubbing API kami memungkinkan pengembang dan agensi menerjemahkan serta men-dubbing video secara terprogram, menyematkan kemampuan ini langsung ke dalam alur konten atau CMS.
Pengaturan ini cocok untuk saluran yang menghasilkan banyak video serupa, seperti ringkasan berita berulang, rangkuman berbasis data, atau penjelasan bertemplat di mana skrip dihasilkan atau diisi dari data terstruktur. Ia cocok untuk agensi yang mengelola beberapa saluran klien yang membutuhkan alur kerja suara otomatis dan berulang, serta produk perangkat lunak yang menawarkan fitur publikasi otomatis yang membutuhkan voiceover berkualitas dalam skala besar. Karena suara klon dapat dirujuk berdasarkan ID bersama dengan suara standar, otomatisasi tidak membuat Anda kehilangan konsistensi merek: setiap render menggunakan suara yang dimaksudkan sama di seluruh video dan saluran.
Biayanya adalah rekayasa. Alur kerja API membutuhkan keakraban dengan layanan RESTful ditambah infrastruktur untuk menyimpan audio, memprosesnya lebih lanjut, dan melampirkannya ke aset video. Kreator yang lebih kecil yang bekerja sepenuhnya di editor web biasanya tidak akan mendapat manfaat hingga mereka mencapai skala yang berarti. Alur otomatis juga membutuhkan pengaman seputar kualitas skrip, waktu, dan kepatuhan, karena input yang lemah tetap menghasilkan output yang lemah tidak peduli sebagus apa pun suaranya.
Cara memilih pengaturan suara yang tepat untuk saluran Anda
Empat pertanyaan menyelesaikan sebagian besar keputusan. Jawab secara berurutan dan tumpukan suara Anda akan jatuh pada tempatnya.
Audiens dan format. Jika saluran Anda tanpa wajah, bernuansa berita, atau digerakkan listicle, mulailah dengan suara AI standar untuk penyelesaian cepat dan pengujian nada yang mudah. Jika pemirsa berlangganan karena Anda secara spesifik, investasikan untuk mengklon suara Anda dan menggunakannya baik di Text to Speech maupun dubbing.
Strategi bahasa. Jika Anda memublikasikan dalam satu bahasa, temukan satu atau dua suara yang cocok dengan nada Anda dan berkomitmenlah padanya demi konsistensi. Jika Anda berencana mendunia, rancang berdasarkan dubbing: pilih satu suara klon utama dan petakan ke trek dubbing di hingga 33 bahasa target.
Volume produksi. Untuk unggahan mingguan atau serial sesekali, alat Text to Speech dan AI Dubbing berbasis web sudah cukup. Untuk konten bervolume tinggi atau berbasis data, rencanakan alur kerja yang mengutamakan API di mana skrip dan aset baru memicu pembuatan suara secara otomatis.
Kontrol merek dan risiko. Gunakan suara standar untuk uji coba berisiko rendah dan saluran di mana identitas suara bukanlah inti. Gunakan suara klon dengan aturan internal yang jelas tentang siapa yang dapat memicunya dan di mana ia dapat muncul, yang paling penting untuk saluran korporat atau bermerek.
Menyelaraskan suara Anda dengan ekspektasi audiens, rencana bahasa, dan alur kerja adalah cara Anda menghindari kegagalan umum: narasi yang tidak konsisten, perubahan suara yang mengejutkan antar video, dan alur yang terlalu banyak rekayasa sehingga sulit dipelihara. Jalur praktisnya adalah menguji beberapa suara standar terlebih dahulu, menambahkan suara klon begitu identitas Anda penting, dan memperkenalkan API serta dubbing multibahasa ketika operasi Anda melampaui render manual.
Pertanyaan yang Sering Diajukan
Bisakah saya menggunakan suara AI DubSmart pada video YouTube saya?
Alat Text to Speech dan AI Dubbing kami dibangun bagi kreator dan bisnis untuk memproduksi voiceover untuk konten publik, termasuk YouTube, di bawah model penggunaan berbasis kredit. Anda tetap bertanggung jawab untuk mematuhi ketentuan YouTube, kebijakan periklanan, dan regulasi lokal, tetapi platform kami dirancang untuk penggunaan media komersial.
Berapa banyak audio yang saya butuhkan untuk mengklon suara saya?
Anda membutuhkan setidaknya 20 detik ucapan bersih tanpa kebisingan latar belakang untuk membuat suara klon yang dapat digunakan. Semakin bersih rekamannya, semakin akurat dan alami hasilnya, jadi sampel sunyi khusus mengalahkan audio bising yang digunakan kembali.
Apakah suara klon saya akan berfungsi dalam beberapa bahasa?
Ya. Suara klon dapat digunakan baik di Text to Speech maupun AI Dubbing, yang mendukung banyak bahasa dan 33 bahasa target untuk dubbing. Anda mempertahankan identitas suara yang sama di seluruh skrip dalam bahasa berbeda, meskipun pengucapan dan aksen mengikuti model sintesis alih-alih ucapan manusia asli di setiap kasus.
Bisakah saya beralih dari suara standar ke suara klon nanti?
Ya. Kami memperlakukan suara klon sebagai suara yang dapat digunakan kembali dalam katalog yang sama dengan suara AI standar, sehingga Anda dapat memulai dengan suara standar dan nanti mengalihkan proyek ke suara klon menggunakan antarmuka atau API Text to Speech dan AI Dubbing yang sama, tanpa membangun ulang alur kerja Anda.
Bagaimana API membantu produksi YouTube?
API Text to Speech, Voice Cloning, dan AI Dubbing kami memungkinkan Anda mengonversi skrip menjadi ucapan, mengklon suara, dan men-dubbing video melalui endpoint RESTful. Itu membuatnya praktis untuk mengotomatiskan format berulang, menyambungkan voiceover ke dalam CMS atau alur pengeditan yang sudah ada, dan menskalakan ke banyak saluran atau bahasa tanpa memicu setiap render secara manual.