Tanyakan bagaimana cara kerja neural text to speech dan jawaban singkatnya adalah ini: teknologi ini mengubah teks tertulis menjadi audio yang terdengar hidup dengan menjalankan naskah Anda melalui jaringan saraf tiruan mendalam yang memodelkan bagaimana manusia sebenarnya berbicara—pelafalan, ritme, dan intonasi secara bersamaan. Alih-alih menyatukan fragmen yang sudah direkam sebelumnya seperti yang dilakukan sistem lama, neural TTS menghasilkan ucapan dari nol, mempelajari pola langsung dari kumpulan data besar rekaman manusia asli yang dipasangkan dengan teks. Perbedaan itulah yang membuat suara sintetis modern terdengar seperti narator yang bisa Anda dengarkan sepanjang video, bukan pengumuman yang robotik. Di DubSmart AI, kami membangun pendekatan neural yang sama untuk menggerakkan Text to Speech kami, menghubungkannya dengan kloning suara dan dubbing sehingga satu naskah dapat berpindah dari satu bahasa ke banyak bahasa.
Panduan ini menjelaskan mekanismenya tahap demi tahap, lalu menerjemahkannya menjadi keputusan praktis: di mana suara neural cukup kuat untuk berdiri sendiri, di mana Anda masih menginginkan performa manusia, dan bagaimana semua bagian ini saling melengkapi di dalam platform kami.
Daftar isi
Apa arti sebenarnya dari "cara kerja neural text to speech"
Neural text to speech adalah bentuk sintesis ucapan yang menggunakan jaringan saraf tiruan mendalam untuk menghasilkan ucapan dari nol. Perbedaan utama dari metode berbasis aturan atau konkatenatif adalah bahwa sistem ini belajar dari kumpulan data besar rekaman manusia yang dipasangkan dengan teks, sehingga dapat memprediksi baik bagaimana kata-kata seharusnya terdengar maupun bagaimana seseorang secara alami akan menyampaikannya. Perilaku yang dipelajari itulah yang menangkap prosodi—tekanan, ritme, jeda, dan nada emosional—membuat suara yang dihasilkan nyaman untuk sesi mendengarkan yang panjang. Penyedia cloud besar menggambarkan suara neural ini sebagai ucapan sintesis yang menyerupai manusia yang artikulasinya mengurangi kelelahan mendengarkan pada asisten, alat aksesibilitas, dan pengalaman baca-nyaring.
Mesin Text to Speech kami mengikuti jalur neural ini. Mesin ini menganalisis naskah Anda, memecahnya menjadi fonem, menyimpulkan ritme dan intonasi, lalu menggunakan model neural untuk merender audio yang halus alih-alih penyampaian datar yang terkait dengan TTS lama. Hasilnya adalah ucapan realistis yang dihasilkan dari teks dalam hitungan detik, diambil dari pustaka berisi 300+ suara yang disesuaikan untuk berbagai nada dan kasus penggunaan.
Mengapa neural TTS penting bagi kreator dan tim
Bagi kreator YouTube, bisnis kecil, produser e-learning, pembuat film, podcaster, dan pengembang, pertanyaan sebenarnya bukan hanya bagaimana teknologi ini bekerja tetapi apakah harus mengandalkannya dalam pipeline produksi. Neural TTS penting karena teknologi ini memindahkan suara sintetis keluar dari wilayah "utilitas"—petunjuk GPS, prompt dasar—dan ke wilayah performer: cukup baik untuk menjadi konten garis depan, menarasikan seluruh kursus, dan membawa pesan bermerek tanpa terdengar jelas artifisial. Padukan dengan terjemahan dan dubbing, dan teknologi ini menjadi pengganda, memungkinkan satu naskah menjangkau puluhan bahasa dengan biaya dan waktu yang jauh lebih sedikit dibandingkan pekerjaan studio tradisional.
Kami merancang DubSmart tepat di sekitar keputusan itu. Text to Speech, Voice Cloning, AI Dubbing, Speech to Text, Speech Separator, Text to Image, dan Image to Video berada dalam satu pipeline, sehingga konten lisan berpindah dari unggah ke ekspor multibahasa tanpa harus menggunakan alat-alat terpisah. Anda memilih seberapa banyak yang ingin diotomatisasi dan seberapa banyak yang ingin disesuaikan di setiap tahap—naskah, suara, bahasa, mix—dalam satu lingkungan.
Di mana hal ini berdampak tergantung pada apa yang Anda buat:
- Memperluas kanal YouTube ke bahasa baru: neural TTS ditambah dubbing memungkinkan Anda menggunakan kembali naskah dan pengaturan waktu sambil mengganti dengan suara yang dilokalkan.
- Melokalkan video pemasaran atau pelatihan: Anda mendapatkan narasi merek yang konsisten di berbagai bahasa tanpa harus memesan pengisi suara untuk setiap pembaruan.
- Memproduksi e-learning atau pelatihan korporat: narasi format panjang menjadi mudah diskalakan dan mudah direvisi ketika konten berubah.
- Menjalankan podcast atau film independen: Anda dapat membuat versi multibahasa, sisipan narasi, atau trek aksesibilitas.
- Membangun aplikasi: API kami mengubah ucapan neural menjadi layanan yang dapat dipanggil untuk IVR, agen, dan alat konten.
Memahami mekanismenya membantu Anda menilai di mana suara neural dapat berdiri sendiri dan di mana rekaman manusia sebaiknya tetap menjadi sumber untuk kloning atau dubbing.
Di balik layar: pipeline neural TTS
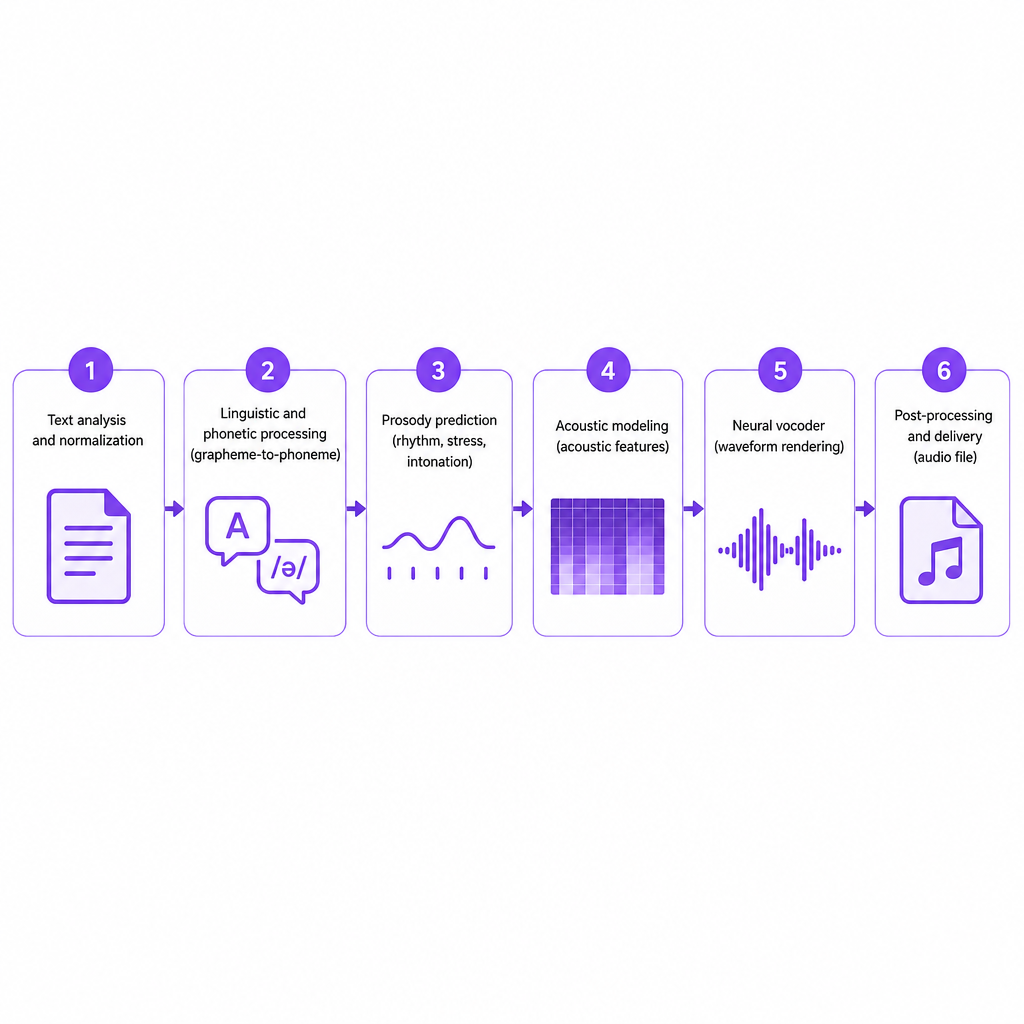
Mesin-mesin berbeda dalam detailnya, tetapi mereka berbagi pipeline yang secara garis besar serupa yang dijelaskan dalam dokumentasi teknis dan pengungkapan AI yang bertanggung jawab dari penyedia besar, dan penjelasan kami sendiri tentang bagaimana voiceover AI dibuat selaras dengan itu.
Analisis dan normalisasi teks
Pertama sistem menyerap teks Anda dan menormalkannya menjadi bentuk yang dapat diucapkan. Itu berarti memperluas angka ("2026" menjadi "dua ribu dua puluh enam"), tanggal, dan singkatan; menyelesaikan token yang ambigu seperti "US" versus "us" berdasarkan konteks; dan membaca tanda baca serta struktur untuk merencanakan jeda dan penekanan. Mesin kami menginterpretasikan tanda baca dan struktur untuk menyimpulkan ritme dan alur alih-alih memperlakukan teks sebagai aliran karakter yang datar. Tahap ini memiliki bobot nyata untuk naskah yang lebih panjang—kursus, penjelasan, podcast—di mana struktur paragraf dan judul membentuk bagaimana manusia secara alami akan membaca.
Pemrosesan linguistik dan fonetik
Teks yang telah dinormalkan diubah menjadi fonem, unit suara dasar suatu bahasa. Model grafem-ke-fonem memetakan karakter ke suara, menangani aturan pelafalan, pengecualian, dan input multibahasa. Inilah yang memungkinkan Text to Speech kami menerima naskah di banyak bahasa dan menghasilkan urutan fonetik yang benar untuk bahasa yang dipilih, baik Anda menggunakan suara bawaan maupun suara hasil kloning. Suara neural kami mencakup lebih dari 33 bahasa, termasuk Inggris, Portugis, Spanyol, Prancis, Jerman, Mandarin, dan Jepang.
Prediksi prosodi
Prosodi—ritme, tekanan, dan intonasi—adalah perbedaan antara suara robotik dan performa yang menyerupai manusia. Model neural mempelajari pola prosodi langsung dari rekaman, sehingga mereka dapat memutuskan di mana harus berhenti dan berapa lama, memilih kata mana yang membawa penekanan, dan menyesuaikan nada serta energi di sepanjang kalimat atau paragraf. Suara neural definisi tinggi melangkah lebih jauh, mendeteksi sentimen dalam teks dan menyesuaikan nada sambil mempertahankan persona yang stabil, yang memungkinkan penyampaian percakapan atau empatik untuk konten dukungan dan narasi. Mesin kami menyimpulkan prosodi sebelum mensintesis audio dengan alasan yang sama: untuk menghindari penyampaian yang datar dan menghasilkan ucapan yang bisa Anda dengarkan sepanjang satu modul penuh.
Pemodelan akustik
Setelah fonem dan prosodi ditetapkan, model akustik neural mengubah representasi tersebut menjadi fitur akustik—cetak biru untuk gelombang suara. Pengungkapan AI yang bertanggung jawab mencatat bahwa, selain rekaman dari pengisi suara tertentu, model-model ini juga menarik dari pustaka sumber yang lebih luas dari banyak pembicara. Campuran itu membantu jaringan mempelajari pola bicara umum sambil tetap menangkap timbre, aksen, dan gaya suara tertentu. Di platform kami, pemodelan inilah yang membuat 300+ suara terdengar berbeda namun natural, dan menjadi dasar kloning suara cepat, di mana sistem mempelajari tanda tangan akustik dan prosodi suara dari sampel singkat.
Vocoder dan rendering audio
Fitur akustik diteruskan ke vocoder neural, yang merendernya menjadi gelombang audio penuh. Vocoder yang lebih baru menghasilkan ucapan berkualitas tinggi yang hampir tidak dapat dibedakan dari rekaman studio, dengan konsonan yang jelas, vokal yang halus, dan artefak yang minimal. Kombinasi model akustik neural ditambah vocoder adalah alasan mengapa suara neural terdengar jauh lebih natural daripada teknologi lama yang digunakan pada pembaca layar tradisional dan IVR. Kami menggunakan kemajuan serupa sehingga audio yang dihasilkan siap dipublikasikan secara langsung atau dimasukkan ke dalam mix dengan musik dan efek suara.
Pasca-pemrosesan dan pengiriman
Terakhir sistem mungkin menerapkan pasca-pemrosesan—penyesuaian noise, normalisasi kenyaringan, atau konversi format—sebelum mengembalikan file audio. Untuk alur kerja API, ini dibungkus dalam endpoint RESTful yang menerima parameter teks dan suara serta mengembalikan aset yang siap digunakan. Text to Speech kami mengikuti alur ini persis: tempel atau kirim teks, pilih bahasa dan suara, sesuaikan penyampaian di mana kontrol tersedia, hasilkan, dan unduh audio format standar. Mesin yang sama berada di balik AI Dubbing kami, di mana transkripsi, terjemahan, dan sintesis dirangkai untuk membuat versi multibahasa.
Pilihan di dalam DubSmart: suara, kloning, dubbing, dan API
Memahami mekanismenya menjelaskan mengapa rangkaian fitur kami dibangun sedemikian rupa.
Text to Speech untuk narasi langsung
Alat Text to Speech kami adalah antarmuka inti untuk mengubah naskah menjadi audio. Anda menempel atau mengunggah teks dalam bahasa apa pun yang didukung, memilih dari 300+ suara yang terdengar natural, mengatur bahasa dan kontrol penyampaian dasar jika tersedia, dan menghasilkan ucapan dalam hitungan detik. Ini mencakup hook YouTube dan narasi video penuh, voiceover penjelasan dan promo untuk bisnis kecil, modul e-learning dan pelatihan yang jelas, serta intro, outro, dan mid-roll podcast. Jika Anda sedang mempertimbangkan alat untuk pekerjaan itu, rangkuman kami tentang software AI dubbing terbaik untuk kreator menunjukkan bagaimana narasi dan lokalisasi terhubung.
Kloning suara: mempertahankan suara merek atau pembawa acara Anda
Kloning suara dibangun di atas langkah-langkah neural yang sama—fonem, prosodi, fitur akustik—tetapi mengoptimalkan jaringan untuk mencocokkan timbre dan gaya tertentu, sehingga Anda dapat menghasilkan baris baru dalam suara itu tanpa merekam ulang. Kloning suara cepat kami membuat suara khusus yang dapat Anda gunakan di dalam Text to Speech atau AI Dubbing, yang berarti konten yang dilokalkan tetap terdengar seperti pembawa acara, narator, atau merek Anda. Kontinuitas itu paling penting bagi kanal dan perusahaan yang telah berinvestasi pada identitas suara yang dapat dikenali.
AI Dubbing: merangkai speech to text, terjemahan, dan TTS
AI dubbing menggunakan mesin TTS sebagai langkah terakhir dalam rangkaian yang lebih panjang: mentranskripsi audio yang ada, menerjemahkan transkrip, lalu mensintesis ucapan baru dalam bahasa target. AI Dubbing kami menjaga dubbing, text-to-speech, speech-to-text, dan kloning dalam satu alur kerja sehingga konten berpindah dari unggah ke ekspor multibahasa tanpa meninggalkan platform. Dalam praktiknya Anda dapat mengunggah video atau podcast, mentranskripsikannya dan memisahkannya dari audio latar, menerjemahkan ke satu atau beberapa bahasa, lalu menghasilkan trek dubbing menggunakan suara stok atau kloning yang mempertahankan pengaturan waktu dan nada. Untuk panduan langkah demi langkah tentang konten lisan, lihat panduan kami tentang cara menerjemahkan podcast ke bahasa lain.
API untuk pengembang dan agensi
Kami menyediakan neural TTS dan dubbing melalui API sehingga pengembang dan agensi dapat mengintegrasikan pembuatan suara ke dalam produk mereka sendiri. API Text to Speech kami adalah layanan RESTful yang menerima permintaan POST dengan konten teks dan preferensi suara serta mengembalikan audio berkualitas tinggi, dengan akses ke suara neural premium dalam lebih dari 33 bahasa. API AI Dubbing memperluas itu ke dubbing multibahasa otomatis. Bagi agensi yang menangani lokalisasi di berbagai klien, endpoint ini menstandarkan pembuatan suara sambil tetap menyesuaikan bahasa dan persona per merek.
Kriteria keputusan: memilih dan menggunakan neural TTS dengan baik
Setelah mekanismenya jelas, pekerjaan praktisnya adalah memutuskan kapan dan bagaimana menggunakannya.
Kenaturalan dan kenyamanan mendengarkan. Uji inti adalah apakah suara cukup natural untuk diterima audiens Anda sebagai narator utama. Jaringan saraf tiruan mendalam dan suara HD dibangun untuk mengurangi kelelahan mendengarkan, tetapi pilihan yang tepat tetap tergantung pada jenis konten. Gunakan pustaka suara besar kami untuk menguji persona—energik, tenang, ceria, otoritatif—dan untuk kursus atau podcast format panjang, utamakan suara yang prosodinya terasa seperti percakapan alih-alih seperti pengumuman.
Cakupan bahasa dan kesesuaian aksen. Untuk ekspansi multibahasa Anda memerlukan baik bahasa maupun aksen yang sesuai untuk audiens target. Suara neural kami mencakup lebih dari 33 bahasa di berbagai pasar besar. Saat memilih trek yang dilokalkan, putuskan apakah Anda menginginkan aksen netral atau spesifik daerah, dan uji sampel dengan penutur asli jika memungkinkan.
Konsistensi merek versus fleksibilitas. Kloning membawa suara tertentu ke berbagai bahasa dan proyek, tetapi memperkenalkan tanggung jawab terkait persetujuan dan pengungkapan. Gunakan ketika persona yang konsisten menjadi inti merek Anda, dan dokumentasikan siapa yang memiliki dan mengendalikan suara itu—terutama dalam pekerjaan perusahaan atau agensi.
Integrasi alur kerja. Neural TTS memberikan nilai terbesar ketika terpasang ke dalam cara Anda sudah bekerja. Karena alat kami menggabungkan text-to-speech, kloning, dubbing, speech to text, dan utilitas media, Anda dapat mengotomatiskan sebagian besar rantai lokalisasi sambil tetap mengedit naskah dan audio. Kreator solo mungkin menemukan alat browser sudah cukup; pengembang dan agensi mendapatkan endpoint yang dapat diprogram untuk penskalaan.
Risiko, batasan, dan penggunaan yang bertanggung jawab
Bahkan model canggih memiliki batasan yang perlu direncanakan.
- Nuansa emosional: Suara HD merespons sentimen, tetapi mungkin melewatkan isyarat halus atau performa kompleks yang dapat disampaikan oleh aktor terampil. Pesan merek yang kritis atau drama naratif mungkin masih memerlukan rekaman manusia sebagai sumbernya.
- Kasus khusus pelafalan: Nama langka, istilah baru, atau naskah campuran bahasa dapat menantang model grafem-ke-fonem, jadi bangun pemeriksaan manual.
- Etika kloning: Panduan AI yang bertanggung jawab menekankan bahwa suara khusus harus dibangun dan digunakan dengan persetujuan eksplisit, kontrak yang jelas, dan pengungkapan kepada audiens. Meniru orang tanpa izin menimbulkan kekhawatiran hukum dan etika.
- Bias dan representasi: Data pelatihan membentuk bagaimana suara menangani aksen dan dialek, jadi periksa bahwa suara yang Anda pilih secara adil mewakili audiens Anda dan menghindari penguatan stereotip.
Karena alur kerja terintegrasi kami memudahkan pembuatan dan penerapan ucapan sintetis, tinjauan internal menjadi lebih penting, bukan kurang penting—terutama ketika Anda menangani suara klien atau karyawan. Jalur konkret membantu: seorang kreator dapat menulis satu naskah bahasa Inggris, menghasilkan voiceover bahasa Inggris, lalu men-dub versi Spanyol, Portugis, dan Jerman untuk kanal tambahan sambil mempertahankan pengaturan waktu dan penyampaian yang sama. Tim pelatihan dapat membangun narasi modular dan menghasilkannya kembali dengan cepat kapan pun kebijakan berubah. Itulah keuntungan nyata dari memahami pipeline—Anda tahu tahap mana yang harus dikendalikan dan mana yang harus dibiarkan ditangani model.
Pertanyaan yang sering diajukan
Apa itu neural text to speech dalam istilah sederhana?
Neural text to speech adalah AI yang mengubah teks tertulis menjadi ucapan menggunakan jaringan saraf tiruan mendalam yang dilatih pada kumpulan data besar rekaman manusia, menghasilkan suara yang terdengar jauh lebih mirip orang sungguhan dibandingkan sistem TTS lama.
Apa bedanya Text to Speech DubSmart dari TTS dasar?
Kami menggunakan model neural yang menganalisis naskah Anda, menyimpulkan prosodi, dan mensintesis ucapan dari nol, didukung oleh 300+ suara natural dan kloning suara cepat, sehingga hasilnya berfungsi sebagai narator utama untuk video, kursus, dan podcast.
Dapatkah DubSmart mempertahankan suara saya sendiri dalam bahasa lain?
Ya. Kloning suara kami dapat mempelajari suara Anda dari rekaman lalu menggunakannya dalam text-to-speech dan AI dubbing, sehingga versi konten Anda yang dilokalkan tetap terdengar seperti Anda atau narator merek Anda.
Bagaimana AI dubbing bekerja dengan neural TTS?
AI dubbing merangkai transkripsi speech-to-text, terjemahan, dan neural text-to-speech, mengubah audio Anda yang sudah ada menjadi trek dubbing multibahasa dalam satu alur kerja, menggunakan suara stok atau suara kloning Anda.
Apakah neural text to speech aman dan etis untuk digunakan?
Digunakan dengan persetujuan, pengungkapan yang jelas, dan pengamanan yang sesuai, neural TTS adalah alat yang kuat untuk aksesibilitas dan lokalisasi. Panduan AI yang bertanggung jawab menekankan penghormatan terhadap hak pengisi suara dan menghindari penggunaan suara sintetis yang menyesatkan.