Wenn Sie schon einmal eine flüssige YouTube-Erzählung oder eine klare E-Learning-Lektion gehört und sich gefragt haben, ob tatsächlich ein Mensch sie aufgenommen hat, sind Sie der Technologie hinter dieser Frage bereits begegnet. Was ist ein KI-Stimmengenerator? Einfach ausgedrückt ist es Software, die geschriebenen Text oder eine Audioreferenz mithilfe von maschinellen Lernmodellen in gesprochenes Audio umwandelt, sodass Sie Erzählungen erstellen können, ohne für jede Skriptänderung ein Studio, ein Mikrofon oder einen Sprecher zu buchen. Diese eine Fähigkeit verändert, wie Creator, Marketer, Kurs-Ersteller und Entwickler ihre Audioarbeit planen.
Dieser Leitfaden erklärt, was ein KI-Stimmengenerator tatsächlich ist, wie er Sprache erzeugt, wie er mit Text-to-Speech und Voice-Cloning zusammenhängt und welche Kriterien wirklich wichtig sind, wenn Sie einen auswählen. Wir konzentrieren uns auf die Entscheidung, nicht auf den Hype: Realismus allein ist ein schwacher Grund, ein Werkzeug zu wählen, denn Aussprachesteuerung, Sprachabdeckung, Rechte und Datenschutz entscheiden in der Regel darüber, ob ein Projekt sauber umgesetzt werden kann.
Inhaltsverzeichnis
Wie ein KI-Stimmengenerator tatsächlich Sprache erzeugt
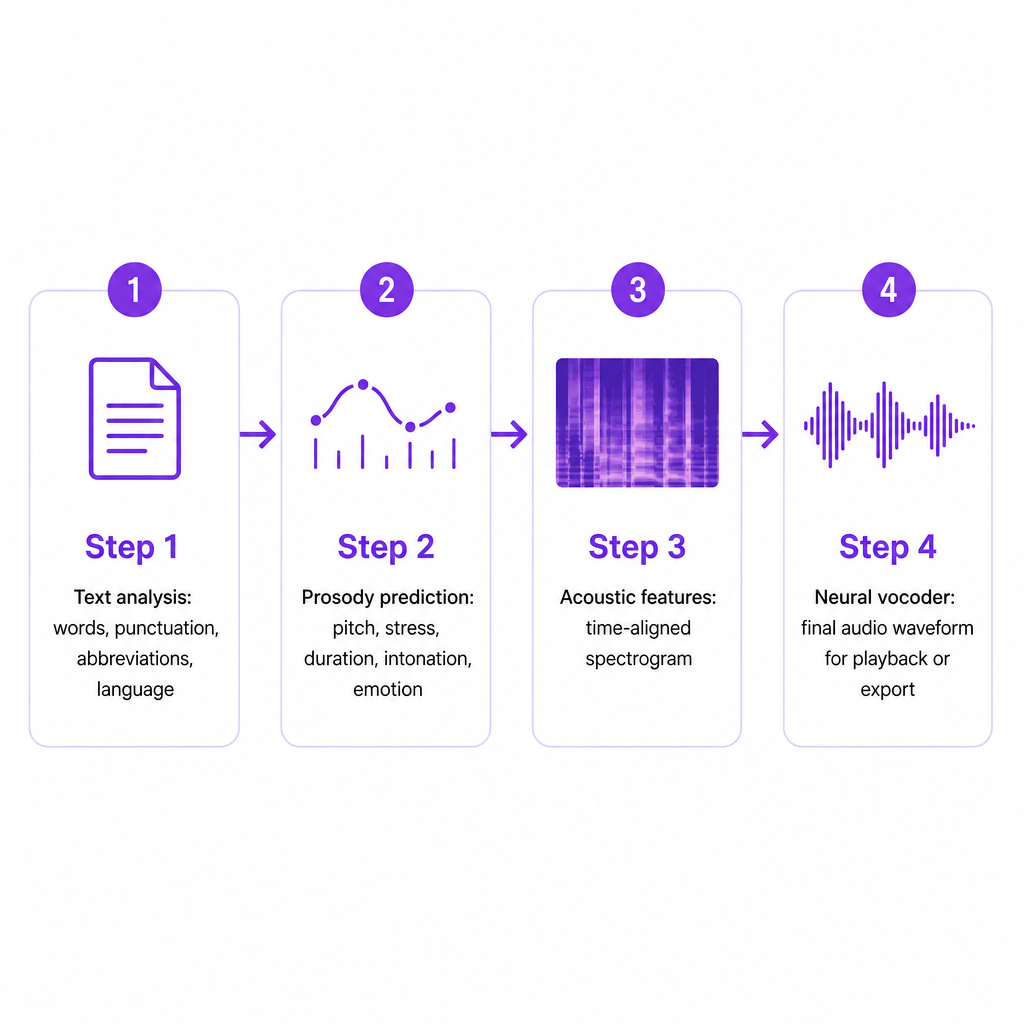
Die meisten KI-Stimmengeneratoren laufen auf Text-to-Speech- bzw. TTS-Modellen, und die Arbeit findet in zwei großen Phasen statt: Das System analysiert Ihren Text und synthetisiert dann aus dieser Analyse Audio. IBM beschreibt TTS-Systeme so, dass sie Wörter, Interpunktion, Satzstruktur, Aussprache, Timing und Prosodie analysieren, bevor sie das Ergebnis in eine Audiowellenform umwandeln.
In der Analysephase liest das Modell mehr als die reinen Buchstaben. Es erkennt Satzgrenzen, Interpunktion und Pausen, Abkürzungen und Zahlen sowie die beabsichtigte Sprache oder den Akzent. Das ist wichtig, weil geschriebener Text selten verrät, wie er klingen soll. „Dr." muss möglicherweise zu „Doktor" werden, und ein Produktname oder ein technisches Akronym braucht unter Umständen eine individuelle Aussprache, die keine Standardregel erraten würde.
Als Nächstes sagt das Modell die Darbietung voraus: Tonhöhe, Betonung, Phonemdauer, Rhythmus, Intonation und emotionalen Tonfall. Zusammengefasst nennt man das Prosodie, und sie ist es, die eine monotone Lesung von einer Erzählung unterscheidet, die eine Frage von einer Aussage trennt. Das System wandelt diese Analyse dann in zeitlich ausgerichtete akustische Merkmale um, die oft als Spektrogramm dargestellt werden, das Frequenzänderungen über die Zeit abbildet.
Schließlich verwandelt ein neuronaler Vocoder diese akustischen Merkmale in eine digitale Audiowellenform, die Ihr Editor abspielen oder exportieren kann. IBM weist darauf hin, dass neuronale TTS-Systeme die Beziehung zwischen Sprache und akustischen Merkmalen aus Trainingsdaten lernen, die Aufnahmen und passende Transkriptionen enthalten. Wenn Sie die tiefere Mechanik dieser Phase verstehen möchten, erklärt unser Beitrag dazu, wie neuronales Text-to-Speech funktioniert, die Pipeline weiter im Detail.
KI-Stimmengenerator vs. Text-to-Speech vs. Voice-Cloning
Diese Begriffe treten gemeinsam auf, weshalb man annimmt, sie seien dasselbe. Das sind sie nicht, und die Unterschiede verändern, was Sie rechtlich und praktisch mit dem Ergebnis tun können.
| Technologie | Was sie tut | Typische Eingabe | Am besten geeignet für |
|---|---|---|---|
| KI-Stimmengenerator | Oberbegriff für Software, die synthetische Sprache erzeugt | Text, Stimmeinstellungen oder eine Audioreferenz | Voiceovers, Erzählungen, Assistenten, Inhalte |
| Text-to-Speech | Wandelt ein geschriebenes Skript in gesprochenes Audio um | Geschriebenes Skript | Erzählungen, Barrierefreiheit, E-Learning, Podcasts |
| Voice-Cloning | Erstellt eine synthetische Stimme nach dem Vorbild eines bestimmten Sprechers | Autorisierte Stimmaufnahmen | Konsistente Marken- oder Creator-Erzählung, Charaktere |
| Speech-to-Speech | Erstellt gesprochenes Audio neu und behält dabei die Darbietung bei | Aufgenommene Sprache | Synchronisation, Stimmkonvertierung, Übertragung der Darbietung |
| KI-Synchronisation | Übersetzt und vertont bestehende Medien in einer anderen Sprache neu | Video oder Audio | Mehrsprachige Veröffentlichung und Lokalisierung |
Der praktische Unterschied liegt in der Eingabe und der damit verbundenen Berechtigung. Eine Standard-TTS-Stimme wird aus der Bibliothek eines Anbieters ausgewählt, sodass Sie sie sofort verwenden können. Eine geklonte Stimme wird aus den Aufnahmen einer bestimmten Person erstellt, was bedeutet, dass Einwilligung und Nutzungsrechte ins Spiel kommen, bevor Sie auch nur ein einziges Wort generieren. Die beiden als austauschbar zu behandeln ist der häufigste Anfängerfehler – und derjenige mit den größten rechtlichen Folgen.
Was Sie damit erstellen können
Die Bandbreite der Ergebnisse ist groß: YouTube-Erzählungen, Kurzvideo-Voiceovers für Social Media, Podcast-Intros, Hörbuch-Entwürfe, Produktdemos, Online-Kurslektionen, betriebliche Schulungsmodule, Erklärvideos, Spieldialoge, Kundenservice-Ansagen, Audio für Barrierefreiheit und mehrsprachige Versionen all dessen.
Der Mehrwert steigt stark, wenn sich Inhalte häufig ändern, mehrere Sprachen benötigt werden oder verschiedene Versionen für unterschiedliche Zielgruppen erforderlich sind. Ein kleines Unternehmen kann ein Produktskript schreiben und lokalisierte Varianten erzeugen. Ein YouTube-Creator kann eine überarbeitete Einleitung ersetzen, ohne das gesamte Video neu aufzunehmen. Ein E-Learning-Team kann eine Lektion aktualisieren, nachdem einige Sätze bearbeitet wurden, anstatt einen Sprecher erneut zu buchen. Wenn Ihr Audio einmal produziert und nie wieder angefasst wird, hilft ein Generator weniger; wenn es ständig wechselt, hilft er umso mehr. Unsere Anleitung dazu, wie Sie Text online schnell in Sprache umwandeln, zeigt, wie dieser erste Entwurf in der Praxis entsteht.
Gängige Arten von KI-generierten Stimmen
Nicht jede Stimmoption bringt den gleichen Einrichtungsaufwand oder die gleichen Rechteverpflichtungen mit sich, daher hilft es, drei praktische Kategorien zu unterscheiden, bevor Sie sich festlegen.
Vorgefertigte Stimmen sind fertige synthetische Stimmen, die von der Plattform bereitgestellt werden, meist sortiert nach Stil, Geschlechterdarstellung, Altersbereich, Akzent, Sprache, Energie und Erzähltyp. Sie sind sofort verfügbar und benötigen keine Einwilligungsunterlagen, was sie zur richtigen Standardwahl macht, wenn Geschwindigkeit und Konsistenz wichtiger sind als die Übereinstimmung mit einer bestimmten Person.
Individuelle oder geklonte Stimmen werden aus Aufnahmen eines bestimmten Sprechers erzeugt, sodass ein Creator, eine Marke oder eine Organisation über viele Videos hinweg einen erkennbaren Erzähler beibehalten kann. Da eine Stimme mit der Identität und dem Ruf einer realen Person verbunden sein kann, sollte Cloning nur mit der informierten Zustimmung des Sprechers und innerhalb der Nutzungsregeln des Anbieters erfolgen.
Charakter- und ausdrucksstarke Stimmen zielen auf Storytelling, Spiele, Animation oder Marketing ab und bieten oft eine feinere Kontrolle über Tempo, Betonung, Emotion und Sprechstil. Ausdrucksstärke kann das Engagement steigern, muss aber zur Aufgabe passen: Eine dramatische Lesung passt zu einem fiktiven Trailer und schadet einer medizinischen Anweisung oder einem Compliance-Hinweis aktiv.
Die Kriterien, die entscheiden, welches Werkzeug passt
Der beste KI-Stimmengenerator hängt von dem Ergebnis ab, das Sie benötigen, nicht davon, wie gut ein Demo-Clip klingt. Hier ist, was ein Werkzeug, das Sie veröffentlichen können, tatsächlich von einem unterscheidet, mit dem Sie kämpfen.
Stimmqualität, ehrlich getestet. Lassen Sie ein repräsentatives Skript durchlaufen, nicht einen kurzen Werbesatz. Fügen Sie die echten Namen, die Terminologie, die Interpunktion und die Satzlängen aus Ihrem Projekt ein und hören Sie dann auf falsch ausgesprochene Namen, unpassende Pausen, unnatürliche Betonung, wiederholte Wörter und flache oder übertriebene Emotion.
Sprach- und Akzentabdeckung. Vergewissern Sie sich, dass das Werkzeug genau die Sprachen und regionalen Akzente unterstützt, die Sie benötigen. Eine Plattform unterstützt eine Sprache möglicherweise in ihrer Oberfläche, bietet darin aber weniger Stimmen oder eine schwächere Aussprache. Für die Lokalisierung prüfen Sie außerdem, ob sie Übersetzung, Synchronisation, Stimmkonsistenz über Sprachen hinweg und zeitliche Abstimmung bewältigt.
Aussprache- und Darbietungssteuerung. Sie brauchen eine zuverlässige Möglichkeit, Namen, Akronyme und Zahlen über Ausspracheverzeichnisse, phonetische Schreibweisen oder bearbeitbare Formatierung zu korrigieren, plus Steuerungen für Tempo, Pausen, Betonung, Tonhöhe, Tonfall und emotionale Darbietung. Mit unserem Text-to-Speech-Tool können Sie aus über 300 KI-Stimmen wählen, die Sprechgeschwindigkeit anpassen, Emotionen über Dialog-Tags hinzufügen, Wörter betonen und Zahlen ausschreiben, wenn die Aussprache korrigiert werden muss.
Bearbeitungs-, Export- und API-Optionen. Ein Browser-Editor mag für Creator ausreichen. Entwicklern und Agenturen geht es oft eher darum, Audio automatisch innerhalb einer Anwendung oder einer Video-Pipeline zu generieren, wo Authentifizierung, unterstützte Formate, synchrone versus asynchrone Generierung, Ratenbegrenzungen und vorhersehbare Preise allesamt wichtig sind. Wenn Sie den programmatischen Einsatz abwägen, deckt unsere Einführung dazu, was eine Voice-AI-API ist, diese Bewertungspunkte im Detail ab.
Kommerzielle Rechte und Nutzungsbedingungen. Bestätigen Sie vor der Veröffentlichung, ob die kommerzielle Nutzung erlaubt ist, ob das Audio in bezahlten Anzeigen laufen darf, ob Cloning eine Einwilligungsdokumentation erfordert und ob sich die Lizenz nach Ablauf eines Abonnements ändert. Gehen Sie nicht davon aus, dass ein kostenloser Tarif uneingeschränkte kommerzielle Rechte gewährt.
Datenschutz und Datenverarbeitung. Stimmaufnahmen können biometrische, persönliche oder kommerziell sensible Informationen enthalten. Prüfen Sie Speicherdauer, Löschkontrollen, Verschlüsselung und Trainingsdaten-Richtlinien, insbesondere bei Mitarbeiteraufnahmen, Kundengesprächen, unveröffentlichten Medien und geklonten Stimmen.
Einschränkungen und Risiken, die man ernst nehmen sollte
KI-Stimmerzeugung ist nützlich, aber nicht unfehlbar, und einige Risiken verdienen echte Aufmerksamkeit.
Aussprache- und Kontextfehler sind an der Tagesordnung: Modelle lesen Namen, Homographen, Zahlen und Fachbegriffe falsch, weshalb juristische, finanzielle, medizinische, pädagogische und technische Inhalte vor der Veröffentlichung immer ein Durchhören brauchen. Auch die Emotion kann danebengehen; eine Stimme kann Satz für Satz natürlich klingen und dennoch die falsche Betonung treffen, was ablenkend oder sogar irreführend wirkt.
Die schwereren Risiken betreffen die Identität. Voice-Cloning kann missbraucht werden, um Familienmitglieder, Führungskräfte oder Personen des öffentlichen Lebens zu imitieren. Die Federal Trade Commission warnt, dass Betrüger geklonte Stimmen verwenden, um Forderungen nach Geld oder persönlichen Informationen glaubwürdiger erscheinen zu lassen, und empfiehlt, den vermeintlichen Sprecher unabhängig über eine vertrauenswürdige Nummer oder einen anderen bekannten Kanal zu kontaktieren. NIST stuft synthetische Inhalte, einschließlich Audio, ebenfalls als Material ein, das genutzt werden kann, um Menschen in die Irre zu führen oder Betrug zu unterstützen, einschließlich Versuchen, biometrische Authentifizierung zu überwinden.
Das führt zu einem praktischen Verantwortungskatalog: Erzeugen Sie Stimmen nur aus Text und Aufnahmen, zu deren Nutzung Sie berechtigt sind, holen Sie eine klare Einwilligung ein, bevor Sie jemanden klonen, führen Sie Einwilligungsnachweise und setzen Sie niemals eine geklonte Stimme zur Täuschung ein. Prüfen Sie das Skript vor der finalen Generierung auf Fakten, legen Sie synthetische Erzählung offen, wenn Transparenz angebracht oder erforderlich ist, schützen Sie hochgeladene Aufnahmen und weisen Sie Inhalten mit großer Wirkung einen menschlichen Prüfer zu. Die Automatisierung erzeugt das Audio; sie bürgt nicht für Richtigkeit, kulturelle Passung oder Sicherheit.
KI-Stimme oder ein menschlicher Sprecher?
Das sind keine automatischen Ersatzlösungen, und die ehrliche Antwort für viele Teams lautet „beides, für unterschiedliche Aufgaben".
| Aspekt | KI-Stimmengenerator | Menschlicher Sprecher |
|---|---|---|
| Produktionsgeschwindigkeit | Schnell für Überarbeitungen und mehrere Versionen | Benötigt Terminplanung und Aufnahme |
| Kostenstruktur | In der Regel nutzungs- oder abobasiert | Honorare für Talent und Studio |
| Konsistenz | Wiederholbar bei großen Mengen | Hängt von Bedingungen und Regie ab |
| Emotionale Nuancen | Verbessert sich, variiert je nach Werkzeug und Skript | Reagiert dynamisch auf Regie |
| Rechteverwaltung | Benötigt Prüfung von synthetischer Stimme und Lizenz | Benötigt Talent- und Nutzungsvereinbarungen |
| Bester Anwendungsfall | Inhalte mit hohem Volumen, Überarbeitungen, mehrsprachig | Premium- und emotional komplexe Arbeiten |
Eine übliche Aufteilung: Lassen Sie eine KI-Stimme Entwürfe, interne Schulungen, lokalisierte Versionen und routinemäßige Aktualisierungen übernehmen, während ein menschlicher Sprecher die Vorzeigekampagne oder emotional sensibles Material trägt. Entscheiden Sie auf Basis von Qualitätsanforderungen, Rechten, Datenschutz, Prüfkapazität, Sprachabdeckung und Gesamtproduktionskosten statt allein nach Demo-Hochglanz. Wenn die Lokalisierung das Ziel ist, vertont unser KI-Synchronisations-Workflow bestehende Inhalte in 33 Sprachen neu, sodass eine Quelle mehrere Märkte erreichen kann.
Häufig gestellte Fragen
Was ist ein KI-Stimmengenerator einfach ausgedrückt?
Es ist ein Werkzeug, das gesprochenes Audio aus Text oder einer anderen Stimmeingabe erzeugt. Die meisten laufen auf Text-to-Speech-Modellen, die auf Sprachaufnahmen und Transkriptionen trainiert wurden, um synthetische Erzählungen zu produzieren.
Ist ein KI-Stimmengenerator dasselbe wie Text-to-Speech?
Nicht immer. Text-to-Speech ist eine Art der KI-Stimmerzeugung. Die umfassendere Kategorie umfasst auch Voice-Cloning, Speech-to-Speech-Konvertierung und KI-Synchronisation.
Können KI-Stimmen menschlich klingen?
Sie können sehr natürlich klingen, aber die Qualität variiert je nach Anbieter, Sprache, Stimme, Skript und Darbietung. Aussprache- und emotionale Genauigkeit benötigen vor der Veröffentlichung immer noch eine menschliche Prüfung.
Kann ich eine KI-generierte Stimme auf YouTube verwenden?
Oft ja, sofern die Lizenz des Werkzeugs Ihre beabsichtigte Nutzung erlaubt und der Inhalt den Richtlinien von YouTube folgt. Prüfen Sie die Bedingungen für die kommerzielle Nutzung, die Offenlegungsregeln sowie die Richtlinien zu irreführenden oder imitierenden Inhalten.
Sind KI-generierte Stimmen kostenlos?
Einige Dienste bieten kostenlosen Zugang oder kostenlose Credits; andere berechnen nach Zeichen, Dauer, Credits, Abonnement oder API-Nutzung. Vergleichen Sie die Gesamtkosten Ihres erwarteten Produktionsvolumens anstatt des beworbenen kostenlosen Kontingents.