Eine Voice-AI-API ist die programmierbare Verbindung, mit der Ihre Anwendung gesprochenes Audio mithilfe von KI-Modellen erstellen, verstehen, umwandeln oder lokalisieren kann, ohne dass Sie diese selbst entwickeln müssen. Sie senden Text, Audio oder Video an einen Endpunkt und erhalten etwas Nützliches zurück: synthetisierte Sprachausgabe, ein Transkript, eine individuelle Stimme oder ein vollständig synchronisiertes Video. Die eigentliche Frage am Anfang ist nicht, ob Sie „KI-Stimme“ benötigen – sondern welche Sprachfunktion Ihr Produkt tatsächlich erfordert, denn Sprachgenerierung, Spracherkennung, Voice Cloning und Synchronisation sind eigenständige Produkte, die zufällig einen Kategorienamen teilen.
Dieser Leitfaden erklärt, was der Begriff bedeutet, welche wichtigsten API-Typen es gibt und wie sie sich unterscheiden, wie eine Anfrage die Pipeline durchläuft, welche Entscheidungskriterien eine gute Wahl von einem teuren Fehler trennen und welche Risiken es sich lohnt zu managen, bevor Sie live gehen. Es ist der zentrale Ausgangspunkt unserer Entwickler- und API-Serie, daher finden Sie dort, wo es sinnvoll ist, Links zu den ausführlicheren Integrationsleitfäden.
Inhaltsverzeichnis
Was „Voice-AI-API“ tatsächlich bedeutet
Der Begriff bündelt drei Ideen. Voice AI ist künstliche Intelligenz, die mit menschlicher Sprache arbeitet oder synthetische Sprache erzeugt. API steht für Application Programming Interface – eine definierte Art und Weise, wie zwei Softwaresysteme Anfragen und Antworten austauschen. Die Kombination bedeutet, dass die aufwendige Modellverarbeitung auf der Seite des Anbieters stattfindet, während Ihre Anwendung die Benutzererfahrung, Ihre Geschäftsregeln und den endgültigen Inhalt übernimmt.
Eine Anfrage kann so einfach sein wie eine kurze JSON-Payload mit dem Text, den Sie gesprochen haben möchten, einer Stimmen-ID und einem Sprachcode. Die Antwort liefert in der Regel eine Projekt-ID, einen Verarbeitungsstatus und eine URL zum generierten Audio zurück, sobald es fertig ist. Bei der Videolokalisierung verweist die Anfrage stattdessen auf eine hochgeladene Datei und eine Liste von Zielsprachen.
Diese Struktur unterscheidet eine API von einem browserbasierten Sprachgenerator. Eine Web-App ist dafür gebaut, dass eine Person sie manuell bedient, einen Auftrag nach dem anderen. Eine API ist dafür gebaut, dass Software sie wiederholt, automatisch und in großem Umfang aufruft. Wenn Sie gelegentlich einen einzelnen Voiceover produzieren, ist das Web-Tool oft schneller. Wenn Sie jedes Video, das Sie veröffentlichen, lokalisieren, ist die API der entscheidende Vorteil.
Die fünf wichtigsten Voice-AI-API-Typen
„Voice-AI-API“ ist eine Kategorie, keine einzelne Technologie. Die fünf gängigen Typen nehmen unterschiedliche Eingaben entgegen und liefern unterschiedliche Ausgaben zurück, und die Wahl des falschen Typs verschwendet Integrationszeit. Die folgende Tabelle ordnet sie zu, damit Sie Ihr Ausgangsmaterial dem gewünschten Ergebnis zuordnen können.
| API-Typ | Eingabe | Ausgabe | Typische Verwendung |
|---|---|---|---|
| Text-to-Speech | Geschriebener Text | Synthetisches Sprach-Audio | Sprachausgabe, Barrierefreiheit, App-Hinweise, Schulungen |
| Speech-to-Text | Sprache oder Video | Geschriebenes Transkript | Untertitel, Suche, Besprechungsnotizen, Wiederverwendung |
| Voice Cloning | Autorisierte Stimmprobe | Individuelle synthetische Stimme | Markenstimmen, wiederkehrende Sprecher, mehrsprachige Sprachausgabe |
| KI-Synchronisation | Video oder Audio | Übersetzte und vertonte Medien | YouTube-Lokalisierung, Kurse, Filme, Podcasts |
| Speech-to-Speech | Aufgezeichnete Sprache | Transformierte oder übersetzte Sprache | Stimmkonvertierung, mehrsprachige Produktion |
Die Auswahlregel ist unkompliziert. Wenn Sie bereits ein Skript haben, ist Text-to-Speech in der Regel der einfachste Weg. Wenn Sie eine Aufnahme haben, die ein Transkript benötigt, brauchen Sie Speech-to-Text. Wenn Sie dieselbe Sprecheridentität über mehrere Sprachen hinweg möchten, sind Voice Cloning oder Synchronisation besser geeignet. Für eine fokussierte Erklärung ausschließlich zur TTS-Seite geht unser Begleitleitfaden zu was eine Text-to-Speech-API ist tiefer auf die Synthese-Pipeline ein.
Eine lohnenswerte Unterscheidung: Voice Cloning ist kein Stimmverzerrer. Ein Stimmverzerrer transformiert eine bestehende Darbietung an Ort und Stelle, während Cloning ein wiederverwendbares Stimmmodell erstellt, das neue Sprache aus Text oder einer anderen kontrollierten Eingabe generiert.
Wie eine Anfrage die Pipeline durchläuft
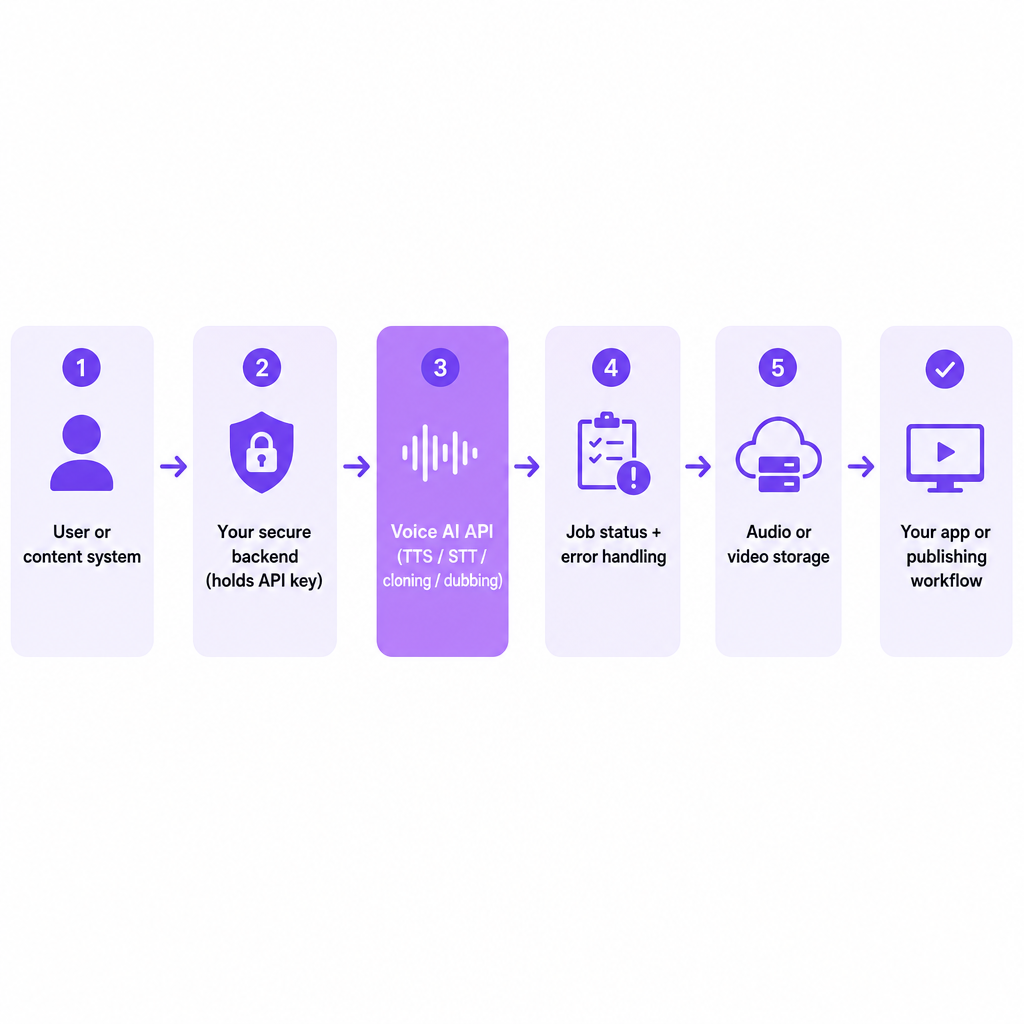
Die Implementierungen variieren, aber die meisten Voice-APIs folgen denselben vier Phasen. Die Struktur des Ablaufs zu verstehen, erspart stundenlanges Rätselraten, wenn etwas einen unerwarteten Status zurückgibt.
Zuerst authentifiziert sich Ihre Anwendung. Sie sendet einen API-Schlüssel oder ein Bearer-Token im Anfrage-Header. Die TTS-API von DubSmart verwendet beispielsweise einen REST-Endpunkt mit Bearer-Token-Authentifizierung und JSON-Anfragen gegen die Basis-URL https://dubsmart.ai/api/v1. Eine Regel, die wichtiger ist, als sie klingt: Platzieren Sie niemals einen privaten Schlüssel in browserseitigem JavaScript oder einer verteilten mobilen App. Speichern Sie ihn auf einem sicheren Server und lassen Sie Ihren Client diesen Server aufrufen.
Zweitens sendet Ihre Anwendung Inhalte und Einstellungen. Eine Anfrage enthält in der Regel eine Mischung aus Text oder einem Dateiverweis, Quell- und Zielsprache, einer Stimmen-ID, Geschwindigkeit oder Tonhöhe, Sprecherinformationen, Ausgabeeinstellungen und Projektmetadaten. Für einfaches TTS besteht der Inhalt aus Text. Bei der Synchronisation erfordert die API oft zunächst einen Video-Upload und dann eine separate Anfrage zur Erstellung des Projekts.
Drittens verarbeitet der Dienst den Inhalt. Je nach Aufgabe kann das bedeuten, Text zu normalisieren und zu interpretieren, Aussprache und Prosodie vorherzusagen, gesprochene Inhalte zu übersetzen, Sprecher zu trennen oder Sprache vom Hintergrundaudio zu isolieren, Audio mit einer Standard- oder individuellen Stimme zu erzeugen und das Ergebnis mit einer Video-Zeitleiste zu synchronisieren. Längere Aufträge laufen asynchron: Statt einer fertigen Datei liefert die API eine Projekt-ID zurück.
Viertens ruft Ihre Anwendung das Ergebnis ab – eine Audio- oder Video-URL, einzelne Segment-URLs, ein Transkript, übersetzten Text, Timing-Daten sowie Status- oder Fehlerfelder. Die TTS-API von DubSmart dokumentiert Projektzustände wie pending, processing, completed und failed, und abgeschlossene Projekte können MP3-URLs auf Projekt- oder Segmentebene zurückgeben.
Synchron versus asynchron: Die Unterscheidung, die Ihren Aufbau prägt
Wie eine API Ergebnisse zurückgibt, bestimmt, wie Sie Ihre Architektur darum herum gestalten, also entscheiden Sie dies, bevor Sie Integrationscode schreiben.
Eine synchrone API hält die Anfrage offen, bis die Verarbeitung abgeschlossen ist, und gibt dann das Ergebnis zurück. Das funktioniert gut für kurze Texte, kurze Sprachhinweise, kleine Audioausschnitte und interaktive Funktionen mit geringer Latenz. Ihre Schwäche besteht darin, dass lange Aufträge die Anfrage-Timeouts überschreiten können.
Eine asynchrone API gibt sofort eine Projekt- oder Auftrags-ID zurück. Ihre Anwendung fragt dann einen Status-Endpunkt ab (Polling) oder erhält einen Webhook, wenn der Auftrag abgeschlossen ist. Dieses Modell eignet sich für lange Sprachausgaben, Videosynchronisation, mehrere Zielsprachen, Batch-Generierung und große Dateien. Die dokumentierten TTS- und Synchronisations-Workflows von DubSmart verwenden Projektzustände und Ergebnisabruf, was ein asynchrones Muster ist, das für Medienaufträge gebaut wurde.
Wenn Sie eine Option bewerten, prüfen Sie, ob sie Webhooks unterstützt. Alle paar Sekunden zu pollen, ist trivial zu implementieren, aber Webhooks reduzieren unnötige Anfragen und skalieren besser, sobald Sie viele Aufträge gleichzeitig ausführen.
Was Sie prüfen sollten, bevor Sie sich festlegen
Die richtige API hängt von der Aufgabe ab, aber eine Handvoll Kriterien gilt für fast jedes Projekt. Gehen Sie sie bewusst durch, anstatt sich auf eine kurze Demo zu verlassen.
Funktionalität passt. Stellen Sie sicher, dass die API die genaue Aufgabe unterstützt – Text-to-Speech, Speech-to-Text, Voice Cloning, Synchronisation, mehrere Sprecher, reine Audio- oder Videoausgabe, Echtzeit oder Batch. Gehen Sie nicht davon aus, dass alles, was als „Voice AI“ vermarktet wird, all diese Funktionen enthält.
Sprachabdeckung. Prüfen Sie Quell- und Zielsprachen. „Unterstützt 30 Sprachen“ kann 30 TTS-Stimmen, 30 Übersetzungsziele oder eine Mischung aus Sprachen und Dialekten bedeuten. Für einen mehrsprachigen Kanal sollten Sie auch Akzentqualität, Aussprache von Namen und Orten, regionalen Wortschatz, die Stimmenverfügbarkeit pro Sprache und die Frage abwägen, ob eine geklonte Stimme über mehrere Sprachen hinweg funktioniert.
Ausgabe- und Medienunterstützung. Überprüfen Sie Audioformate, Video-Container, Abtastrate und Bitrate, Downloads auf Segmentebene, vollständig gerenderte Videos, Verfügbarkeit von Transkripten oder Untertiteln sowie die maximale Dateigröße. Diese bestimmen Ihren Bearbeitungs-Workflow und Ihre Speicherkosten.
Qualität und Steuerbarkeit. Achten Sie auf natürliche Pausen, korrekte Aussprache, stabile Lautstärke, konsistente Sprecheridentität, angemessene Betonung und präzises Timing. Eine Stimme kann in einer zehnsekündigen Probe makellos klingen und bei Fachbegriffen, langen Absätzen, Zahlen oder ungewöhnlichen Namen stolpern. Testen Sie repräsentative Inhalte, nicht den handverlesenen Clip des Anbieters.
Latenz und Durchsatz. Messen Sie die Zeit anhand Ihrer tatsächlichen Arbeitslast. Ein kurzer Voiceover und Hunderte lokalisierter Videos sind unterschiedliche Probleme. Fragen Sie, ob die Verarbeitung in Echtzeit oder asynchron erfolgt, wie die Ratenbegrenzungen aussehen, ob Aufträge parallel laufen, ob es eine priorisierte Verarbeitung gibt und wie Fehler wiederholt werden. DubSmart gibt an, dass ein typisches fünfminütiges Video etwa eine Minute zur Verarbeitung benötigt, wobei das Timing von Länge und Dateigröße abhängt.
Preismodell. Voice-APIs können nach Zeichen, Wörtern, Audio- oder Videodauer, Credits, Anfragen, Speicher oder gleichzeitigen Aufträgen abrechnen. Bei der Synchronisation vervielfacht die Anzahl der Zielsprachen die effektiven Kosten. Berechnen Sie einen vollständigen Workflow – Wiederholungen, neu generierte Segmente, Übersetzungsprüfung, Speicher – nicht nur den ersten Aufruf. Unsere Analyse der Voice-AI-API-Preise erläutert die Credit-Berechnung im Detail.
Risiken, die es sich lohnt, frühzeitig zu managen
Voice AI bringt Fehlermodi mit sich, die es bei gewöhnlichen Medientools nicht gibt. Sie während der Entwurfsphase anzugehen, ist weitaus günstiger als nach einem öffentlichen Fehler.
Unbefugte Stimmennutzung. Das Klonen der Stimme einer Person ohne Erlaubnis schafft rechtliche, ethische und reputationsbezogene Risiken. Verwenden Sie einen schriftlichen Einwilligungsprozess, der benennt, wem die Aufnahme gehört, was generiert werden darf, wo die Stimme verwendet werden darf, ob eine kommerzielle Nutzung erlaubt ist, wie die Stimme gelöscht wird und was geschieht, wenn die Vereinbarung endet.
Falsche Übersetzung oder Aussprache. Generierte Sprache kann mit Namen, Akronymen, Adressen und Fachbegriffen falsch umgehen. Behalten Sie die menschliche Prüfung für öffentlich zugängliche Inhalte bei: ein Vorlesen des übersetzten Skripts, ein Anhören durch Muttersprachler, Stichprobenprüfungen der Aussprache, ein Durchgang zu Timing und Lippenbewegung sowie eine abschließende Prüfung der exportierten Medien.
Imitation und Betrug. Synthetische Stimmen können für Betrug oder falsche Empfehlungen missbraucht werden. Vermeiden Sie es, etwas zu generieren, das einen vernünftigen Zuhörer glauben lassen könnte, eine reale Person habe etwas gesagt, was sie nicht gesagt hat. Fügen Sie für sensible Kommunikation Offenlegung, Freigabekontrollen und Audit-Protokolle hinzu.
Stimm- und Datenschutz. Proben können personenbezogene Daten enthalten. Klären Sie vor dem Hochladen Einwilligung, Aufbewahrungsregeln, Zugriffsbeschränkungen, Löschverfahren, die Datenverarbeitungsbedingungen des Anbieters und etwaige Richtlinien zur Zweitnutzung. DubSmart gibt an, dass hochgeladene Cloning-Dateien verschlüsselt werden und dass Benutzer individuelle Stimmen und zugehörige Audiodaten löschen können, wobei Teams dennoch die aktuellen Bedingungen und Kontrollen für ihren spezifischen Plan bestätigen sollten.
Anbieter- und Modelländerungen. Stimmen-IDs, Sprachunterstützung, Ausgabeformate und Ratenbegrenzungen können sich ändern. Behandeln Sie die API als externe Abhängigkeit: Fixieren Sie die Konfiguration, wo Sie können, speichern Sie Quell-Skripte, sichern Sie freigegebenes Audio, überwachen Sie Fehlerraten, halten Sie einen Fallback-Workflow bereit und testen Sie nach größeren Anbieter-Updates erneut. Für Teams, die weniger bewegliche Teile wünschen, erläutert unser Überblick über All-in-One-KI-Videotools die Kompromisse bei der Konsolidierung dieser Funktionen.
Wann eine API einen manuellen Workflow schlägt
Eine Voice-AI-API rechtfertigt ihre Integrationskosten, wenn Sie eine wiederholbare, programmatische Produktion benötigen. Sie passt gut, wenn ein Creator lokalisierte Versionen jedes Videos veröffentlicht, ein kleines Unternehmen Produktsprachausgaben in mehreren Sprachen generiert, ein E-Learning-Unternehmen Hunderte von Lektionen aktualisiert, ein Podcast übersetzte Ausgaben veröffentlicht, ein Softwareprodukt gesprochene Barrierefreiheit hinzufügt oder eine Agentur die Sprachgenerierung in ihr Content-Management-System einbindet.
Ein manueller Studio-Workflow kann in bestimmten Fällen dennoch die Nase vorn haben: wenn ein Projekt von einer äußerst nuancierten menschlichen Darbietung abhängt, wenn eine rechtliche Freigabe einen professionellen Sprecher erfordert, wenn Inhalte sensible Aussagen enthalten, wenn eine einmalige Aufnahme schneller ist als der Aufbau einer Integration, oder wenn das Ergebnis eine umfangreiche künstlerische Leitung benötigt. Es geht nicht darum, jede menschliche Stimme zu ersetzen. Es geht darum, die Teile zu automatisieren, bei denen Konsistenz, Geschwindigkeit, Skalierung oder mehrsprachige Ausgabe am wichtigsten sind.
Für einen kleinen Aufbau halten Sie die Architektur einfach. Ein sicheres Backend sitzt zwischen Ihrem Benutzer- oder Content-System und der Voice-API. Dieses Backend hält Anmeldedaten geheim, validiert Eingaben, erstellt Projekte, speichert Auftrags-IDs, pollt den Status oder empfängt Webhooks, wiederholt vorübergehende Fehler, speichert Ergebnis-URLs und Metadaten, wendet Nutzungsgrenzen an und dokumentiert die Einwilligung für jede geklonte Stimme. Eine Creator-orientierte Version könnte ein fertiges englisches Video entgegennehmen, es an einen Synchronisations-Endpunkt für die gewählten Sprachen senden, auf den Abschluss warten, die Ergebnisse in einen Prüfordner leiten und erst nach Freigabe veröffentlichen.
Wo DubSmart ins Bild passt
Wir integrieren mehrere sprachbezogene API-Funktionen in eine einzige KI-Medienplattform, was am wichtigsten ist, wenn Sie Generierung und Lokalisierung mit einem bestehenden Workflow verbinden möchten, anstatt jeden Auftrag manuell auszuführen.
Unsere Text-to-Speech-API bietet programmatische Sprachgenerierung mit neuronalen Stimmen, Voice Cloning, Mehrsprachigkeit, Verfolgung des Projektstatus und MP3-Ergebnissen – ihre Beispielanfrage verwendet Textsegmente mit einer Stimmen-ID, Sprache, Geschwindigkeit und Tonhöhe. Unsere Voice-Cloning-API folgt einem dreistufigen Muster: Fordern Sie eine vorsignierte Upload-URL an, laden Sie eine Audioprobe hoch und erstellen Sie dann eine individuelle Stimme aus dem hochgeladenen Dateischlüssel; sie akzeptiert MP3, WAV, AAC, M4A und FLAC, und wir empfehlen für bessere Ergebnisse mindestens 20 Sekunden sauberes Audio. Unsere KI-Synchronisations-API übernimmt die Videolokalisierung mit mehrsprachiger Projekterstellung, Sprechereinstellungen, übersetzten Segmenten und herunterladbarer synchronisierter Ausgabe und akzeptiert Eingaben wie MP4, MOV, AVI, MKV und WebM bis zu 5 GB.
Wenn Sie abwägen, mit welchem Endpunkt Sie beginnen sollen, richten Sie sich nach Ihren Inhalten: skriptbasierte Sprachausgabe deutet auf TTS, eine autorisierte wiederkehrende Stimme deutet auf Cloning und mehrsprachiges Video deutet auf Synchronisation.
Häufig gestellte Fragen
Was ist eine Voice-AI-API, einfach erklärt?
Es ist eine Verbindung, mit der Software Sprache generieren, erkennen, klonen, übersetzen oder transformieren kann, ohne ein eigenes KI-Stimmsystem zu bauen. Ihre App sendet eine Anfrage und erhält verarbeitetes Audio, Text oder Video.
Ist eine Voice-AI-API dasselbe wie Text-to-Speech?
Nein. Text-to-Speech ist ein Typ von Voice-AI-API. Die Kategorie umfasst außerdem Spracherkennung, Voice Cloning, Synchronisation und Speech-to-Speech-Funktionen.
Benötige ich Programmiererfahrung, um eine zu nutzen?
In der Regel etwas, denn APIs beinhalten Authentifizierung, HTTP-Anfragen, JSON, Datei-Uploads und Status-Handling. Für gelegentliche manuelle Aufträge ist eine No-Code-Web-App oft einfacher.
Kann eine Voice-AI-API ein YouTube-Video übersetzen?
Eine Synchronisations-API kann Audio für ein Video übersetzen und neu generieren, wenn sie die erforderlichen Quell- und Zielsprachen, das Dateiformat und den Ausgabe-Workflow unterstützt. Prüfen Sie das Ergebnis vor der Veröffentlichung.
Kann ich die Stimme jeder beliebigen Person klonen?
Technisch möglich ist nicht dasselbe wie rechtlich oder ethisch erlaubt. Klonen Sie eine Stimme nur mit entsprechender Erlaubnis und befolgen Sie die Regeln des Anbieters, Ihre Verträge sowie die geltenden Datenschutz- und Persönlichkeitsrechtsanforderungen.