Die meisten Videoprojekte enden nicht, wenn Sie die Aufnahme stoppen. Transkription, Audiobereinigung, Sprachaufnahme, Synchronisation, Bildgenerierung, Animation und manchmal API-Integration liegen alle zwischen Rohmaterial und einem fertigen, veröffentlichungsreifen Asset. Die nützlichsten All-in-One-KI-Videotools lösen diese Fragmentierung: Statt Dateien zwischen voneinander unabhängigen Apps zu exportieren, bewegen Sie sich innerhalb eines einzigen vernetzten Workflows vom Ausgangsmaterial zu lokalisierten, vertonten und wiederverwerteten Inhalten.
Diese Liste ist kein Beliebtheitsranking. Wir haben die Tools in unserem eigenen Medienerstellungs-Stack nach der Produktionsaufgabe ausgewählt, die jedes einzelne abnimmt, und wir weisen auf die Grenzen jedes Tools hin, damit Sie testen können, bevor Sie sich festlegen. Unsere Auswahlkriterien waren Workflow-Abdeckung, praktische Ein- und Ausgaben, Integrationspotenzial, Eignung für Creator und Teams sowie transparente Einschränkungen wie unterstützte Formate und Sprachqualifikationen. Die folgenden Abschnitte sind nach Anwendungsfall gegliedert, denn der richtige Ausgangspunkt hängt davon ab, ob Ihnen mehrsprachiges Publizieren, Audiobereinigung, Kurzvideo-Visuals, Transkription oder Entwickler-Automatisierung am wichtigsten ist.
Inhaltsverzeichnis
KI-Synchronisation für mehrsprachiges Video-Publishing
Wenn das fertige Asset bereits existiert und einfach ein größeres Publikum erreichen soll, ist die Synchronisation der richtige Ausgangspunkt. Unsere KI-Synchronisation unterstützt die Synchronisation aus mehr als 60 Ausgangssprachen in 33 Zielsprachen, klont die Stimmen der Sprecher und ist darauf ausgelegt, Ton, Emotion und Kontext während der Lokalisierung zu bewahren.
Was dies von einem reinen Textübersetzer oder einem eigenständigen Stimmgenerator unterscheidet, ist, dass die gesamte Aufgabe in einem Projekt stattfindet. Sie laden eine Video- oder Audiodatei hoch oder fügen einen YouTube-Link ein, wählen die Zielsprache, fügen Sprecher hinzu, bearbeiten den Text oder die Zeitpunkte, generieren einzelne Segmente neu, wenn eine Zeile Nacharbeit braucht, und laden das Ergebnis herunter. Synchronisiertes Audio kann außerdem an den Lippenbewegungen und dem Mienenspiel der Figuren ausgerichtet werden, was wichtig ist, wenn die Ausgabe ein Video und nicht nur Audio ist.
Am besten geeignet für: YouTube-Creator, E-Learning-Teams, Unternehmen, Filmemacher und Podcaster, die bestehende Inhalte in neue Sprachen übertragen. Es passt auch zu Teams, die eine internationale Version testen möchten, bevor sie eine klassische Synchronisation in Auftrag geben.
Zu beachtende Einschränkung: Die öffentliche Seite nennt nicht jede einzelne der 33 Zielsprachen oder alle über 60 Ausgangssprachen und gibt keine herunterladbaren Formate, maximale Auflösung oder Verarbeitungszeiten an. Testen Sie zuerst einen repräsentativen Clip, idealerweise einen mit mehreren Sprechern, Akzenten, Musik oder Fachterminologie, bevor Sie eine große Charge angehen.
Speech-to-Text für Untertitel, Transkripte und Wiederverwertung
Die Transkription steht an beiden Enden eines Workflows: bevor eine Aufnahme zum Skript wird, und nachdem sie zu Inhalt wird, den Sie wiederverwenden möchten. Unser Speech-to-Text-Tool wandelt Audio oder Video in bearbeitbaren Text und Untertitel um und akzeptiert YouTube-Links sowie hochgeladene Audio- und Videodateien.
Der Ablauf ist unkompliziert: Laden Sie eine Datei hoch oder fügen Sie einen Link ein, erstellen Sie ein Transkript- oder Untertitelprojekt, fügen Sie Sprecher hinzu, bearbeiten Sie es und laden Sie es anschließend im benötigten Format herunter. Das Tool wird so beschrieben, dass es lange Aufnahmen, Meetings, Interviews, Vorlesungen, Podcasts, mehrere Sprecher, Hintergrundgeräusche und unterschiedliche Akzente verarbeitet, was es für reales Material und nicht nur für sauberes Studioaudio praktisch macht.
Am besten geeignet für: das Umwandeln von Langform-Videos in Untertitel, durchsuchbare Transkripte, Skripte für die Synchronisation, geschriebene Artikel oder Kurzvideo-Clips sowie das Verbessern der Barrierefreiheit für gehörlose und schwerhörige Zielgruppen.
Zu beachtende Einschränkung: Die Sprachabdeckung wird auf der Seite auf zwei Arten beschrieben – an einer Stelle bis zu 99 Sprachen und in den FAQ mehr als 60 –, bestätigen Sie also die genaue Sprache für Ihr Projekt vor der Produktion. Dateien können bis zu 5 GB groß sein, ohne angegebene Begrenzung der Videolänge, es gibt jedoch keine veröffentlichte Genauigkeitsangabe oder detaillierte Erläuterung zur automatischen Sprechererkennung. Die Genauigkeit variiert je nach Audioqualität, überlappender Sprache und Fachvokabular. Wenn Sie dieses Transkript später lokalisieren, setzt unsere KI-Synchronisation dort an, wo der bearbeitete Text aufhört.
Speech Separator zur Bereinigung verrauschter Aufnahmen
Sauberes Ausgangsaudio bestimmt still und leise die Qualität von allem Nachgelagerten. Unser Speech Separator isoliert die gesprochene Stimme von Hintergrundgeräuschen und zielt auf Aufnahmen ab, die durch Straßenlärm, Mikrofonrückkopplung oder Umgebungsgeräusche beeinträchtigt sind.
Der Grund, warum er früh in den Stack gehört, ist konkret: Hintergrundgeräusche verschlechtern die Qualität eines Stimmklons, daher positionieren wir die Separierung als Vorbereitungsschritt vor dem Klonen sowie vor Transkription und Vertonung. Er unterstützt gängige Audioformate, darunter MP3, WAV und AAC, und akzeptiert zudem Videodateien, sodass Sie Ausgangsmaterial direkt bereinigen können, anstatt zuerst manuell die Audiospur zu extrahieren.
Am besten geeignet für: Podcaster, Interview-Produzenten und Filmemacher, die aus unvollkommenem Produktionsaudio nutzbare Sprache retten, sowie alle, die eine saubere Probe für das Stimmklonen vorbereiten.
Zu beachtende Einschränkung: Die Seite beschreibt das Trennen von Sprache und Hintergrundgeräuschen, nicht die vollständige Mehrsprecher-Stem-Trennung. Sie gibt nicht an, wie überlappende Sprecher, musiklastige Aufnahmen, starkes Echo oder stark schwankendes Rauschen gehandhabt werden. Hören Sie sich die bereinigte Datei an, bevor Sie sie als finalen Mix oder als Klon-Quelle verwenden.
Image to Video für kurze visuelle Einfügungen
Wenn Sie Bewegung brauchen, aber nicht filmen möchten, ist das Animieren eines Standbilds der schnellste Weg. Unser Image-to-Video-Tool verwandelt ein hochwertiges Standbild in einen kurzen animierten Clip: Das hochgeladene Bild wird zum ersten Frame, und ein Text-Prompt beschreibt die Bewegung des Motivs, die Kamerabewegung oder die Szenendynamik.
Der Workflow bleibt bewusst kurz. Laden Sie ein hochwertiges Bild hoch, beschreiben Sie die Bewegung, wählen Sie Dauer, Auflösung, Seitenverhältnis und Qualität, dann generieren, prüfen und herunterladen. Verfügbare Dauern sind 4, 6 und 8 Sekunden. Die Seitenverhältnisse umfassen Querformat, Quadrat und Hochformat, einschließlich 16:9, 1:1 und 9:16. Standardqualität erzeugt Video ohne Ton, während die Optionen Hoch und Ultrahoch als mit Ton beschrieben werden.
Am besten geeignet für: Social-Media-Teams, Marketer und Pädagogen, die animierte Eröffnungen, Übergänge, Produkt-Artwork-Clips oder Bewegung auf Folien benötigen und diese Clips dann in einen größeren Schnitt einfügen.
Zu beachtende Einschränkung: Dies ist ein Generator für kurze Clips, kein Langform-Editor, und die veröffentlichten Dauern enden bei 8 Sekunden. Die Seite gibt keine Bilddateiformate, maximale Dateigröße, Prompt-Länge, Generierungskontingente oder das genaue Audioverhalten an. Verwenden Sie saubere, artefaktfreie Ausgangsbilder und behandeln Sie jede Ausgabe als Komponente innerhalb eines größeren Projekts. Wenn Sie das Ausgangs-Artwork selbst benötigen, erzeugt unser KI-Bildgenerator Standbilder, die Sie anschließend animieren können.
KI-Synchronisations-API für skalierte, wiederholbare Lokalisierung
Gelegentliche manuelle Exporte funktionieren, bis die Lokalisierung zu einer wiederkehrenden Aufgabe wird. Dafür bieten wir eine KI-Synchronisations-API, die darauf ausgelegt ist, Video in mehr als 33 Sprachen zu übersetzen und zu synchronisieren, einschließlich Stimmklon-Funktionen.
Der Mehrwert hier unterscheidet sich von einem browserbasierten Editor. Mit einer API können Sie die Lokalisierung aus einer bestehenden Anwendung heraus auslösen und verwalten, sodass Sie die Synchronisation mit einer Video-Upload-Plattform, einem Lernmanagementsystem, einer Medienverarbeitungs-Pipeline, einem Agentur-Dashboard oder einem automatisierten Publishing-Workflow verbinden können. Es ist keine weitere kreative Steuerung, sondern die Möglichkeit, die Lokalisierung zu einem wiederholbaren System zu machen.
Am besten geeignet für: Entwickler, Agenturen und SaaS-Teams, die nach Uploads automatisch Sprachversionen erzeugen, mehrsprachige Trainingsbibliotheken aufbauen oder große Content-Kataloge verarbeiten. Teams, die Automatisierungskosten abwägen, können vor dem Festlegen eines Builds unseren Erklärtext zur Preisgestaltung der Voice-KI-API durchsehen.
Zu beachtende Einschränkung: Die öffentliche Seite bestätigt, dass eine API existiert, veröffentlicht aber kein Endpunktverhalten, keine Authentifizierungsanforderungen, Rate Limits, Webhooks, Ausgabeformate oder Hinweise zur Fehlerbehandlung. Fordern Sie die aktuelle technische Dokumentation an oder sehen Sie sie durch, bevor Sie den Implementierungsaufwand abschätzen.
Ein Workflow für Bereinigung, Transkription, Visuals und Lokalisierung
Das eigentliche Argument für eine All-in-One-Plattform ist nicht, dass jede einzelne Funktion jede spezialisierte App übertrifft. Es ist, dass mehrere Schritte innerhalb eines umfassenderen Workflows ablaufen, sodass Ausgangs-Assets, Transkripte, Audio und lokalisierte Versionen mit weniger Dateiübergaben näher beieinander bleiben.
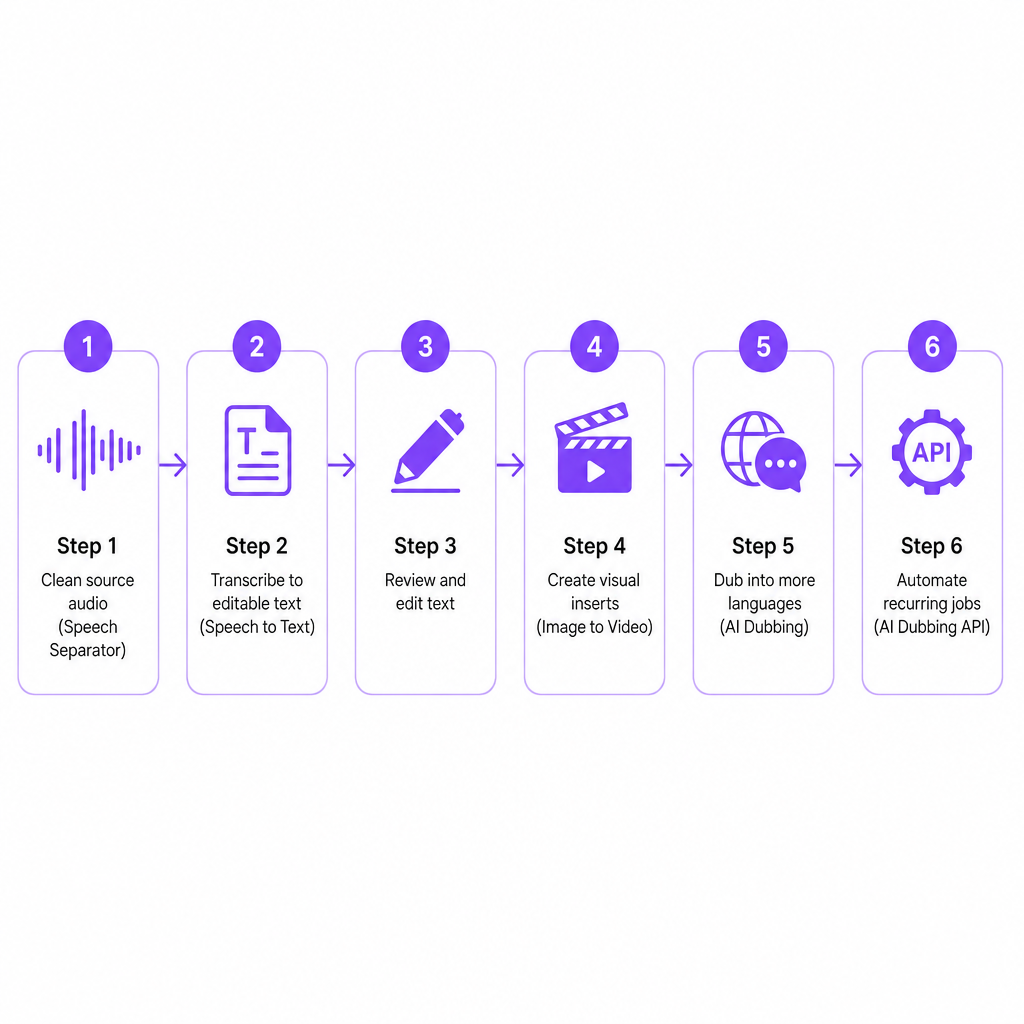
Eine wiederholbare Abfolge sieht so aus:
- Bereinigen Sie die Ausgangsaufnahme mit dem Speech Separator.
- Transkribieren Sie den Inhalt mit Speech-to-Text.
- Prüfen und bearbeiten Sie den Text vor der Vertonung oder Lokalisierung.
- Erstellen Sie neue visuelle Einfügungen mit Image to Video.
- Synchronisieren Sie das fertige Video in weitere Sprachen.
- Verbinden Sie wiederkehrende Produktionsaufgaben über eine API.
Diese Struktur zahlt sich am meisten aus, wenn dasselbe Team Inhalte regelmäßig erstellt, anpasst und lokalisiert, darunter mehrsprachige YouTube-Kanäle, kleine Marketingteams mit häufigen Produktvideos, Unternehmens-Trainingsbibliotheken und Agenturen, die mehrere Kundensprachen jonglieren.
Zu beachtende Einschränkung: All-in-One ist nicht dasselbe wie vollautomatisch. Transkripte müssen weiterhin geprüft werden, Übersetzungen benötigen eventuell eine kulturelle Anpassung, geklonte Stimmen erfordern eine Genehmigung, und generierte Visuals müssen ausgewählt oder bearbeitet werden. Einige technische Details bleiben auf den Produktseiten unspezifiziert, überprüfen Sie also Ihre genauen Dateitypen, Sprachen, Kontingente und Exportanforderungen, bevor Sie einen gesamten Betrieb migrieren. Unsere Video-Lokalisierungs-Checkliste für Teams ist eine praktische Methode, um diese Übergabe auf die Probe zu stellen.
So wählen Sie das richtige Tool für Ihre Aufgabe
Ordnen Sie die Aufgabe der Fähigkeit zu, anstatt bei der Funktionsliste zu beginnen. Die folgende Übersicht weist Ihnen den richtigen Einstiegspunkt für die häufigsten Produktionsaufgaben.
| Ihre Hauptaufgabe | Beginnen Sie mit | Warum |
|---|---|---|
| Ein bestehendes Video in anderen Sprachen veröffentlichen | KI-Synchronisation | Lokalisiert Video oder Audio und unterstützt geklonte Sprecherstimmen |
| Untertitel oder ein durchsuchbares Transkript erstellen | Speech-to-Text | Wandelt hochgeladenes Audio, Video oder YouTube-Links in bearbeitbaren Text um |
| Verrauschten Dialog verbessern | Speech Separator | Isoliert Sprache von Hintergrundgeräuschen, unterstützt MP3, WAV, AAC |
| Ein Standbild animieren | Image to Video | Fügt Bewegung aus einem Bild plus einem Text-Bewegungs-Prompt hinzu |
| Lokalisierung in ein Produkt einbauen | KI-Synchronisations-API | Verbindet die Synchronisation mit einer App oder automatisierten Medien-Pipeline |
| Eine Stimmprobe zum Klonen vorbereiten | Speech Separator, dann Klonen | Saubereres Ausgangsaudio verbessert die Klonqualität |
| Mehrsprachige Kursinhalte produzieren | Speech-to-Text plus KI-Synchronisation | Zuerst Transkript, dann lokalisierte Sprachversionen |
Bevor Sie sich auf eine Plattform festlegen, führen Sie einen kurzen Überprüfungsdurchlauf durch. Bestätigen Sie, dass Ihre Ausgangs- und Zielsprachen unterstützt werden, prüfen Sie maximale Dateigrößen und Dauern, und testen Sie, ob Exporte sauber in Ihren Schnitt- oder Publishing-Workflow übergehen. Klären Sie, ob Sprecher automatisch erkannt oder von Hand hinzugefügt werden, bestätigen Sie, dass Sie die Genehmigung haben, jede Stimme zu klonen oder zu synthetisieren, und prüfen Sie, ob generierte Clips für ihren Einsatzzweck lang genug sind. Entscheiden Sie schließlich, wo ein Mensch Übersetzung, Aussprache, Timing und kulturellen Kontext überprüft, und ob Sie eine API für die Stapelverarbeitung benötigen. Die ehrliche Antwort auf diese Fragen sagt Ihnen in der Regel, ob eine einzelne Plattform oder ein eng spezialisiertes Tool zu der vor Ihnen liegenden Arbeit passt.
Häufig gestellte Fragen
Was sind All-in-One-KI-Videotools?
Sie vereinen mehrere Medienproduktionsaufgaben, etwa Transkription, Stimmgenerierung, Audiobereinigung, Bildanimation und Synchronisation, innerhalb einer Plattform oder eines vernetzten Workflows, sodass Sie vermeiden, Dateien zwischen voneinander unabhängigen Apps zu exportieren.
Welches Tool eignet sich am besten für mehrsprachige YouTube-Inhalte?
Beginnen Sie mit der KI-Synchronisation. Sie unterstützt die Synchronisation aus mehr als 60 Ausgangssprachen in 33 Zielsprachen, mit Sprecher-Stimmklonen und bearbeitbaren Synchronisationsprojekten. Bestätigen Sie das genaue Sprachenpaar und prüfen Sie eine Probe, bevor Sie in großem Umfang veröffentlichen.
Kann ich diese Tools für Podcasts verwenden?
Ja. Der Speech Separator bereinigt verrauschtes Podcast-Audio, Speech-to-Text erstellt ein Transkript, und die KI-Synchronisation erzeugt lokalisierte Versionen. Unsere Seiten beschreiben speziell Anwendungsfälle für Podcasts, Interviews und Audio.
Kann Speech-to-Text lange Videos verarbeiten?
Es gibt keine angegebene Begrenzung der Videolänge, aber eine Dateigrößenbegrenzung von 5 GB. Die Genauigkeit kann dennoch je nach Audioqualität, Akzenten, überlappenden Sprechern und Fachterminologie variieren.
Sind KI-synchronisierte Videos ohne Prüfung veröffentlichungsreif?
Nicht immer. Die Synchronisation beschleunigt die Produktion, aber prüfen Sie zuerst Übersetzungen, Namen, Timing, Aussprache, Stimmgenehmigungen und kulturellen Kontext. Ein kurzer Testexport ist am wichtigsten bei Inhalten mit mehreren Sprechern oder Fachsprache.