Du kannst online Text in Sprache umwandeln – in der Zeit, die du brauchst, um ein Skript einzufügen, eine Stimme auszuwählen und auf „Generieren“ zu klicken. Kein Mikrofon, keine Kabine, kein Schnittstudio – nur ein browserbasiertes Tool, das geschriebene Worte in natürlich klingende Erzählung verwandelt, die du herunterladen und in ein Video, einen Kurs, einen Podcast oder eine Werbung einfügen kannst. Die eigentliche Arbeit ist nicht das Klicken; es sind die wenigen Entscheidungen, die bestimmen, ob das Audio wie ein Mensch oder wie ein Automat klingt.
Dieser Leitfaden führt zügig durch diese Entscheidung: Was passiert, wenn du online Text in Sprache umwandelst, wie du schnell eine brauchbare Datei bekommst, wie du die richtige Stimme auswählst und wo die ehrlichen Grenzen liegen. Wir haben DubSmart AI entwickelt, um diesen gesamten Workflow an einem Ort abzuwickeln, sodass die Beispiele hier daraus stammen, wie sich unsere eigenen Tools für Text-to-Speech, Voice Cloning und Synchronisation tatsächlich verhalten.
Inhaltsverzeichnis
Was „Text online in Sprache umwandeln“ tatsächlich bedeutet
Text-to-Speech, oder TTS, ist eine Technologie, die geschriebene Sprache in gesprochenes Audio umwandelt. Ein modernes KI-System liest den Text, interpretiert Aussprache und Satzbau und synthetisiert eine Stimme mit Tempo, Betonung und Tonfall. Es „online“ zu tun bedeutet einfach, dass die Synthese in der Cloud läuft: Du installierst keine Software und nimmst selbst nichts auf.
Diese Verschiebung ist wichtig, weil sie verändert, wer Voiceover produzieren kann. Ein YouTuber, der ein Short schreibt, ein Trainer, der ein Compliance-Modul aktualisiert, ein Marketer, der eine Werbung in dieser Woche zum dritten Mal umschreibt – keiner von ihnen braucht Aufnahmetechnik oder einen Sprecher auf Abruf. Dasselbe eingefügte Skript kann zur Erzählung für Tutorials, Produktdemos, Kurse, Podcasts, Präsentationen, Barrierefreiheits-Audio, Kundenservice-Nachrichten und lokalisierte Versionen in anderen Sprachen werden.
Wenn du die tiefere Mechanik verstehen willst, wie die Synthese-Pipeline Phoneme in Prosodie verwandelt, behandeln wir das separat in wie neuronales Text-to-Speech funktioniert. Für diesen Leitfaden ist das nützliche gedankliche Modell kurz: gutes Eingabeskript plus die richtige Stimme ergibt Audio, das du veröffentlichen kannst.
Der schnelle Weg vom Skript zum herunterladbaren Audio
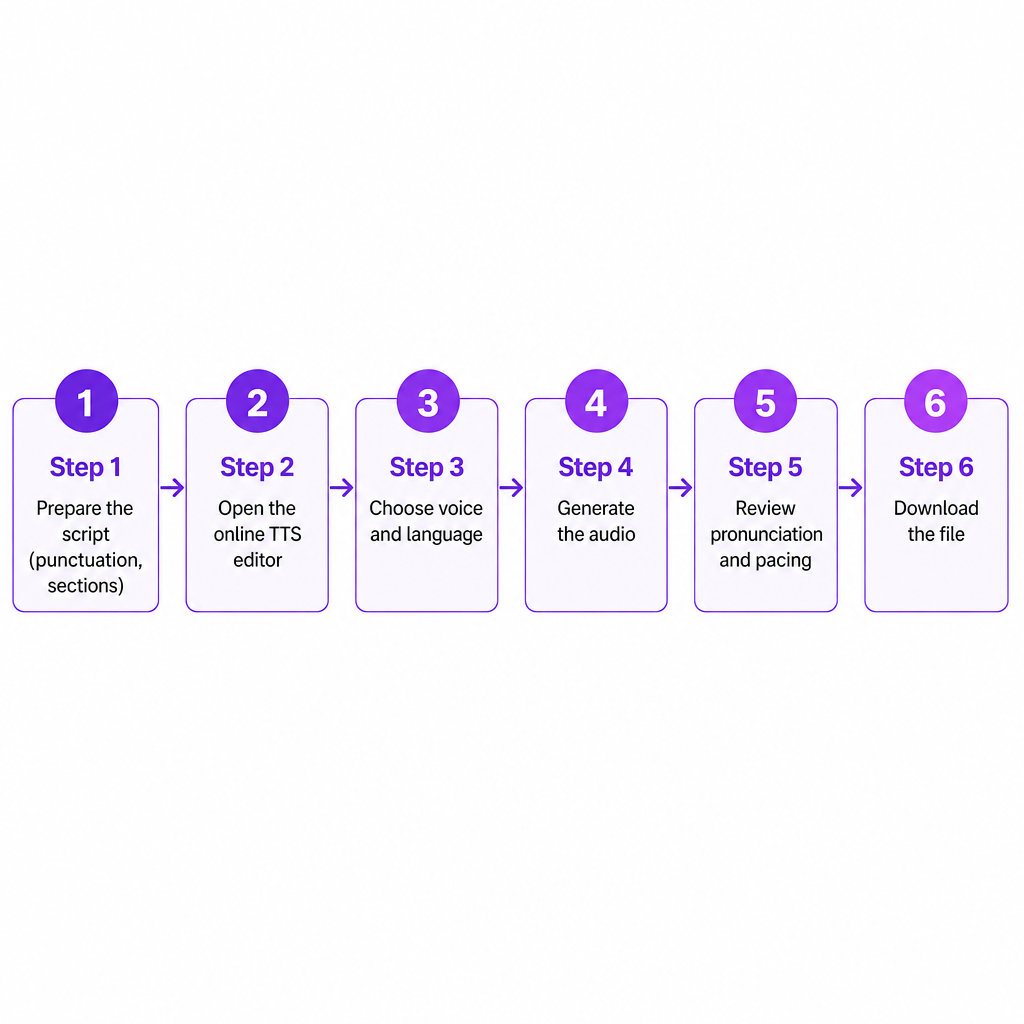
Die Abfolge ist kurz genug, um sie sich zu merken: Text vorbereiten, Tool öffnen, Stimme und Sprache auswählen, generieren, überprüfen, herunterladen. Der Schritt, den die Leute überspringen, ist der erste – und es ist derjenige, der am meisten Zeit spart.
Beginne mit einem fertigen Skript, nicht mit groben Notizen. Füge Satzzeichen hinzu, teile lange Passagen in logische Abschnitte und lies es einmal laut vor. Eine KI-Stimme liefert das, was du ihr gibst, daher verhindert das Aufräumen des Textes im Vorfeld ein späteres erneutes Generieren. Von dort aus fügst du ihn in DubSmarts Text-to-Speech-Tool ein, wählst eine Stimme, die zum Inhalt und zur Zielgruppe passt, und generierst das Audio. Unsere TTS-Seite bietet über 300 KI-Stimmen – männlich, weiblich und neutral – sowie Steuerungen für Sprechgeschwindigkeit, emotionale Ausrichtung, Betonung und Zahlenaussprache.
Überprüfe es dann, bevor du exportierst. Achte besonders auf falsch ausgesprochene Namen, unnatürliche Pausen, fehlplatzierte Betonungen oder einen Tonfall, der nicht zum Video passt. Korrigiere diese im Skript und generiere den betroffenen Abschnitt neu, anstatt die gesamte Datei. Wenn es richtig klingt, lade es herunter und füge es in dein Projekt ein.
Ein praktischer Hinweis: Unser Editor zeigt die Exportoptionen direkt an, und wir veröffentlichen keine erschöpfende Formatliste im Voraus. Prüfe daher die verfügbaren Formate im Editor, bevor du einen großen Stapelauftrag startest. Diese Fünf-Sekunden-Prüfung ist besser, als nach dem Rendern einer Stunde Erzählung eine Formatinkompatibilität zu entdecken.
Eine Stimme wählen, die für das gesamte Projekt überzeugt
Die realistischste klingende Stimme in einer kurzen Vorschau auszuwählen, ist ein häufiger Fehler. Eine Stimme, die in einem Zehn-Sekunden-Clip beeindruckt, kann über ein zwanzigminütiges Erklärvideo ermüdend werden. Der bessere Test besteht darin, einen repräsentativen Absatz aus deinem tatsächlichen Skript durchlaufen zu lassen – mit Namen, Zahlen und allem – bevor du irgendetwas produzierst.
Passe die Stimme zur Aufgabe an. Warm und gesprächig passt zu Tutorials, Podcasts und Creator-Content. Klar und autoritativ passt zu Geschäftspräsentationen und Schulungen. Energisch funktioniert bei Werbung und Social-Media-Videos; ruhig und ausgewogen passt zu Meditation, Barrierefreiheit und Lehrmaterial; markant oder ausdrucksstark hilft bei Fiktion und Animation. Wenn du eine auf eine bestimmte Plattform zugeschnittene Auswahlliste möchtest, grenzt unser Leitfaden zu den besten Text-to-Speech-Stimmen für YouTube das Feld ein.
Die Sprache verdient dieselbe Sorgfalt. Wähle für mehrsprachige Inhalte eine Stimme, die für die Zielsprache entwickelt wurde, anstatt eine englische Stimme zu zwingen, fremden Text zu lesen – Aussprache, Rhythmus und Betonung unterscheiden sich stark zwischen Sprachen und Akzenten. Unsere Text-to-Speech-API listet Unterstützung für über 33 Sprachen und Dialekte auf und nennt darunter Englisch, Portugiesisch, Spanisch, Französisch, Deutsch, Chinesisch und Japanisch, und unser Voice Cloning funktioniert in 33 Sprachen.
Konsistenz ist der stille Unterschied. Verwende dieselbe Stimme, denselben Aussprachestil und dieselben Wiedergabeeinstellungen in verwandten Videos, damit ein Kanal, ein Kurs oder eine Marke erkennbar bleibt. Wechsle bei Dialogen die Stimmen nur, wenn die Änderung das Verständnis wirklich fördert; zu viele Stimmen lassen ein kurzes Erklärvideo zerfahren wirken.
KI-Sprache weniger maschinell klingen lassen
Die meiste „roboterhafte“ Ausgabe lässt sich auf das Skript zurückführen, nicht auf die Engine. Geschriebene Sprache und gesprochene Sprache sind unterschiedliche Register, und die Stimme liest genau das, was du getippt hast.
Schreibe für das Ohr. Kürzere Sätze kommen natürlicher an als dichte Nebensätze. Vergleiche diese beiden:
Die Implementierung dieser Funktion bietet Nutzern die Möglichkeit, Audioinhalte zu generieren, ohne dass Aufnahmetechnik erforderlich ist.
Mit dieser Funktion kannst du Audio ohne Aufnahmetechnik erstellen.
Der zweite atmet. Nutze auch Satzzeichen als Wiedergabesteuerung: Kommas erzeugen kurze Pausen, Punkte und Absatzumbrüche erzeugen stärkere Übergänge. Wenn die Stimme anfängt zu hetzen oder flach zu werden, teile den Satz.
Zahlen, Daten, Währungen und Abkürzungen sind die üblichen Aussprachefallen. Wenn die Ausgabe falsch klingt, schreibe die Aussprache ins Skript – das ist unsere ständige Empfehlung, wenn generierte Zahlen falsch herauskommen:
| Du hast geschrieben | Schreibe es als |
|---|---|
| 2026 | zwanzig sechsundzwanzig |
| 49,99 € | neunundvierzig Euro und neunundneunzig Cent |
| API | A-P-I |
| SQL | die Aussprache, die deine Zielgruppe erwartet |
Emotionale Ausrichtung kann helfen, sparsam eingesetzt. Ein Hinweis wie „sagte sie fröhlich“ kann die Wiedergabe aufhellen, während „schrie er wütend“ einen kräftigeren Ton erzwingt – aber wenn jeder Satz eine Anweisung trägt, wird die Erzählung theatralisch. Die Geschwindigkeit ist der andere Hebel: Ein etwas langsameres Tempo unterstützt das Verständnis in Kursen und Barrierefreiheits-Audio, während schnellere Wiedergabe zu kurzen Social-Clips passt, bis sie beginnt, die Klarheit zu kosten. Unser Editor zeigt eine Sprechgeschwindigkeits-Steuerung (zum Beispiel einen Wert wie 1,00x), die du in beide Richtungen verschieben kannst. Wenn ein Schlüsselwort verloren geht, korrigiere die Satzstruktur, bevor du zu ungewöhnlicher Formatierung greifst; Betonung sollte der Bedeutung dienen, nicht darauf aufmerksam machen, dass eine Maschine sie erzeugt hat.
Standard-TTS, Voice Cloning oder die API: Was passt
Drei Wege führen zu gesprochenem Audio, und sie lösen unterschiedliche Probleme. Standard-Text-to-Speech verwendet eine vorgefertigte KI-Stimme. Voice Cloning erstellt eine wiederverwendbare synthetische Stimme aus einer Audioprobe. Die API macht beides programmierbar.
Greife zu einer Standard-KI-Stimme, wenn du ein schnelles einmaliges Voiceover brauchst, mehrere Stile zum Probehören, einen Allzweck-Erzähler oder eine Stimme in einer Sprache, die du selbst nicht aufnehmen kannst. Greife zum Voice Cloning, wenn du eine konsistente Creator- oder Markenstimme brauchst, wiederkehrende Episoden mit demselben Erzähler, Audio-Aktualisierungen ohne Neuaufnahme oder mehrsprachige Versionen, die eine erkennbare Stimmidentität bewahren. Wir bieten unbegrenztes Voice Cloning im TTS-Tarif, und geklonte Stimmen funktionieren sowohl in Text-to-Speech als auch in KI-Synchronisation in 33 Sprachen.
Die API ist eine ganz andere Entscheidung. Ein Browser-Editor ist am schnellsten für einzelne Dateien und kleine Stapel. Eine API verdient ihren Platz, wenn die Generierung automatisch erfolgen muss – eine Plattform, die von Nutzern eingereichte Skripte vertont, ein Lernsystem, das Audio-Lektionen erstellt, ein Support-Produkt, das personalisierte Nachrichten versendet, oder eine Agentur, die viele lokalisierte Varianten verarbeitet. Unsere Text-to-Speech-API verwendet eine REST-Schnittstelle mit Projekt- und Segmentverwaltung, Stimm- und Sprachauswahl, Geschwindigkeits- und Tonhöhenparametern, Fortschrittsstatus und Audio-URLs nach der Verarbeitung; sie gibt MP3 zurück, und typische Segmente von ein bis zwei Sätzen dauern je nach Länge und Komplexität etwa 10–30 Sekunden. Merkenswert: Eine API automatisiert das Volumen, aber sie macht ein einzelnes kurzes Voiceover nicht schneller als der visuelle Editor. Wenn du programmgesteuerte Wege generell abwägst, erklärt „Was ist eine Voice-AI-API“ die Kategorie, bevor du irgendetwas integrierst.
Was du prüfen solltest, bevor du dich für ein Tool entscheidest
Das meiste Bedauern entsteht durch das Überspringen eines kurzen Pilotversuchs. Lass denselben Absatz durch mehrere Stimmen laufen, nimm echte Namen und Zahlen aus deinem Workflow auf und höre auf dem Gerät, das deine Zielgruppe tatsächlich benutzt. Dies sind die Kriterien, die es dabei zu bewerten lohnt.
| Entscheidungskriterium | Was zu prüfen ist |
|---|---|
| Stimmqualität | Bleibt sie in langen Sätzen und schwierigen Wörtern natürlich? |
| Aussprache | Kannst du Namen, Abkürzungen und Zahlen korrigieren? |
| Sprachunterstützung | Sind deine genaue Zielsprache und dein Akzent abgedeckt? |
| Konsistenz | Kannst du dieselbe Stimme projektübergreifend wiederverwenden? |
| Bearbeitungssteuerungen | Sind Geschwindigkeit, Tonhöhe, Pausen und Betonung anpassbar? |
| Ausgabe und Geschwindigkeit | Ist das Format verfügbar und die Generierung schnell genug? |
| Automatisierung | Gibt es eine API, falls du programmgesteuerte Generierung brauchst? |
| Rechte und Kosten | Sind Nutzung, kommerzielle Rechte und Kreditbedingungen klar? |
Die Tabelle komprimiert eine Kaufcheckliste auf einen Bildschirm, aber der Pilotversuch ist das, was sie validiert. Eine kostenlose Stufe oder ein kleiner Test sagt dir in zehn Minuten mehr als jede Funktionsliste, denn die einzige Ausgabe, die zählt, ist, wie dein Skript in der Stimme klingt, die du tatsächlich einsetzen würdest.
KI-Sprache verantwortungsvoll einsetzen
Synthetische Sprache ist wirklich nützlich und bringt echte Verpflichtungen mit sich. Klone eine Stimme nur, wenn du die Erlaubnis des Sprechers und die Rechte an der Aufnahme hast. Gib synthetisches Audio nicht als authentische Aufnahme aus und verwende niemals eine vertraut klingende Stimme, um Geld oder sensible Informationen zu erbitten.
Das ist keine abstrakte Vorsicht. Die Federal Trade Commission warnt, dass Voice Cloning betrügerische Anfragen so klingen lassen kann, als kämen sie von einem vertrauten Familienmitglied, Kollegen oder einer Führungskraft, und empfiehlt, die Identität unabhängig zu überprüfen, anstatt allein einer vertrauten Stimme zu trauen.
Für kommerzielle oder öffentlich sichtbare Arbeiten halten dich ein paar Gewohnheiten sicher: Führe Aufzeichnungen, die die Erlaubnis zur Nutzung einer geklonten Stimme belegen, prüfe die Bedingungen des Anbieters zur kommerziellen Nutzung und Datenverarbeitung, weise auf synthetische Erzählung hin, wenn Transparenz für deine Zielgruppe wichtig wäre, und füge menschliche Überprüfung bei rechtlichen, medizinischen, finanziellen oder sicherheitskritischen Inhalten hinzu. Behandle eine Stimme als Annehmlichkeit, niemals als Identitätsnachweis.
Häufig gestellte Fragen
Was ist der schnellste Weg, online Text in Sprache umzuwandeln?
Verwende einen browserbasierten TTS-Editor: Füge ein vorbereitetes Skript ein, wähle eine Stimme, generiere, überprüfe die Aussprache und lade herunter. Das Vorbereiten des Skripts, bevor du das Tool öffnest, ist normalerweise der größte Zeitersparer, denn sauberer Input bedeutet weniger erneutes Generieren.
Kann ich Text kostenlos in Sprache umwandeln?
Einige Plattformen, einschließlich unserer, bieten kostenlosen Zugang oder Testguthaben, aber die Grenzen variieren je nach Tarif. Prüfe die aktuellen Bedingungen für Zeichen, Guthaben, Downloads, kommerzielle Nutzung und Voice Cloning, bevor du veröffentlichst.
Kann ich Online-Text-to-Speech für YouTube verwenden?
Ja. Online-TTS kann Videos, Shorts, Tutorials und mehrsprachige Versionen vertonen. Bestätige die Lizenzbedingungen des Anbieters, damit die Stimme und das generierte Audio für deinen beabsichtigten Zweck freigegeben sind.
Kann ich Text in eine andere Sprache umwandeln?
Ja, wenn die Plattform diese Sprache und eine passende Stimme unterstützt. Für natürliche Ergebnisse übersetze und bearbeite zuerst das Skript und wähle dann eine Stimme, die für die Zielsprache oder den Akzent entwickelt wurde, anstatt eine englische wiederzuverwenden.
Welches Dateiformat sollte ich verwenden?
MP3 passt zu den meisten Videos, Podcasts und Web-Projekten, weil es weit verbreitet unterstützt und kompakt ist. Für professionelle Postproduktion prüfe, ob dein Editor ein anderes oder höherwertiges Quellformat benötigt.
Ist Online-TTS gut genug für professionelle Inhalte?
Für Erklärvideos, Schulungen, Barrierefreiheits-Audio, Entwürfe, lokalisierte Medien und regelmäßig aktualisierte Erzählung: ja. Für performancelastige oder hochriskante Projekte, bei denen subtiles Timing die Bedeutung trägt, höre genau hin und erwäge menschliche Sprecher.