Fragt man, wie neuronale Text-to-Speech funktioniert, lautet die kurze Antwort: Sie wandelt geschriebenen Text in lebensechtes Audio um, indem sie Ihr Skript durch tiefe neuronale Netze laufen lässt, die modellieren, wie Menschen tatsächlich sprechen – Aussprache, Rhythmus und Intonation zusammen. Anstatt vorab aufgenommene Fragmente aneinanderzureihen, wie es ältere Systeme taten, erzeugt neuronale TTS Sprache von Grund auf neu und lernt Muster direkt aus großen Datensätzen echter menschlicher Aufnahmen, die mit Text kombiniert sind. Dieser Unterschied ist der Grund, warum moderne synthetische Stimmen wie ein Erzähler klingen, dem man ein ganzes Video lang zuhören könnte, statt wie eine roboterhafte Durchsage. Bei DubSmart AI bauen wir auf genau diesem neuronalen Ansatz auf, um unser Text to Speech anzutreiben, und verbinden es mit Stimmklonen und Synchronisation, sodass ein einziges Skript von einer Sprache in viele reisen kann.
Dieser Leitfaden führt Schritt für Schritt durch den Mechanismus und übersetzt ihn dann in praktische Entscheidungen: wo eine neuronale Stimme stark genug ist, um allein zu bestehen, wo Sie weiterhin eine menschliche Darbietung wünschen und wie die Teile innerhalb unserer Plattform zusammenpassen.
Inhaltsverzeichnis
Was „wie neuronale Text-to-Speech funktioniert" wirklich bedeutet
Neuronale Text-to-Speech ist eine Form der Sprachsynthese, die tiefe neuronale Netze nutzt, um Sprache von Grund auf neu zu erzeugen. Der entscheidende Unterschied zu regelbasierten oder konkatenativen Methoden besteht darin, dass das System aus großen Datensätzen menschlicher Aufnahmen lernt, die mit Text kombiniert sind, sodass es sowohl vorhersagen kann, wie Wörter klingen sollten, als auch, wie ein Mensch sie natürlich vortragen würde. Dieses erlernte Verhalten ist es, das die Prosodie erfasst – Betonung, Rhythmus, Pausen und emotionaler Tonfall – und die resultierende Stimme über lange Hörsitzungen hinweg angenehm macht. Große Cloud-Anbieter beschreiben diese neuronalen Stimmen als menschenähnliche synthetisierte Sprache, deren Artikulation die Höranstrengung bei Assistenten, Barrierefreiheitswerkzeugen und Vorlesefunktionen verringert.
Unsere Text to Speech-Engine folgt diesem neuronalen Ansatz. Sie analysiert Ihr Skript, zerlegt es in Phoneme, leitet Rhythmus und Intonation ab und verwendet dann neuronale Modelle, um flüssiges Audio zu erzeugen, statt der flachen Darbietung, die man mit älterer TTS verbindet. Das Ergebnis ist realistische Sprache, die in Sekunden aus Text erzeugt wird und aus einer Bibliothek von über 300 Stimmen stammt, die auf unterschiedliche Tonlagen und Anwendungsfälle zugeschnitten sind.
Warum neuronale TTS für Creator und Teams wichtig ist
Für YouTube-Creator, kleine Unternehmen, E-Learning-Produzenten, Filmemacher, Podcaster und Entwickler geht es nicht nur darum, wie die Technologie funktioniert, sondern auch darum, ob man sich in einer Produktions-Pipeline auf sie verlassen sollte. Neuronale TTS ist wichtig, weil sie synthetische Stimmen aus dem „Nutz"-Bereich – Navigationsanweisungen, einfache Ansagen – herausholt und in den Bereich der Darbietung bringt: gut genug, um Inhalte zu tragen, ganze Kurse zu vertonen und Markenbotschaften zu übermitteln, ohne offensichtlich künstlich zu klingen. Kombiniert man sie mit Übersetzung und Synchronisation, wird sie zum Multiplikator, der es einem einzigen Skript ermöglicht, Dutzende von Sprachen zu einem Bruchteil der Kosten und Zeit herkömmlicher Studioarbeit zu erreichen.
Wir haben DubSmart genau um diese Entscheidung herum gestaltet. Text to Speech, Voice Cloning, AI Dubbing, Speech to Text, Speech Separator, Text to Image und Image to Video liegen in einer einzigen Pipeline, sodass gesprochene Inhalte vom Upload bis zum mehrsprachigen Export bewegt werden, ohne mit separaten Tools jonglieren zu müssen. Sie entscheiden bei jeder Stufe – Skript, Stimme, Sprache, Mix – wie viel automatisiert und wie viel angepasst werden soll, alles in einer einzigen Umgebung.
Wo das landet, hängt davon ab, was Sie produzieren:
- Einen YouTube-Kanal auf neue Sprachen ausweiten: Neuronale TTS plus Synchronisation ermöglicht es Ihnen, Skripte und Timing wiederzuverwenden und dabei lokalisierte Stimmen einzuwechseln.
- Marketing- oder Trainingsvideos lokalisieren: Sie erhalten eine konsistente Markennarration über Sprachen hinweg, ohne für jede Aktualisierung Sprecher buchen zu müssen.
- E-Learning oder Unternehmensschulungen produzieren: Langform-Narration wird skalierbar und lässt sich leicht überarbeiten, wenn sich Inhalte ändern.
- Einen Podcast oder Indie-Film betreiben: Sie können mehrsprachige Versionen, Narrationseinschübe oder Barrierefreiheitsspuren erstellen.
- Anwendungen entwickeln: Unsere APIs verwandeln neuronale Sprache in einen abrufbaren Dienst für IVRs, Agenten und Content-Tools.
Das Verständnis des Mechanismus hilft Ihnen zu beurteilen, wo eine neuronale Stimme allein bestehen kann und wo eine menschliche Aufnahme als Quelle für Klonen oder Synchronisation dienen sollte.
Ein Blick unter die Haube: die neuronale TTS-Pipeline
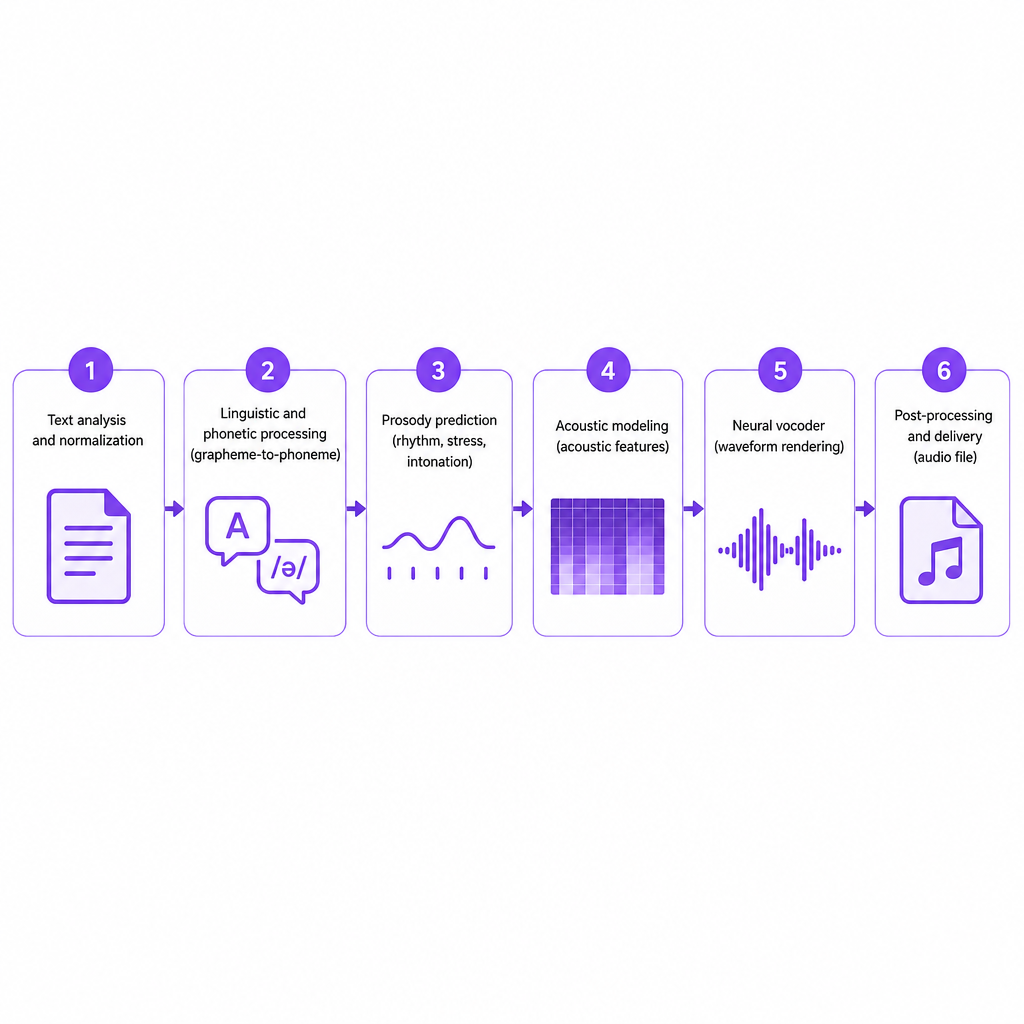
Engines unterscheiden sich im Detail, aber sie teilen eine weitgehend ähnliche Pipeline, die in technischer Dokumentation und in Offenlegungen zu verantwortungsvoller KI großer Anbieter beschrieben wird, und unsere eigenen Erklärungen dazu, wie KI-Voiceovers entstehen, stimmen damit überein.
Textanalyse und Normalisierung
Zuerst nimmt das System Ihren Text auf und normalisiert ihn in eine sprechbare Form. Das bedeutet, Zahlen auszuschreiben („2026" wird zu „zwanzig sechsundzwanzig"), Daten und Abkürzungen aufzulösen, mehrdeutige Token wie „US" gegenüber „us" kontextabhängig aufzulösen und Satzzeichen sowie Struktur zu lesen, um Pausen und Betonungen zu planen. Unsere Engine interpretiert Satzzeichen und Struktur, um Rhythmus und Fluss abzuleiten, statt Text als flachen Zeichenstrom zu behandeln. Diese Stufe hat echtes Gewicht für längere Skripte – Kurse, Erklärvideos, Podcasts – bei denen Absatzstruktur und Überschriften prägen, wie ein Mensch natürlich lesen würde.
Linguistische und phonetische Verarbeitung
Der normalisierte Text wird in Phoneme umgewandelt, die grundlegenden Klangeinheiten einer Sprache. Ein Graphem-zu-Phonem-Modell ordnet Zeichen Klängen zu und behandelt dabei Ausspracheregeln, Ausnahmen und mehrsprachige Eingaben. Genau das ermöglicht es unserem Text to Speech, Skripte in vielen Sprachen zu akzeptieren und die korrekte phonetische Sequenz für die ausgewählte Sprache zu erzeugen, egal ob Sie eine integrierte oder eine geklonte Stimme verwenden. Unsere neuronalen Stimmen decken mehr als 33 Sprachen ab, darunter Englisch, Portugiesisch, Spanisch, Französisch, Deutsch, Chinesisch und Japanisch.
Prosodie-Vorhersage
Prosodie – Rhythmus, Betonung und Intonation – ist der Unterschied zwischen einer roboterhaften Stimme und einer menschenähnlichen Darbietung. Neuronale Modelle lernen prosodische Muster direkt aus Aufnahmen, sodass sie entscheiden können, wo und wie lange pausiert wird, welche Wörter betont werden und wie Tonhöhe und Energie über einen Satz oder Absatz hinweg angepasst werden. Hochauflösende neuronale Stimmen gehen noch weiter, erkennen die Stimmung im Text und passen den Tonfall an, während sie eine stabile Persona beibehalten – genau das ermöglicht eine gesprächige oder einfühlsame Darbietung für Support-Inhalte und Narration. Unsere Engine leitet die Prosodie aus demselben Grund ab, bevor sie Audio synthetisiert: um eine flache Darbietung zu vermeiden und Sprache zu erzeugen, der man ein ganzes Modul lang zuhören könnte.
Akustische Modellierung
Sobald Phoneme und Prosodie feststehen, wandelt ein neuronales akustisches Modell diese Darstellung in akustische Merkmale um – einen Bauplan für die Schallwelle. Offenlegungen zu verantwortungsvoller KI weisen darauf hin, dass diese Modelle neben Aufnahmen eines bestimmten Sprechers auch auf eine breitere Quellbibliothek vieler Sprecher zurückgreifen. Diese Mischung hilft dem Netzwerk, allgemeine Sprechmuster zu lernen und gleichzeitig die Klangfarbe, den Akzent und den Stil einer bestimmten Stimme zu erfassen. In unserer Plattform ist es diese Modellierung, die über 300 Stimmen zugleich unterscheidbar und natürlich klingen lässt, und sie bildet die Grundlage für schnelles Stimmklonen, bei dem das System die akustische und prosodische Signatur einer Stimme aus einer kurzen Probe lernt.
Vocoder und Audio-Rendering
Die akustischen Merkmale werden an einen neuronalen Vocoder weitergegeben, der sie in eine vollständige Audiowellenform umwandelt. Neuere Vocoder erzeugen hochauflösende Sprache, die von Studioaufnahmen kaum zu unterscheiden ist, mit klaren Konsonanten, weichen Vokalen und minimalen Artefakten. Die Kombination aus neuronalem akustischem Modell und Vocoder ist der Grund, warum neuronale Stimmen weitaus natürlicher klingen als die ältere Technologie, die in herkömmlichen Screenreadern und IVRs verwendet wird. Wir nutzen ähnliche Fortschritte, sodass erzeugtes Audio bereit ist, direkt veröffentlicht oder in einen Mix mit Musik und Soundeffekten eingefügt zu werden.
Nachbearbeitung und Auslieferung
Schließlich kann das System eine Nachbearbeitung anwenden – Rauschformung, Lautstärkenormalisierung oder Formatkonvertierung –, bevor es die Audiodatei zurückgibt. Für API-Workflows ist dies in einen RESTful-Endpunkt eingebettet, der Text- und Stimmparameter akzeptiert und ein einsatzbereites Asset zurückgibt. Unser Text to Speech folgt genau diesem Ablauf: Text einfügen oder senden, Sprache und Stimme wählen, die Darbietung anpassen, wo Steuerelemente verfügbar sind, generieren und Audio im Standardformat herunterladen. Dieselbe Engine liegt unserem AI Dubbing zugrunde, bei dem Transkription, Übersetzung und Synthese verkettet werden, um mehrsprachige Versionen zu erstellen.
Optionen in DubSmart: Stimmen, Klonen, Synchronisation und APIs
Das Verständnis der Mechanik erklärt, warum unser Funktionsumfang so aufgebaut ist, wie er ist.
Text to Speech für direkte Narration
Unser Text-to-Speech-Tool ist die zentrale Schnittstelle, um Skripte in Audio umzuwandeln. Sie fügen Text in einer beliebigen unterstützten Sprache ein oder laden ihn hoch, wählen aus den über 300 natürlich klingenden Stimmen, legen Sprache und grundlegende Darbietungssteuerungen fest, wo verfügbar, und erzeugen Sprache in Sekunden. Es deckt YouTube-Hooks und vollständige Videonarration, Erklär- und Promo-Voiceovers für kleine Unternehmen, klare E-Learning- und Trainingsmodule sowie Podcast-Intros, -Outros und Mid-Rolls ab. Wenn Sie Tools für diese Aufgabe abwägen, zeigt unsere Übersicht der besten KI-Synchronisationssoftware für Creator, wie Narration und Lokalisierung zusammenhängen.
Stimmklonen: Ihre Marken- oder Moderatorenstimme bewahren
Stimmklonen baut auf denselben neuronalen Schritten auf – Phoneme, Prosodie, akustische Merkmale –, optimiert das Netzwerk jedoch so, dass es eine bestimmte Klangfarbe und einen bestimmten Stil trifft, sodass Sie neue Zeilen in dieser Stimme erzeugen können, ohne neu aufnehmen zu müssen. Unser schnelles Stimmklonen erstellt benutzerdefinierte Stimmen, die Sie in Text to Speech oder AI Dubbing verwenden können, was bedeutet, dass lokalisierte Inhalte weiterhin wie Ihr Moderator, Erzähler oder Ihre Marke klingen. Diese Kontinuität ist am wichtigsten für Kanäle und Unternehmen, die in eine wiedererkennbare Stimmidentität investiert haben.
AI Dubbing: Verkettung von Speech to Text, Übersetzung und TTS
KI-Synchronisation nutzt die TTS-Engine als letzten Schritt in einer längeren Kette: vorhandenes Audio transkribieren, das Transkript übersetzen und dann neue Sprache in der Zielsprache synthetisieren. Unser AI Dubbing hält Synchronisation, Text-to-Speech, Speech-to-Text und Klonen in einem Workflow, sodass Inhalte vom Upload bis zum mehrsprachigen Export bewegt werden, ohne die Plattform zu verlassen. In der Praxis können Sie ein Video oder einen Podcast hochladen, es transkribieren und vom Hintergrundaudio trennen lassen, in eine oder mehrere Sprachen übersetzen und dann synchronisierte Spuren mit Standard- oder geklonten Stimmen erzeugen, die Timing und Tonfall bewahren. Eine Anleitung zu gesprochenen Inhalten finden Sie in unserem Leitfaden, wie man einen Podcast in eine andere Sprache übersetzt.
APIs für Entwickler und Agenturen
Wir stellen neuronale TTS und Synchronisation über APIs bereit, sodass Entwickler und Agenturen die Sprachgenerierung in ihre eigenen Produkte integrieren können. Unsere Text-to-Speech-API ist ein RESTful-Dienst, der eine POST-Anfrage mit Textinhalt und Stimmpräferenzen akzeptiert und hochwertiges Audio zurückgibt, mit Zugriff auf erstklassige neuronale Stimmen in mehr als 33 Sprachen. Die AI-Dubbing-API erweitert dies auf automatisierte mehrsprachige Synchronisation. Für Agenturen, die Lokalisierung über mehrere Kunden hinweg abwickeln, standardisieren diese Endpunkte die Sprachgenerierung, während sie Sprachen und Personas pro Marke individuell anpassen.
Entscheidungskriterien: neuronale TTS richtig wählen und nutzen
Sobald der Mechanismus klar ist, besteht die praktische Arbeit darin, zu entscheiden, wann und wie man ihn einsetzt.
Natürlichkeit und Hörkomfort. Der zentrale Test ist, ob die Stimme natürlich genug ist, damit Ihr Publikum sie als Hauptsprecher akzeptiert. Tiefe neuronale Netze und HD-Stimmen sind darauf ausgelegt, die Höranstrengung zu verringern, aber die richtige Wahl hängt weiterhin vom Inhaltstyp ab. Nutzen Sie unsere große Stimmbibliothek, um Personas zu testen – energiegeladen, ruhig, verspielt, autoritativ – und bevorzugen Sie für Langform-Kurse oder Podcasts Stimmen, deren Prosodie eher gesprächig als ansageartig wirkt.
Sprachabdeckung und Akzentpassung. Für mehrsprachige Expansion benötigen Sie sowohl die Sprache als auch einen für die Zielgruppe geeigneten Akzent. Unsere neuronalen Stimmen umfassen mehr als 33 Sprachen über wichtige Märkte hinweg. Bei der Auswahl lokalisierter Spuren entscheiden Sie, ob Sie einen neutralen oder regionsspezifischen Akzent möchten, und testen Sie Proben nach Möglichkeit mit Muttersprachlern.
Markenkonsistenz gegenüber Flexibilität. Das Klonen trägt eine bestimmte Stimme über Sprachen und Projekte hinweg, bringt aber Verantwortlichkeiten rund um Einwilligung und Offenlegung mit sich. Nutzen Sie es, wenn eine konsistente Persona zentral für Ihre Marke ist, und dokumentieren Sie, wer diese Stimme besitzt und kontrolliert – insbesondere bei Unternehmens- oder Agenturarbeit.
Workflow-Integration. Neuronale TTS liefert den größten Nutzen, wenn sie sich in Ihre bestehende Arbeitsweise einfügt. Da unsere Tools Text-to-Speech, Klonen, Synchronisation, Speech to Text und Medien-Hilfsprogramme kombinieren, können Sie einen Großteil der Lokalisierungskette automatisieren und dennoch Skripte und Audio bearbeiten. Solo-Creator finden die Browser-Tools möglicherweise ausreichend; Entwickler und Agenturen erhalten programmierbare Endpunkte zum Skalieren.
Risiken, Grenzen und verantwortungsvolle Nutzung
Selbst fortschrittliche Modelle haben Grenzen, die man einplanen sollte.
- Emotionale Nuancen: HD-Stimmen reagieren auf Stimmung, können aber subtile Hinweise oder komplexe Darbietungen verpassen, die ein erfahrener Schauspieler liefern würde. Kritische Markenbotschaften oder erzählerisches Drama können weiterhin eine menschliche Aufnahme als Quelle rechtfertigen.
- Ausnahmefälle bei der Aussprache: Seltene Namen, neuartige Begriffe oder gemischtsprachige Skripte können Graphem-zu-Phonem-Modelle herausfordern, also planen Sie manuelle Überprüfungen ein.
- Ethik des Klonens: Leitlinien zu verantwortungsvoller KI betonen, dass benutzerdefinierte Stimmen mit ausdrücklicher Einwilligung, klaren Verträgen und Offenlegung gegenüber dem Publikum erstellt und genutzt werden sollten. Das Nachahmen von Personen ohne Erlaubnis wirft rechtliche und ethische Bedenken auf.
- Verzerrung und Repräsentation: Trainingsdaten prägen, wie Stimmen mit Akzenten und Dialekten umgehen, prüfen Sie also, ob die von Ihnen gewählten Stimmen Ihr Publikum fair repräsentieren und keine Stereotype verstärken.
Da unser integrierter Workflow es leicht macht, synthetische Sprache zu erzeugen und einzusetzen, wird die interne Überprüfung wichtiger, nicht weniger wichtig – besonders wenn Sie Kunden- oder Mitarbeiterstimmen verarbeiten. Ein konkreter Weg hilft: Ein Creator kann ein englisches Skript schreiben, ein englisches Voiceover erzeugen und dann spanische, portugiesische und deutsche Versionen für zusätzliche Kanäle synchronisieren, während dasselbe Timing und dieselbe Darbietung beibehalten werden. Ein Trainingsteam kann modulare Narration erstellen und diese schnell neu erzeugen, wann immer sich Richtlinien ändern. Das ist der eigentliche Gewinn des Verständnisses der Pipeline – Sie wissen, welche Stufe Sie kontrollieren und welche Sie dem Modell überlassen sollten.
Häufig gestellte Fragen
Was ist neuronale Text-to-Speech in einfachen Worten?
Neuronale Text-to-Speech ist KI, die geschriebenen Text mithilfe tiefer neuronaler Netze, die auf großen Datensätzen menschlicher Aufnahmen trainiert wurden, in Sprache umwandelt und dabei Stimmen erzeugt, die echten Menschen viel näher klingen als ältere TTS-Systeme.
Wie unterscheidet sich DubSmarts Text to Speech von einfacher TTS?
Wir verwenden neuronale Modelle, die Ihr Skript analysieren, die Prosodie ableiten und Sprache von Grund auf neu synthetisieren, unterstützt von über 300 natürlichen Stimmen und schnellem Stimmklonen, sodass die Ausgabe als Hauptsprecher für Videos, Kurse und Podcasts funktioniert.
Kann DubSmart meine eigene Stimme in anderen Sprachen beibehalten?
Ja. Unser Stimmklonen kann Ihre Stimme aus Aufnahmen lernen und sie dann in Text-to-Speech und AI Dubbing verwenden, sodass lokalisierte Versionen Ihrer Inhalte weiterhin wie Sie oder Ihr Markensprecher klingen.
Wie funktioniert KI-Synchronisation mit neuronaler TTS?
KI-Synchronisation verkettet Speech-to-Text-Transkription, Übersetzung und neuronale Text-to-Speech und verwandelt Ihr vorhandenes Audio in einem einzigen Workflow in mehrsprachige synchronisierte Spuren, entweder mit Standardstimmen oder Ihrer geklonten Stimme.
Ist neuronale Text-to-Speech sicher und ethisch nutzbar?
Mit Einwilligung, klarer Offenlegung und geeigneten Schutzmaßnahmen eingesetzt, ist neuronale TTS ein starkes Werkzeug für Barrierefreiheit und Lokalisierung. Leitlinien zu verantwortungsvoller KI betonen die Achtung der Rechte von Sprechern und die Vermeidung täuschender Verwendungen synthetischer Stimmen.