Die Wahl der besten KI-Synchronisationssoftware für Creator läuft meist auf eine Frage hinaus: Möchten Sie ein einziges Studio, das Transkription, Übersetzung, Stimmerzeugung, Timing und Export übernimmt, oder möchten Sie eine Handvoll unverbundener Apps zusammenflicken und hoffen, dass das Timing überlebt? Wir haben DubSmart AI rund um die erste Antwort entwickelt. Unsere Tools für KI-Synchronisation, Text-to-Speech, Speech-to-Text und Voice Cloning laufen innerhalb eines einzigen Workflows, sodass gesprochene Inhalte vom Upload bis zum fertigen mehrsprachigen Export gelangen, ohne die Plattform zu verlassen.
Dies ist keine Übersicht, die konkurrierende Marken bewertet. Es ist eine praktische Aufschlüsselung der DubSmart-Funktionen, die für ernsthafte Creator wichtig sind, für wen jede einzelne geeignet ist und wo die ehrlichen Grenzen liegen – damit Sie die richtigen Tools mit Ihrem Kanal abstimmen können, statt zu raten.
Inhaltsverzeichnis
Wonach diese Liste tatsächlich auswählt
Bevor ein Tool hier einen Platz verdient, muss es echte Anforderungen von Creatorn erfüllen, statt nur auf einem Feature-Blatt beeindruckend zu klingen. Wir haben jede Funktion anhand von sechs Kriterien beurteilt, die entscheiden, ob mehrsprachige Inhalte tatsächlich erscheinen.
- Durchgängige, stimmenzentrierte Lokalisierung. Die Kette vom Upload bis zum Export sollte an einem Ort liegen, statt aus einem Flickwerk separater Apps zu bestehen.
- Umfassende Sprachabdeckung. Wir unterstützen die Synchronisation aus mehr als 60 Ausgangssprachen in 33 Zielsprachen, sodass eine Plattform ein globales Publikum erreichen kann.
- Natürliche, wiederverwendbare Stimmen. Text-to-Speech und Voice Cloning ermöglichen es Ihnen, dieselben Stimm-Assets über Projekte hinweg beizubehalten, statt sie jedes Mal neu aufzubauen.
- Bearbeitungskontrolle. Anpassungen von Segmenten, Timing und Sprechern halten Synchronisationen synchron und markengerecht.
- Ein Weg sowohl für nicht-technische Creator als auch für Entwickler. Ein Web-Studio für praktische Bearbeitung sowie APIs für Teams, die automatisieren möchten.
- Preisgestaltung und Skalierbarkeit, die zu YouTube-Kanälen, Kleinunternehmen, E-Learning-Katalogen und Produktionsteams passen.
Alles Folgende bezieht sich auf diese Kriterien: was die Funktion anders macht, für wen sie geeignet ist und die praktischen Grenzen, die man kennen sollte, bevor man einen ganzen Katalog darauf festlegt.
Integriertes KI-Synchronisationsstudio für mehrsprachige Workflows
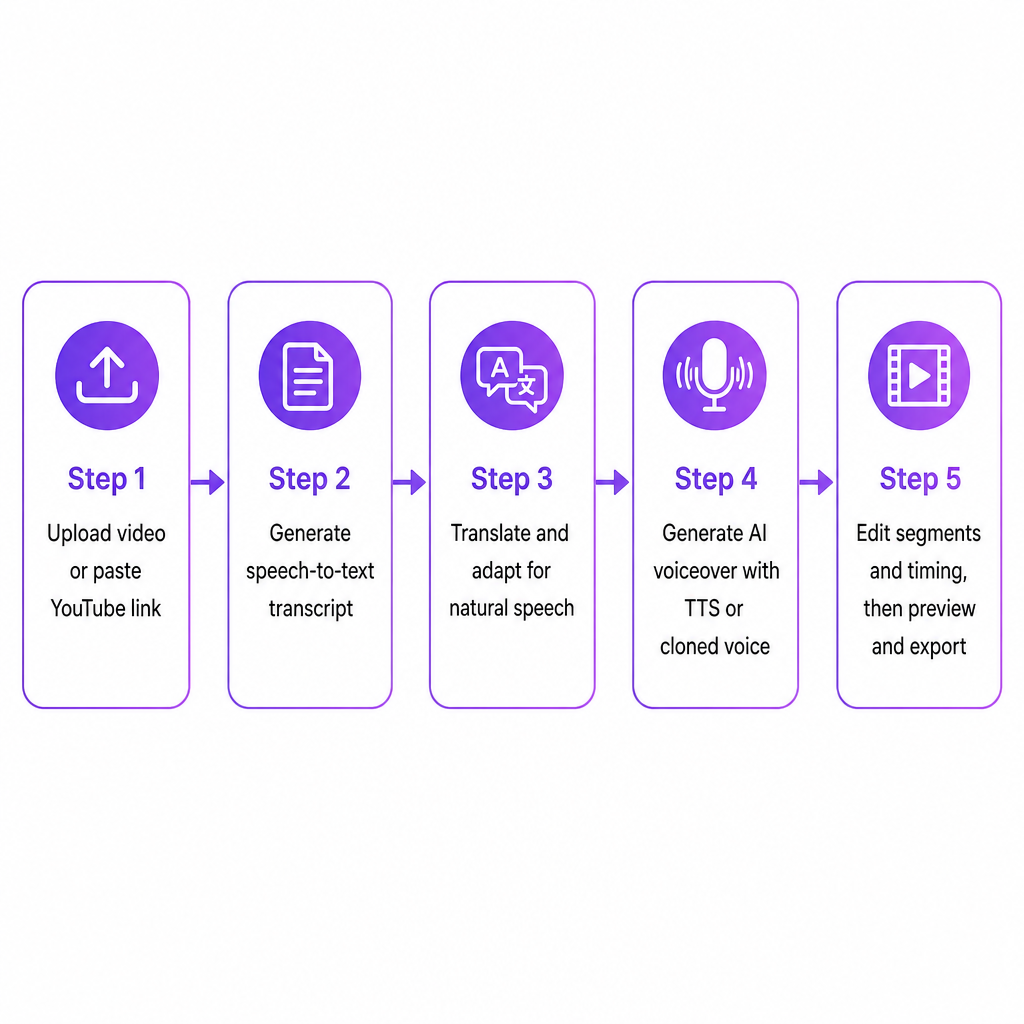
Warum mit einer Transkriptions-App, einem Übersetzungsdokument, einem TTS-Tool und einem Videoeditor jonglieren, wenn sie sich beim Timing nie ganz einig sind? Unser KI-Synchronisationsstudio läuft online und ermöglicht es Ihnen, Video oder Audio von Ihrem Gerät hochzuladen oder einen YouTube-Link einzufügen, sodass wir die Quelle automatisch abrufen. Von dort aus laufen Transkription, Übersetzung, Stimmerzeugung, Segmentbearbeitung und Export als eine einzige Kette ab. Sie können Sprecher hinzufügen, Timings und Text bearbeiten, Segmente anpassen und das lokalisierte Video vor dem Download in der Vorschau ansehen.
Unterscheidungsmerkmal. Wir konzentrieren uns auf stimmen- und audiozentrierte Lokalisierung und verwandeln gesprochene Inhalte aus über 60 Ausgangssprachen in synchronisierte Versionen in 33 Zielsprachen – gestützt auf eine große KI-Stimmbibliothek und Voice Cloning an einem Ort. Der Ein-Studio-Ansatz ist darauf ausgelegt, Timing, Ton und Absicht aufeinander abgestimmt zu halten, während Inhalte Sprachen überschreiten – genau dort, wo zusammengeflickte Tool-Ketten tendenziell versagen.
Beste Eignung. YouTube-Creator, die einen bewährten Kanal in neue Sprachmärkte erweitern, ohne eine vollständige Postproduktions-Pipeline aufzubauen; Kleinunternehmen und Marketingteams, die Videokampagnen für neue Regionen wiederverwenden; E-Learning- und Unternehmensschulungsproduzenten, die englischsprachige Module in mehrsprachiges Voiceover umwandeln, ohne separate Sprachstudios zu engagieren.
Einschränkungen. Die Automatisierung beschleunigt die Arbeit, macht es aber nicht überflüssig, Transkripte und Übersetzungen auf Nuancen zu prüfen und leicht zu bearbeiten, besonders bei spezialisierten oder technischen Inhalten. Die Ausgabequalität hängt von Ihrem Ausgangsaudio ab, sodass starkes Hintergrundgeräusch oder überlappende Sprache weiterhin von einer vorherigen Bereinigung profitiert. Und obwohl die Abdeckung breit ist, ist sie durch die dokumentierten über 60 Ausgangs- und 33 Zielsprachen begrenzt – Nischendialekte oder ressourcenarme Sprachen können einen hybriden Workflow mit menschlichem Talent erfordern.
Schnelles Voice Cloning für Marken-, Creator- und Charakterstimmen
Generische Erzählung ist der schnellste Weg, ein synchronisiertes Video so wirken zu lassen, als gehöre es jemand anderem. Unser Voice Cloning erstellt individuelle KI-Stimmen aus Audiosamples, benötigt mindestens 20 Sekunden sauberer Sprache und schließt den Klon in Sekunden ab. Diese geklonte Stimme funktioniert dann sowohl in Text-to-Speech- als auch in Synchronisationsprojekten, sodass Ihre Stimme – oder jede Stimme, die Sie rechtlich lizenziert nutzen dürfen – zu einem wiederverwendbaren Asset für mehrsprachige Inhalte wird.
Unterscheidungsmerkmal. Das Klonen ist hier kein isoliertes Laborexperiment. Es fügt sich direkt in Ihre Synchronisations- und TTS-Abläufe ein, was es praktisch macht, eine einzige Moderatorenstimme über Videos und Sprachen hinweg beizubehalten, während sich nur die gesprochene Sprache ändert.
Beste Eignung. Solo-Creator, deren synchronisierte Videos wie sie selbst klingen sollen; Podcaster und Filmemacher, die konsistente Charakterstimmen über Episoden oder Schnitte hinweg wiederverwenden und lokalisieren müssen; Marken und Unternehmen mit charakteristischem Stimmtalent, die diese Stimme über Kampagnen in mehreren Sprachen skalieren möchten.
Einschränkungen. Das Klonen erfordert saubere, geräuschfreie Aufnahmen; schwaches Ausgangsaudio senkt die Qualität und kann eine Neuaufnahme erzwingen. Sie sind dafür verantwortlich, die Rechte und die Einwilligung für jede Stimme zu haben, die Sie klonen – die Einfachheit der Technologie ändert nichts an Ethik oder Recht. Und für anspruchsvolle erzählerische oder filmische Arbeiten können extrem stilisierte oder theatralische Darbietungen weiterhin besser von einer menschlichen Aufnahme erbracht werden.
Text-to-Speech für Trainings, Erklärvideos und Voiceover im großen Maßstab
Wenn Sie Dutzende von erzählten Lektionen oder Erklärvideos benötigen, ist die Neuaufnahme jedes einzelnen keine Option. Unsere Text-to-Speech-Tools wandeln Skripte in natürlich klingende Sprache um – mit integrierten KI-Stimmen oder Ihrer eigenen geklonten Stimme. Innerhalb des Lokalisierungs-Workflows erstellen Sie ein Transkript, übersetzen und passen es für natürliche Sprache an und erzeugen dann das KI-Voiceover, bevor Sie Segmente und Timing verfeinern – eine Abfolge, die zu Trainingsvideos, Erklärvideos und stimmengeführten Formaten passt.
Unterscheidungsmerkmal. Das ist mehr als ein Vorlese-Dienstprogramm. Die TTS-Engine sitzt innerhalb des Synchronisationsstudios, wo Sie bestimmte Segmente neu generieren, Segmente zusammenführen oder aufteilen sowie emotionalen Ton und Timing anpassen können. In Kombination mit Voice Cloning gibt Ihnen das eine granulare Kontrolle darüber, wie ein übersetztes Skript in jeder Sprache tatsächlich klingt.
Beste Eignung. E-Learning-Produzenten und Instruktionsdesigner, die große Kataloge erzählter Lektionen oder Microlearning-Module aufbauen; Unternehmensschulungsteams, die Compliance- oder Onboarding-Inhalte über Regionen hinweg aktualisieren, ohne jedes Modul neu aufzunehmen; Marketing- und Produktteams, die Erklär- und Demo-Voiceovers produzieren, die über Sprachversionen hinweg konsistent bleiben müssen.
Einschränkungen. KI-Sprache kann sehr natürlich sein, doch emotional intensives Storytelling oder filmische Spots wünschen sich möglicherweise weiterhin eine maßgeschneiderte menschliche Darbietung. Wörtlich genau übersetzte Skripte benötigen oft eine Anpassung an den gesprochenen Fluss; der Workflow unterstützt dies, erfordert aber dennoch Ihre Mitwirkung. Wird die Formulierungsprüfung übersprungen, können manche Zielsprachen steif oder übermäßig förmlich klingen.
Entwickler-APIs für Synchronisation, TTS und Voice Cloning
Wenn Sie Lokalisierung als Funktion innerhalb Ihres eigenen Produkts ausliefern, skalieren manuelle Exporte nicht. Wir stellen unsere Kernfunktionen über APIs bereit, sodass Sie Medien einlesen, individuelle Stimmen erstellen und Synchronisation programmatisch ausführen können. Die AI Dubbing API stellt eine vorsignierte URL aus, sodass Sie Videodateien mit standardmäßigen HTTP-PUT-Anfragen hochladen, und die Voice Cloning API akzeptiert gängige Audioformate wie MP3, WAV, AAC, M4A und FLAC für den Sample-Upload. Über die API erstellte Stimmen fließen dann in Text-to-Speech und Synchronisation ein.
Unterscheidungsmerkmal. Die APIs verwandeln unser Creator-Studio in eine Engine, die Sie in Plattformen, SaaS-Produkte und Agentur-Workflows einbetten können. Statt Dateien von Hand zu exportieren, automatisieren Sie Upload, Stimmerstellung, Synchronisation und Abruf und verdrahten die Lokalisierung direkt in Ihre eigenen Anwendungen oder Pipelines.
Beste Eignung. Videoplattformen und Creator-Tools, die einen „Dieses Video synchronisieren"-Button hinzufügen; Agenturen und Lokalisierungsanbieter, die sich auf ein KI-Synchronisations-Backend standardisieren und dabei ihr eigenes Frontend behalten; interne Engineering-Teams, die mehrsprachige Stimmen in Schulungsportale, Support-Center oder Content-Management-Systeme einbetten.
Einschränkungen. Die API-Nutzung setzt Entwicklerressourcen und Vertrautheit mit HTTP und JSON voraus – nicht-technische Teams bevorzugen oft das Studio. Rate Limiting, Fehlerbehandlung und Dateispeicher-Infrastruktur liegen auf der Seite des Integrators, auch wenn wir die Synchronisationslogik bereitstellen. Die Governance darüber, wer geklonte Stimmen erstellen und nutzen darf, muss auf Anwendungsebene durchgesetzt werden.
Speech-to-Text als Grundgerüst für präzises Timing
Eine Synchronisation, die einen Takt vom Bild abweicht, fühlt sich falsch an, selbst wenn die Worte perfekt sind. Unsere Speech-to-Text-Ebene wandelt gesprochene Inhalte in ein bearbeitbares Transkript um, bevor etwas neu vertont wird. Die von uns dokumentierte durchgängige Kette läuft so ab: ein Transkript des Originalvideos erstellen, es auf Genauigkeit und Klarheit hin bearbeiten, die Formulierung für natürliche Sprache übersetzen und anpassen, das KI-Voiceover erzeugen, das Audio im Synchronisationsstudio anpassen und dann in der Vorschau ansehen und exportieren.
Unterscheidungsmerkmal. Wir bauen Speech-to-Text in die Synchronisations-Pipeline ein, statt es als separates Produkt zu behandeln. Das bedeutet, dass Sie Transkriptfehler korrigieren, Zeilen umschreiben und das Tempo anpassen, bevor Stimmen und Timings erzeugt werden – was am wichtigsten ist, wenn synchronisierte Sprache mit vorhandenem Bildmaterial abgestimmt wird, wo kleine Fehlausrichtungen störend wirken. Wenn Sie auch mit lauten Mehrsprecher-Aufnahmen arbeiten, deckt unser Leitfaden „Speech Separator erklärt" den Bereinigungsschritt ab, der die Transkriptgenauigkeit schützt.
Beste Eignung. Talking-Head- und Tutorial-Kanäle, bei denen präzises Sprach-Timing entscheidend ist; Trainings- und Unternehmenskommunikationsteams, die wortgetreue Genauigkeit für Compliance benötigen und dabei dennoch die Formulierung für eine natürliche Wiedergabe anpassen; lokalisierte Produktdurchläufe oder UI-Demos, bei denen die Stimme bestimmte visuelle Momente treffen muss.
Einschränkungen. Die Transkriptgenauigkeit hängt weiterhin von Audioqualität, Sprecherakzent und Fachvokabular ab, sodass technische oder laute Aufnahmen mehr Überprüfung benötigen. Komplexes Mehrsprecher- oder stark überlappendes Audio ist ohne vorherige Bereinigung schwerer zu transkribieren und auszurichten. Der Workflow reduziert manuelle Arbeit, macht aber abschließende Qualitätsprüfungen nicht überflüssig – besonders in regulierten Branchen.
So wählen Sie das richtige Setup für Ihren Kanal
Sobald die Bausteine klar sind, ist die Zuordnung zu Ihrem Profil unkompliziert. Nutzen Sie diese Zuordnung, um zu entscheiden, wo Sie beginnen.
| Ihr Profil | Beginnen Sie mit | Warum es passt |
|---|---|---|
| YouTube-Creator oder Filmemacher | Synchronisationsstudio + Voice Cloning + Timing-Steuerung | Synchronisierte Versionen fühlen sich wie Ihre Originale an, nicht wie Neuerzählungen |
| Marketing/Training in Kleinunternehmen | TTS- + Synchronisations-Workflow | Skalieren Sie Erklärvideos und Trainings über Sprachen hinweg mit bearbeitbaren, wiederverwendbaren Skripten |
| E-Learning / Unternehmensschulung | Transkriptbearbeitung + Segmentsteuerung + geklonte Stimmen | Kurse bleiben konsistent und lassen sich im Laufe der Zeit leicht aktualisieren |
| Entwickler oder Agentur | AI Dubbing- + Voice Cloning-APIs | Vorsignierte Uploads und individuelle Stimmen werden zu Backend-Diensten, die Sie orchestrieren |
Wenn Sie einen vollständigen mehrsprachigen Kanal statt einzelner Videos planen, führt Sie unser Leitfaden zum Aufbau eines mehrsprachigen YouTube-Kanals von Anfang bis Ende durch die Strategie, und „So ändern Sie die Sprachsprache in einem Video" deckt den praktischen Einzelvideo-Weg ab. Ein nützliches Muster für US-basierte Creator: Beginnen Sie mit einem einsprachigen Kanal oder Katalog und fügen Sie dann mehrsprachige Stimmspuren hinzu, während Sie die Nachfrage validieren, statt sich im Voraus auf eine vollständige menschlich synchronisierte Produktion festzulegen.
Häufig gestellte Fragen
Was ist KI-Synchronisation und wie unterscheidet sie sich von Untertiteln?
Die KI-Synchronisation transkribiert, übersetzt und vertont Ihr Audio oder Video in andere Sprachen neu, während das ursprüngliche Timing, der Ton und die Absicht erhalten bleiben. Untertitel legen Text über den Bildschirm; die Synchronisation ersetzt oder fügt eine Audiospur hinzu, sodass Zuschauer in ihrer eigenen Sprache zuhören können.
Mit wie vielen Sprachen kann DubSmart arbeiten?
Unser Workflow verwandelt gesprochene Inhalte aus mehr als 60 Ausgangssprachen in synchronisierte Versionen in 33 Zielsprachen und kombiniert dabei Text-to-Speech und Voice Cloning in einer einzigen Plattform.
Auf welche Arten von Creatorn konzentriert sich DubSmart?
Wir sind für globale Content-Creator, Agenturen und Unternehmen konzipiert, mit KI-Synchronisation, Voice Cloning, Text-to-Speech und Speech-to-Text, die auf Videoersteller in Medien, Marketing, E-Learning und Training ausgerichtet sind.
Kann ich die Synchronisation über einen großen Videokatalog hinweg automatisieren?
Ja. Unsere AI Dubbing API und Voice Cloning API ermöglichen es Ihnen, Dateien über vorsignierte URLs hochzuladen, individuelle Stimmen zu erstellen und Synchronisation programmatisch auszuführen, sodass die Lokalisierung eines großen Katalogs innerhalb Ihrer eigenen Anwendungen oder Content-Pipelines praktikabel ist.
Benötige ich weiterhin eine menschliche Überprüfung, wenn ich KI-Synchronisation nutze?
Für professionelle oder anspruchsvolle Inhalte überprüfen Sie das Transkript, die Übersetzung und das finale Audio auf Genauigkeit und Nuancen. Unser Workflow erleichtert diese Prüfungen, indem er jede Phase – Transkript, Übersetzung, Voiceover und Timing – in einem integrierten Studio zugänglich macht.