Aus einem Podcast eine mehrsprachige Show zu machen, klingt nach einem studiogroßen Projekt, aber mit dem richtigen Workflow braucht es pro Folge weniger als eine Stunde aktiver Arbeit, sobald man die Schritte kennt. Falls Sie sich gefragt haben, wie man einen Podcast in eine andere Sprache übersetzt, ohne jede Folge neu aufzunehmen, lautet die praktische Antwort: eine einzige Lokalisierungspipeline, die Ihr Audio transkribiert, übersetzt, neu vertont und synchronisiert. Die Kosten für KI-Synchronisation liegen in der Regel irgendwo zwischen etwa 0,20 und 7 US-Dollar pro fertiger Minute, abhängig davon, wie viele Minuten und Sprachen Sie liefern und wie viel manuelle Qualitätskontrolle Sie einbauen.
Wir haben DubSmart AI genau um diese sprachorientierte Arbeit herum entwickelt: Es nimmt gesprochene Inhalte aus mehr als 60 Ausgangssprachen und erstellt synchronisierte Versionen in 33 Zielsprachen, indem es Speech-to-Text, Übersetzung, Text-to-Speech und Voice Cloning an einem Ort vereint. Dieser Leitfaden führt Sie durch die gesamte Abfolge, weist auf die Fehler hin, die synchronisierte Folgen unbemerkt ruinieren, und zeigt Ihnen, wo ein muttersprachlicher Prüfer seinen Wert beweist.
Inhaltsverzeichnis
Was Sie brauchen, bevor Sie beginnen
Ein reibungsloser Lokalisierungslauf hängt weniger von den Werkzeugen ab als davon, womit Sie sie füttern. Bringen Sie diese fünf Dinge vor Ihrem ersten Projekt in Ordnung, und jeder spätere Schritt wird schneller.
- Saubere Ausgangsdateien. Exportieren Sie jede Folge als einzelne WAV- oder MP3-Datei mit hoher Bitrate, mit minimalem Hintergrundrauschen, ohne Übersteuerung und mit normalisierter Lautstärke. Sauberes Ausgangsmaterial verbessert direkt die Transkriptionsgenauigkeit und reduziert Artefakte während der Synchronisation, besonders wenn eine Sprachtrennung im Spiel ist.
- Die Rechte, das Audio zu bearbeiten. Stellen Sie sicher, dass Sie gesprochene Inhalte, Gastbeiträge und jegliche Musik in jedem Markt, in dem Sie veröffentlichen möchten, übersetzen und weiterverbreiten dürfen.
- Eine Zielsprachenstrategie. Entscheiden Sie, welche Sprachen Sie priorisieren und ob jede einen vollständig synchronisierten Feed oder nur ausgewählte Highlight-Folgen erhält. Jede zusätzliche Sprache vervielfacht Ihre Minuten und Ihre Kosten, planen Sie also gezielt, anstatt alles auf einmal zu synchronisieren.
- Stimmrichtlinien. Entscheiden Sie, ob die Stimme des Hosts in der neuen Sprache geklont oder durch eine Bibliotheksstimme ersetzt werden soll, und bereiten Sie Aussprachehinweise für Produktnamen, Personen und Fachjargon vor.
- Ein aufgeladenes Konto. Unsere Plattform arbeitet mit einem kreditbasierten Modell, das AI Dubbing, Speech to Text, den Speech Separator und Text to Speech abdeckt. Prüfen Sie Ihr Guthaben, damit Sie vollständige Folgen verarbeiten können, anstatt auf halbem Weg abzubrechen.
Wenn Sie ein Gedankenmodell dafür möchten, wie Transkription, Übersetzung und Neuvertonung zusammenpassen, bevor Sie ein Projekt anfassen, deckt unsere Erklärung dazu, wie KI-Lokalisierung funktioniert, die Pipeline von Anfang bis Ende ab.
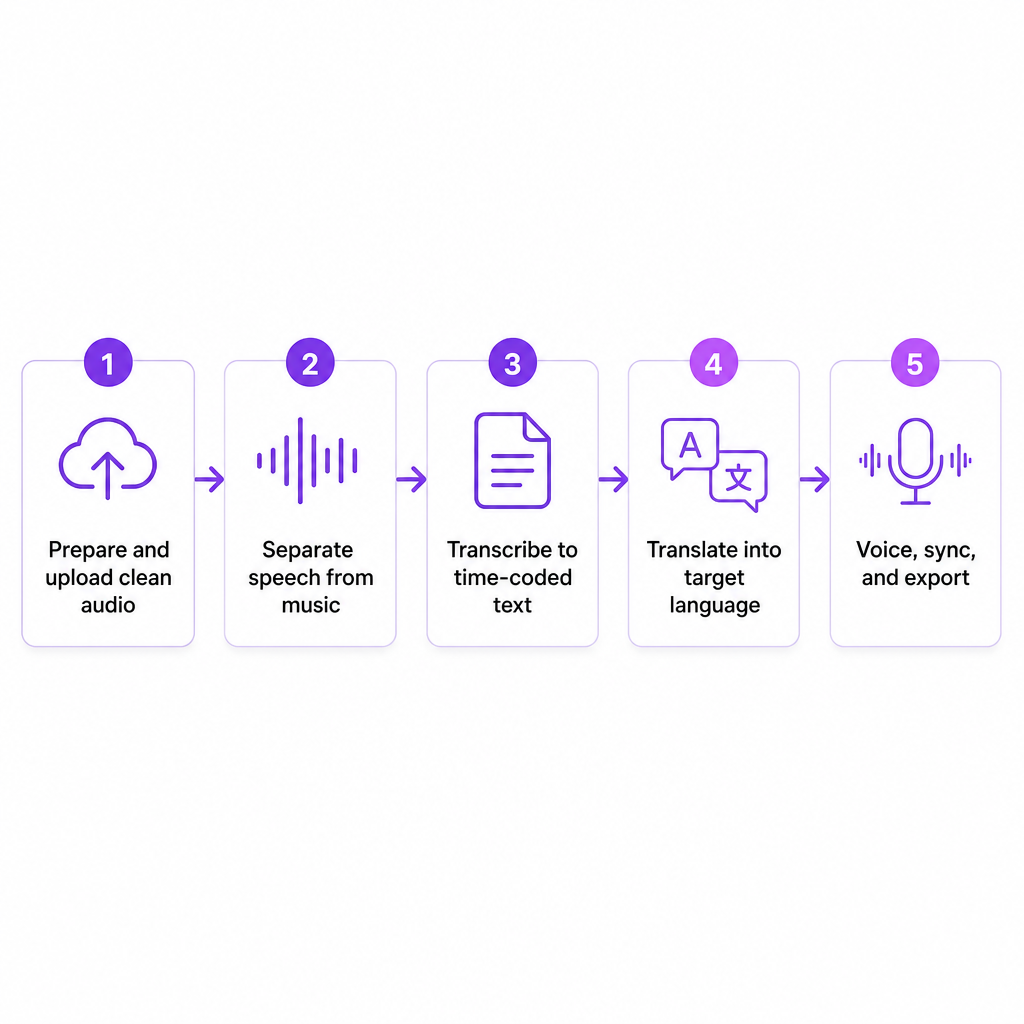
Der Schritt-für-Schritt-Synchronisations-Workflow
Dies ist die praktische Abfolge, die wir verwenden, um eine Folge von Rohaudio zu einer fertigen, synchronisierten Version zu bringen. Jeder Schritt speist den nächsten, widerstehen Sie also dem Drang, vorauszuspringen.
Schritt 1: Wählen Sie Ihr Lokalisierungsformat
Entscheiden Sie, was Sie tatsächlich ausliefern. Es gibt drei sinnvolle Optionen: vollständig synchronisierte Folgen mit neuen Audiospuren, nur übersetzte Transkripte und Untertitel, oder sowohl synchronisiertes Audio als auch übersetzten Text. Für YouTube und Video-Podcasts bietet die Auslieferung von beidem Hörern und Zuschauern eine Version, die zu ihrer Konsumweise passt. Unser AI-Dubbing-Tool übernimmt den vollständig vertonten Weg, während Speech to Text Ihnen bearbeitbare Transkripte und Untertitel liefert.
Schritt 2: Folge vorbereiten und hochladen
Exportieren Sie den finalen Mix als einzelne Datei und erstellen Sie dann vom Dashboard aus ein neues AI-Dubbing-Projekt. Laden Sie das Audio direkt hoch, oder falls die Folge bereits auf YouTube liegt, fügen Sie den Link ein und lassen Sie das System sie abrufen. Fügen Sie den Folgentitel, die Originalsprache und alle Notizen zu Sprechern oder Segmenten hinzu. Die korrekte Identifizierung der Ausgangssprache ist wichtiger, als es scheint, denn sie hilft dem System, sowohl die Transkriptions- als auch die Übersetzungsgenauigkeit zu optimieren.
Schritt 3: Sprache vom Hintergrund-Audio trennen
Podcasts sind selten reine Stimme. Intro-Musik, Klangbetten und Umgebungsgeräusche vermischen sich alle im Mix, und darüber zu synchronisieren erzeugt ein matschiges Ergebnis. Unser Speech Separator isoliert den Dialog von Musik und Effekten, sodass die neue Sprachspur sauber obendrauf sitzt. Aktivieren Sie den Trennungsschritt, falls er nicht bereits aktiv ist, und spielen Sie dann die isolierte Sprache ab, um zu bestätigen, dass die Stimmen klar sind. Wenn der Original-Mix extrem verrauscht ist, remastern Sie ihn leicht und laden Sie ihn neu hoch, bevor Sie fortfahren.
Schritt 4: Transkribieren mit Speech to Text
Eine genaue Transkription ist das Rückgrat des gesamten Prozesses. Unser Speech-to-Text-Tool wandelt gesprochene Inhalte in zeitcodierten Text um, der an der Originalzeitleiste ausgerichtet ist und den Sie im Projekteditor ansehen und bearbeiten können. Erledigen Sie hier drei Dinge: Weisen Sie dem Host, den Co-Hosts und den Gästen Sprecheretiketten zu; korrigieren Sie missverstandene Wörter, Markennamen und Fachbegriffe; und schneiden Sie Füllwörter heraus, die in der Übersetzung nichts beitragen. Dies ist auch der Moment, um Inhalte anzupassen, die für bestimmte Märkte ungeeignet sein könnten. Saubere Transkripte hier verhindern sich häufende Fehler später.
Schritt 5: In Ihre Zielsprache übersetzen
Mit einem sauberen Transkript übersetzt die Pipeline das zeitcodierte Skript und hält dabei Kontext, Timing und Absicht mit dem Originalaudio abgestimmt. Wählen Sie Ihre Zielsprachen aus und überprüfen Sie dann die maschinelle Übersetzung auf Ton, Redewendungen und kulturspezifische Anspielungen. Witze und Metaphern überstehen selten einen wörtlichen Durchlauf, also passen Sie sie hier an. Wenn eine Sprache regionale Varianten hat, entscheiden Sie von vornherein, ob Sie beispielsweise lateinamerikanisches oder europäisches Spanisch anvisieren, und halten Sie diese Wahl über jede Folge hinweg konsistent.
Schritt 6: Stimmen auswählen und lokalisierte Sprache generieren
Unsere Text-to-Speech-Engine verwandelt das übersetzte Skript in lebensechtes Audio aus einer Bibliothek von über 300 Stimmen in verschiedenen Geschlechtern, Stilen und Sprachen, und Voice Cloning kann die stimmliche Identität des Original-Hosts in der neuen Sprache nachbilden. Wählen Sie für jeden etikettierten Sprecher eine Stimme, die zu seinem Alter, Geschlecht, seiner Energie und Markenpersönlichkeit passt. Bei Solo-Shows sorgt das Klonen des Hosts dafür, dass die synchronisierte Folge für bestehende Hörer vertraut bleibt. Generieren Sie das Audio innerhalb der Synchronisations-Pipeline; das System synchronisiert die neue Sprache mit der Originalzeitleiste und bewahrt dabei das Tempo und die Segmentgrenzen. Hören Sie dann durch, generieren Sie holprige Zeilen neu und tauschen Sie Stimmen aus, die nicht zur Marke passen.
Schritt 7: Finale Qualitätskontrolle durchführen und exportieren
Machen Sie vor der Veröffentlichung einen vollständigen Durchgang. Überprüfen Sie, ob Kernbotschaften, Handlungsaufforderungen, Haftungsausschlüsse, gesprochene URLs und Social-Media-Handles korrekt und gut ausgesprochen sind. Stellen Sie sicher, dass die Lautstärke konsistent ist, die Musik die Sprache nicht übertönt und die Trennung kein Echo oder Artefakte hinterlassen hat. Exportieren Sie im Format und der Bitrate, die Ihr Host verlangt. Wenn Sie Video-Folgen produzieren und lokalisierten Bildschirmtext oder Grafiken benötigen, hilft unser Image-to-Video-Tool beim Aktualisieren der Visuals. Veröffentlichen Sie schließlich jede Sprache als eigenen Feed oder eigene Playlist und kennzeichnen Sie die Sprache klar in Titeln und Beschreibungen, damit Hörer die richtige Version abonnieren.
Häufige Fehler und wie man sie behebt
Die meisten Synchronisationsprobleme sind nicht exotisch. Sie häufen sich um eine Handvoll vorhersehbarer Schwachstellen, und jede hat ein einfaches Gegenmittel.
- Schlechtes Ausgangsaudio. Verrauschte, überkomprimierte oder übersteuerte Aufnahmen erzeugen schwache Transkripte und holpriges synchronisiertes Audio. Reinigen und normalisieren Sie den Original-Mix, nutzen Sie die Sprachtrennung und wenden Sie vor dem Upload eine leichte Rauschunterdrückung in Ihrem Editor an.
- Überspringen der Transkript-Bereinigung. Der automatischen Transkription pauschal zu vertrauen, führt zu Fehlern bei Namen, Akronymen und Fachjargon, die dann falsch übersetzt werden. Bearbeiten Sie das Transkript immer vor der Übersetzung, besonders bei Nischen- oder Markenbegriffen.
- Kulturellen Kontext ignorieren. Wörtliche Übersetzungen von Witzen und Redewendungen können seltsam klingen oder schlecht ankommen. Passen Sie kulturspezifische Anspielungen während der Überprüfung an oder ersetzen Sie sie und erklären Sie sie bei Bedarf, anstatt Wort für Wort zu übersetzen.
- Inkonsistente Sprecher-Vertonung. Zufällig zugewiesene Stimmen lassen Gäste und Co-Hosts ineinander verschwimmen. Verwenden Sie Sprecheretiketten, feste Stimmzuweisungen und gegebenenfalls Klonen, um eine kohärente Besetzung über die Folgen hinweg beizubehalten.
- Qualitätskontrolle unterschätzen. Ohne einen vollständigen Durchhören zu veröffentlichen, hinterlässt Timing-Fehler und Fehlaussprachen in Ihrem Feed. Führen Sie in jeder Sprache einen vollständigen Audio-QA-Durchgang durch und holen Sie für kritische Folgen einen Muttersprachler hinzu.
- Rechte übersehen. Die Weiterverbreitung übersetzten Audios ohne Klärung von gesprochenen Inhalten, Gastbeiträgen und Musik kann Urheberrechtsprobleme verursachen. Klären Sie die Rechte für jeden Markt, bevor Sie veröffentlichen.
Selbermachen versus muttersprachliche Prüfung: wo die Grenze zu ziehen ist
Unser KI-orientierter Workflow ist so aufgebaut, dass die meisten Podcaster Folgen selbst übersetzen und synchronisieren können, ohne ein Studioteam anzuheuern. Für Unterhaltungs-, Kommentar- und Shows mit allgemeinem Interesse sowie für Bildungsfolgen, bei denen kleinere Unvollkommenheiten akzeptabel sind, kann ein alleinarbeitender Creator, der die obigen sieben Schritte durchläuft, ausgefeilte mehrsprachige Folgen ganz allein veröffentlichen. Von Creatorn geführte Shows auf YouTube, Spotify und Apple Podcasts, bei denen Reichweite und Geschwindigkeit mehr zählen als Perfektion auf Broadcast-Niveau, eignen sich natürlich für den vollständig selbstbedienten Weg.
Die Rechnung ändert sich, wenn Präzision echte Konsequenzen hat. Ziehen Sie eine professionelle oder muttersprachliche Prüfung hinzu, wenn Folgen rechtliche, medizinische, finanzielle oder regulatorische Themen behandeln, bei denen die Formulierung exakt sein muss; wenn Ihre Marke in streng regulierten Branchen oder Regionen mit strengen Werbevorschriften tätig ist; oder wenn Sie Flaggschiff-Inhalte wie Produktankündigungen, große Kampagnen oder Unternehmensschulungen lokalisieren, bei denen Ton und Nuance entscheidend sind. Auch dann behalten Sie die Effizienz: Nutzen Sie die Plattform für Transkription, Übersetzungsentwurf, Stimmgenerierung und Timing, und lassen Sie dann einen Prüfer die Formulierung verfeinern und die finale QA durchführen, bevor Sie veröffentlichen.
Häufig gestellte Fragen
Wie lange dauert es, eine 60-minütige Folge zu übersetzen und zu synchronisieren?
Sobald Sie mit den Tools vertraut sind, rechnen Sie mit weniger als einer Stunde aktiver Arbeit pro Folge, plus automatisierter Verarbeitungszeit für Transkription, Übersetzung und Stimmgenerierung.
Was kostet es, einen Podcast mit KI-Synchronisation zu übersetzen?
Praktische KI-Synchronisationspreise liegen in der Regel zwischen etwa 0,20 und 7 US-Dollar pro fertiger Minute, abhängig davon, wie viele Minuten Sie verarbeiten, wie viele Sprachen Sie liefern und wie viel Qualitätskontrolle Sie hinzufügen. Unsere Plattform verwendet Credits, sodass Ihre effektiven Kosten pro Minute von Ihrem Tarif und Ihrer Nutzung abhängen. Unsere Aufschlüsselung der KI-Synchronisationskosten pro Minute erklärt die Kostentreiber.
Kann ich die Stimme meines Original-Hosts in der neuen Sprache beibehalten?
Ja. Text to Speech und Voice Cloning arbeiten zusammen, sodass Sie die stimmliche Identität des Hosts bewahren können, während Sie Folgen in anderen Sprachen neu vertonen.
Kann ich nur einen Teil einer Folge übersetzen?
Sie können eine ganze Folge oder nur ausgewählte Segmente wie Intro und Outro synchronisieren. Die Verwaltung im Projekteditor ermöglicht es Ihnen, sich auf die Abschnitte zu konzentrieren, die für mehrsprachiges Branding am wichtigsten sind.
Brauche ich einen separaten Feed für jede Sprache?
Es ist bewährte Praxis, eigene Sprach-Feeds oder -Playlists zu pflegen, damit Hörer die von ihnen bevorzugte Version über Podcast-Apps und YouTube abonnieren können.