Bei der Auswahl der besten Text-to-Speech-Stimmen für YouTube geht es weniger darum, einer einzigen „perfekten" Stimme hinterherzujagen, als vielmehr darum, das richtige Stimmen-Setup auf die Nische Ihres Kanals, Ihre Sprachpläne und die Art und Weise abzustimmen, wie Sie Ihre Videos tatsächlich produzieren. Bei DubSmart AI kommt es bei dieser Wahl auf vier praktische Optionen innerhalb eines Arbeitsbereichs an: unsere Bibliothek mit über 300 fertigen KI-Stimmen, eine Stimme, die Sie aus Ihrem eigenen Audiomaterial klonen, dieselben Stimmen angewendet auf mehrsprachige Synchronisation und API-gesteuerte Stimmen für automatisierte Pipelines. Jede löst ein anderes Problem, und die beste Wahl kombiniert in der Regel ein paar davon, während Ihr Kanal wächst.
Dieser Leitfaden erläutert, was jedes Stimmen-Setup gut kann, wo es passt und wo es an seine Grenzen stößt, damit Sie sich mit Zuversicht entscheiden können, anstatt anhand eines generischen Rankings zu raten.
Inhaltsverzeichnis
Wie wir die besten Text-to-Speech-Stimmen für YouTube auswählen
Wir wählen Stimmen und Stimmen-Setups aus, die auf einem echten YouTube-Kanal bestehen, nicht nach abstrakten Marktrankings. Fünf Kriterien prägen jede Auswahl unten.
Natürlichkeit steht an erster Stelle, denn die meiste Wiedergabezeit findet auf Smartphones bei wechselnder Lautstärke statt. Eine Stimme muss menschlich klingen und auch durch komprimiertes Audio und Hintergrundgeräusche im Berufsverkehr klar bleiben. Als Nächstes kommt die Abdeckung von Sprachen und Akzenten: Eine Stimme ist für Wachstum nur dann nützlich, wenn Sie sie in neue Regionen übertragen können, ohne Ihren Backkatalog neu aufzunehmen. Markenkonsistenz ist der dritte Filter, denn dieselbe Stimme sollte sowohl in unserem Text-to-Speech-Studio als auch bei der Synchronisation wiederverwendbar sein, einschließlich einer geklonten Stimme, die wie Sie klingt. Die Workflow-Eignung entscheidet darüber, ob eine Stimme praktisch zu generieren, zu bearbeiten und in einem echten Produktionsplan zu exportieren ist. Schließlich bestimmt das Automatisierungspotenzial, ob Entwickler und Agenturen dieselben Stimmen über APIs für vorlagenbasierte oder umfangreiche Ausgaben aufrufen können.
Jeder Punkt unten erhält einen Abschnitt mit seiner Besonderheit, seiner besten Eignung auf YouTube und seinen ehrlichen Einschränkungen, abgeleitet davon, wie diese Tools tatsächlich innerhalb unserer Plattform funktionieren.
Standard-KI-Stimmenbibliothek: schnelle, veröffentlichungsfertige Erzählung
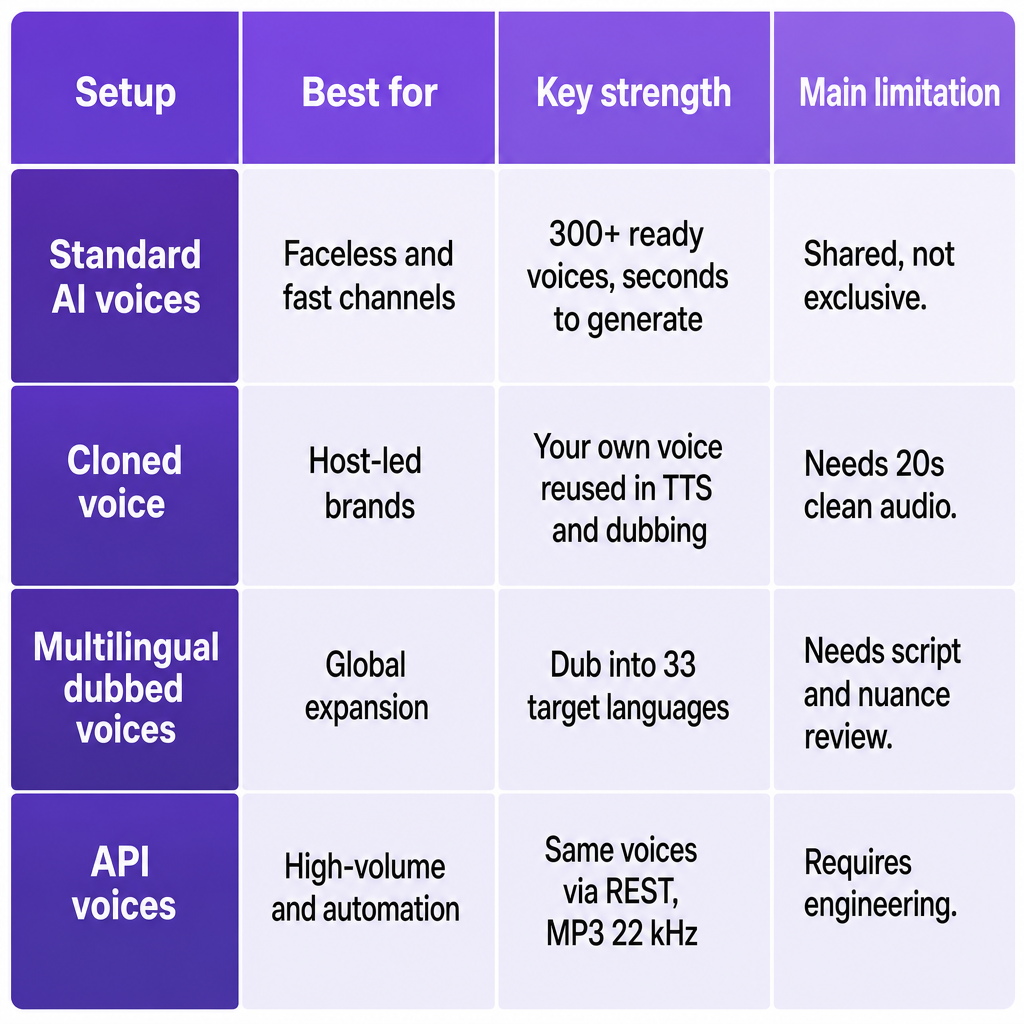
Der schnellste Weg zu einem fertigen Voiceover ist unsere Text-to-Speech-Engine: Fügen Sie ein Skript in Ihrer Sprache ein, wählen Sie aus mehr als 300 KI-Stimmen, hören Sie eine Vorschau und erzeugen Sie innerhalb von Sekunden realistische Sprache. Sie können einen Sprecher auswählen, grundlegende Einstellungen anpassen und Standard-Audio exportieren, das Sie direkt in einen YouTube-Schnitt einfügen. Derselbe Katalog ist über unsere TTS-API verfügbar, sodass jede fertige Stimme sowohl im Web-Studio als auch in programmatischen Workflows existiert.
Dieses Setup eignet sich für gesichtslose und Kommentar-Kanäle, die Geschwindigkeit und Konsistenz über eine einzelne wiedererkennbare Persönlichkeit stellen. Es passt zu Nachrichtenanalysen, Listicles, Erklärvideos und Slideshows, die bei engem Zeitplan eine saubere Erzählung benötigen, sowie zu E-Learning-, Unternehmens- und Marketing-Kanälen, die einen neutralen professionellen Ton bevorzugen. Ein Creator kann ein Skript einfügen, eine Stimme auswählen, generieren und für einen Editor wie Premiere oder Final Cut herunterladen, ohne Aufnahmegeräte anzufassen. Für technische Teams gibt unsere Text-to-Speech-API MP3-Dateien mit 22 kHz nach einer einfachen Anfrage mit Text und Stimmpräferenzen zurück, was sich nahtlos in vorlagen- oder datengesteuerte Video-Pipelines einfügt. Wenn Sie tiefer in die Mechanik einsteigen möchten, behandelt unser Erklärtext, wie neuronales Text-to-Speech funktioniert, was hinter jedem Rendering passiert.
Der Kompromiss ist Exklusivität. Standardstimmen werden unter den Nutzern geteilt, sodass ein stark gebrandeter, persönlichkeitsgetriebener Kanal letztlich etwas Markanteres wünschen könnte. Sie können Sprache, Sprecher und einige Parameter anpassen, aber ohne Klonen erhalten Sie nicht die subtilen Eigenheiten Ihrer eigenen Stimme. Und da der Katalog umfangreich ist, erfordert das Finden der Stimme, die wirklich zu Ihrem Publikum passt, immer noch ein paar Hörtests statt einer glücklichen Wahl.
Geklonte Creator-Stimme: ein wiedererkennbarer Host in großem Maßstab
Wenn Ihr Klang Teil Ihrer Marke ist, verändert das Klonen die Rechnung. Unser Voice Cloning erstellt eine individuelle KI-Stimme aus einer kurzen Probe und macht diese Stimme überall dort auswählbar, wo Standardstimmen erscheinen, sowohl in Text-to-Speech als auch in der Synchronisation. Sie laden mindestens 20 Sekunden sauberes Audio ohne Hintergrundgeräusche hoch, und das System erzeugt einen wiederverwendbaren Klon. Wir unterstützen das Klonen beliebig vieler Stimmen, sodass eine Marke nicht an einen Host gebunden ist: Sie können nach Bedarf mehrere Sprecher oder Charakterstimmen klonen.
Eine geklonte Stimme ist die stärkste Wahl für persönlichkeitsgetriebene Kanäle, bei denen Zuschauer wegen einer bestimmten Person abonnieren. Sie passt auch zu Creatorn, die ihre eigene Stimme behalten und dabei Teile der Produktion automatisieren möchten, etwa B-Roll-Erzählung, alternative Sprachtracks oder gescriptete Shorts. Und sie ist das Rückgrat mehrsprachiger Kanäle, die in Kombination mit Synchronisation eine konsistente Sprecheridentität über Sprachen hinweg beibehalten möchten. Einmal geklont, wird Ihre Stimme zu einer normalen Option im Studio, bereit für gescriptete Erzählung oder für das Neuvertonen ganzer Videos in andere Sprachen unter Beibehaltung Ihrer Identität.
Die Qualität hängt von Ihrem Quellaudio ab. Eine verrauschte oder hallende Probe erzeugt einen schwächeren Klon und kann Artefakte einführen, weshalb viele Creator eine eigene saubere Probe aufnehmen, statt Livestream- oder Vlog-Audio wiederzuverwenden. Über Sprachen hinweg folgen Akzent und Prosodie dem Synthesemodell, sodass die Aussprache in jeder Zielsprache möglicherweise nicht perfekt der eines Muttersprachlers entspricht. Das Klonen fügt außerdem vor der ersten Verwendung einen Einrichtungsschritt hinzu, was es am besten für Kanäle macht, die sich langfristiger Konsistenz verschrieben haben, statt für einen einmaligen Test.
Mehrsprachige synchronisierte Stimmen: aus einem Kanal viele machen
Der direkteste Weg zu einem globalen Kanal ist die Synchronisation. Mit unserem AI Dubbing laden Sie ein Video hoch, übersetzen und vertonen es neu in eine von 33 Zielsprachen und wenden optional eine geklonte Stimme auf diese synchronisierten Tracks an. Das entscheidende Detail ist, dass die Synchronisation auf denselben Stimmkatalog und dieselben geklonten Stimmen zurückgreift, die für Text-to-Speech verwendet werden, sodass Ihre „besten" Synchronisationsstimmen einfach Ihre gewählten Stimmen sind, konfiguriert für übersetzte Skripte. Da der Arbeitsbereich außerdem Speech to Text, einen Speech Separator sowie Bild- und Videotools bündelt, vermeiden Sie es, separate Anbieter für Transkription, Übersetzung, Voiceover und Bildmaterial zusammenzuflicken.
Dies passt zu Kanälen, die bereits in einer Sprache erfolgreich sind und bereit sind, ohne Neudreh zu expandieren. Tutorials, Produktbewertungen, Dokumentationen und Langform-Inhalte mit hohem Wiederholungswert rechtfertigen den Aufwand, ebenso wie Unternehmen, E-Learning-Anbieter und Marketing-Teams, die eine konsistente Marken-Erzählung über Regionen hinweg benötigen. Sie können von bestehenden Videos ausgehen, übersetzte Skripte generieren und entweder eine Standardstimme oder Ihre geklonte Stimme auf das synchronisierte Audio anwenden, wodurch lokale Versionen Ihres Kanals entstehen, die dieselbe Persönlichkeit behalten. Text-to-Speech und Synchronisation in einem Arbeitsbereich zu halten, macht es einfach, den Erzählstil zwischen Original- und übersetzten Versionen anzugleichen. Wenn Sie Lokalisierungsformate abwägen, hilft unsere Aufschlüsselung von Synchronisation versus Untertitel dabei, die Entscheidung einzuordnen.
Synchronisation bringt Arbeit mit sich, die einsprachige Erzählung nicht hat. Selbst bei starker Übersetzung und Synthese müssen Sie Skripte weiterhin auf kulturelle Feinheiten prüfen, Beispiele anpassen und bestätigen, dass der Stimmstil zum Zielpublikum passt. Sie verbraucht außerdem mehr Credits und mehr Exportverwaltung als ein einmaliger Clip. Geklonte Stimmen bewahren die Identität, aber Lippensynchronität und Timing passen bei schnell sprechenden oder stark animierten Inhalten möglicherweise nicht perfekt zu den Originalbildern, sodass Sie mit einigen manuellen Bearbeitungen in Ihrem Videoeditor rechnen sollten.
API-gesteuerte Stimmen: automatisierte Produktion in großem Umfang
Für Teams, die in großem Umfang produzieren, sind dieselben Stimmen programmatisch über drei Endpunkte verfügbar. Unsere Text-to-Speech-API wandelt Text mithilfe des vollständigen Satzes von über 300 Stimmen in natürliche Sprache um und gibt nach Abschluss der Verarbeitung herunterladbare MP3-Dateien mit 22 kHz zurück. Mit unserer Voice-Cloning-API können Sie Proben hochladen und individuelle Stimmen erstellen, die in TTS oder Synchronisation verwendbar sind. Mit unserer AI-Dubbing-API können Entwickler und Agenturen Videos programmatisch übersetzen und synchronisieren und diese Funktionen direkt in Content-Pipelines oder ein CMS einbetten.
Dieses Setup passt zu Kanälen, die viele ähnliche Videos erzeugen, etwa wiederkehrende Nachrichtenzusammenfassungen, datengesteuerte Zusammenfassungen oder vorlagenbasierte Erklärvideos, bei denen Skripte generiert oder aus strukturierten Daten gefüllt werden. Es eignet sich für Agenturen, die mehrere Kundenkanäle verwalten und einen wiederholbaren, automatisierten Stimm-Workflow benötigen, sowie für Softwareprodukte, die Auto-Publish-Funktionen anbieten und qualitativ hochwertige Voiceover in großem Umfang brauchen. Da geklonte Stimmen neben Standardstimmen per ID referenziert werden können, kostet Sie die Automatisierung keine Markenkonsistenz: Jedes Rendering verwendet dieselbe beabsichtigte Stimme über Videos und Kanäle hinweg.
Der Preis ist Entwicklungsaufwand. API-Workflows erfordern Vertrautheit mit RESTful-Diensten sowie Infrastruktur, um Audio zu speichern, nachzubearbeiten und an Video-Assets anzuhängen. Kleinere Creator, die vollständig im Web-Editor arbeiten, profitieren in der Regel erst, wenn sie eine nennenswerte Größe erreichen. Automatisierte Pipelines benötigen außerdem Schutzmaßnahmen rund um Skriptqualität, Timing und Compliance, denn schwache Eingaben erzeugen weiterhin schwache Ausgaben, egal wie gut die Stimme ist.
So wählen Sie das richtige Stimmen-Setup für Ihren Kanal
Vier Fragen klären die meisten Entscheidungen. Beantworten Sie sie der Reihe nach, und Ihr Stimmen-Stack fügt sich zusammen.
Publikum und Format. Wenn Ihr Kanal gesichtslos, nachrichtenlastig oder Listicle-getrieben ist, beginnen Sie mit Standard-KI-Stimmen für schnelle Durchlaufzeiten und einfache Tontests. Wenn Zuschauer speziell wegen Ihnen abonnieren, investieren Sie in das Klonen Ihrer Stimme und deren Verwendung sowohl in Text-to-Speech als auch bei der Synchronisation.
Sprachstrategie. Wenn Sie in einer Sprache veröffentlichen, finden Sie ein oder zwei Stimmen, die zu Ihrem Ton passen, und bleiben Sie der Konsistenz wegen dabei. Wenn Sie global expandieren möchten, gestalten Sie rund um die Synchronisation: Wählen Sie eine primäre geklonte Stimme und ordnen Sie sie synchronisierten Tracks in bis zu 33 Zielsprachen zu.
Produktionsvolumen. Für wöchentliche Uploads oder gelegentliche Serien reichen die webbasierten Text-to-Speech- und AI-Dubbing-Tools aus. Für umfangreiche oder datengesteuerte Inhalte planen Sie einen API-first-Workflow, bei dem neue Skripte und Assets automatisch die Stimmerzeugung auslösen.
Markenkontrolle und Risiko. Verwenden Sie Standardstimmen für risikoarme Piloten und Kanäle, bei denen die Stimmidentität nicht zentral ist. Verwenden Sie geklonte Stimmen mit klaren internen Regeln darüber, wer sie auslösen darf und wo sie erscheinen dürfen, was für Unternehmens- oder Marken-Kanäle am wichtigsten ist.
Ihre Stimmen auf Publikumserwartungen, Sprachpläne und Workflow abzustimmen, ist der Weg, die häufigen Fehler zu vermeiden: inkonsistente Erzählung, überraschende Stimmwechsel zwischen Videos und überkonstruierte Pipelines, die schwer zu warten sind. Ein praktischer Weg ist, zuerst ein paar Standardstimmen zu testen, eine geklonte Stimme hinzuzufügen, sobald Ihre Identität wichtig wird, und APIs sowie mehrsprachige Synchronisation einzuführen, wenn Ihr Betrieb über manuelles Rendering hinauswächst.
Häufig gestellte Fragen
Kann ich DubSmarts KI-Stimmen in meinen YouTube-Videos verwenden?
Unsere Text-to-Speech- und AI-Dubbing-Tools sind dafür gebaut, dass Creator und Unternehmen Voiceover für öffentliche Inhalte, einschließlich YouTube, unter einem kreditbasierten Nutzungsmodell erstellen. Sie bleiben dafür verantwortlich, die Nutzungsbedingungen von YouTube, Werberichtlinien und lokale Vorschriften einzuhalten, aber unsere Plattform ist für die kommerzielle Mediennutzung konzipiert.
Wie viel Audio benötige ich, um meine Stimme zu klonen?
Sie benötigen mindestens 20 Sekunden saubere Sprache ohne Hintergrundgeräusche, um eine brauchbare geklonte Stimme zu erstellen. Je sauberer die Aufnahme, desto genauer und natürlicher das Ergebnis, sodass eine eigene, ruhige Probe verrauschtes, zweckentfremdetes Audio schlägt.
Funktioniert meine geklonte Stimme in mehreren Sprachen?
Ja. Eine geklonte Stimme ist sowohl in Text-to-Speech als auch in AI Dubbing nutzbar, die viele Sprachen und 33 Zielsprachen für die Synchronisation unterstützen. Sie behalten dieselbe Stimmidentität über Skripte in verschiedenen Sprachen hinweg, wobei Aussprache und Akzent jedoch dem Synthesemodell folgen und nicht in jedem Fall der natürlichen menschlichen Sprache entsprechen.
Kann ich später von Standardstimmen zu einer geklonten Stimme wechseln?
Ja. Wir behandeln geklonte Stimmen als wiederverwendbare Stimmen im selben Katalog wie Standard-KI-Stimmen, sodass Sie mit Standardstimmen beginnen und später Projekte mit denselben Text-to-Speech- und AI-Dubbing-Schnittstellen oder APIs auf eine geklonte Stimme umstellen können, ohne Ihren Workflow neu aufzubauen.
Wie helfen die APIs bei der YouTube-Produktion?
Mit unseren Text-to-Speech-, Voice-Cloning- und AI-Dubbing-APIs können Sie Skripte in Sprache umwandeln, Stimmen klonen und Videos über RESTful-Endpunkte synchronisieren. Das macht es praktikabel, wiederkehrende Formate zu automatisieren, Voiceover in ein bestehendes CMS oder eine Schnitt-Pipeline einzubinden und über viele Kanäle oder Sprachen hinweg zu skalieren, ohne jedes Rendering manuell auszulösen.