คุณสามารถแปลงข้อความเป็นเสียงพูดออนไลน์ได้ในเวลาเท่าที่ใช้วางสคริปต์ เลือกเสียง และคลิกสร้าง ไม่ต้องใช้ไมโครโฟน ไม่ต้องใช้ห้องอัด ไม่ต้องใช้ชุดตัดต่อ—เพียงแค่เครื่องมือบนเบราว์เซอร์ที่เปลี่ยนคำที่เขียนไว้ให้เป็นเสียงบรรยายที่ฟังดูเป็นธรรมชาติ ซึ่งคุณสามารถดาวน์โหลดและนำไปใส่ในวิดีโอ คอร์ส พอดแคสต์ หรือโฆษณาได้ งานที่แท้จริงไม่ได้อยู่ที่การคลิก แต่อยู่ที่ตัวเลือกไม่กี่อย่างที่ตัดสินว่าเสียงจะฟังดูเหมือนคนหรือเหมือนตู้คีออสก์
คู่มือนี้จะพาผ่านการตัดสินใจนั้นอย่างรวดเร็ว ได้แก่ สิ่งที่เกิดขึ้นเมื่อคุณแปลงข้อความเป็นเสียงพูดออนไลน์ วิธีได้ไฟล์ที่ใช้งานได้อย่างรวดเร็ว วิธีเลือกเสียงที่เหมาะสม และข้อจำกัดที่แท้จริงอยู่ตรงไหน เราสร้าง DubSmart AI ขึ้นมาเพื่อจัดการเวิร์กโฟลว์ทั้งหมดนี้ในที่เดียว ดังนั้นตัวอย่างในที่นี้จึงมาจากพฤติกรรมการทำงานจริงของเครื่องมือ Text to Speech การโคลนเสียง และการพากย์เสียงของเราเอง
สารบัญ
“การแปลงข้อความเป็นเสียงพูดออนไลน์” หมายความว่าอย่างไรกันแน่
Text to speech หรือ TTS คือเทคโนโลยีที่แปลงภาษาเขียนให้เป็นเสียงพูด ระบบ AI สมัยใหม่จะอ่านข้อความ ตีความการออกเสียงและโครงสร้างประโยค และสังเคราะห์เสียงด้วยจังหวะ การเน้นเสียง และโทนเสียง การทำแบบ “ออนไลน์” หมายความง่ายๆ ว่าการสังเคราะห์ทำงานบนคลาวด์ คุณไม่ต้องติดตั้งซอฟต์แวร์หรืออัดเสียงอะไรด้วยตัวเอง
การเปลี่ยนแปลงนี้สำคัญเพราะมันเปลี่ยนว่าใครสามารถผลิตเสียงบรรยายได้ ยูทูบเบอร์ที่เขียนสคริปต์ Short เทรนเนอร์ที่อัปเดตโมดูลการกำกับดูแล นักการตลาดที่เขียนโฆษณาใหม่เป็นครั้งที่สามในสัปดาห์นั้น—ไม่มีใครในนั้นต้องใช้อุปกรณ์อัดเสียงหรือต้องมีนักพากย์คอยให้บริการ สคริปต์เดียวกันที่วางไว้สามารถกลายเป็นเสียงบรรยายสำหรับบทเรียน การสาธิตผลิตภัณฑ์ คอร์ส พอดแคสต์ การนำเสนอ เสียงสำหรับการเข้าถึง ข้อความบริการลูกค้า และเวอร์ชันที่แปลเป็นภาษาอื่น
หากคุณต้องการเจาะลึกกลไกว่าไปป์ไลน์การสังเคราะห์เปลี่ยนหน่วยเสียงให้เป็นทำนองเสียงพูดได้อย่างไร เราได้อธิบายแยกไว้ใน neural text to speech ทำงานอย่างไร สำหรับคู่มือนี้ โมเดลความคิดที่เป็นประโยชน์นั้นสั้น: สคริปต์อินพุตที่ดีบวกกับเสียงที่เหมาะสมเท่ากับเสียงที่คุณสามารถเผยแพร่ได้
เส้นทางลัดจากสคริปต์สู่ไฟล์เสียงที่ดาวน์โหลดได้
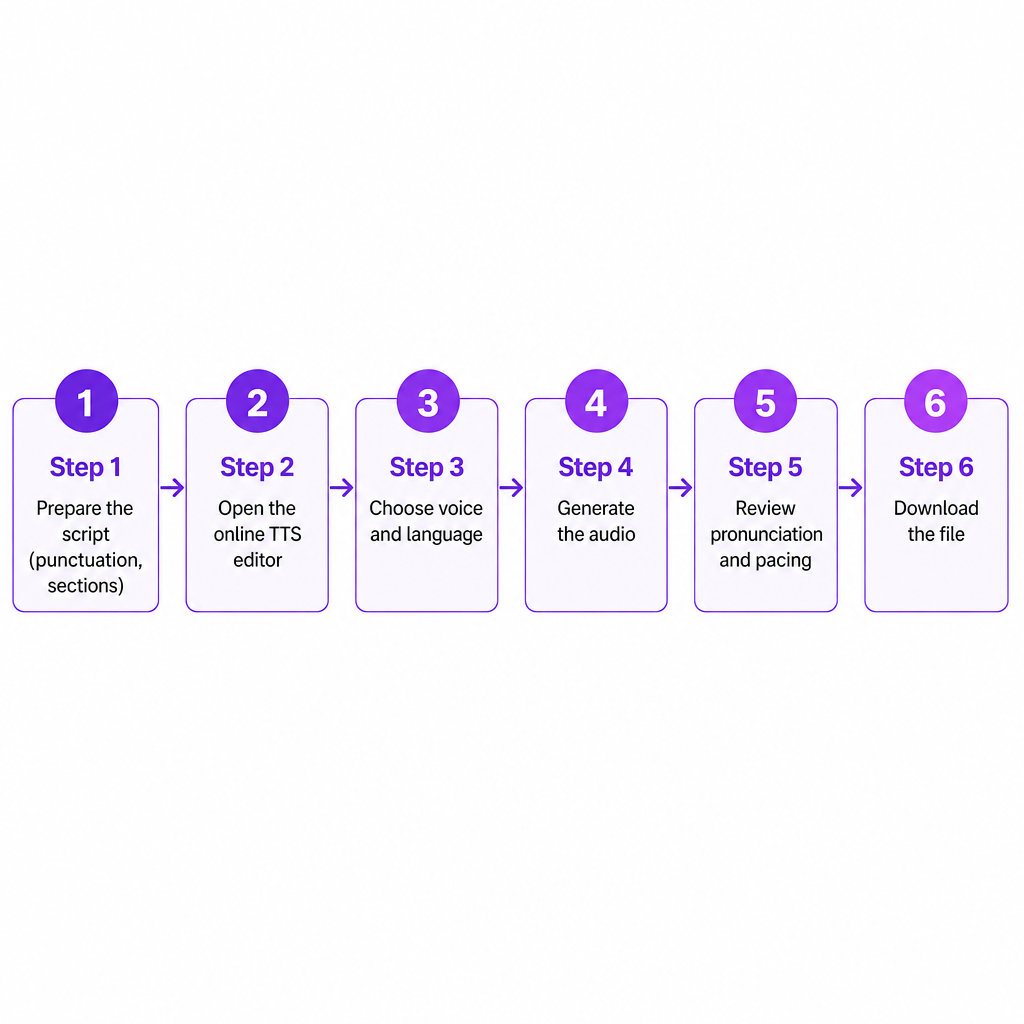
ลำดับขั้นตอนนั้นสั้นพอที่จะจำได้: เตรียมข้อความ เปิดเครื่องมือ เลือกเสียงและภาษา สร้าง ตรวจทาน ดาวน์โหลด ขั้นตอนที่คนมักข้ามคือขั้นตอนแรก และมันเป็นขั้นตอนที่ช่วยประหยัดเวลาได้มากที่สุด
เริ่มด้วยสคริปต์ที่เสร็จสมบูรณ์ ไม่ใช่โน้ตคร่าวๆ เพิ่มเครื่องหมายวรรคตอน แบ่งข้อความยาวออกเป็นส่วนที่มีเหตุผล และอ่านออกเสียงสักครั้ง เสียง AI จะส่งมอบสิ่งที่คุณให้มันไป ดังนั้นการทำความสะอาดข้อความล่วงหน้าจะช่วยป้องกันการสร้างใหม่ในภายหลัง จากนั้นวางลงใน เครื่องมือ Text to Speech ของ DubSmart เลือกเสียงที่ตรงกับเนื้อหาและกลุ่มเป้าหมาย และสร้างเสียง หน้า TTS ของเรามีเสียง AI มากกว่า 300 เสียง—ชาย หญิง และเป็นกลาง—พร้อมการควบคุมอัตราการพูด การกำกับอารมณ์ การเน้นเสียง และการออกเสียงตัวเลข
จากนั้นตรวจทานก่อนส่งออก ฟังโดยเฉพาะสำหรับชื่อที่ออกเสียงผิด การหยุดที่ไม่เป็นธรรมชาติ การเน้นเสียงผิดจุด หรือโทนเสียงที่ไม่เข้ากับวิดีโอ แก้ไขสิ่งเหล่านั้นในสคริปต์และสร้างเฉพาะส่วนที่ได้รับผลกระทบใหม่แทนที่จะสร้างทั้งไฟล์ เมื่อฟังแล้วถูกต้อง ดาวน์โหลดและนำไปใส่ในโปรเจกต์ของคุณ
ข้อสังเกตเชิงปฏิบัติข้อหนึ่ง: เอดิเตอร์ของเราแสดงตัวเลือกการส่งออกโดยตรง และเราไม่ได้เผยแพร่รายการรูปแบบไฟล์ทั้งหมดไว้ล่วงหน้า ดังนั้นควรตรวจสอบรูปแบบที่มีอยู่ในเอดิเตอร์ก่อนที่คุณจะเริ่มงานแบบแบตช์ขนาดใหญ่ การตรวจสอบห้าวินาทีนั้นดีกว่าการค้นพบว่ารูปแบบไฟล์ไม่ตรงกันหลังจากเรนเดอร์เสียงบรรยายไปหนึ่งชั่วโมงแล้ว
การเลือกเสียงที่ใช้ได้ตลอดทั้งโปรเจกต์
การเลือกเสียงที่ฟังดูสมจริงที่สุดในตัวอย่างสั้นๆ เป็นความผิดพลาดที่พบบ่อย เสียงที่สร้างความประทับใจในคลิปสิบวินาทีอาจกลายเป็นเสียงที่น่าเบื่อตลอดคำอธิบายยี่สิบนาที การทดสอบที่ดีกว่าคือลองใช้ย่อหน้าที่เป็นตัวแทนจากสคริปต์จริงของคุณ—ชื่อ ตัวเลข และทุกอย่าง—ก่อนที่จะผลิตอะไรก็ตาม
จับคู่เสียงให้เข้ากับงาน เสียงอบอุ่นและเป็นกันเองเหมาะกับบทเรียน พอดแคสต์ และเนื้อหาของครีเอเตอร์ เสียงชัดเจนและมีอำนาจเหมาะกับการนำเสนอทางธุรกิจและการฝึกอบรม เสียงที่มีพลังเหมาะกับโฆษณาและวิดีโอโซเชียล เสียงสงบและมีจังหวะเหมาะกับการทำสมาธิ การเข้าถึง และสื่อการศึกษา เสียงที่มีเอกลักษณ์หรือแสดงอารมณ์ช่วยเนื้อหานิยายและแอนิเมชัน หากคุณต้องการรายชื่อที่ปรับมาเฉพาะสำหรับแพลตฟอร์มใดแพลตฟอร์มหนึ่ง คู่มือของเราเกี่ยวกับ เสียง text to speech ที่ดีที่สุดสำหรับ YouTube จะช่วยจำกัดตัวเลือกให้แคบลง
ภาษาก็สมควรได้รับความใส่ใจเช่นเดียวกัน สำหรับเนื้อหาหลายภาษา ให้เลือกเสียงที่สร้างมาสำหรับภาษาเป้าหมายแทนที่จะบังคับเสียงภาษาอังกฤษให้อ่านข้อความภาษาต่างประเทศ—การออกเสียง จังหวะ และการเน้นเสียงแตกต่างกันอย่างมากระหว่างภาษาและสำเนียง Text to Speech API ของเรามีรายการรองรับมากกว่า 33 ภาษาและสำเนียง และระบุชื่อภาษาอังกฤษ โปรตุเกส สเปน ฝรั่งเศส เยอรมัน จีน และญี่ปุ่น ไว้ในนั้น และการโคลนเสียงของเราใช้งานได้ทั่ว 33 ภาษา
ความสม่ำเสมอคือตัวสร้างความแตกต่างที่เงียบงัน ใช้เสียง รูปแบบการออกเสียง และการตั้งค่าการส่งมอบเดียวกันซ้ำในวิดีโอที่เกี่ยวข้องกัน เพื่อให้ช่อง คอร์ส หรือแบรนด์ยังคงจดจำได้ สำหรับบทสนทนา ให้สลับเสียงเฉพาะเมื่อการเปลี่ยนแปลงนั้นช่วยความเข้าใจอย่างแท้จริงเท่านั้น เสียงที่มากเกินไปทำให้คำอธิบายสั้นๆ รู้สึกกระจัดกระจาย
ทำให้เสียงพูด AI ฟังดูเหมือนเครื่องจักรน้อยลง
เสียงที่ออกมา “เหมือนหุ่นยนต์” ส่วนใหญ่สืบย้อนกลับไปที่สคริปต์ ไม่ใช่เอนจิน ภาษาเขียนและภาษาพูดเป็นระดับที่แตกต่างกัน และเสียงจะอ่านสิ่งที่คุณพิมพ์ตรงเป๊ะ
เขียนเพื่อหู ประโยคสั้นๆ ฟังเป็นธรรมชาติมากกว่าอนุประโยคที่แน่นหนา ลองเปรียบเทียบสองประโยคนี้:
การดำเนินการของฟีเจอร์นี้มอบความสามารถให้แก่ผู้ใช้ในการสร้างเนื้อหาเสียงโดยไม่มีข้อกำหนดเกี่ยวกับอุปกรณ์อัดเสียง
ฟีเจอร์นี้ช่วยให้คุณสร้างเสียงได้โดยไม่ต้องใช้อุปกรณ์อัดเสียง
ประโยคที่สองหายใจได้ ใช้เครื่องหมายวรรคตอนเป็นตัวควบคุมการส่งมอบด้วย: จุลภาคสร้างการหยุดสั้นๆ มหัพภาคและการขึ้นย่อหน้าใหม่สร้างการเปลี่ยนผ่านที่แรงกว่า หากเสียงเริ่มเร่งหรือราบเรียบ ให้แยกประโยคออก
ตัวเลข วันที่ สกุลเงิน และตัวย่อ เป็นกับดักการออกเสียงที่พบบ่อย เมื่อเสียงที่ออกมาฟังดูผิด ให้สะกดการออกเสียงลงในสคริปต์—นั่นคือคำแนะนำที่เรายึดถือเมื่อตัวเลขที่สร้างออกมาไม่ถูกต้อง:
| คุณเขียน | เขียนให้เป็น |
|---|---|
| 2026 | twenty twenty-six |
| $49.99 | forty-nine dollars and ninety-nine cents |
| API | A-P-I |
| SQL | การออกเสียงที่กลุ่มเป้าหมายของคุณคาดหวัง |
การกำกับอารมณ์สามารถช่วยได้ หากใช้อย่างประหยัด คำแนะนำอย่าง “เธอพูดอย่างมีความสุข” อาจทำให้การส่งมอบสดใสขึ้น ในขณะที่ “เขาตะโกนอย่างโกรธเคือง” ผลักดันโทนเสียงที่หนักแน่นขึ้น—แต่หากทุกประโยคมีคำสั่งกำกับ เสียงบรรยายก็จะกลายเป็นละคร ความเร็วคือคันโยกอีกตัว: จังหวะที่ช้าลงเล็กน้อยช่วยความเข้าใจในคอร์สและเสียงสำหรับการเข้าถึง ในขณะที่การส่งมอบที่เร็วขึ้นเหมาะกับคลิปโซเชียลสั้นๆ จนกระทั่งเริ่มทำให้สูญเสียความชัดเจน เอดิเตอร์ของเราแสดงการควบคุมอัตราการพูด (ตัวอย่างเช่น ค่าเช่น 1.00x) ที่คุณสามารถปรับได้ทั้งสองทิศทาง เมื่อคำสำคัญหายไป ให้แก้ไขโครงสร้างประโยคก่อนที่จะหันไปใช้รูปแบบที่ผิดปกติ การเน้นเสียงควรรับใช้ความหมาย ไม่ใช่โฆษณาว่าเครื่องจักรเป็นคนทำ
TTS มาตรฐาน การโคลนเสียง หรือ API: อันไหนเหมาะกว่า
มีสามเส้นทางที่นำไปสู่เสียงพูด และแต่ละเส้นทางแก้ปัญหาที่ต่างกัน Text to speech มาตรฐานใช้เสียง AI ที่สร้างไว้ล่วงหน้า การโคลนเสียงสร้างเสียงสังเคราะห์ที่นำกลับมาใช้ซ้ำได้จากตัวอย่างเสียง API ทำให้ทั้งสองอย่างสามารถเขียนโปรแกรมได้
เลือกใช้เสียง AI มาตรฐานเมื่อคุณต้องการเสียงบรรยายแบบครั้งเดียวที่รวดเร็ว หลายๆ สไตล์เพื่อทดลอง นักบรรยายแบบเอนกประสงค์ หรือเสียงในภาษาที่คุณไม่สามารถอัดเองได้ เลือกใช้การโคลนเสียงเมื่อคุณต้องการเสียงครีเอเตอร์หรือแบรนด์ที่สม่ำเสมอ ตอนที่เกิดซ้ำด้วยนักบรรยายคนเดียวกัน การอัปเดตเสียงโดยไม่ต้องอัดใหม่ หรือเวอร์ชันหลายภาษาที่รักษาเอกลักษณ์เสียงที่จดจำได้ เรามีการโคลนเสียงแบบไม่จำกัดในแพลน TTS และเสียงที่โคลนแล้วใช้งานได้ทั้งใน Text to Speech และ AI Dubbing ทั่ว 33 ภาษา
API เป็นการตัดสินใจที่ต่างออกไปโดยสิ้นเชิง เอดิเตอร์บนเบราว์เซอร์เร็วที่สุดสำหรับไฟล์เดี่ยวและแบตช์ขนาดเล็ก API คุ้มค่าเมื่อการสร้างต้องเกิดขึ้นโดยอัตโนมัติ—แพลตฟอร์มที่บรรยายสคริปต์ที่ผู้ใช้ส่งมา ระบบการเรียนรู้ที่สร้างบทเรียนเสียง ผลิตภัณฑ์สนับสนุนที่ส่งข้อความส่วนบุคคล หรือเอเจนซีที่ประมวลผลตัวแปรท้องถิ่นจำนวนมาก Text to Speech API ของเราใช้อินเทอร์เฟซ REST พร้อมการจัดการโปรเจกต์และเซกเมนต์ การเลือกเสียงและภาษา พารามิเตอร์ความเร็วและระดับเสียง สถานะความคืบหน้า และ URL ของเสียงหลังการประมวลผล มันคืนค่าเป็น MP3 และเซกเมนต์หนึ่งถึงสองประโยคทั่วไปใช้เวลาประมาณ 10–30 วินาที ขึ้นอยู่กับความยาวและความซับซ้อน สิ่งที่ควรจำไว้: API ทำงานอัตโนมัติในปริมาณมาก แต่มันจะไม่ทำให้เสียงบรรยายสั้นๆ ชิ้นเดียวเร็วกว่าเอดิเตอร์แบบภาพ หากคุณกำลังชั่งน้ำหนักเส้นทางเชิงโปรแกรมโดยทั่วไป what is a voice AI API อธิบายหมวดหมู่นี้ก่อนที่คุณจะผนวกรวมอะไรก็ตาม
สิ่งที่ควรตรวจสอบก่อนตัดสินใจเลือกเครื่องมือ
ความเสียใจส่วนใหญ่มาจากการข้ามการทดสอบสั้นๆ ลองใช้ย่อหน้าเดียวกันผ่านหลายๆ เสียง รวมชื่อและตัวเลขจริงจากเวิร์กโฟลว์ของคุณ และฟังบนอุปกรณ์ที่กลุ่มเป้าหมายของคุณใช้งานจริง นี่คือเกณฑ์ที่ควรให้คะแนนในขณะที่คุณทำ
| เกณฑ์การตัดสินใจ | สิ่งที่ควรตรวจสอบ |
|---|---|
| คุณภาพเสียง | มันยังคงเป็นธรรมชาติในประโยคยาวและคำยากไหม? |
| การออกเสียง | คุณสามารถแก้ไขชื่อ ตัวย่อ และตัวเลขได้ไหม? |
| การรองรับภาษา | ภาษาและสำเนียงเป้าหมายที่แน่นอนของคุณครอบคลุมไหม? |
| ความสม่ำเสมอ | คุณสามารถใช้เสียงเดียวกันซ้ำในหลายโปรเจกต์ได้ไหม? |
| การควบคุมการแก้ไข | ความเร็ว ระดับเสียง การหยุด และการเน้นเสียงปรับได้ไหม? |
| เอาต์พุตและความเร็ว | รูปแบบไฟล์มีให้ใช้และการสร้างเร็วพอไหม? |
| ระบบอัตโนมัติ | มี API ไหมหากคุณต้องการการสร้างเชิงโปรแกรม? |
| สิทธิ์และต้นทุน | เงื่อนไขการใช้งาน สิทธิ์เชิงพาณิชย์ และเครดิตชัดเจนไหม? |
ตารางบีบอัดเช็กลิสต์การซื้อให้เหลือหน้าจอเดียว แต่การทดสอบนำร่องคือสิ่งที่ยืนยันมัน แพลนฟรีหรือการทดสอบเล็กๆ บอกคุณได้มากกว่าในสิบนาทีเมื่อเทียบกับรายการฟีเจอร์ใดๆ เพราะเอาต์พุตเดียวที่สำคัญคือสคริปต์ของคุณฟังเป็นอย่างไรในเสียงที่คุณจะใช้งานจริง
การใช้เสียงพูด AI อย่างมีความรับผิดชอบ
เสียงสังเคราะห์มีประโยชน์อย่างแท้จริง และมันมาพร้อมภาระหน้าที่ที่แท้จริง โคลนเสียงเฉพาะเมื่อคุณได้รับอนุญาตจากผู้พูดและมีสิทธิ์ในการบันทึกเสียงนั้น อย่าแอบอ้างเสียงสังเคราะห์ว่าเป็นการบันทึกจริง และอย่าใช้เสียงที่ฟังคุ้นเคยเพื่อขอเงินหรือข้อมูลที่ละเอียดอ่อนเด็ดขาด
นี่ไม่ใช่ความระมัดระวังแบบนามธรรม คณะกรรมการการค้าแห่งสหพันธรัฐ (Federal Trade Commission) เตือนว่าการโคลนเสียงสามารถทำให้คำร้องขอที่ฉ้อโกงฟังดูราวกับว่ามาจากสมาชิกครอบครัว เพื่อนร่วมงาน หรือผู้บริหารที่ไว้ใจได้ และแนะนำให้ ตรวจสอบตัวตนอย่างอิสระ แทนที่จะเชื่อใจเพียงเสียงที่คุ้นเคยเท่านั้น
สำหรับงานเชิงพาณิชย์หรือที่เผยแพร่สู่สาธารณะ นิสัยไม่กี่อย่างจะช่วยให้คุณปลอดภัย: เก็บบันทึกที่แสดงการอนุญาตให้ใช้เสียงที่โคลนไว้ ทบทวนเงื่อนไขของผู้ให้บริการสำหรับการใช้งานเชิงพาณิชย์และการจัดการข้อมูล เปิดเผยเสียงบรรยายสังเคราะห์เมื่อความโปร่งใสมีความสำคัญต่อกลุ่มเป้าหมายของคุณ และเพิ่มการตรวจสอบโดยมนุษย์สำหรับเนื้อหาด้านกฎหมาย การแพทย์ การเงิน หรือเนื้อหาที่สำคัญต่อความปลอดภัย ปฏิบัติต่อเสียงในฐานะความสะดวก ไม่ใช่หลักฐานยืนยันตัวตนเด็ดขาด
คำถามที่พบบ่อย
วิธีที่เร็วที่สุดในการแปลงข้อความเป็นเสียงพูดออนไลน์คืออะไร?
ใช้เอดิเตอร์ TTS บนเบราว์เซอร์: วางสคริปต์ที่เตรียมไว้ เลือกเสียง สร้าง ตรวจทานการออกเสียง และดาวน์โหลด การเตรียมสคริปต์ก่อนที่คุณจะเปิดเครื่องมือมักเป็นตัวประหยัดเวลาที่ใหญ่ที่สุด เพราะอินพุตที่สะอาดหมายถึงการสร้างใหม่ที่น้อยลง
ฉันสามารถแปลงข้อความเป็นเสียงพูดได้ฟรีไหม?
บางแพลตฟอร์ม รวมถึงของเรา เสนอการเข้าถึงฟรีหรือเครดิตทดลองใช้ แต่ข้อจำกัดแตกต่างกันไปตามแพลน ตรวจสอบเงื่อนไขปัจจุบันสำหรับจำนวนอักขระ เครดิต การดาวน์โหลด การใช้งานเชิงพาณิชย์ และการโคลนเสียงก่อนที่คุณจะเผยแพร่
ฉันสามารถใช้ text to speech ออนไลน์สำหรับ YouTube ได้ไหม?
ได้ TTS ออนไลน์สามารถบรรยายวิดีโอ Shorts บทเรียน และเวอร์ชันหลายภาษา ยืนยันเงื่อนไขการอนุญาตของผู้ให้บริการเพื่อให้เสียงและเสียงที่สร้างขึ้นได้รับการอนุมัติสำหรับการใช้งานตามที่คุณตั้งใจ
ฉันสามารถแปลงข้อความเป็นเสียงพูดในภาษาอื่นได้ไหม?
ได้ เมื่อแพลตฟอร์มรองรับภาษานั้นและมีเสียงที่เหมาะสม เพื่อผลลัพธ์ที่เป็นธรรมชาติ แปลและแก้ไขสคริปต์ก่อน จากนั้นเลือกเสียงที่ออกแบบมาสำหรับภาษาหรือสำเนียงเป้าหมายแทนที่จะนำเสียงภาษาอังกฤษกลับมาใช้ซ้ำ
ฉันควรใช้รูปแบบไฟล์ใด?
MP3 เหมาะกับวิดีโอ พอดแคสต์ และโปรเจกต์เว็บส่วนใหญ่ เพราะได้รับการรองรับอย่างกว้างขวางและกะทัดรัด สำหรับการโพสต์โปรดักชันระดับมืออาชีพ ตรวจสอบว่าเอดิเตอร์ของคุณต้องการรูปแบบต้นฉบับที่แตกต่างหรือมีคุณภาพสูงกว่าหรือไม่
TTS ออนไลน์ดีพอสำหรับเนื้อหาระดับมืออาชีพไหม?
สำหรับคำอธิบาย การฝึกอบรม เสียงสำหรับการเข้าถึง ร่าง สื่อท้องถิ่น และเสียงบรรยายที่อัปเดตเป็นประจำ ใช่ สำหรับโปรเจกต์ที่เน้นการแสดงหรือมีความเสี่ยงสูงที่จังหวะอันละเอียดอ่อนเป็นตัวสื่อความหมาย ให้ฟังอย่างใกล้ชิดและพิจารณานักพากย์ที่เป็นมนุษย์