การเลือกเสียงพูดจากข้อความที่ดีที่สุดสำหรับ YouTube นั้นไม่ได้เกี่ยวกับการไล่ล่าหาเสียงที่ "สมบูรณ์แบบ" เพียงเสียงเดียว แต่เป็นเรื่องของการจับคู่การตั้งค่าเสียงที่เหมาะสมกับกลุ่มเฉพาะของช่องคุณ แผนการใช้ภาษา และวิธีการผลิตวิดีโอของคุณจริง ๆ บน DubSmart AI ทางเลือกนั้นแบ่งออกเป็นสี่ตัวเลือกที่ใช้งานได้จริงภายในพื้นที่ทำงานเดียว ได้แก่ คลังเสียง AI สำเร็จรูปกว่า 300 เสียงของเรา เสียงที่คุณโคลนจากเสียงของคุณเอง เสียงเดียวกันเหล่านั้นที่นำไปใช้กับการพากย์เสียงหลายภาษา และเสียงที่ขับเคลื่อนด้วย API สำหรับระบบอัตโนมัติ แต่ละตัวเลือกแก้ปัญหาที่แตกต่างกัน และตัวเลือกที่ดีที่สุดมักจะรวมบางตัวเลือกเข้าด้วยกันเมื่อช่องของคุณเติบโตขึ้น
คู่มือนี้จะพาคุณผ่านสิ่งที่การตั้งค่าเสียงแต่ละแบบทำได้ดี เหมาะกับงานแบบไหน และข้อจำกัดอยู่ตรงไหน เพื่อให้คุณตัดสินใจได้อย่างมั่นใจแทนที่จะเดาจากการจัดอันดับทั่วไป
สารบัญ
เราเลือกเสียงพูดจากข้อความที่ดีที่สุดสำหรับ YouTube อย่างไร
เราคัดเลือกเสียงและการตั้งค่าเสียงที่ใช้งานได้จริงบนช่อง YouTube จริง ไม่ใช่สำหรับการจัดอันดับตลาดในเชิงนามธรรม เกณฑ์ห้าข้อกำหนดทุกตัวเลือกด้านล่างนี้
ความเป็นธรรมชาติสำคัญเป็นอันดับแรก เพราะเวลาการรับชมส่วนใหญ่เกิดขึ้นบนโทรศัพท์ที่ระดับเสียงแปรผัน เสียงต้องฟังดูเหมือนมนุษย์และคงความชัดเจนผ่านเสียงที่ถูกบีบอัดและเสียงรบกวนรอบข้างระหว่างการเดินทาง ความครอบคลุมของภาษาและสำเนียงเป็นลำดับถัดไป: เสียงจะมีประโยชน์สำหรับการเติบโตก็ต่อเมื่อคุณสามารถนำมันไปยังภูมิภาคใหม่ ๆ ได้โดยไม่ต้องบันทึกคลังเนื้อหาเดิมใหม่ ความสอดคล้องของแบรนด์เป็นตัวกรองที่สาม เพราะเสียงเดียวกันควรนำกลับมาใช้ซ้ำได้ทั้งในสตูดิโอ Text to Speech ของเราและการพากย์เสียง รวมถึงเสียงที่โคลนมาให้ฟังดูเหมือนคุณ ความเหมาะสมกับเวิร์กโฟลว์เป็นตัวตัดสินว่าเสียงนั้นสร้าง แก้ไข และส่งออกได้จริงภายในตารางการผลิตจริงหรือไม่ และสุดท้าย ศักยภาพในการทำงานอัตโนมัติเป็นตัวกำหนดว่านักพัฒนาและเอเจนซีสามารถเรียกใช้เสียงเดียวกันนี้ผ่าน API สำหรับการผลิตแบบเทมเพลตหรือในปริมาณมากได้หรือไม่
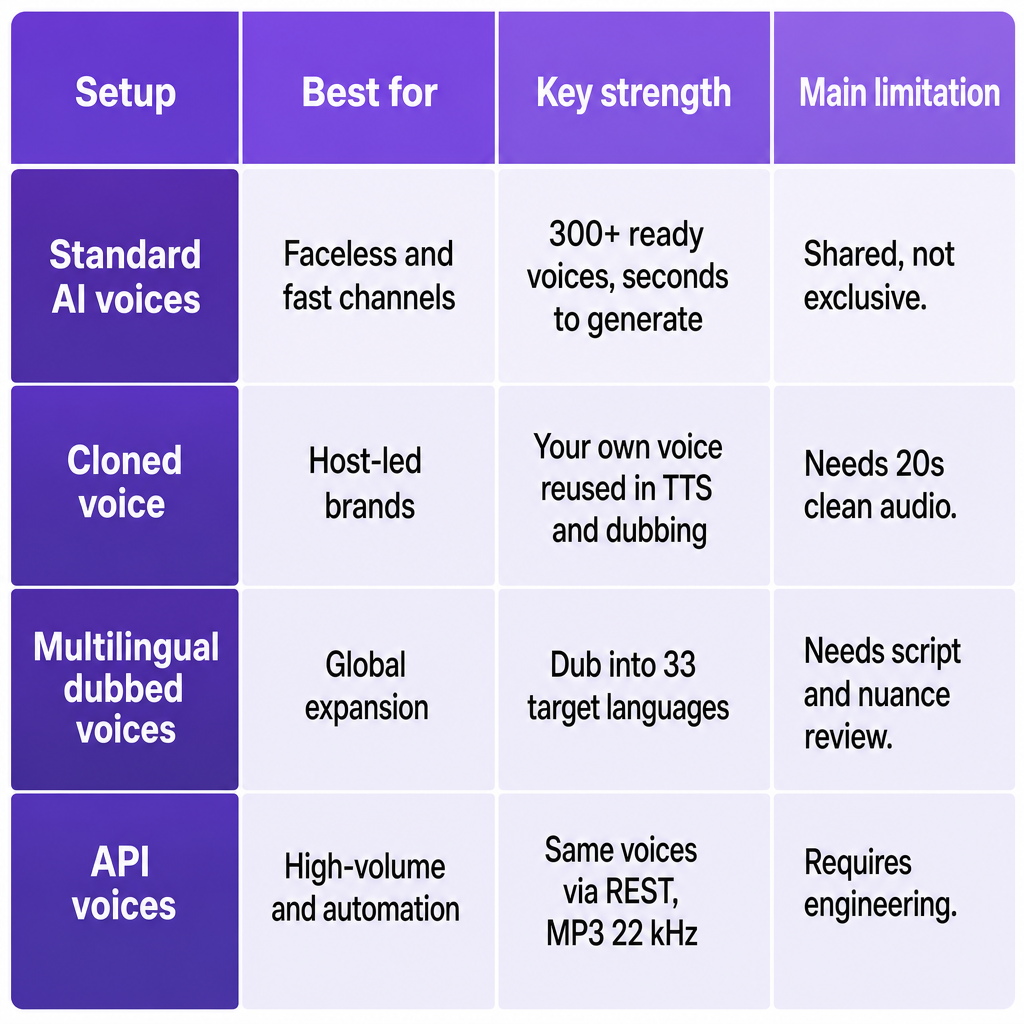
แต่ละรายการด้านล่างนี้จะมีหนึ่งหัวข้อพร้อมความโดดเด่น ความเหมาะสมที่สุดบน YouTube และข้อจำกัดอย่างตรงไปตรงมา ซึ่งดึงมาจากวิธีที่เครื่องมือเหล่านี้ทำงานจริงภายในแพลตฟอร์มของเรา
คลังเสียง AI มาตรฐาน: การบรรยายที่รวดเร็ว พร้อมเผยแพร่
เส้นทางที่เร็วที่สุดสู่เสียงบรรยายที่เสร็จสมบูรณ์คือเอนจิน Text to Speech ของเรา: วางสคริปต์ในภาษาของคุณ เลือกจากเสียง AI กว่า 300 เสียง พรีวิว และสร้างเสียงพูดที่สมจริงภายในไม่กี่วินาที คุณสามารถเลือกผู้พูด ปรับการตั้งค่าพื้นฐาน และส่งออกไฟล์เสียงมาตรฐานที่คุณนำไปวางในการตัดต่อ YouTube ได้โดยตรง แคตตาล็อกเดียวกันนี้เปิดให้ใช้งานผ่าน TTS API ของเรา ดังนั้นทุกเสียงสำเร็จรูปจึงมีอยู่ทั้งในสตูดิโอบนเว็บและในเวิร์กโฟลว์แบบโปรแกรม
การตั้งค่านี้เหมาะกับช่องแบบไม่เปิดเผยหน้าและช่องแสดงความคิดเห็นที่ให้ความสำคัญกับความเร็วและความสอดคล้องมากกว่าบุคลิกที่จดจำได้เพียงหนึ่งเดียว มันเหมาะกับการสรุปข่าว รายการจัดอันดับ คลิปอธิบาย และสไลด์โชว์ที่ต้องการการบรรยายที่สะอาดในตารางเวลาที่กระชั้นชิด รวมถึงช่อง e-learning องค์กร และการตลาดที่ต้องการโทนเสียงที่เป็นกลางและเป็นมืออาชีพ ครีเอเตอร์สามารถวางสคริปต์ เลือกเสียง สร้าง และดาวน์โหลดสำหรับโปรแกรมตัดต่ออย่าง Premiere หรือ Final Cut โดยไม่ต้องแตะต้องอุปกรณ์บันทึกเสียง สำหรับทีมด้านเทคนิค Text to Speech API ของเราจะส่งคืนไฟล์ MP3 ที่ 22 kHz หลังจากคำของ่าย ๆ ที่มีข้อความและความชอบด้านเสียง ซึ่งเข้ากันได้อย่างลงตัวกับระบบการผลิตวิดีโอแบบเทมเพลตหรือขับเคลื่อนด้วยข้อมูล หากคุณต้องการกลไกเชิงลึก คลิปอธิบายของเราเกี่ยวกับการทำงานของ neural text to speech ครอบคลุมสิ่งที่เกิดขึ้นเบื้องหลังการเรนเดอร์แต่ละครั้ง
ข้อแลกเปลี่ยนคือความเป็นเอกลักษณ์ เสียงมาตรฐานถูกแชร์ร่วมกันระหว่างผู้ใช้ ดังนั้นช่องที่มีการสร้างแบรนด์หนักและนำโดยบุคลิกอาจต้องการบางอย่างที่โดดเด่นกว่าในที่สุด คุณสามารถปรับแต่งภาษา ผู้พูด และพารามิเตอร์บางอย่างได้ แต่คุณจะไม่ได้ลักษณะเฉพาะที่ละเอียดอ่อนของเสียงตัวเองโดยไม่ทำการโคลน และเนื่องจากแคตตาล็อกนั้นกว้าง การหาเสียงที่ตรงกับผู้ชมของคุณอย่างแท้จริงยังคงต้องทดลองฟังสักสองสามครั้งแทนที่จะเลือกได้ครั้งเดียวแบบโชคดี
เสียงครีเอเตอร์ที่โคลน: พิธีกรที่จดจำได้ในสเกลใหญ่
เมื่อเสียงของคุณเป็นส่วนหนึ่งของแบรนด์ การโคลนจะเปลี่ยนสมการ การโคลนเสียงของเราสร้างเสียง AI ที่กำหนดเองจากตัวอย่างสั้น ๆ จากนั้นทำให้เสียงนั้นสามารถเลือกได้ในทุกที่ที่เสียงมาตรฐานปรากฏ ทั้งใน Text to Speech และการพากย์เสียง คุณอัปโหลดเสียงที่สะอาดอย่างน้อย 20 วินาทีโดยไม่มีเสียงรบกวนรอบข้าง และระบบจะผลิตเสียงโคลนที่นำกลับมาใช้ซ้ำได้ เรารองรับการโคลนเสียงจำนวนเท่าใดก็ได้ ดังนั้นแบรนด์จึงไม่ถูกจำกัดอยู่กับพิธีกรเพียงคนเดียว: คุณสามารถโคลนโฆษกหลายคนหรือเสียงตัวละครได้ตามต้องการ
เสียงที่โคลนเป็นตัวเลือกที่แข็งแกร่งที่สุดสำหรับช่องที่ขับเคลื่อนด้วยบุคลิก ที่ผู้ชมติดตามเพื่อบุคคลเฉพาะ มันยังเหมาะกับครีเอเตอร์ที่ต้องการคงเสียงของตัวเองไว้ในขณะที่ทำให้บางส่วนของการผลิตเป็นอัตโนมัติ เช่น การบรรยาย B-roll แทร็กภาษาอื่น หรือคลิปสั้นที่มีสคริปต์ และมันเป็นแกนหลักของช่องหลายภาษาที่ต้องการเอกลักษณ์ของผู้พูดที่สอดคล้องกันหนึ่งเดียวข้ามภาษาเมื่อจับคู่กับการพากย์เสียง เมื่อโคลนแล้ว เสียงของคุณจะกลายเป็นตัวเลือกปกติในสตูดิโอ พร้อมสำหรับการบรรยายที่มีสคริปต์หรือสำหรับการพากย์เสียงวิดีโอเต็มรูปแบบเป็นภาษาอื่นในขณะที่รักษาเอกลักษณ์ของคุณไว้
คุณภาพขึ้นอยู่กับเสียงต้นฉบับของคุณ ตัวอย่างที่มีเสียงรบกวนหรือเสียงก้องจะผลิตเสียงโคลนที่อ่อนแอกว่าและอาจทำให้เกิดสิ่งแปลกปลอม ดังนั้นครีเอเตอร์หลายคนจึงบันทึกตัวอย่างที่สะอาดโดยเฉพาะแทนที่จะใช้เสียงไลฟ์สตรีมหรือ vlog ซ้ำ ข้ามภาษา สำเนียงและจังหวะการออกเสียงเป็นไปตามโมเดลการสังเคราะห์เสียง ดังนั้นการออกเสียงอาจไม่ตรงกับเจ้าของภาษาอย่างสมบูรณ์แบบในทุกภาษาเป้าหมาย การโคลนยังเพิ่มขั้นตอนการตั้งค่าก่อนใช้งานครั้งแรก ซึ่งทำให้มันเหมาะที่สุดสำหรับช่องที่มุ่งมั่นต่อความสอดคล้องในระยะยาวมากกว่าการทดสอบครั้งเดียว
เสียงพากย์หลายภาษา: เปลี่ยนหนึ่งช่องให้เป็นหลายช่อง
เส้นทางที่ตรงที่สุดสู่ช่องระดับโลกคือการพากย์เสียง ด้วยAI Dubbing ของเรา คุณอัปโหลดวิดีโอ แปลและพากย์เสียงใหม่เป็นภาษาเป้าหมายใด ๆ ใน 33 ภาษา และเลือกใช้เสียงที่โคลนกับแทร็กที่พากย์เสียงเหล่านั้นได้ รายละเอียดสำคัญคือการพากย์เสียงดึงมาจากแคตตาล็อกเสียงเดียวกันและเสียงที่โคลนที่ใช้สำหรับ Text to Speech ดังนั้นเสียงพากย์ "ที่ดีที่สุด" ของคุณจึงเป็นเพียงเสียงที่คุณเลือกซึ่งกำหนดค่าสำหรับสคริปต์ที่แปลแล้ว เนื่องจากพื้นที่ทำงานยังรวม Speech to Text, Speech Separator และเครื่องมือภาพและวิดีโอไว้ด้วย คุณจึงหลีกเลี่ยงการเย็บต่อซัพพลายเออร์แยกกันสำหรับการถอดเสียง การแปล การบรรยาย และภาพ
สิ่งนี้เหมาะกับช่องที่ประสบความสำเร็จในภาษาเดียวอยู่แล้วและพร้อมขยายโดยไม่ต้องถ่ายใหม่ บทช่วยสอน การรีวิวผลิตภัณฑ์ สารคดี และเนื้อหายาวที่มีคุณค่าในการรับชมซ้ำสูงนั้นคุ้มค่ากับความพยายาม เช่นเดียวกับธุรกิจ ผู้ให้บริการ e-learning และทีมการตลาดที่ต้องการการบรรยายแบรนด์ที่สอดคล้องกันข้ามภูมิภาค คุณสามารถเริ่มจากวิดีโอที่มีอยู่ สร้างสคริปต์ที่แปลแล้ว และนำเสียงมาตรฐานหรือเสียงที่โคลนของคุณไปใช้กับเสียงที่พากย์ สร้างเวอร์ชันท้องถิ่นของช่องของคุณที่คงบุคลิกเดิมไว้ การเก็บ Text to Speech และการพากย์เสียงไว้ในพื้นที่ทำงานเดียวทำให้ง่ายต่อการจัดสไตล์การบรรยายให้สอดคล้องกันระหว่างเวอร์ชันต้นฉบับและเวอร์ชันที่แปล หากคุณกำลังชั่งน้ำหนักรูปแบบการแปลเนื้อหาท้องถิ่น การวิเคราะห์ของเราเกี่ยวกับการพากย์เสียงเทียบกับคำบรรยายช่วยกำหนดกรอบการตัดสินใจได้
การพากย์เสียงเพิ่มงานที่การบรรยายภาษาเดียวไม่มี แม้จะมีการแปลและการสังเคราะห์ที่แข็งแกร่ง คุณก็ยังต้องทบทวนสคริปต์เพื่อความละเอียดอ่อนทางวัฒนธรรม ปรับตัวอย่าง และยืนยันว่าสไตล์เสียงเหมาะกับผู้ชมเป้าหมาย มันยังใช้เครดิตและการจัดการการส่งออกมากกว่าคลิปครั้งเดียว เสียงที่โคลนรักษาเอกลักษณ์ไว้ แต่การลิปซิงค์และจังหวะเวลาอาจไม่ตรงกับภาพต้นฉบับอย่างสมบูรณ์แบบในเนื้อหาที่พูดเร็วหรือมีแอนิเมชันหนัก ดังนั้นคาดว่าจะมีการแก้ไขด้วยตนเองบ้างในโปรแกรมตัดต่อวิดีโอของคุณ
เสียงที่ขับเคลื่อนด้วย API: การผลิตปริมาณมากแบบอัตโนมัติ
สำหรับทีมที่ผลิตในปริมาณมาก เสียงเดียวกันมีให้ใช้งานแบบโปรแกรมผ่านสามเอ็นด์พอยต์ Text to Speech API ของเราแปลงข้อความเป็นเสียงพูดที่เป็นธรรมชาติโดยใช้ชุดเสียงกว่า 300 เสียงเต็มรูปแบบ และส่งคืนไฟล์ MP3 ที่ดาวน์โหลดได้ที่ 22 kHz เมื่อการประมวลผลเสร็จสมบูรณ์ Voice Cloning API ของเราให้คุณอัปโหลดตัวอย่างและสร้างเสียงที่กำหนดเองซึ่งใช้งานได้ใน TTS หรือการพากย์เสียง AI Dubbing API ของเราให้นักพัฒนาและเอเจนซีแปลและพากย์วิดีโอแบบโปรแกรม ฝังความสามารถเหล่านี้ลงในระบบการผลิตเนื้อหาหรือ CMS โดยตรง
การตั้งค่านี้เหมาะกับช่องที่สร้างวิดีโอที่คล้ายกันจำนวนมาก เช่น สรุปข่าวประจำ บทสรุปที่ขับเคลื่อนด้วยข้อมูล หรือคลิปอธิบายแบบเทมเพลตที่สคริปต์ถูกสร้างหรือเติมจากข้อมูลที่มีโครงสร้าง มันเหมาะกับเอเจนซีที่จัดการหลายช่องของลูกค้าที่ต้องการเวิร์กโฟลว์เสียงอัตโนมัติที่ทำซ้ำได้ และผลิตภัณฑ์ซอฟต์แวร์ที่มีฟีเจอร์เผยแพร่อัตโนมัติที่ต้องการเสียงบรรยายคุณภาพในสเกลใหญ่ เนื่องจากเสียงที่โคลนสามารถอ้างอิงโดย ID ควบคู่กับเสียงมาตรฐาน การทำงานอัตโนมัติจึงไม่ทำให้คุณเสียความสอดคล้องของแบรนด์: ทุกการเรนเดอร์ใช้เสียงที่ตั้งใจเดียวกันข้ามวิดีโอและช่อง
ต้นทุนคืองานวิศวกรรม เวิร์กโฟลว์ API ต้องการความคุ้นเคยกับบริการ RESTful พร้อมโครงสร้างพื้นฐานในการจัดเก็บเสียง ประมวลผลหลัง และแนบมันกับแอสเซ็ตวิดีโอ ครีเอเตอร์รายเล็กที่ทำงานทั้งหมดในโปรแกรมตัดต่อบนเว็บมักจะไม่ได้ประโยชน์จนกว่าจะถึงสเกลที่มีความหมาย ระบบอัตโนมัติยังต้องการมาตรการป้องกันเกี่ยวกับคุณภาพสคริปต์ จังหวะเวลา และการปฏิบัติตามข้อกำหนด เพราะอินพุตที่อ่อนแอก็ยังผลิตเอาต์พุตที่อ่อนแออยู่ดีไม่ว่าเสียงจะดีแค่ไหน
วิธีเลือกการตั้งค่าเสียงที่เหมาะกับช่องของคุณ
คำถามสี่ข้อจะคลี่คลายการตัดสินใจส่วนใหญ่ ตอบตามลำดับแล้วสแต็กเสียงของคุณจะเข้าที่
ผู้ชมและรูปแบบ หากช่องของคุณไม่เปิดเผยหน้า เน้นข่าว หรือขับเคลื่อนด้วยรายการจัดอันดับ ให้เริ่มด้วยเสียง AI มาตรฐานสำหรับการทำงานที่รวดเร็วและการทดสอบโทนที่ง่าย หากผู้ชมติดตามเพราะตัวคุณโดยเฉพาะ ให้ลงทุนในการโคลนเสียงของคุณและใช้มันทั้งใน Text to Speech และการพากย์เสียง
กลยุทธ์ด้านภาษา หากคุณเผยแพร่ในภาษาเดียว ให้หาเสียงหนึ่งหรือสองเสียงที่ตรงกับโทนของคุณและยึดมั่นกับมันเพื่อความสอดคล้อง หากคุณวางแผนจะก้าวสู่ระดับโลก ให้ออกแบบรอบการพากย์เสียง: เลือกเสียงที่โคลนหลักและแมปมันกับแทร็กที่พากย์ข้ามภาษาเป้าหมายได้ถึง 33 ภาษา
ปริมาณการผลิต สำหรับการอัปโหลดรายสัปดาห์หรือซีรีส์เป็นครั้งคราว เครื่องมือ Text to Speech และ AI Dubbing บนเว็บก็เพียงพอ สำหรับเนื้อหาปริมาณมากหรือขับเคลื่อนด้วยข้อมูล ให้วางแผนเวิร์กโฟลว์แบบ API-first ที่สคริปต์และแอสเซ็ตใหม่จะกระตุ้นการสร้างเสียงโดยอัตโนมัติ
การควบคุมแบรนด์และความเสี่ยง ใช้เสียงมาตรฐานสำหรับโครงการนำร่องที่มีความเสี่ยงต่ำและช่องที่เอกลักษณ์ของเสียงไม่ใช่สิ่งสำคัญ ใช้เสียงที่โคลนด้วยกฎภายในที่ชัดเจนเกี่ยวกับว่าใครสามารถกระตุ้นพวกมันได้และพวกมันจะปรากฏที่ไหน ซึ่งสำคัญที่สุดสำหรับช่ององค์กรหรือช่องที่มีแบรนด์
การจับคู่เสียงของคุณกับความคาดหวังของผู้ชม แผนด้านภาษา และเวิร์กโฟลว์เป็นวิธีที่คุณหลีกเลี่ยงความล้มเหลวทั่วไป: การบรรยายที่ไม่สอดคล้อง การเปลี่ยนเสียงที่ไม่คาดคิดระหว่างวิดีโอ และระบบที่ซับซ้อนเกินไปจนยากต่อการบำรุงรักษา เส้นทางที่ใช้งานได้จริงคือทดสอบเสียงมาตรฐานสองสามเสียงก่อน เพิ่มเสียงที่โคลนเมื่อเอกลักษณ์ของคุณเริ่มสำคัญ และนำ API และการพากย์เสียงหลายภาษาเข้ามาเมื่อการดำเนินงานของคุณเติบโตเกินการเรนเดอร์ด้วยตนเอง
คำถามที่พบบ่อย
ฉันสามารถใช้เสียง AI ของ DubSmart บนวิดีโอ YouTube ของฉันได้หรือไม่
เครื่องมือ Text to Speech และ AI Dubbing ของเราสร้างขึ้นเพื่อให้ครีเอเตอร์และธุรกิจผลิตเสียงบรรยายสำหรับเนื้อหาสาธารณะ รวมถึง YouTube ภายใต้โมเดลการใช้งานแบบเครดิต คุณยังคงต้องรับผิดชอบในการปฏิบัติตามข้อกำหนดของ YouTube นโยบายการโฆษณา และกฎระเบียบท้องถิ่น แต่แพลตฟอร์มของเราได้รับการออกแบบมาสำหรับการใช้สื่อเชิงพาณิชย์
ฉันต้องใช้เสียงมากแค่ไหนในการโคลนเสียงของฉัน
คุณต้องใช้เสียงพูดที่สะอาดอย่างน้อย 20 วินาทีโดยไม่มีเสียงรบกวนรอบข้างเพื่อสร้างเสียงโคลนที่ใช้งานได้ ยิ่งการบันทึกสะอาดมากเท่าไร ผลลัพธ์ก็จะยิ่งแม่นยำและเป็นธรรมชาติมากขึ้นเท่านั้น ดังนั้นตัวอย่างเงียบที่บันทึกโดยเฉพาะจึงดีกว่าเสียงที่นำมาใช้ซ้ำที่มีเสียงรบกวน
เสียงที่โคลนของฉันจะใช้งานได้ในหลายภาษาหรือไม่
ใช่ เสียงที่โคลนสามารถใช้งานได้ทั้งใน Text to Speech และ AI Dubbing ซึ่งรองรับหลายภาษาและ 33 ภาษาเป้าหมายสำหรับการพากย์เสียง คุณคงเอกลักษณ์ของเสียงเดียวกันข้ามสคริปต์ในภาษาที่แตกต่างกัน แม้ว่าการออกเสียงและสำเนียงจะเป็นไปตามโมเดลการสังเคราะห์เสียงมากกว่าเสียงมนุษย์เจ้าของภาษาในทุกกรณี
ฉันสามารถเปลี่ยนจากเสียงมาตรฐานไปเป็นเสียงที่โคลนในภายหลังได้หรือไม่
ใช่ เราถือว่าเสียงที่โคลนเป็นเสียงที่นำกลับมาใช้ซ้ำได้ในแคตตาล็อกเดียวกันกับเสียง AI มาตรฐาน ดังนั้นคุณสามารถเริ่มด้วยเสียงมาตรฐานและเปลี่ยนโครงการไปเป็นเสียงที่โคลนในภายหลังโดยใช้อินเทอร์เฟซหรือ API ของ Text to Speech และ AI Dubbing เดียวกัน โดยไม่ต้องสร้างเวิร์กโฟลว์ของคุณใหม่
API ช่วยในการผลิต YouTube อย่างไร
Text to Speech, Voice Cloning และ AI Dubbing API ของเราให้คุณแปลงสคริปต์เป็นเสียงพูด โคลนเสียง และพากย์วิดีโอผ่านเอ็นด์พอยต์ RESTful นั่นทำให้สามารถทำงานอัตโนมัติกับรูปแบบที่เกิดซ้ำได้จริง เสียบเสียงบรรยายเข้ากับ CMS หรือระบบตัดต่อที่มีอยู่ และขยายไปยังหลายช่องหรือหลายภาษาได้โดยไม่ต้องกระตุ้นการเรนเดอร์แต่ละครั้งด้วยตนเอง