Een script omzetten in YouTube-voice-over betekende vroeger een microfoon, een rustige ruimte en een hoop nieuwe opnames. Nu kun je met youtube tekst naar spraak een script plakken, een stem kiezen en voice-over exporteren die je in een video, een Short, een tutorial of een vertaalde versie van een al gepubliceerde upload kunt plaatsen. De echte beslissing is niet óf je überhaupt een synthetische stem gebruikt. Het is welke productiemethode past bij de specifieke video die voor je ligt: een standaard AI-stem, een aangepaste kloon, een menselijke opname of een combinatie van de drie.
Deze gids legt uit hoe de technologie daadwerkelijk werkt, welke workflow past bij verschillende kanaaldoelen en wat je moet controleren op het gebied van rechten en openbaarmaking voordat je op publiceren drukt. Het is het centrale knooppunt voor onze bredere reeks uitleg over spraak en transcriptie, dus je vindt links naar diepere verkenningen waar een enkel onderwerp een eigen pagina verdient.
Inhoudsopgave
Wat YouTube tekst naar spraak eigenlijk betekent
YouTube tekst naar spraak is simpelweg het gebruik van tekst-naar-spraaktechnologie om voice-over voor YouTube-content te genereren. Je levert een script, kiest een stem en taal, past aan hoe het moet worden uitgesproken en exporteert een audiobestand om te bewerken of te uploaden. Achter de schermen zet een TTS-systeem tekst, of Speech Synthesis Markup Language (SSML), om in audiodata zoals MP3 of WAV-compatibele audio die je kunt toevoegen aan video en andere media.
Twee onderscheiden lossen de meeste verwarring op. Ondertiteling doet het tegenovergestelde van TTS: ondertiteling zet gesproken audio om in tekst, terwijl tekst naar spraak geschreven tekst omzet in gesproken audio. Nasynchronisatie is nog breder. TTS begint meestal bij een geschreven script en produceert een nieuw stemspoor, terwijl nasynchronisatie over het algemeen een bestaande video vertaalt en de vervangende spraak laat aansluiten op de oorspronkelijke timing en betekenis. Als die grenzen belangrijk zijn voor je workflow, behandelt onze uitleg over in welke talen AI kan nasynchroniseren de lokalisatiekant in detail.
Hoe de synthesepijplijn een script in een stem omzet
Een TTS-systeem combineert vier ingrediënten: je script, een geselecteerd stemmodel, taalinformatie en bedieningselementen voor de uitspraak. Daaruit werkt het door een korte reeks die verklaart waarom dezelfde zin geweldig of onhandig kan klinken, afhankelijk van hoe je hem hebt geschreven.
Eerst komt de tekstinvoer, die een volledig YouTube-script kan zijn, een schets uitgewerkt tot voice-over, een vertaalde versie van een bestaand script, of ondertiteling omgevormd tot voice-over. De invoerkwaliteit bepaalt de uitvoerkwaliteit. Lange zinnen, onverklaarde afkortingen, ongebruikelijke namen en rommelige interpunctie kunnen een capabele stem verkeerd laten klinken. De oplossing is schrijven om beluisterd te worden in plaats van stil te lezen: kortere zinnen, duidelijke overgangen, bewuste pauzes.
Vervolgens analyseert de engine de tekst om te bepalen hoe woorden moeten worden uitgesproken en gegroepeerd. Het leest zinsgrenzen, interpunctie en pauzes, getallen en datums, afkortingen, namen en regionale uitspraakaanwijzingen. Daarom verandert interpunctie de uitspraak. Voeg een komma toe, herschrijf een getal als woorden of schrijf een acroniem voluit, en de stem reageert.
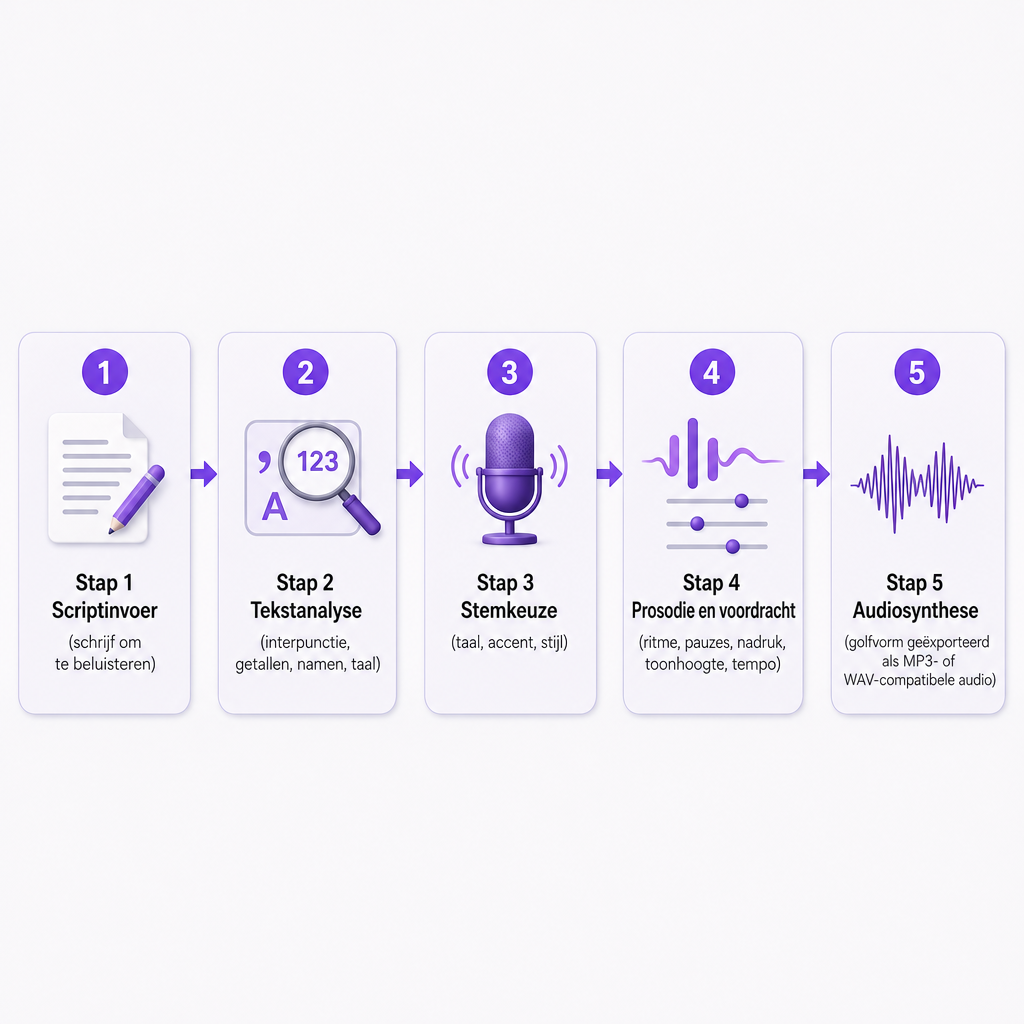
Dan kies je een stem. Stemmen verschillen qua taal, accent, leeftijd of vocaal karakter, genderpresentatie, spreekstijl, energie en formaliteit. Uitvoerinstellingen omvatten vaak spreeksnelheid, toonhoogte, volume en samplefrequentie. Voor een kanaal wint consistentie meestal van drama. Een herkenbare stem door meerdere video's heen laat het kanaal samenhangend aanvoelen, wat belangrijker is dan de meest theatrale optie kiezen voor een enkele upload.
De engine genereert vervolgens prosodie: het ritme, de pauzes, de nadruk, de toonhoogtebeweging en de intonatie die expressieve spraak onderscheiden van gelijkmatig verdeelde woorden. Sommige tools bieden deze bediening rechtstreeks aan; andere leiden ze af uit interpunctie, zinsstructuur of stijlinstructies. Hier verschijnen de meeste kwaliteitsverschillen. Een stem kan elk woord correct uitspreken en toch verkeerd aanvoelen als het tempo of de emotionele toon botst met de video.
Tot slot synthetiseert het model audio, waarbij de geanalyseerde tekst wordt omgezet in een golfvorm die de dienst teruggeeft als downloadbaar bestand. Een API-workflow kan gecodeerde audiodata teruggeven die je decodeert tot een afspeelbaar bestand, terwijl gehoste tools voor makers die stap voor je afhandelen. Zelfs dan is de voice-over geen afgerond product. Je plaatst hem nog steeds op de tijdlijn, knipt stilte weg, voegt muziek en effecten toe, stemt hem af op de beelden, balanceert niveaus, voegt ondertiteling toe en controleert uitspraak en timing. Voor een uitleg moet de stem de visuele volgorde volgen; een technisch schoon spoor voelt nog steeds slordig als de beelden veranderen voordat de bijbehorende zin begint. Als je het volledige neurale plaatje wilt, gaat onze uitleg over hoe neurale tekst naar spraak werkt dieper in op de interne werking van het model.
Vier productieroutes, en wanneer elk de beste keuze is
De meeste YouTube-voice-over komt neer op vier opties, en de juiste hangt af van wat de video nodig heeft in plaats van wat het meest geavanceerd klinkt in een preview.
| Route | Het beste voor | Belangrijkste afweging |
|---|---|---|
| Standaard AI-stem | Faceless kanalen, uitleganimaties, tutorials, nieuwsachtige samenvattingen, Shorts | Snel en betrouwbaar, maar niet gekoppeld aan een specifiek persoon |
| Aangepaste stemkloon | Eén herkenbare identiteit behouden over veel video's | Vereist een stem die je gemachtigd bent te reproduceren |
| Meertalige TTS of nasynchronisatie | Vertaalde uitleganimaties, gelokaliseerde productvideo's, tests in nieuwe markten | Vereist uitspraak- en culturele controle per taal |
| Menselijke voice-over | Genuanceerd acteren, getuigenissen, gevoelige of merkkritische bewoordingen | Trager en moeilijker op te schalen |
Een standaardstem uit de bibliotheek van een aanbieder is de snelste weg voor content in grote hoeveelheden waarbij de voice-over niet als één specifiek persoon hoeft te klinken. Aangepaste stemklonen bouwen een synthetische stem op uit een audiofragment, wat een maker helpt een consistente identiteit te behouden zonder elk script met de hand op te nemen. Gebruik klonen alleen met toestemming en met een stem die je het recht hebt te reproduceren; een kloon is geen omweg rond het bezitten van iemands identiteit of prestatie. Onze Tekst-naar-spraaktool geeft je toegang tot AI-stemmen en kloonworkflows, en onze Voice Cloning-pagina is de plek om te beginnen wanneer je een herbruikbare aangepaste verteller wilt in plaats van een standaardstem.
Met meertalige voice-over kun je een script vertalen en een nieuw stemspoor in een andere taal synthetiseren, wat handig is voor het laten groeien van een educatief kanaal in het buitenland, het lokaliseren van productvideo's of het testen van vraag in een nieuwe markt. TTS begint bij tekst; onze AI Dubbing-workflow voegt de bredere lokalisatielaag toe, inclusief vertaling en vervangende audio voor een bestaande video in 33 talen. Een menselijke verteller wint nog steeds wanneer de video leunt op genuanceerd acteren, persoonlijke getuigenissen, gevoelige onderwerpen, complexe humor, juridische of merkkritische bewoordingen, of de interpretatie van een onderscheidende performer. Veel kanalen draaien een hybride vorm: AI-voice-over voor concepten, versies en uploads in grote hoeveelheden, menselijke stem voor hun paradepaardjes.
Wanneer tekst naar spraak zijn plaats op een kanaal verdient
YouTube-TTS loont het meest wanneer je knelpunt opnemen is, niet schrijven. Als scripten gemakkelijk is maar het boeken van een opnamesessie het trage deel is, verwijdert synthetische voice-over de langzaamste stap.
Educatieve en instructieve video's profiteren rechtstreeks. Werk een script bij en genereer alleen het betreffende gedeelte opnieuw in plaats van een nieuwe opname te regelen, wat past bij softwaretutorials, onboarding en cursusmateriaal dat vaak verandert. Faceless kanalen kunnen video's van commentaar voorzien die zijn opgebouwd uit schermopnames, stockbeelden, animatie, slides of gegenereerde beelden, hoewel de stem nog steeds redactionele sturing nodig heeft; audio over niet-gerelateerde beelden ondermijnt het vertrouwen van de kijker. Shorts profiteren van een snelle omzetting van script naar audio, waardoor je meerdere hooks of doelgroepvariaties kunt testen, zolang de stem niet gehaast of repetitief klinkt.
Toegankelijkheid is een ander eerlijk gebruik. Een gesproken versie van geschreven content helpt kijkers die audio verkiezen of moeite hebben met tekst op het scherm, maar voice-over moet nauwkeurige ondertiteling en duidelijk visueel ontwerp aanvullen in plaats van vervangen. En voor meertalige uitbreiding kun je vertaalde stemsporen produceren zonder een afzonderlijk productieproces per taal te draaien. Met YouTube's functie voor meertalige audio kunnen geschikte makers extra audiosporen koppelen aan één video of Short in plaats van een afzonderlijk kanaal te beheren voor elke markt.
Een stem kiezen en testen voordat je je vastlegt
Beoordeel een stem aan de hand van de echte eisen van de video, niet aan een vleiende preview van tien seconden. Een stem die één regel perfect uitspreekt, kan over een volledig script uiteenvallen, dus zet hem eerst onder druk.
- Stem de stem af op het formaat. Een rustige uitspraak past bij een documentaire of tutorial; een energiekere stem past bij een korte hook of aankondiging. Laat het onderwerp, het tempo en de doelgroep beslissen.
- Test moeilijke woorden. Voordat je een volledige video genereert, laat je je terugkerende merknamen, plaatsnamen, acroniemen, wetenschappelijke termen, buitenlandse woorden, eenheden en persoonsnamen de revue passeren. Een stem die gewone zinnen aankan, kan struikelen over het vocabulaire van jouw kanaal.
- Controleer consistentie over langere stukken. Genereer een langer fragment en luister naar repetitieve intonatie, onjuiste pauzes, onnatuurlijk ritme, verschuivende uitspraak en abrupte paragraafovergangen.
- Houd rekening met regionale doelgroep. Engelse voice-over kan Amerikaanse, Britse, Australische of een andere uitspraak nodig hebben. Bevestig voor andere talen dat de stem natuurlijk klinkt voor een moedertaalspreker, niet alleen dat de tool de taal vermeldt.
- Bekijk de gebruiksrechten. Voordat je monetiseert of adverteert, lees je de voorwaarden van de aanbieder en bevestig je dat de stem en de uitvoer vrijgegeven zijn voor commerciële YouTube-content, klantwerk, betaalde advertenties en afgeleide versies.
Een paar schrijfgewoontes verhogen de kwaliteit ook snel. Schrijf voor spraak door dicht proza te vervangen door spreektaalzinnen en interpunctie te gebruiken om pauzes te sturen zonder erop te leunen voor emotie. Schrijf dubbelzinnige termen voluit zodat de engine ze correct leest, en test varianten zoals "AI" versus "A.I." of "2026" versus "twintig zesentwintig". Genereer in secties in plaats van één gigantisch bestand, zodat je een enkele fout opnieuw kunt genereren, scènes opnieuw kunt ordenen en audio op beeld kunt afstemmen. Voeg daarna menselijke bewerking toe: bekijk de volledige video terwijl het spoor speelt, knip ongemakkelijke pauzes weg, corrigeer timing en duck de muziek onder de spraak. AI bespaart opnametijd; het verwijdert redactionele controle niet.
Rechten, openbaarmaking en het uploaden van een tweede taalspoor
Het deel dat makers het vaakst overslaan is ook het deel dat video's offline laat halen. Als je een afzonderlijke taalversie bouwt, kun je die publiceren als een nieuwe video of YouTube's functie voor meertalige audio gebruiken waar beschikbaar, maar het platform maakt die nagesynchroniseerde sporen niet voor je. Makers moeten hun eigen audiobestanden voorbereiden en uploaden in een ondersteund audio-only-formaat, ongeveer even lang als de video. YouTube kan een secundair audiobestand ook verwijderen als de auteursrechtelijk beschermde inhoud ervan afwijkt van het origineel, waardoor rechtencontrole essentieel is wanneer je nagesynchroniseerde spoor muziek, clips of ander beschermd materiaal bevat.
Openbaarmaking is een afzonderlijke verplichting. YouTube vereist dat makers AI-gegenereerde of gewijzigde content openbaar maken die er realistisch uitziet, inclusief content die een echt persoon iets laat zeggen of doen wat hij niet deed, beelden van een echte gebeurtenis of plaats wijzigt, of een realistische scène fabriceert. Opvallend is dat YouTube het klonen van je eigen stem voor voice-overs of nasynchronisatie noemt onder voorbeelden die geen openbaarmaking vereisen onder dat specifieke beleid. Dat is geen licentie om de stem van iemand anders te klonen, en het labelen van synthetische content geeft geen toestemming om het gezicht of de stem van een ander persoon zonder toestemming te gebruiken.
Een veilig redactioneel beleid is om je eigen stem of een gelicentieerde stem te gebruiken, toestemmingsgegevens te bewaren voor aangepaste stemfragmenten, het imiteren van een echt persoon zonder toestemming te vermijden, voorwaarden voor commercieel gebruik te controleren, realistische synthetische of gewijzigde content openbaar te maken wanneer YouTube dat vereist, en de rechten op muziek, beeldmateriaal en vertaalde audio afzonderlijk te controleren. Voor teams die herhaaldelijk voice-over genereren vanuit een contentsysteem of app is onze Tekst-naar-spraak-API gebouwd voor programmatische spraakgeneratie, zodat je sporen in grote hoeveelheden kunt produceren zonder de workflow elke keer opnieuw op te bouwen.
Dus is YouTube tekst naar spraak de moeite waard? Het past uitstekend wanneer je herhaalbare voice-over, snelle revisies, meertalige versies of een voice-over zonder opnameapparatuur nodig hebt. Het past minder goed wanneer het succes van de video afhangt van genuanceerd acteren, persoonlijke getuigenissen of een juridisch gevoelige prestatie. De norm die telt, is niet of kijkers kunnen horen dat een stem synthetisch is. Het is of de voice-over helder, gepast, consistent, juridisch bruikbaar en goed geïntegreerd met de video is.
Veelgestelde vragen
Kan ik tekst-naar-spraak-audio gebruiken op YouTube?
Ja. Je kunt gegenereerde voice-over gebruiken in een YouTube-video zolang je de licentievoorwaarden van de TTS-aanbieder, het beleid van YouTube en de rechten verbonden aan je script, muziek, beeldmateriaal en stem respecteert.
Zet YouTube een script automatisch om in voice-over?
Nee. YouTube's functie voor meertalige audio maakt je nagesynchroniseerde sporen niet voor je. Makers moeten hun eigen audiobestanden voorbereiden en uploaden.
Wat is het verschil tussen YouTube tekst naar spraak en automatische nasynchronisatie?
Tekst naar spraak zet geschreven tekst om in gesproken audio. Automatische nasynchronisatie is een breder lokalisatieproces dat bestaande content kan vertalen en een vervangend taalspoor kan genereren. De exacte functies hangen af van het platform en de workflow.
Kan ik mijn stem klonen voor YouTube-video's?
Je kunt een stemkloon gebruiken wanneer je het recht hebt om die te maken en te gebruiken. YouTube noemt het klonen van je eigen stem voor voice-overs of nasynchronisatie als een voorbeeld dat geen openbaarmaking vereist onder zijn beleid voor realistische content, hoewel andere AI-gegenereerde of gewijzigde content nog steeds openbaarmaking kan vereisen.
Welk audiobestand moet ik uploaden voor een tweede taal?
Voor YouTube's functie voor meertalige audio moet het bestand in een ondersteund audio-only-formaat zijn en ongeveer even lang als de video. Controleer de huidige upload-interface van YouTube Studio voordat je exporteert.