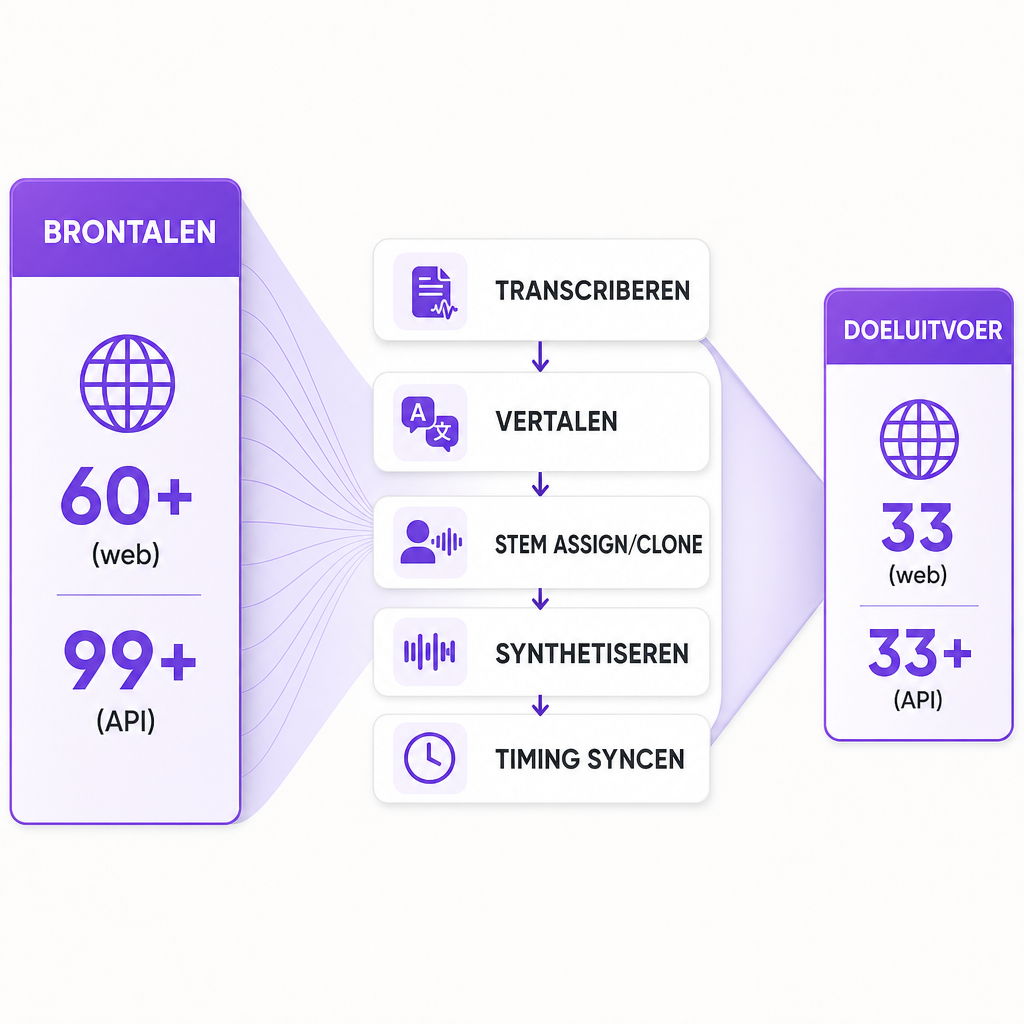
Als je een meertalige uitbreiding overweegt, is het eerste dat het waard is om duidelijk te krijgen: in welke talen kan AI inspreken met het platform dat je daadwerkelijk van plan bent te gebruiken. Het eerlijke antwoord heeft twee kanten: AI-nasynchronisatie kan gesproken inhoud herkennen in een lange lijst talen, maar de talen die het kan produceren als voltooide nagesynchroniseerde audio vormen een kortere, meer bepalende lijst. Met DubSmart AI synchroniseren we inhoud vanuit 60+ brontalen naar 33 doeltalen, en onze AI Dubbing API kan inhoud detecteren en verwerken vanuit 99+ brontalen terwijl die 33+ uitvoer in doeltalen genereert. Dat zijn niet dezelfde aantallen, en ze als uitwisselbaar behandelen is de meest voorkomende planningsfout die we zien.
Voordat je een productieschema vastzet rond een aantal vlaggetjes, helpt het om te begrijpen wat de cijfers betekenen, welke talen genoemd worden, hoe meertalige uitvoer eigenlijk werkt, en wat in elke taal nog menselijke beoordeling vereist.
Inhoudsopgave
Brontalen versus doeltalen
Het enige onderscheid dat het hele onderwerp bepaalt, is het verschil tussen invoer en uitvoer. Een brontaal is wat er in je oorspronkelijke bestand wordt gesproken. Een doeltaal is wat de voltooide nasynchronisatie spreekt. Een platform kan vrijwel altijd meer brontalen herkennen dan het als verzorgde uitvoer kan genereren, omdat transcriptie en vertaling gemakkelijker uit te breiden zijn dan een volledige bibliotheek van natuurlijk klinkende stemmen met correct timinggedrag.
Dat verschil is zichtbaar in onze eigen cijfers. Het web-product AI Dubbing vermeldt 60+ brontalen naar 33 doeltalen, terwijl de API-documentatie beschrijft dat inhoud wordt verwerkt vanuit 99+ brontalen naar 33+ uitvoer in doeltalen. Deze cijfers weerspiegelen verschillende productoppervlakken in plaats van één uitwisselbare statistiek, dus plan rond de doeltaallijst, niet rond het grotere herkenningsgetal.
| Categorie | Wat het betekent | Openbaar bewijs |
|---|---|---|
| Brontaal | Gesproken in het oorspronkelijke bestand | 60+ (web), 99+ (API) |
| Doeltaal | Gegenereerd voor de nasynchronisatie | 33 (web), 33+ (API) |
| Dialect / variant | Regionaal accent of vocabulaire | Breed ondersteund; geen volledige openbare lijst |
| Stemtaal | Wat een gekozen of gekloonde stem kan spreken | Afhankelijk van stem en projectopzet |
De praktische conclusie: als je origineel in een minder gangbare taal is, is herkenning zelden de bottleneck. De vraag die je moet bevestigen is of je beoogde uitvoertaal, en de specifieke regionale variant, beschikbaar is voor de stem die je wilt.
Welke doeltalen DubSmart noemt
We adverteren openbaar met nasynchronisatie naar 33 doeltalen, en de API-documentatie noemt expliciet een kernset met de opmerking "en nog veel meer". De genoemde talen zijn Engels, Portugees, Spaans, Frans, Duits, Chinees, Japans, Koreaans, Russisch, Arabisch en Hindi. Dit zijn bevestigde voorbeelden, niet de volledige catalogus.
Wat we niet publiceren op de openbare pagina's is de volledige lijst van 33 talen of een uitputtende dialectinventaris. Dus het nauwkeurige, niet-opgeblazen antwoord op de kernvraag is dit: we kunnen inspreken in 33 doeltalen, waarvan de elf bovenstaande met naam zijn bevestigd. Bevestig voor elke minder gangbare taal of een specifieke regionale variant de beschikbaarheid binnen het platform voordat je er een productieplanning aan verbindt.
AI-nasynchronisatie kan hier 33 doeltalen produceren, waaronder Engels, Portugees, Spaans, Frans, Duits, Chinees, Japans, Koreaans, Russisch, Arabisch en Hindi. Verifieer een minder gangbare taal of dialect in het project voordat je er een planning omheen maakt.
Die gewoonte om eerst te verifiëren is belangrijker dan het kopgetal. Dat een taal op een lijst verschijnt, belooft geen identieke aantallen stemmen, accenten of expressieve stijlen voor elk item.
Welke talen voor creators als eerste logisch zijn
Voor een in de VS gevestigd YouTube-kanaal komen de juiste eerste talen voort uit je publieksanalyses, niet uit de langst mogelijke lijst. Een handvol doeltalen bevat het grootste deel van de vroege kansen.
Spaans is meestal de logische eerste test, omdat het de Verenigde Staten, Mexico, Spanje en een groot deel van Latijns-Amerika bereikt. Beslis vroeg of je mikt op Latijns-Amerikaans of Europees Spaans, aangezien vocabulaire, humor en verwijzingen uiteenlopen. Portugees opent Brazilië en Portugal, en Braziliaans Portugees is doorgaans de schaalkeuze voor een Amerikaanse creator. Frans beslaat Frankrijk, Canada, België, Zwitserland en delen van Afrika, hoewel idiomen en uitspraakvoorkeuren tussen die markten verschuiven.
Duits past bij educatieve, software-, zakelijke en technische inhoud, met één kanttekening waar je op moet plannen: vertaalde Duitse zinnen zijn vaak langer dan het Engelse origineel, dus de timing moet mogelijk worden aangepast. Hindi kan sterk zijn voor educatieve en entertainmentinhoud gericht op India en wereldwijde Hindi-publieken, maar let op gemengde Hindi-Engelse uitdrukkingen en technische termen.
Chinees, Japans en Koreaans zijn van belang voor uitbreiding in Oost-Azië, waar beleefdheidsvormen, schrijfconventies en voordrachtstijl bepalen of het resultaat natuurlijk klinkt. Arabisch en Russisch dekken elk meerdere regio's, en vooral bij Arabisch bestaat er een reëel onderscheid tussen Modern Standaardarabisch en regionale varianten. Een taalmatch alleen garandeert nooit het juiste register.
Hoe één project meerdere talen wordt
Een moderne workflow produceert een afzonderlijke gelokaliseerde versie per doeltaal in plaats van één gemengde track. In onze API bevat één verzoek meerdere doelcodes, bijvoorbeeld Spaans, Frans en Duits als ["es", "fr", "de"], en de respons retourneert afzonderlijke groepsprojecten voor elke taal. Die structuur is wat een bureau of bedrijf in staat stelt om één masterbestand om te zetten in meerdere marktklare versies zonder opnieuw te uploaden.
Binnen een meertalig project kun je benaderingen mengen: een standaard synthetische stem overal voor consistentie, een andere natuurlijk klinkende stem per markt voor natuurlijkheid, een gekloonde stem waar je rechten hebt, of timing- en uitspraakaanpassingen per taal. De keuze komt meestal neer op één afweging: merkconsistentie versus lokale authenticiteit. Een gekloonde stem behoudt de identiteit van de spreker over markten heen; een marktspecifieke stem kan simpelweg meer thuisklinken bij een bepaald publiek.
Als je dit over veel assets plant, behandelt onze gids over het opschalen van contentproductie met AI hoe één master vele gelokaliseerde uitvoer wordt zonder je toolstack te vermenigvuldigen.
Kan de stem van de oorspronkelijke spreker over talen heen behouden blijven?
Ja, binnen grenzen en met verantwoordelijkheden. Onze AI Dubbing kan de stem van elke spreker klonen, en de AI Dubbing API ondersteunt het klonen van stemmen binnen de nasynchronisatieworkflow, waarbij eigenschappen zoals toon, toonhoogte, accent en spreekstijl worden geanalyseerd. Dat is wat een YouTube-presentator in elke taal herkenbaar houdt, een cursusdocent consistent over gelokaliseerde modules, of één woordvoerder coherent over markten heen.
Het verantwoordelijkheidsdeel staat niet ter discussie. Kloon alleen audio die je bezit of die je gemachtigd bent te verwerken. Houd voor merkgebonden, commerciële of publieke inhoud bij dat de spreker de kloon en het beoogde gebruik heeft goedgekeurd, vooral wanneer werknemers, acteurs, klanten of publieke figuren betrokken zijn. De beschikbaarheid van stemmen per taal verschilt ook, dus bevestig dat een gekloonde of gekozen stem je doeltaal daadwerkelijk spreekt voordat je er een seizoen of een cursus omheen bouwt.
Wat de nasynchronisatiekwaliteit per taal daadwerkelijk verandert
Taalbeschikbaarheid is het eerste filter, niet de eindstreep. Verschillende factoren werken samen om te bepalen of een nasynchronisatie natuurlijk klinkt of slechts accuraat is.
Vertaalcontext is waar letterlijke uitvoer faalt. Humor, idiomen, slogans en vakspecifieke termen hebben vaak een redacteur nodig om het vertaalde script te herzien voordat de audio wordt gegenereerd. Uitspraak van namen, acroniemen, producttermen en locaties moet vaak handmatig worden gecorrigeerd; een transcript kan grammaticaal perfect zijn en toch verkeerd klinken wanneer het hardop wordt uitgesproken.
Timing en spreeksnelheid zijn van belang omdat vertaalde zinnen zelden overeenkomen met de oorspronkelijke duur. Onze web-workflow bevat bewerkbare timings, en de Dubbing Studio laat je audio rekken of comprimeren om het passend te maken. Sprekeridentificatie houdt interviews, panels en films coherent; een verkeerd toegewezen stem beschadigt de continuïteit, zelfs wanneer de vertaling klopt. Dialecten en accenten worden niet gegarandeerd door een taallabel, en onze openbare pagina's noemen niet elk dialect. Ten slotte reikt culturele aanpassing verder dan de stemtrack: beoordeel voorbeelden, valuta, tekst op het scherm en calls to action afzonderlijk.
Materiaal met veel op het spel verdient extra zorg. Voeg voor medische, financiële, juridische, veiligheids- of nalevingsinhoud menselijke beoordeling in de doeltaal toe in plaats van op de eerste gegenereerde doorgang te vertrouwen.
Een taalstrategie afstemmen op je inhoud
Het beste plan hangt meer af van je publiek, inhoudstype en beoordelingsmiddelen dan van ruwe dekking. De onderstaande tabel koppelt veelvoorkomende situaties aan een verstandige aanpak.
| Situatie | Aanbevolen aanpak |
|---|---|
| Vraag testen | Lanceer één of twee kansrijke talen; vergelijk retentie en geografie van kijkers |
| Amerikaanse creator die mondiaal gaat | Test eerst Spaans, voeg daarna Portugees, Frans, Duits of een door analyses onderbouwde taal toe |
| Wereldwijd e-learning | Prioriteer talen in de lerendenbasis; beoordeel terminologie met een vakexpert |
| Marketingvideo | Lokaliseer script, tekst op het scherm en landingspagina, niet alleen de stem |
| Podcast met meerdere sprekers | Bevestig eerst sprekerdetectie, stemtoewijzing en achtergrondverwerking |
| API-lokalisatie op schaal | Verifieer taalcodes, stembeschikbaarheid, limieten, rechten en foutafhandeling |
Twee keuzes op clusterniveau liggen onder vrijwel elk plan. Ten eerste, nasynchronisatie versus ondertiteling: nasynchronisatie wint voor multitaskende kijkers, instructie-inhoud en meeslepende lokale-taalbranding, terwijl ondertitels winnen wanneer de oorspronkelijke voordracht belangrijk is of je snelle, laagdrempelige dekking over veel talen nodig hebt. Onze uiteenzetting van nasynchronisatie vs ondertiteling voor video behandelt die beslissing in de diepte. Ten tweede, voor teams die herhaalbare lanceringen uitvoeren houdt een checklist voor videolokalisatie ervoor dat taal, variant, timing, terminologie en toestemming elke keer worden beoordeeld in plaats van ad hoc.
Voordat je een nasynchronisatie uitbrengt, bevestig je dat de doeltaal overeenkomt met de markt, de regionale variant past, namen en technische termen correct zijn, sprekers consistent zijn toegewezen, de timing een gehaaste of gerekte voordracht vermijdt, tekst op het scherm gelokaliseerd is, de stemeigenaar toestemming heeft gegeven, en een beoordelaar op moedertaalniveau heeft goedgekeurd. Het gepubliceerde aantal talen is een dekkingssignaal, nooit een kwaliteitsgarantie.
Veelgestelde vragen
In welke talen kan AI inspreken met DubSmart?
We ondersteunen openbaar 33 doeltalen, waaronder Engels, Portugees, Spaans, Frans, Duits, Chinees, Japans, Koreaans, Russisch, Arabisch en Hindi. De volledige lijst van 33 talen en de volledige dialectinventaris worden niet gepubliceerd op onze openbare pagina's, dus bevestig een minder gangbare taal binnen het platform.
Kan één video tegelijk in meerdere talen worden nagesynchroniseerd?
Ja. Onze API accepteert meerdere doelcodes in één verzoek, zoals Spaans, Frans en Duits, en retourneert een afzonderlijk gelokaliseerd project voor elke taal vanuit één masterbestand.
Ondersteunt AI-nasynchronisatie dialecten en regionale accenten?
Dat kan, maar de beschikbaarheid verschilt per taal en stem. We ondersteunen een breed scala aan talen en dialecten en blijven uitbreiden, zonder een volledige dialectlijst te publiceren. Laat een moedertaalbeoordelaar uitspraak en register controleren voordat je opschaalt.
Is AI-nasynchronisatie hetzelfde als tekst-naar-spraak?
Nee. Tekst-naar-spraak zet aangeleverde tekst om in audio. AI-nasynchronisatie start vanuit bestaande video of audio en voegt transcriptie, vertaling, sprekerverwerking, stemgeneratie en synchronisatie samen in één workflow.
Zijn alle AI-nasynchronisatietalen even nauwkeurig?
Nee. De kwaliteit varieert met dialect, stem, audiokwaliteit, aantal sprekers, terminologie en vertaalcomplexiteit. Behandel het aantal doeltalen als dekking en verifieer vervolgens de exacte stem en variant voor jouw specifieke project.