Vraag hoe neurale tekst-naar-spraak werkt en het korte antwoord is dit: het zet geschreven tekst om in levensechte audio door je script door diepe neurale netwerken te sturen die modelleren hoe mensen daadwerkelijk spreken—uitspraak, ritme en intonatie samen. In plaats van vooraf opgenomen fragmenten aan elkaar te rijgen zoals oudere systemen deden, genereert neurale TTS spraak vanaf nul, waarbij het patronen rechtstreeks leert uit grote datasets van echte menselijke opnamen gekoppeld aan tekst. Dat onderscheid is de reden waarom moderne synthetische stemmen klinken als een verteller waar je naar een volledige video kunt luisteren, in plaats van een robotachtige aankondiging. Bij DubSmart AI bouwen we voort op deze zelfde neurale aanpak om onze Tekst-naar-Spraak aan te drijven, waarbij we het koppelen aan stemklonen en nasynchronisatie zodat één script van de ene taal naar vele kan reizen.
Deze gids doorloopt het mechanisme fase voor fase en vertaalt het vervolgens naar praktische beslissingen: waar een neurale stem sterk genoeg is om alleen te staan, waar je nog steeds een menselijke uitvoering wilt, en hoe de onderdelen binnen ons platform samenkomen.
Inhoudsopgave
Wat "hoe neurale tekst-naar-spraak werkt" werkelijk betekent
Neurale tekst-naar-spraak is een vorm van spraaksynthese die diepe neurale netwerken gebruikt om spraak vanaf nul te genereren. Het belangrijkste verschil met regelgebaseerde of concatenatieve methoden is dat het systeem leert van grote datasets van menselijke opnamen gekoppeld aan tekst, zodat het zowel kan voorspellen hoe woorden moeten klinken als hoe een persoon ze op natuurlijke wijze zou uitspreken. Dat aangeleerde gedrag legt de prosodie vast—klemtoon, ritme, pauzes en emotionele toon—waardoor de resulterende stem comfortabel is tijdens lange luistersessies. Grote cloudaanbieders beschrijven deze neurale stemmen als mensachtige gesynthetiseerde spraak waarvan de articulatie luistermoeheid vermindert in assistenten, toegankelijkheidstools en voorleeservaringen.
Onze Tekst-naar-Spraak-engine volgt dit neurale pad. Het analyseert je script, splitst het op in fonemen, leidt ritme en intonatie af en gebruikt vervolgens neurale modellen om vloeiende audio te renderen in plaats van de vlakke uitvoering die geassocieerd wordt met verouderde TTS. Het resultaat is realistische spraak die in seconden uit tekst wordt gegenereerd, gekozen uit een bibliotheek van 300+ stemmen afgestemd op verschillende tonen en toepassingen.
Waarom neurale TTS belangrijk is voor creators en teams
Voor YouTube-creators, kleine bedrijven, e-learningproducenten, filmmakers, podcasters en ontwikkelaars is de echte vraag niet alleen hoe de technologie werkt, maar of je erop moet vertrouwen in een productiepijplijn. Neurale TTS is belangrijk omdat het synthetische stemmen uit het "nuts"-domein haalt—GPS-aanwijzingen, basale prompts—en naar het domein van de performer brengt: goed genoeg om content te dragen, volledige cursussen te vertellen en merkboodschappen over te brengen zonder duidelijk kunstmatig te klinken. Combineer het met vertaling en nasynchronisatie en het wordt een vermenigvuldiger, waardoor één script tientallen talen kan bereiken tegen een fractie van de kosten en tijd van traditioneel studiowerk.
We hebben DubSmart precies rond die beslissing ontworpen. Tekst-naar-Spraak, Stemklonen, AI-Nasynchronisatie, Spraak-naar-Tekst, Spraakscheider, Tekst-naar-Afbeelding en Afbeelding-naar-Video zitten in één pijplijn, zodat gesproken content van upload naar meertalige export gaat zonder met aparte tools te jongleren. Je kiest hoeveel je automatiseert en hoeveel je aanpast in elke fase—script, stem, taal, mix—binnen één omgeving.
Waar dat uitkomt, hangt af van wat je maakt:
- Een YouTube-kanaal uitbreiden naar nieuwe talen: neurale TTS plus nasynchronisatie laat je scripts en timing hergebruiken terwijl je gelokaliseerde stemmen inwisselt.
- Marketing- of trainingsvideo's lokaliseren: je krijgt consistente merkvertelling in alle talen zonder voor elke update stemtalent te boeken.
- E-learning of bedrijfstrainingen produceren: langdurige vertelling wordt schaalbaar en gemakkelijk te herzien wanneer content verandert.
- Een podcast of onafhankelijke film runnen: je kunt meertalige versies, vertelinlassingen of toegankelijkheidstracks maken.
- Applicaties bouwen: onze API's maken van neurale spraak een aanroepbare service voor IVR's, agents en contenttools.
Het begrijpen van het mechanisme helpt je te beoordelen waar een neurale stem alleen kan staan en waar een menselijke opname de bron zou moeten blijven voor klonen of nasynchronisatie.
Onder de motorkap: de neurale TTS-pijplijn
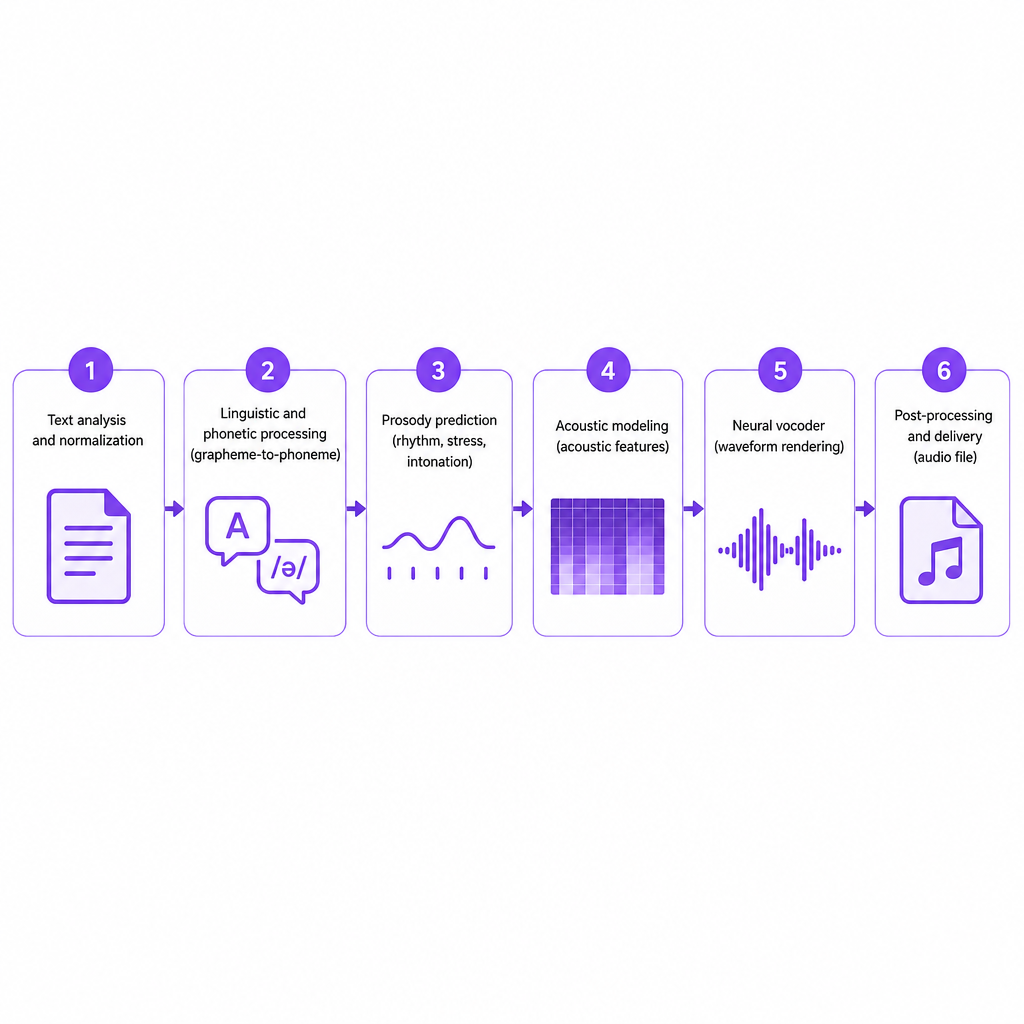
Engines verschillen in detail, maar ze delen een grotendeels vergelijkbare pijplijn beschreven in technische documentatie en verantwoorde AI-verklaringen van grote aanbieders, en onze eigen uitleg over hoe AI-voice-overs worden gemaakt sluit daarop aan.
Tekstanalyse en normalisatie
Eerst neemt het systeem je tekst op en normaliseert het naar een uitspreekbare vorm. Dat betekent het uitschrijven van getallen ("2026" wordt "twintig zesentwintig"), datums en afkortingen; het oplossen van dubbelzinnige tokens zoals "US" versus "us" op basis van context; en het lezen van interpunctie en structuur om pauzes en nadruk te plannen. Onze engine interpreteert interpunctie en structuur om ritme en flow af te leiden in plaats van tekst te behandelen als een vlakke tekenstroom. Deze fase draagt echt gewicht voor langere scripts—cursussen, uitlegvideo's, podcasts—waar paragraafstructuur en koppen bepalen hoe een mens het van nature zou lezen.
Linguïstische en fonetische verwerking
De genormaliseerde tekst wordt omgezet in fonemen, de basale klankeenheden van een taal. Een grafeem-naar-foneem-model koppelt tekens aan klanken, waarbij het uitspraakregels, uitzonderingen en meertalige invoer afhandelt. Dit is wat onze Tekst-naar-Spraak in staat stelt scripts in vele talen te accepteren en de juiste fonetische reeks voor de geselecteerde taal te produceren, of je nu een ingebouwde stem of een gekloonde stem gebruikt. Onze neurale stemmen ondersteunen meer dan 33 talen, waaronder Engels, Portugees, Spaans, Frans, Duits, Chinees en Japans.
Prosodievoorspelling
Prosodie—ritme, klemtoon en intonatie—is het verschil tussen een robotachtige stem en een mensachtige uitvoering. Neurale modellen leren prosodische patronen rechtstreeks van opnamen, zodat ze kunnen bepalen waar en hoe lang ze pauzeren, kiezen welke woorden nadruk krijgen, en toonhoogte en energie aanpassen over een zin of paragraaf. High-definition neurale stemmen gaan verder, door sentiment in de tekst te detecteren en de toon aan te passen terwijl ze een stabiele persona vasthouden, wat conversationele of empathische uitvoering mogelijk maakt voor supportcontent en vertelling. Onze engine leidt prosodie af voordat audio wordt gesynthetiseerd, om dezelfde reden: om vlakke uitvoering te vermijden en spraak te produceren waar je naar een hele module kunt luisteren.
Akoestische modellering
Zodra fonemen en prosodie zijn vastgesteld, zet een neuraal akoestisch model die representatie om in akoestische kenmerken—een blauwdruk voor de geluidsgolf. Verantwoorde AI-verklaringen merken op dat deze modellen naast opnamen van een specifiek stemtalent ook putten uit een bredere bronbibliotheek van vele sprekers. Die mix helpt het netwerk algemene spraakpatronen te leren terwijl het toch het timbre, accent en de stijl van een bepaalde stem vastlegt. In ons platform is deze modellering wat 300+ stemmen onderscheidend maar natuurlijk laat klinken, en het vormt de basis voor snel stemklonen, waarbij het systeem de akoestische en prosodische signatuur van een stem leert uit een kort fragment.
Vocoder en audiorendering
De akoestische kenmerken gaan naar een neurale vocoder, die ze rendert tot een volledige audiogolfvorm. Nieuwere vocoders produceren spraak van hoge kwaliteit die nauwelijks te onderscheiden is van studio-opnamen, met heldere medeklinkers, vloeiende klinkers en minimale artefacten. De combinatie van een neuraal akoestisch model plus vocoder is de reden waarom neurale stemmen veel natuurlijker klinken dan de oudere technologie die in traditionele schermlezers en IVR's wordt gebruikt. We gebruiken vergelijkbare vooruitgangen zodat gegenereerde audio klaar is om direct te publiceren of in een mix met muziek en geluidseffecten te plaatsen.
Nabewerking en levering
Ten slotte kan het systeem nabewerking toepassen—ruisvorming, luidheidsnormalisatie of formaatconversie—voordat het het audiobestand teruggeeft. Voor API-workflows wordt dit verpakt in een RESTful endpoint dat tekst- en stemparameters accepteert en een gebruiksklaar item retourneert. Onze Tekst-naar-Spraak volgt precies deze flow: plak of verstuur tekst, kies taal en stem, pas de uitvoering aan waar bedieningselementen beschikbaar zijn, genereer en download audio in standaardformaat. Dezelfde engine zit onder onze AI-Nasynchronisatie, waar transcriptie, vertaling en synthese aan elkaar gekoppeld zijn om meertalige versies te creëren.
Opties binnen DubSmart: stemmen, klonen, nasynchronisatie en API's
Het kennen van de mechanismen verklaart waarom onze functieset is gebouwd zoals hij is.
Tekst-naar-Spraak voor directe vertelling
Onze Tekst-naar-Spraak-tool is de kerninterface voor het omzetten van scripts naar audio. Je plakt of uploadt tekst in elke ondersteunde taal, kiest uit de 300+ natuurlijk klinkende stemmen, stelt taal en basale uitvoeringsinstellingen in waar beschikbaar, en genereert spraak in seconden. Het dekt YouTube-hooks en volledige videovertelling, uitleg- en promotievoice-overs voor kleine bedrijven, heldere e-learning- en trainingsmodules, en podcastintro's, -outro's en -mid-rolls. Als je tools voor die taak overweegt, laat ons overzicht van de beste AI-nasynchronisatiesoftware voor creators zien hoe vertelling en lokalisatie samenkomen.
Stemklonen: je merk- of hoststem behouden
Stemklonen bouwt voort op dezelfde neurale stappen—fonemen, prosodie, akoestische kenmerken—maar optimaliseert het netwerk om een specifiek timbre en stijl te evenaren, zodat je nieuwe regels in die stem kunt genereren zonder opnieuw op te nemen. Ons snelle stemklonen creëert aangepaste stemmen die je binnen Tekst-naar-Spraak of AI-Nasynchronisatie kunt gebruiken, wat betekent dat gelokaliseerde content nog steeds klinkt als je host, verteller of merk. Die continuïteit is het belangrijkst voor kanalen en bedrijven die hebben geïnvesteerd in een herkenbare stemidentiteit.
AI-Nasynchronisatie: het koppelen van spraak-naar-tekst, vertaling en TTS
AI-nasynchronisatie gebruikt de TTS-engine als de laatste stap in een langere keten: het transcriberen van bestaande audio, het vertalen van de transcriptie, en vervolgens het synthetiseren van nieuwe spraak in de doeltaal. Onze AI-Nasynchronisatie houdt nasynchronisatie, tekst-naar-spraak, spraak-naar-tekst en klonen binnen één workflow, zodat content van upload naar meertalige export gaat zonder het platform te verlaten. In de praktijk kun je een video of podcast uploaden, deze laten transcriberen en scheiden van achtergrondaudio, vertalen naar één of meer talen, en vervolgens nagesynchroniseerde tracks genereren met stock- of gekloonde stemmen die timing en toon behouden. Voor een uitleg over gesproken content, zie onze gids over hoe je een podcast naar een andere taal vertaalt.
API's voor ontwikkelaars en bureaus
We stellen neurale TTS en nasynchronisatie beschikbaar via API's zodat ontwikkelaars en bureaus stemgeneratie in hun eigen producten kunnen integreren. Onze Tekst-naar-Spraak API is een RESTful service die een POST-verzoek accepteert met tekstinhoud en stemvoorkeuren en audio van hoge kwaliteit retourneert, met toegang tot premium neurale stemmen in meer dan 33 talen. De AI-Nasynchronisatie API breidt dit uit naar geautomatiseerde meertalige nasynchronisatie. Voor bureaus die lokalisatie voor klanten afhandelen, standaardiseren deze endpoints stemgeneratie terwijl ze nog steeds talen en persona's per merk aanpassen.
Beslissingscriteria: neurale TTS goed kiezen en gebruiken
Zodra het mechanisme duidelijk is, is het praktische werk beslissen wanneer en hoe je het gebruikt.
Natuurlijkheid en luistercomfort. De kerntest is of de stem natuurlijk genoeg is voor je publiek om te accepteren als de hoofdverteller. Diepe neurale netwerken en HD-stemmen zijn gebouwd om luistermoeheid te verminderen, maar de juiste keuze hangt nog steeds af van het contenttype. Gebruik onze grote stembibliotheek om persona's te testen—energiek, kalm, speels, gezaghebbend—en geef voor langdurige cursussen of podcasts de voorkeur aan stemmen waarvan de prosodie conversationeel aanvoelt in plaats van aankondigingsachtig.
Taaldekking en accentpasvorm. Voor meertalige uitbreiding heb je zowel de taal als een accent nodig dat geschikt is voor het doelpubliek. Onze neurale stemmen omvatten meer dan 33 talen in belangrijke markten. Bij het kiezen van gelokaliseerde tracks, beslis of je een neutraal of regiospecifiek accent wilt, en test samples met moedertaalsprekers waar mogelijk.
Merkconsistentie versus flexibiliteit. Klonen draagt een specifieke stem over talen en projecten heen, maar introduceert verantwoordelijkheden rond toestemming en openbaarmaking. Gebruik het wanneer een consistente persona centraal staat in je merk, en documenteer wie die stem bezit en beheert—vooral in enterprise- of bureauwerk.
Workflow-integratie. Neurale TTS levert de meeste waarde wanneer het past in hoe je al werkt. Omdat onze tools tekst-naar-spraak, klonen, nasynchronisatie, spraak-naar-tekst en media-hulpmiddelen combineren, kun je veel van de lokalisatieketen automatiseren terwijl je nog steeds scripts en audio bewerkt. Solo-creators vinden de browsertools misschien voldoende; ontwikkelaars en bureaus krijgen programmeerbare endpoints om op te schalen.
Risico's, grenzen en verantwoord gebruik
Zelfs geavanceerde modellen hebben grenzen die het waard zijn om rond te plannen.
- Emotionele nuance: HD-stemmen reageren op sentiment, maar kunnen subtiele signalen of complexe uitvoeringen missen die een bekwame acteur zou leveren. Kritieke merkboodschappen of narratief drama kunnen nog steeds een menselijke opname als bron rechtvaardigen.
- Uitspraakuitzonderingen: Zeldzame namen, nieuwe termen of gemengde-taalscripts kunnen grafeem-naar-foneem-modellen uitdagen, dus bouw handmatige controles in.
- Kloonethiek: Verantwoorde AI-richtlijnen benadrukken dat aangepaste stemmen gebouwd en gebruikt moeten worden met expliciete toestemming, duidelijke contracten en openbaarmaking aan het publiek. Het imiteren van mensen zonder toestemming roept juridische en ethische zorgen op.
- Vooringenomenheid en representatie: Trainingsdata bepalen hoe stemmen accenten en dialecten afhandelen, dus controleer of je gekozen stemmen je publiek eerlijk vertegenwoordigen en het versterken van stereotypen vermijden.
Omdat onze geïntegreerde workflow het gemakkelijk maakt om synthetische spraak te genereren en in te zetten, is interne beoordeling belangrijker, niet minder—vooral wanneer je klant- of medewerkersstemmen verwerkt. Een concreet pad helpt: een creator kan één Engels script schrijven, een Engelse voice-over genereren en vervolgens Spaanse, Portugese en Duitse versies nasynchroniseren voor extra kanalen terwijl dezelfde timing en uitvoering behouden blijven. Een trainingsteam kan modulaire vertelling bouwen en deze snel opnieuw genereren wanneer het beleid verandert. Dat is de echte beloning van het begrijpen van de pijplijn—je weet welke fase je moet controleren en welke je aan het model kunt overlaten.
Veelgestelde vragen
Wat is neurale tekst-naar-spraak in eenvoudige termen?
Neurale tekst-naar-spraak is AI die geschreven tekst omzet in spraak met behulp van diepe neurale netwerken die zijn getraind op grote datasets van menselijke opnamen, waardoor stemmen worden geproduceerd die veel dichter bij echte mensen klinken dan oudere TTS-systemen.
Waarin verschilt DubSmart's Tekst-naar-Spraak van basale TTS?
We gebruiken neurale modellen die je script analyseren, prosodie afleiden en spraak vanaf nul synthetiseren, ondersteund door 300+ natuurlijke stemmen en snel stemklonen, zodat de output werkt als een primaire verteller voor video's, cursussen en podcasts.
Kan DubSmart mijn eigen stem behouden in andere talen?
Ja. Ons stemklonen kan je stem leren van opnamen en deze vervolgens gebruiken in tekst-naar-spraak en AI-nasynchronisatie, zodat gelokaliseerde versies van je content nog steeds klinken als jij of je merkverteller.
Hoe werkt AI-nasynchronisatie met neurale TTS?
AI-nasynchronisatie koppelt spraak-naar-tekst-transcriptie, vertaling en neurale tekst-naar-spraak, waarbij je bestaande audio wordt omgezet in meertalige nagesynchroniseerde tracks in één workflow, met behulp van stockstemmen of je gekloonde stem.
Is neurale tekst-naar-spraak veilig en ethisch om te gebruiken?
Gebruikt met toestemming, duidelijke openbaarmaking en passende waarborgen, is neurale TTS een sterk hulpmiddel voor toegankelijkheid en lokalisatie. Verantwoorde AI-richtlijnen benadrukken het respecteren van de rechten van stemtalent en het vermijden van misleidend gebruik van synthetische stemmen.