スクリプトをYouTubeのナレーションに変えるには、かつてはマイクと静かな部屋、そして数え切れないほどの録り直しが必要でした。今ではyoutube text to speechを使えば、スクリプトを貼り付け、音声を選び、動画やShorts、チュートリアル、あるいはすでに公開したアップロードの翻訳版に組み込めるナレーションをエクスポートできます。本当の判断は、合成音声をそもそも使うかどうかではありません。それは、目の前にある特定の動画に合う制作方法はどれか、つまりストックのAI音声か、カスタムのクローンか、人間による録音か、あるいはその三つの組み合わせか、ということです。
このガイドでは、この技術が実際にどう機能するのか、どのワークフローがさまざまなチャンネルの目標に合うのか、そして公開ボタンを押す前に権利と開示について何を確認すべきかを説明します。これは音声と文字起こしに関する幅広い解説記事のハブであり、一つのトピックが独自のページに値する場合には、より深掘りした記事へのリンクを見つけられます。
目次
YouTube text to speechが実際に意味すること
YouTube text to speechとは、単にテキスト読み上げ技術を使ってYouTubeコンテンツのナレーションを生成することです。スクリプトを用意し、音声と言語を選び、どのように話させるかを調整し、編集またはアップロードできる音声ファイルをエクスポートします。内部では、TTSシステムがテキスト、またはSpeech Synthesis Markup Language(SSML)を、動画やその他のメディアに追加できるMP3やWAV互換の音声といった音声データに変換します。
二つの区別でほとんどの混乱は解消されます。キャプションはTTSと逆の仕事をします。キャプションは話された音声をテキストに変えますが、テキスト読み上げは書かれたテキストを話し音声に変えます。吹き替えはさらに広い概念です。TTSは通常、書かれたスクリプトから始めて新しい音声トラックを生成しますが、吹き替えは一般に既存の動画を翻訳し、置き換える音声を元のタイミングと意味に合わせます。こうした境界がワークフローにとって重要であれば、AIが吹き替えできる言語に関する解説記事がローカライゼーションの側面を詳しく扱っています。
合成パイプラインがスクリプトを音声に変える仕組み
TTSシステムは4つの要素を組み合わせます。あなたのスクリプト、選択された音声モデル、言語情報、そして話し方の制御です。これらから、短い手順を経て処理が進みます。この手順を理解すると、同じ文章でも書き方次第で素晴らしく聞こえたり不自然に聞こえたりする理由が分かります。
まずはテキスト入力です。これは完全なYouTubeスクリプトであったり、ナレーションに展開されたアウトラインであったり、既存のスクリプトの翻訳版であったり、ボイスオーバーに作り変えられたキャプションであったりします。入力の品質が出力の品質を左右します。長い文章、説明のない略語、珍しい名前、乱雑な句読点は、優れた音声でも不自然に聞こえさせることがあります。解決策は、黙読ではなくリスニングを意識して書くことです。より短い文章、明確な接続、意図的な間です。
次にエンジンがテキストを分析し、単語をどう発音し、どうまとめるかを判断します。文の境界、句読点と間、数字と日付、略語、名前、地域的な発音の手がかりを読み取ります。これが句読点によって話し方が変わる理由です。カンマを加えたり、数字を単語に書き換えたり、頭字語をスペルアウトしたりすると、音声はそれに反応します。
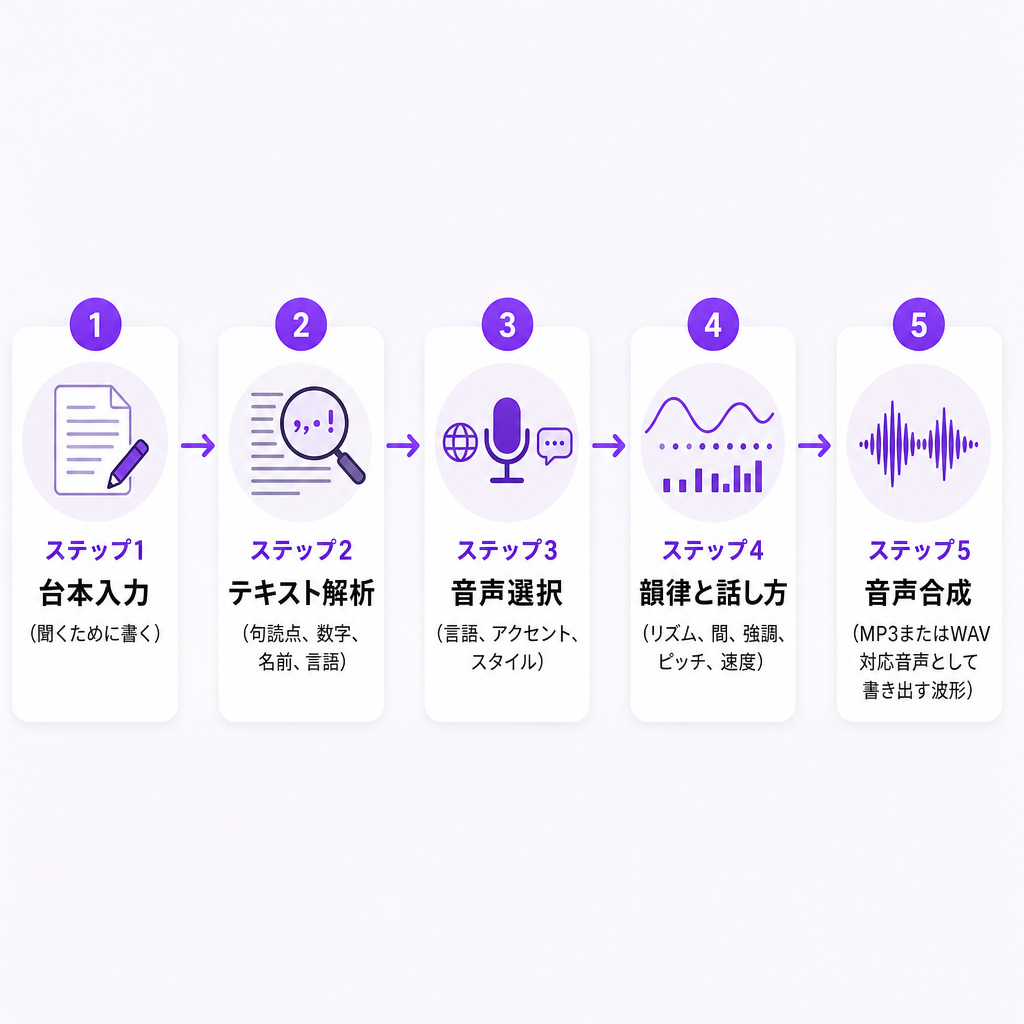
次に音声を選びます。音声は言語、アクセント、年齢や声質、性別表現、話し方のスタイル、エネルギー、フォーマルさによって異なります。出力設定には多くの場合、話す速度、ピッチ、音量、サンプルレートが含まれます。チャンネルにとっては、一貫性がドラマ性に勝るのが普通です。複数の動画にわたって運ばれる認識しやすい音声は、チャンネルに統一感をもたらします。これは単一のアップロードのために最も芝居がかった選択肢を選ぶことよりも重要です。
次にエンジンはプロソディを生成します。これはリズム、間、強調、ピッチの動き、イントネーションであり、表現豊かな発話を均等に並んだ単語と区別するものです。これらの制御を直接公開するツールもあれば、句読点、文構造、スタイル指示から推測するツールもあります。ここで品質の差が最も現れます。すべての単語を正しく発音できる音声でも、ペースや感情のトーンが動画と合わなければ、間違っているように感じられます。
最後にモデルが音声を合成し、分析されたテキストを波形に変換して、サービスはそれをダウンロード可能なファイルとして返します。APIワークフローでは、再生可能なファイルにデコードするエンコードされた音声データが返されることがありますが、ホスト型のクリエイターツールはそのステップを代わりに処理してくれます。それでも、ナレーションは完成した動画ではありません。タイムラインに配置し、無音部分をカットし、音楽と効果音を加え、映像に合わせ、レベルを調整し、キャプションを追加し、発音とタイミングを確認する必要があります。解説動画では、音声は視覚的な順序に従うべきです。技術的にクリーンなトラックでも、一致する文が始まる前に映像が変わってしまうと、雑に感じられます。ニューラルの全体像を知りたい場合は、ニューラルテキスト読み上げの仕組みに関する解説がモデル内部をより深く掘り下げています。
4つの制作ルートと、それぞれが有利になる場面
ほとんどのYouTubeナレーションは4つの選択肢に絞られ、正しい選択はプレビューで最も先進的に聞こえるものではなく、動画が必要とするものによって決まります。
| ルート | 最適な用途 | 主なトレードオフ |
|---|---|---|
| 標準AI音声 | 顔出しなしチャンネル、解説動画、チュートリアル、ニュース風の要約、Shorts | 速くて信頼できるが、特定の人物に結びつかない |
| カスタム音声クローン | 多数の動画にわたって認識しやすい一つのアイデンティティを保つ | 再現する権利を持つ音声が必要 |
| 多言語TTSまたは吹き替え | 翻訳された解説動画、ローカライズされた製品動画、新市場テスト | 言語ごとに発音と文化的なレビューが必要 |
| 人間によるボイスオーバー | 繊細な演技、証言、センシティブまたはブランドに関わる重要な表現 | より遅く、拡張が難しい |
プロバイダーのライブラリから選んだ標準音声は、ナレーションが特定の人物のように聞こえる必要がない大量コンテンツにとって最速の方法です。カスタム音声クローンは音声サンプルから合成音声を作り、クリエイターがすべてのスクリプトを手作業で録音することなく一貫したアイデンティティを保つのに役立ちます。クローンは許可を得て、再現する権利を持つ音声でのみ使用してください。クローンは、誰かのアイデンティティやパフォーマンスを所有することの近道ではありません。当社のテキスト読み上げツールはAI音声とクローン作成のワークフローへのアクセスを提供し、当社の音声クローンページは、ストック音声ではなく再利用可能なカスタムナレーターが欲しいときに始める場所です。
多言語ナレーションでは、スクリプトを翻訳し、別の言語で新しい音声トラックを合成できます。これは教育チャンネルを海外で成長させたり、製品動画をローカライズしたり、新市場で需要をテストしたりするのに役立ちます。TTSはテキストから始まります。当社のAI吹き替えワークフローは、既存の動画の33言語にわたる翻訳と置き換え音声を含む、より広いローカライゼーションの層を加えます。動画が繊細な演技、個人的な証言、センシティブな題材、複雑なユーモア、法的またはブランドに関わる重要な表現、あるいは独特なパフォーマーの解釈に依存する場合は、人間のナレーターが依然として勝ります。多くのチャンネルがハイブリッドを採用しています。下書き、バージョン、大量アップロードにはAIナレーションを、看板動画には人間の音声を使います。
テキスト読み上げがチャンネルで役立つとき
YouTube TTSが最も効果を発揮するのは、ボトルネックが録音であって書くことではない場合です。スクリプト作成は簡単でも録音セッションの予約が遅い部分であるなら、合成ナレーションが最も遅いステップを取り除きます。
教育動画や指導動画は直接的な恩恵を受けます。新しい録音を手配する代わりに、スクリプトを更新して影響を受けたセクションだけを再生成できます。これは頻繁に変わるソフトウェアチュートリアル、オンボーディング、コースコンテンツに向いています。顔出しなしのチャンネルは、画面録画、ストック映像、アニメーション、スライド、生成された映像から作られた動画にナレーションを付けられますが、音声には依然として編集上の指示が必要です。無関係な映像に乗せられた音声は視聴者の信頼を損ないます。Shortsはスクリプトから音声への素早い変換の恩恵を受け、音声が急いでいたり繰り返しに聞こえたりしない限り、複数のフックやオーディエンスのバリエーションをテストできます。
アクセシビリティもまた誠実な使い方です。書かれたコンテンツの音声版は、音声を好む視聴者や画面上のテキストが苦手な視聴者に役立ちますが、ナレーションは正確なキャプションや明確な視覚デザインを置き換えるのではなく、補完すべきです。そして多言語展開では、言語ごとに別々の制作プロセスを走らせることなく翻訳された音声トラックを制作できます。YouTubeの多言語音声機能では、対象となるクリエイターが市場ごとに別のチャンネルを管理する代わりに、一つの動画やShortに追加の音声トラックを付けられます。
決める前に音声を選び、テストする
音声は、好印象を与える10秒のプレビューではなく、動画の実際の要件に照らして判断してください。1行をうまくこなす音声でも、スクリプト全体にわたると崩れることがあるので、まず負荷テストをしましょう。
- 音声をフォーマットに合わせる。落ち着いた話し方はドキュメンタリーやチュートリアルに向き、より高エネルギーの音声は短尺のフックやお知らせに合います。題材、ペース、オーディエンスに決めさせましょう。
- 難しい単語をテストする。完全な動画を生成する前に、繰り返し出てくるブランド名、地名、頭字語、科学用語、外国語、単位、人名を試してください。普通の文章をこなせる音声でも、あなたのチャンネルの語彙でつまずくことがあります。
- 長尺での一貫性を確認する。より長いサンプルを生成し、繰り返しのイントネーション、誤った間、不自然なリズム、変化する発音、唐突な段落の移行がないか聞いてください。
- 地域のオーディエンスを考慮する。英語のナレーションにはアメリカ、イギリス、オーストラリア、あるいは別の発音が必要かもしれません。他の言語では、ツールがその言語をリストに載せているだけでなく、ネイティブの耳に自然に聞こえることを確認してください。
- 使用権を確認する。収益化または広告を出す前に、プロバイダーの規約を読み、その音声と出力が商用YouTubeコンテンツ、クライアント業務、有料広告、派生版に対してクリアされていることを確認してください。
いくつかの書き方の習慣も素早く品質を高めます。濃密な文章を会話的な文章に置き換え、感情のために頼るのではなく句読点を使って間を導くことで、発話を意識して書きましょう。あいまいな用語はスペルアウトしてエンジンが正しく読むようにし、「AI」対「A.I.」や「2026」対「twenty twenty-six」のようなバリエーションをテストしてください。一つの巨大なファイルではなくセクションごとに生成すれば、単一の誤りを再生成し、シーンを並べ替え、音声を映像に合わせられます。そして人間による編集を加えましょう。トラックを再生しながら動画全体を見て、ぎこちない間をカットし、タイミングを修正し、音楽を発話の下に抑えます。AIは録音時間を削減しますが、編集上のレビューを取り除くものではありません。
権利、開示、そして第二言語トラックのアップロード
クリエイターが最も飛ばしがちな部分は、動画が削除される原因になる部分でもあります。別の言語版を作る場合、新しい動画として公開するか、利用可能であればYouTubeの多言語音声機能を使えますが、プラットフォームがそれらの吹き替えトラックを作ってくれるわけではありません。クリエイターは、動画とほぼ同じ長さの、サポートされている音声のみの形式で自分の音声ファイルを準備してアップロードしなければなりません。YouTubeは、二次音声ファイルの著作権保護されたコンテンツが元のものと異なる場合、そのファイルを削除することもあります。このため、吹き替えトラックに音楽、クリップ、その他の保護された素材が含まれる場合、権利のレビューが不可欠です。
開示は別の義務です。YouTubeは、現実的に見えるAI生成または改変されたコンテンツの開示をクリエイターに義務づけています。これには、実在の人物が実際には言っていない、またはしていないことを言ったりしたりしているように見せるコンテンツ、実在のイベントや場所の映像を改変したコンテンツ、現実的なシーンを捏造したコンテンツが含まれます。注目すべきは、YouTubeがボイスオーバーや吹き替えのために自分自身の音声をクローンすることを、その特定のポリシーの下で開示を必要としない例の一つとして挙げていることです。これは他人の音声をクローンするライセンスではなく、合成コンテンツにラベルを付けることが、許可なく他人の顔や音声を使うことを認めるものではありません。
安全な編集方針は、自分自身の音声またはライセンスされた音声を使い、カスタム音声サンプルについては許可の記録を保持し、許可なく実在の人物を模倣することを避け、商用利用の規約を確認し、YouTubeが求める場合は現実的な合成または改変コンテンツを開示し、音楽、映像、翻訳された音声の権利を個別にレビューすることです。コンテンツシステムやアプリから繰り返しナレーションを生成するチームのために、当社のテキスト読み上げAPIはプログラムによる音声生成のために作られており、毎回ワークフローを作り直すことなく大量にトラックを制作できます。
では、YouTube text to speechは価値があるのでしょうか?繰り返し使えるナレーション、素早い修正、多言語版、または録音機材なしのボイスオーバーが必要なときには、強く適合します。動画の成功が繊細な演技、個人的な証言、法的にセンシティブなパフォーマンスにかかっているときには、適合度は低くなります。重要な基準は、視聴者が音声が合成だと見分けられるかどうかではありません。ナレーションが明確で、適切で、一貫していて、法的に使用可能で、動画とよく統合されているかどうかです。
よくある質問
YouTubeでテキスト読み上げ音声を使えますか?
はい。TTSプロバイダーのライセンス規約、YouTubeのポリシー、そしてあなたのスクリプト、音楽、映像、音声に結びついた権利を尊重する限り、生成されたナレーションをYouTube動画で使用できます。
YouTubeは自動的にスクリプトをナレーションに変えますか?
いいえ。YouTubeの多言語音声機能は、吹き替えトラックを代わりに作ってくれません。クリエイターは自分の音声ファイルを準備してアップロードしなければなりません。
YouTube text to speechと自動吹き替えの違いは何ですか?
テキスト読み上げは書かれたテキストを話し音声に変換します。自動吹き替えはより広いローカライゼーションのプロセスで、既存のコンテンツを翻訳し、置き換え言語のトラックを生成することがあります。正確な機能はプラットフォームとワークフローによります。
YouTube動画のために自分の音声をクローンできますか?
それを作成し使用する権利を持っている場合、音声クローンを使用できます。YouTubeはボイスオーバーや吹き替えのために自分自身の音声をクローンすることを、現実的なコンテンツのポリシーの下で開示を必要としない例として挙げていますが、他のAI生成または改変コンテンツは依然として開示が必要な場合があります。
第二言語のためにどの音声ファイルをアップロードすべきですか?
YouTubeの多言語音声機能の場合、ファイルはサポートされている音声のみの形式で、動画とほぼ同じ長さである必要があります。エクスポートする前に、YouTube Studioの現在のアップロードインターフェースを確認してください。