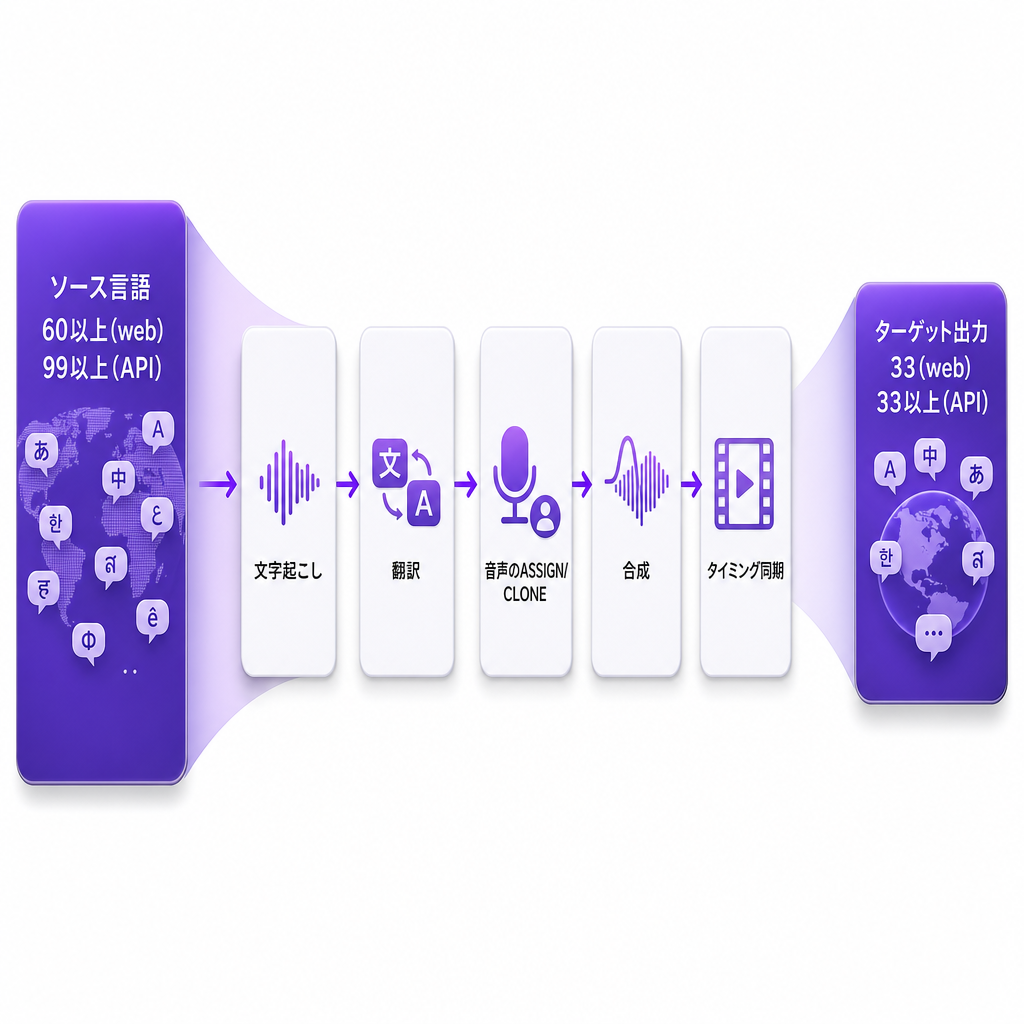
多言語展開を検討しているなら、まず最初に明確にすべきは、実際に使う予定のプラットフォームでAIがどの言語に吹き替えできるのかということです。正直なところ、答えは2つの側面に分かれます。AI吹き替えは長いリストの言語で話された内容を認識できますが、完成した吹き替え音声として生成できる言語は、より短く、より決定的なリストになります。DubSmart AIでは、60以上のソース言語から33のターゲット言語へコンテンツを吹き替え、AI Dubbing APIは99以上のソース言語からコンテンツを検出・処理し、33以上のターゲット言語の出力を生成できます。これらは同じ数字ではなく、互換性があるものとして扱うことが、私たちがよく目にする最も一般的な計画ミスです。
フラグの数を基準に制作スケジュールを固める前に、それらの数字が何を意味するのか、どの言語が挙げられているのか、多言語出力が実際にどのように機能するのか、そしてすべての言語でどこに人間によるレビューが必要かを理解しておくと役立ちます。
目次
ソース言語とターゲット言語
このトピック全体を左右する唯一の区別は、入力と出力の違いです。ソース言語とは、元のファイルで話されている言語のことです。ターゲット言語とは、完成した吹き替えが話す言語のことです。プラットフォームは、磨き上げられた出力として生成できる言語よりも、認識できるソース言語の方がほぼ常に多くなります。なぜなら、文字起こしと翻訳は、正しいタイミング動作を備えた自然な声の完全なライブラリよりも拡張しやすいからです。
そのギャップは私たち自身の数字にも表れています。Web版のAI Dubbing製品は60以上のソース言語から33のターゲットと述べていますが、APIドキュメントは99以上のソース言語から33以上のターゲット出力へのコンテンツ処理を説明しています。これらの数字は、1つの互換性ある統計ではなく、異なる製品の側面を反映しているため、より大きな認識数ではなくターゲットリストを基準に計画してください。
| カテゴリ | 意味 | 公開されている根拠 |
|---|---|---|
| ソース言語 | 元のファイルで話されている言語 | 60以上(Web)、99以上(API) |
| ターゲット言語 | 吹き替え用に生成される言語 | 33(Web)、33以上(API) |
| 方言/バリアント | 地域的なアクセントや語彙 | 広くサポート、完全な公開リストはなし |
| 声の言語 | 選択またはクローンした声が話せる言語 | 声とプロジェクト設定による |
実践的な要点は次のとおりです。元の素材があまり一般的でない言語の場合、認識がボトルネックになることはめったにありません。確認すべき問題は、意図した出力言語、そして特定の地域バリアントが、使いたい声で利用可能かどうかです。
DubSmartが明示するターゲット言語
私たちは33のターゲット言語への吹き替えを公に宣伝しており、APIドキュメントでは「さらに多数」と注記しつつ中核的なセットを明示的に挙げています。挙げられている言語は、英語、ポルトガル語、スペイン語、フランス語、ドイツ語、中国語、日本語、韓国語、ロシア語、アラビア語、ヒンディー語です。これらは確認済みの例であり、カタログの全体ではありません。
公開ページに掲載していないのは、完全な33言語一覧や網羅的な方言一覧です。したがって、中核的な質問への正確で誇張のない答えはこうです。私たちは33のターゲット言語に吹き替えでき、そのうち上記の11言語は名称で確認されています。あまり一般的でない言語や特定の地域バリアントについては、制作スケジュールを割り当てる前に、プラットフォーム内で利用可能性を確認してください。
AI吹き替えはここで33のターゲット言語を生成でき、英語、ポルトガル語、スペイン語、フランス語、ドイツ語、中国語、日本語、韓国語、ロシア語、アラビア語、ヒンディー語を含みます。あまり一般的でない言語や方言については、スケジュールを組む前にプロジェクト内で確認してください。
その「まず確認する」習慣は、見出しの数字よりも重要です。言語がリストに載っているからといって、すべての項目で同一の声の数、アクセント、または表現スタイルが保証されるわけではありません。
クリエイターがまず取り組むべき言語
米国を拠点とするYouTubeチャンネルの場合、最初に取り組むべき言語は、可能な限り長いリストからではなく、視聴者分析から導き出されます。わずかな数のターゲットが、初期の機会の大半を占めます。
スペイン語は通常、論理的な最初のテストです。なぜなら米国、メキシコ、スペイン、そしてラテンアメリカの大部分に届くからです。ラテンアメリカ向けか欧州向けのスペイン語を狙うかを早めに決めてください。語彙、ユーモア、言及される内容が異なるためです。ポルトガル語はブラジルとポルトガルを開拓し、ブラジル・ポルトガル語は米国のクリエイターにとって通常スケールの選択肢です。フランス語はフランス、カナダ、ベルギー、スイス、アフリカの一部に広がりますが、慣用句や発音の好みはそれらの市場間で変化します。
ドイツ語は教育、ソフトウェア、ビジネス、技術系コンテンツに適していますが、計画に入れておくべき注意点が1つあります。翻訳されたドイツ語のフレーズは元の英語より長くなることが多いため、タイミングの調整が必要になる場合があります。ヒンディー語はインドやグローバルなヒンディー語視聴者をターゲットにした教育・エンターテインメントコンテンツに強力ですが、ヒンディー語と英語の混在表現や技術用語に注意してください。
中国語、日本語、韓国語は東アジア展開にとって重要で、敬語、表記慣習、話し方のスタイルが、結果がネイティブに聞こえるかどうかを決定します。アラビア語とロシア語はそれぞれ複数の地域をカバーし、特にアラビア語は現代標準アラビア語と地域バリアントの間に実際の違いがあります。言語が一致するだけでは、適切な言語レジスターが保証されることは決してありません。
1つのプロジェクトが複数言語になる仕組み
現代のワークフローは、1つの混合トラックではなく、ターゲット言語ごとに別々のローカライズ版を生成します。私たちのAPIでは、1つのリクエストが複数のターゲットコードを含み、例えばスペイン語、フランス語、ドイツ語を["es", "fr", "de"]として指定すると、レスポンスは各言語ごとに別々のグループプロジェクトを返します。その構造により、エージェンシーや企業は再アップロードすることなく、1つのマスターファイルを複数の市場対応版に変えることができます。
多言語プロジェクト内では、アプローチを組み合わせることができます。一貫性のためにどこでも標準的な合成音声を使う、自然さのために市場ごとに異なるネイティブらしい声を使う、権利を保有している場合はクローンされた声を使う、または言語ごとのタイミングや発音の調整を行う、といった具合です。選択は通常、1つのトレードオフに帰結します。ブランドの一貫性か、現地の信憑性かです。クローンされた声は複数市場にわたって話者のアイデンティティを保ち、市場固有の声は特定の視聴者にとってより親しみやすく聞こえることがあります。
これを多数のアセットにわたって計画している場合、AIによるコンテンツ制作のスケーリングに関する当社のガイドが、ツールスタックを増やすことなく1つのマスターを多数のローカライズ出力に変える方法を解説しています。
元の話者の声を複数言語にわたって維持できるか?
はい、ただし制限があり、責任を伴います。当社のAI Dubbingは各話者の声をクローンでき、AI Dubbing APIは吹き替えワークフロー内での音声クローンをサポートし、トーン、ピッチ、アクセント、話し方のスタイルといった特徴を分析します。それにより、YouTubeのホストがあらゆる言語で認識可能に保たれ、コースの講師がローカライズされたモジュール全体で一貫し、1人のスポークスパーソンが複数市場にわたって一貫します。
責任の部分は譲れません。所有している、または処理する権限がある音声のみをクローンしてください。ブランド化された、商業的な、または一般公開されるコンテンツについては、特に従業員、俳優、顧客、公人が関わる場合、話者がクローンとその意図された用途を承認したことの記録を保管してください。言語による声の利用可能性も異なるため、シーズンやコースを構築する前に、クローンまたは選択した声が実際にターゲット言語を話せるかどうかを確認してください。
言語ごとに吹き替え品質を実際に左右するもの
言語の利用可能性は最初のフィルターであり、ゴールではありません。吹き替えがネイティブに聞こえるか、単に正確なだけかを決定するために、いくつかの要因が相互に作用します。
翻訳のコンテキストは、逐語的な出力が失敗する部分です。ユーモア、慣用句、スローガン、専門用語は、音声が生成される前に、翻訳されたスクリプトを編集者が修正する必要があることがよくあります。名前、頭字語、製品用語、場所の発音は手動での修正が頻繁に必要です。文字起こしが文法的に完璧でも、声に出すと間違って聞こえることがあります。
タイミングと話速は重要です。翻訳された文が元の長さに一致することはめったにないからです。当社のWebワークフローには編集可能なタイミングが含まれており、Dubbing Studioでは音声を引き伸ばしたり圧縮したりして合わせることができます。話者識別はインタビュー、パネルディスカッション、映画の一貫性を保ちます。翻訳が正しくても、割り当てが誤った声は連続性を損ないます。方言とアクセントは言語ラベルによって保証されるものではなく、当社の公開ページはすべての方言を列挙していません。最後に、文化的適応は声のトラックを超えて及びます。例、通貨、画面上のテキスト、行動喚起を個別にレビューしてください。
リスクの高い素材には特別な注意が必要です。医療、金融、法律、安全、またはコンプライアンスのコンテンツについては、最初に生成されたパスを信頼するのではなく、ターゲット言語での人間によるレビューを追加してください。
コンテンツに言語戦略を合わせる
最適な計画は、生のカバー範囲よりも、視聴者、コンテンツの種類、レビューリソースに依存します。以下の表は、一般的な状況を賢明なアプローチに対応づけています。
| 状況 | 推奨アプローチ |
|---|---|
| 需要のテスト | 可能性の高い1〜2言語をローンチし、視聴維持率と視聴者の地理を比較する |
| グローバル展開する米国クリエイター | まずスペイン語をテストし、その後ポルトガル語、フランス語、ドイツ語、または分析に裏付けられた言語を追加する |
| グローバルなeラーニング | 学習者層の言語を優先し、専門家と用語をレビューする |
| マーケティング動画 | 声だけでなく、スクリプト、画面上のテキスト、ランディングページをローカライズする |
| 複数話者のポッドキャスト | まず話者検出、声の割り当て、背景処理を確認する |
| APIによる大規模なローカライゼーション | 言語コード、声の利用可能性、制限、権利、エラー処理を検証する |
ほぼすべての計画の根底には、2つのクラスターレベルの選択があります。第一に、吹き替えか字幕か。吹き替えは、ながら視聴する視聴者、教育コンテンツ、没入感のある現地語ブランディングに有利ですが、字幕は元のパフォーマンスが重要な場合や、多数の言語で迅速かつ低負荷なカバーが必要な場合に有利です。動画における吹き替え対字幕の分析では、その決定を詳しく解説しています。第二に、繰り返し可能なローンチを運用するチームには、動画ローカライゼーションチェックリストが、場当たり的ではなく毎回、言語、バリアント、タイミング、用語、同意をレビューし続けるのに役立ちます。
吹き替えをリリースする前に、ターゲット言語が市場に一致していること、地域バリアントが適合していること、名前や技術用語が正しいこと、話者が一貫して割り当てられていること、タイミングが急いだり引き伸ばされたりした配信を避けていること、画面上のテキストがローカライズされていること、声の所有者が許可を与えていること、そしてネイティブレベルのレビュアーが承認していることを確認してください。公表されている言語数はカバー範囲のシグナルであり、品質の保証ではありません。
よくある質問
DubSmartでAIはどの言語に吹き替えできますか?
当社は33のターゲット言語を公にサポートしており、英語、ポルトガル語、スペイン語、フランス語、ドイツ語、中国語、日本語、韓国語、ロシア語、アラビア語、ヒンディー語を含みます。完全な33言語一覧と全方言一覧は公開ページに掲載されていないため、あまり一般的でない言語についてはプラットフォーム内で確認してください。
1つの動画を一度に複数の言語に吹き替えできますか?
はい。当社のAPIは、スペイン語、フランス語、ドイツ語など、1つのリクエストで複数のターゲットコードを受け付け、1つのマスターファイルから各言語ごとに別々のローカライズ版プロジェクトを返します。
AI吹き替えは方言や地域的なアクセントをサポートしていますか?
可能ですが、利用可能性は言語と声によって異なります。当社は幅広い言語と方言をサポートしており、完全な方言リストを公開することなく拡張を続けています。スケールする前に、ネイティブのレビュアーに発音と言語レジスターを確認してもらってください。
AI吹き替えはテキスト読み上げと同じですか?
いいえ。テキスト読み上げは提供されたテキストを音声に変換します。AI吹き替えは既存の動画や音声から始まり、文字起こし、翻訳、話者処理、音声生成、同期を1つのワークフローで追加します。
すべてのAI吹き替え言語は同等に正確ですか?
いいえ。品質は方言、声、音声の品質、話者数、用語、翻訳の複雑さによって異なります。ターゲット言語数はカバー範囲として扱い、その上で特定のプロジェクトに対する正確な声とバリアントを確認してください。