ニューラル音声合成の仕組みを尋ねられたら、簡潔な答えはこうです。それは、人間が実際にどのように話すか——発音、リズム、イントネーションを統合的に——モデル化するディープニューラルネットワークにスクリプトを通すことで、書かれたテキストを本物そっくりの音声へと変換します。従来のシステムのように事前録音された断片をつなぎ合わせるのではなく、ニューラルTTSはゼロから音声を生成し、テキストと組み合わされた実際の人間の録音による大規模なデータセットから直接パターンを学習します。この違いこそが、現代の合成音声が、ロボットのようなアナウンスではなく、動画をまるまる聴き続けられるナレーターのように聞こえる理由です。DubSmart AIでは、この同じニューラルアプローチを基盤としてText to Speechを構築し、それを音声クローンや吹き替えと連携させることで、1つのスクリプトが1つの言語から複数の言語へと展開できるようにしています。
このガイドでは、その仕組みを段階ごとに順を追って解説し、それを実用的な判断へと落とし込みます。ニューラル音声が単独で使えるほど強力な場面はどこか、それでも人間によるパフォーマンスが欲しい場面はどこか、そして各要素が当社のプラットフォーム内でどのように組み合わさるのか、を扱います。
目次
「ニューラル音声合成の仕組み」が本当に意味すること
ニューラル音声合成は、ディープニューラルネットワークを用いてゼロから音声を生成する音声合成の一種です。ルールベースや連結型の手法との決定的な違いは、システムがテキストと組み合わされた人間の録音の大規模データセットから学習する点にあり、そのため単語がどう聞こえるべきかと、人がどのように自然に発話するかの両方を予測できます。この学習された振る舞いこそが、プロソディ——強勢、リズム、間、そして感情的なトーン——を捉え、長時間のリスニングでも快適な音声を生み出すのです。大手クラウドプロバイダーは、これらのニューラル音声を、アシスタントやアクセシビリティツール、読み上げ体験におけるリスニングの疲労を軽減する発音を持つ人間らしい合成音声として説明しています。
当社のText to Speechエンジンは、このニューラルの道筋に従っています。スクリプトを解析し、音素に分解し、リズムとイントネーションを推論した上で、ニューラルモデルを用いて、旧来のTTSにありがちな平坦な読み上げではなく、滑らかな音声を生成します。その結果、テキストから数秒でリアルな音声が生成され、さまざまなトーンやユースケースに合わせた300以上の音声ライブラリから選べます。
ニューラルTTSがクリエイターやチームにとって重要な理由
YouTubeクリエイター、中小企業、eラーニング制作者、映像作家、ポッドキャスター、開発者にとって、本当の問いは、この技術がどう機能するかだけでなく、それを制作パイプラインに取り入れるべきかどうかです。ニューラルTTSが重要なのは、合成音声を「実用」領域——GPSの案内や基本的なプロンプト——からパフォーマー領域へと移行させるからです。つまり、コンテンツの主役を務め、コース全体をナレーションし、明らかに人工的だと感じさせることなくブランドメッセージを担えるほどの品質になっています。これを翻訳や吹き替えと組み合わせれば増幅装置となり、1つのスクリプトが、従来のスタジオ作業のわずかなコストと時間で数十言語に届くようになります。
私たちはDubSmartをまさにその判断を軸に設計しました。Text to Speech、Voice Cloning、AI Dubbing、Speech to Text、Speech Separator、Text to Image、Image to Videoが1つのパイプラインに収まっているため、音声コンテンツは別々のツールをやりくりすることなく、アップロードから多言語エクスポートまで移動します。各段階——スクリプト、音声、言語、ミックス——で、どこまで自動化し、どこまでカスタマイズするかを、単一の環境内で選べます。
それがどこに着地するかは、あなたが何を作るかによって変わります。
- YouTubeチャンネルを新しい言語に拡大する場合:ニューラルTTSと吹き替えにより、スクリプトとタイミングを再利用しつつ、ローカライズされた音声に差し替えられます。
- マーケティングやトレーニング動画をローカライズする場合:更新のたびに声優を手配することなく、言語をまたいで一貫したブランドナレーションが得られます。
- eラーニングや企業研修を制作する場合:長尺のナレーションがスケーラブルになり、コンテンツが変わっても簡単に修正できます。
- ポッドキャストやインディー映画を運営する場合:多言語版、ナレーションの差し込み、アクセシビリティトラックを作成できます。
- アプリケーションを構築する場合:当社のAPIは、ニューラル音声をIVR、エージェント、コンテンツツール向けの呼び出し可能なサービスに変えます。
仕組みを理解することで、ニューラル音声が単独で成立できる場面と、クローンや吹き替えのソースとして人間の録音を残すべき場面を判断しやすくなります。
内部の仕組み:ニューラルTTSパイプライン
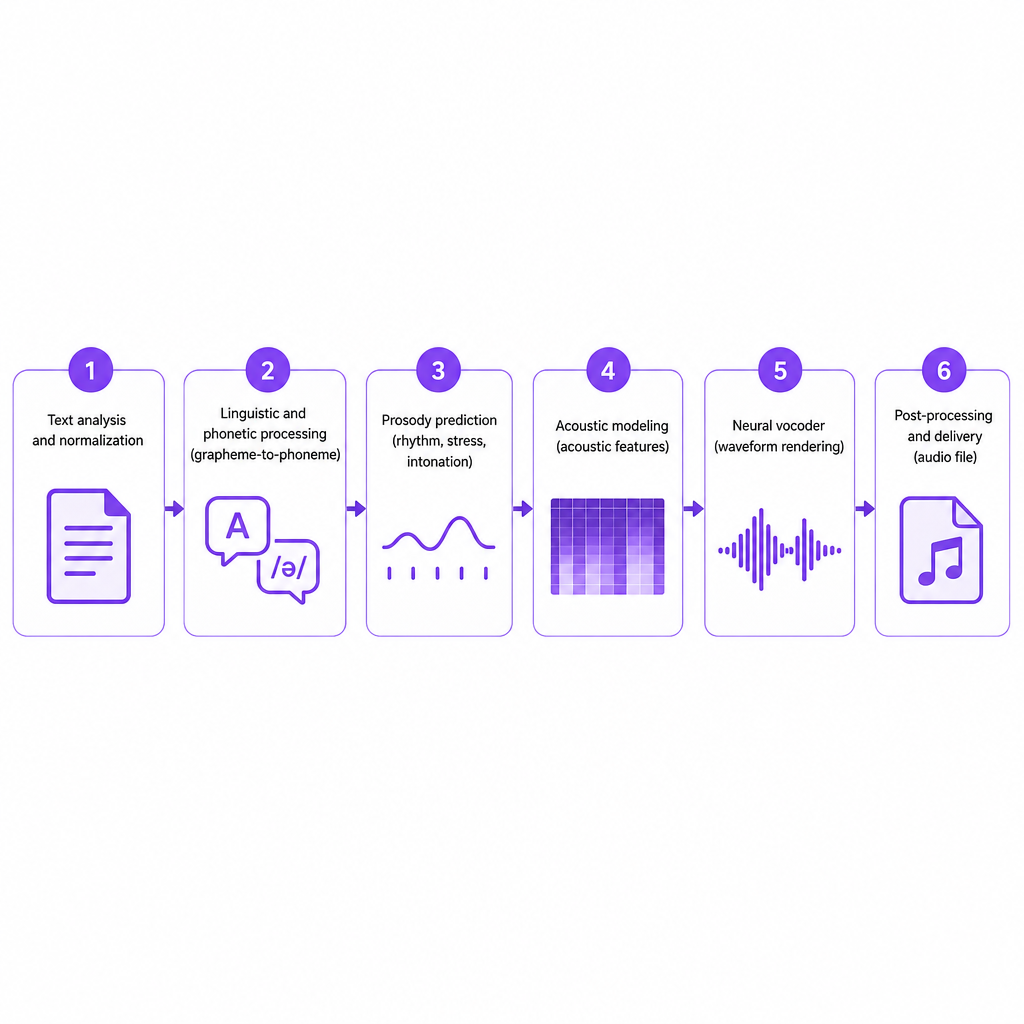
エンジンは詳細では異なりますが、大手プロバイダーの技術文書や責任あるAIの開示に記載された、大まかに共通するパイプラインを共有しており、AI音声ナレーションの作成方法に関する当社独自の説明もこれと一致しています。
テキスト解析と正規化
まずシステムはあなたのテキストを取り込み、発話可能な形へと正規化します。これは、数字(「2026」は「twenty twenty-six」になる)、日付、略語を展開すること、文脈に基づいて「US」対「us」のような曖昧なトークンを解決すること、そして間や強調を計画するために句読点や構造を読み取ることを意味します。当社のエンジンは、テキストを平坦な文字列として扱うのではなく、句読点と構造を解釈してリズムと流れを推論します。この段階は、段落構造や見出しが人間の自然な読み方を形作るような、より長いスクリプト——コース、解説、ポッドキャスト——にとって実質的な重みを持ちます。
言語的・音声学的処理
正規化されたテキストは、言語の基本的な音の単位である音素へと変換されます。書記素から音素へのモデルが文字を音にマッピングし、発音規則、例外、多言語入力を処理します。これにより、当社のText to Speechは、内蔵音声を使う場合でもクローン音声を使う場合でも、多くの言語にわたるスクリプトを受け入れ、選択した言語に対して正しい音素列を生成できます。当社のニューラル音声は、英語、ポルトガル語、スペイン語、フランス語、ドイツ語、中国語、日本語を含む33以上の言語をカバーしています。
プロソディ予測
プロソディ——リズム、強勢、イントネーション——は、ロボット的な音声と人間らしいパフォーマンスの違いです。ニューラルモデルは録音から直接プロソディのパターンを学習するため、どこでどのくらい間を置くかを決め、どの単語を強調するかを選び、文や段落全体にわたってピッチとエネルギーを調整できます。高精細ニューラル音声はさらに進んで、テキスト内の感情を検出し、安定したペルソナを保ちながらトーンを調整します。これがサポートコンテンツやナレーション向けの会話的または共感的な読み上げを可能にします。当社のエンジンも同じ理由で、音声を合成する前にプロソディを推論します。平坦な読み上げを避け、モジュール全体を通して聴き続けられる音声を生み出すためです。
音響モデリング
音素とプロソディが設定されると、ニューラル音響モデルがその表現を音響特徴——音波の設計図——へと変換します。責任あるAIの開示によれば、これらのモデルは特定の声優の録音に加えて、多数の話者からなるより広範なソースライブラリも活用しています。この組み合わせにより、ネットワークは一般的な発話パターンを学習しつつ、特定の音声の音色、アクセント、スタイルを捉えることができます。当社のプラットフォームでは、このモデリングこそが300以上の音声を独特でありながら自然に響かせるものであり、システムが短いサンプルから音声の音響的・プロソディ的な特徴を学習する高速な音声クローンを支えています。
ボコーダーと音声レンダリング
音響特徴はニューラルボコーダーへと渡され、それを完全な音声波形へとレンダリングします。より新しいボコーダーは、明瞭な子音、滑らかな母音、最小限のアーティファクトで、スタジオ録音とほとんど区別がつかない高忠実度の音声を生み出します。ニューラル音響モデルとボコーダーの組み合わせこそが、従来のスクリーンリーダーやIVRで使われていた古い技術よりもニューラル音声がはるかに自然に聞こえる理由です。当社も同様の進歩を活用しており、生成された音声はそのまま直接公開したり、音楽や効果音とのミックスに組み込んだりできます。
後処理と配信
最後にシステムは、音声ファイルを返す前に後処理——ノイズシェイピング、ラウドネス正規化、フォーマット変換——を適用する場合があります。APIワークフローでは、これはテキストと音声パラメータを受け取り、すぐに使えるアセットを返すRESTfulエンドポイントにラップされます。当社のText to Speechはまさにこの流れに従います。テキストを貼り付けるか送信し、言語と音声を選び、コントロールが公開されている箇所で読み上げを調整し、生成して、標準フォーマットの音声をダウンロードします。同じエンジンは当社のAI Dubbingの基盤にもあり、そこでは文字起こし、翻訳、合成が連鎖して多言語版を作成します。
DubSmart内のオプション:音声、クローン、吹き替え、API
仕組みを知ることで、当社の機能セットがなぜこのように構築されているのかが説明できます。
直接ナレーション用のText to Speech
当社のText to Speechツールは、スクリプトを音声に変えるための中核インターフェースです。サポートされている任意の言語のテキストを貼り付けるかアップロードし、300以上の自然な音声から選び、利用可能な箇所で言語と基本的な読み上げコントロールを設定し、数秒で音声を生成します。YouTubeのフック、動画のフルナレーション、中小企業向けの解説・プロモーションのナレーション、明快なeラーニングやトレーニングモジュール、ポッドキャストのイントロ、アウトロ、ミッドロールをカバーします。その用途のためのツールを検討しているなら、クリエイター向けの最高のAI吹き替えソフトウェアに関する当社のまとめが、ナレーションとローカライズがどうつながるかを示しています。
音声クローン:ブランドやホストの声を保つ
音声クローンは、同じニューラルステップ——音素、プロソディ、音響特徴——を基盤としますが、特定の音色とスタイルに合わせてネットワークを最適化するため、再録音なしにその声で新しいセリフを生成できます。当社の高速音声クローンは、Text to SpeechやAI Dubbing内で使えるカスタム音声を作成します。つまり、ローカライズされたコンテンツも依然としてあなたのホスト、ナレーター、ブランドのように聞こえるということです。この連続性は、認識されやすい音声アイデンティティに投資してきたチャンネルや企業にとって最も重要です。
AI Dubbing:音声認識、翻訳、TTSの連鎖
AI吹き替えは、TTSエンジンをより長い連鎖の最終ステップとして使用します。既存の音声を文字起こしし、その文字起こしを翻訳し、次にターゲット言語で新しい音声を合成します。当社のAI Dubbingは、吹き替え、音声合成、音声認識、クローンを1つのワークフロー内に保つため、コンテンツはプラットフォームを離れることなくアップロードから多言語エクスポートへと移動します。実際には、動画やポッドキャストをアップロードし、文字起こしして背景音声から分離し、1つ以上の言語に翻訳し、次にタイミングとトーンを保つストック音声やクローン音声を使って吹き替えトラックを生成できます。音声コンテンツの手順については、ポッドキャストを別の言語に翻訳する方法に関する当社のガイドをご覧ください。
開発者と代理店向けのAPI
私たちはニューラルTTSと吹き替えをAPI経由で公開しており、開発者や代理店が自社製品に音声生成を統合できます。当社のText to Speech APIは、テキストコンテンツと音声設定を含むPOSTリクエストを受け付け、高品質な音声を返すRESTfulサービスで、33以上の言語のプレミアムニューラル音声にアクセスできます。AI Dubbing APIはそれを自動化された多言語吹き替えへと拡張します。クライアント横断でローカライズを扱う代理店にとって、これらのエンドポイントは、ブランドごとに言語やペルソナをカスタマイズしつつ音声生成を標準化します。
判断基準:ニューラルTTSを上手に選び、使う
仕組みが明確になれば、実務的な作業はそれをいつ、どのように使うかを決めることです。
自然さとリスニングの快適さ。核心となるテストは、その音声が、聴衆にメインのナレーターとして受け入れられるほど自然かどうかです。ディープニューラルネットワークとHD音声はリスニングの疲労を軽減するように作られていますが、適切な選択はやはりコンテンツの種類次第です。当社の大規模な音声ライブラリを使ってペルソナ——エネルギッシュ、落ち着いた、遊び心のある、権威ある——をテストし、長尺のコースやポッドキャストでは、アナウンス調ではなく会話調に感じられるプロソディの音声を選びましょう。
言語カバレッジとアクセントの適合性。多言語展開には、言語とターゲット層に適したアクセントの両方が必要です。当社のニューラル音声は、主要市場にわたる33以上の言語に及びます。ローカライズトラックを選ぶ際は、ニュートラルなアクセントを望むか地域固有のアクセントを望むかを決め、可能であればネイティブスピーカーとサンプルをテストしましょう。
ブランドの一貫性対柔軟性。クローンは特定の音声を言語やプロジェクトをまたいで持ち運びますが、同意と開示にまつわる責任を伴います。一貫したペルソナがブランドの中心である場合に使用し、その音声を誰が所有し管理するかを——特に企業や代理店の業務では——文書化しましょう。
ワークフロー統合。ニューラルTTSは、あなたが既に働いている方法に組み込まれたときに最も価値を発揮します。当社のツールは音声合成、クローン、吹き替え、音声認識、メディアユーティリティを組み合わせているため、スクリプトや音声を編集しつつ、ローカライズの連鎖の大部分を自動化できます。ソロクリエイターはブラウザツールで十分かもしれませんし、開発者や代理店はスケーリングのためのプログラム可能なエンドポイントを得られます。
リスク、限界、そして責任ある利用
高度なモデルでさえ、計画に織り込む価値のある境界があります。
- 感情のニュアンス:HD音声は感情に応答しますが、熟練した俳優が届けるような微妙な手がかりや複雑なパフォーマンスを取りこぼす場合があります。重要なブランドメッセージや物語的なドラマは、依然としてソースとして人間の録音が妥当かもしれません。
- 発音のエッジケース:珍しい名前、新しい用語、混在言語のスクリプトは、書記素から音素へのモデルに難題を課す可能性があるため、手動チェックを組み込みましょう。
- クローンの倫理:責任あるAIのガイダンスは、カスタム音声が明示的な同意、明確な契約、聴衆への開示をもって構築・使用されるべきだと強調しています。許可なく人物を模倣することは、法的および倫理的な懸念を引き起こします。
- バイアスと表現:トレーニングデータは音声がアクセントや方言をどう扱うかを形作るため、選んだ音声が聴衆を公正に代表し、ステレオタイプの強化を避けているかを確認しましょう。
当社の統合ワークフローは合成音声の生成と展開を容易にするため、内部レビューは軽視されるどころか一層重要になります——特にクライアントや従業員の声を扱う場合はそうです。具体的な道筋が役立ちます。クリエイターは1つの英語スクリプトを書き、英語のナレーションを生成し、次に同じタイミングと読み上げを保ちながら、追加のチャンネル向けにスペイン語、ポルトガル語、ドイツ語版を吹き替えられます。トレーニングチームはモジュール式のナレーションを構築し、ポリシーが変わるたびにそれを素早く再生成できます。それこそがパイプラインを理解することの真の見返りです——どの段階を制御し、どの段階をモデルに任せるべきかがわかるのです。
よくある質問
ニューラル音声合成を簡単に言うと何ですか?
ニューラル音声合成は、人間の録音の大規模データセットで訓練されたディープニューラルネットワークを用いて、書かれたテキストを音声に変えるAIであり、旧来のTTSシステムよりもはるかに本物の人間に近い音声を生み出します。
DubSmartのText to Speechは基本的なTTSとどう違うのですか?
私たちは、スクリプトを解析し、プロソディを推論し、ゼロから音声を合成するニューラルモデルを使用しており、300以上の自然な音声と高速音声クローンに支えられているため、出力は動画、コース、ポッドキャストの主要なナレーターとして機能します。
DubSmartは私自身の声を他の言語で保てますか?
はい。当社の音声クローンは録音からあなたの声を学習し、それを音声合成やAI吹き替えで使用できるため、コンテンツのローカライズ版も依然としてあなたやあなたのブランドナレーターのように聞こえます。
AI吹き替えはニューラルTTSとどのように連携しますか?
AI吹き替えは、音声認識による文字起こし、翻訳、ニューラル音声合成を連鎖させ、既存の音声を、ストック音声またはあなたのクローン音声を使って、単一のワークフロー内で多言語の吹き替えトラックに変えます。
ニューラル音声合成は安全かつ倫理的に使用できますか?
同意、明確な開示、適切なセーフガードのもとで使用すれば、ニューラルTTSはアクセシビリティとローカライズのための強力なツールです。責任あるAIのガイダンスは、声優の権利を尊重し、合成音声の欺瞞的な使用を避けることを強調しています。