クリエイターに最適なAI吹き替えソフトを選ぶ際、通常はひとつの疑問に行き着きます。それは、文字起こし、翻訳、音声生成、タイミング調整、そしてエクスポートまでを一括で扱う単一のスタジオが欲しいのか、それとも複数のバラバラなアプリを継ぎ合わせてタイミングが崩れないことを祈るのか、という点です。私たちはDubSmart AIを前者の答えを軸に構築しました。AI吹き替え、テキスト読み上げ、音声認識、そして音声クローンの各ツールがひとつのワークフロー内で動作するため、音声コンテンツはプラットフォームを離れることなく、アップロードから完成した多言語エクスポートまでスムーズに進みます。
これは競合ブランドをランク付けするまとめ記事ではありません。本格的なクリエイターにとって重要なDubSmartの機能、それぞれがどんな人に合うのか、そして正直に言える限界がどこにあるのかを実務的に分解したものです。これにより、当て推量ではなく、自分のチャンネルに適切なツールを選べるようになります。
目次
このリストが実際に基準としているもの
どのツールもここに掲載されるには、機能一覧で印象的に見えるだけではなく、実際のクリエイターの要求に応えなければなりません。私たちは、多言語コンテンツが実際に世に出せるかどうかを決める6つの基準に照らして、各機能を評価しました。
- エンドツーエンドの、音声を第一とするローカライゼーション。 アップロードからエクスポートまでの一連の流れは、複数の別々のアプリの寄せ集めではなく、ひとつの場所に存在すべきです。
- 幅広い言語対応。 私たちは60以上のソース言語から33のターゲット言語への吹き替えに対応しており、ひとつのプラットフォームでグローバルな視聴者にリーチできます。
- 自然で再利用可能な音声。 テキスト読み上げと音声クローンにより、毎回作り直すことなく、プロジェクト全体で同じ音声アセットを維持できます。
- 編集のコントロール。 セグメント、タイミング、話者の調整により、吹き替えの同期とブランドの一貫性が保たれます。
- 技術者でないクリエイターと開発者の両方のための道筋。 実際に手を動かして編集するためのウェブスタジオに加え、自動化を望むチーム向けのAPIを提供します。
- 価格設定とスケーラビリティは、YouTubeチャンネル、中小企業、eラーニングのカタログ、制作チームに適しています。
以下のすべては、これらの基準に対応しています。各機能が何を違ったやり方で実現するのか、誰に合うのか、そしてカタログ全体を委ねる前に知っておくべき実務的な限界を示します。
多言語ワークフロー向けの統合型AI吹き替えスタジオ
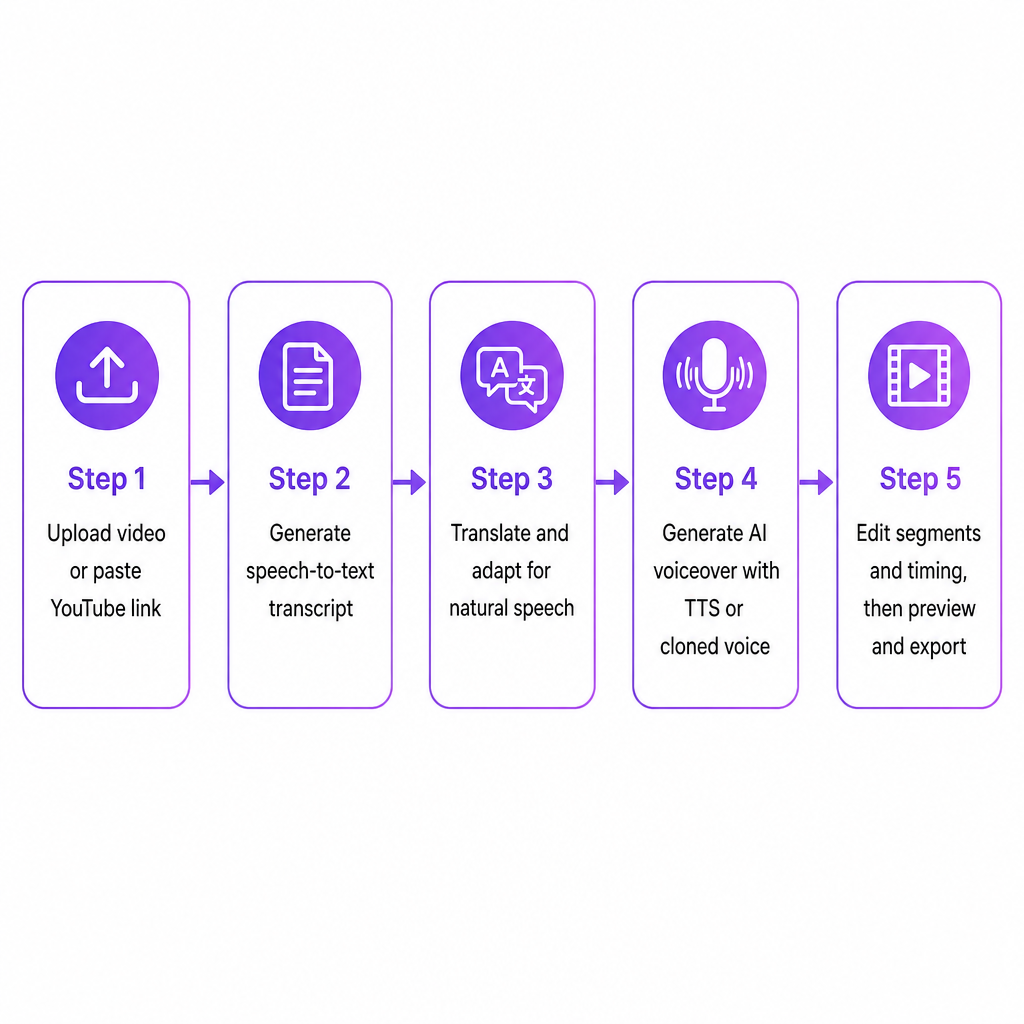
タイミングについて決して完全には一致しない文字起こしアプリ、翻訳ドキュメント、TTSツール、動画編集ソフトを、なぜあれこれ扱う必要があるのでしょうか? 私たちのAI吹き替えスタジオはオンラインで動作し、デバイスから動画や音声をアップロードしたり、YouTubeのリンクを貼り付けたりすれば、ソースを自動的に取得します。そこから、文字起こし、翻訳、音声生成、セグメント編集、そしてエクスポートまでがひとつのチェーンとして流れます。話者を追加したり、タイミングやテキストを編集したり、セグメントを調整したり、ダウンロードする前にローカライズされた動画をプレビューしたりできます。
差別化ポイント。 私たちは音声・オーディオを第一とするローカライゼーションに注力しており、60以上のソース言語から発話コンテンツを、33のターゲット言語にわたる吹き替え版へと変換します。これを大規模なAI音声ライブラリと音声クローンがひとつの場所で支えます。この単一スタジオのアプローチは、コンテンツが言語をまたぐ際にもタイミング、トーン、意図を一致させ続けるよう設計されています。まさにこれこそ、継ぎ合わせたツールチェーンが崩れがちなポイントです。
最適な対象。 フルの後処理パイプラインを構築せずに、実績のあるチャンネルを新しい言語市場へ拡大したいYouTubeクリエイター。動画キャンペーンを新しい地域向けに再利用する中小企業やマーケティングチーム。英語優先のモジュールを、別々の言語スタジオを雇うことなく多言語ナレーションへ変換するeラーニングや企業研修の制作者。
制約。 自動化は作業を高速化しますが、特に専門的または技術的なコンテンツでは、ニュアンスのために文字起こしや翻訳を確認し、軽く編集する必要をなくすものではありません。出力品質はソース音声に左右されるため、激しい背景雑音や重なり合う発話がある場合は、まずクリーンアップすると効果的です。そして対応範囲は広いものの、記載されている60以上のソース言語と33のターゲット言語という枠に限られます。ニッチな方言や低リソース言語では、人間の人材を組み合わせたハイブリッドワークフローが必要になる場合があります。
ブランド化されたクリエイターやキャラクターの声のための高速音声クローン
汎用的なナレーションは、吹き替え動画を他人のもののように感じさせる最速の方法です。私たちの音声クローンは、音声サンプルからカスタムAI音声を作成します。必要なのは最低20秒のクリアな発話で、クローンは数秒で完成します。そのクローンされた声はテキスト読み上げと吹き替えの両方のプロジェクトで使えるため、あなたの声、または法的に使用許諾を得た任意の声が、多言語コンテンツのための再利用可能なアセットになります。
差別化ポイント。 ここでのクローンは、切り離されたラボの実験ではありません。吹き替えとTTSのフローに直接組み込まれているため、話される言語だけが変わる中で、動画や言語をまたいで単一のホストの声を維持することが実用的になります。
最適な対象。 吹き替え動画を自分の声のように聞こえさせたい個人クリエイター。エピソードやカットをまたいで一貫したキャラクターの声を再利用しローカライズする必要のあるポッドキャスターや映像制作者。特徴的な声のタレントを持ち、その声を複数の言語のキャンペーンにわたって拡大したいブランドや企業。
制約。 クローンにはクリアで背景雑音のない録音が必要です。ソース音声が弱いと品質が下がり、録り直しを余儀なくされる場合があります。クローンする任意の声について、権利と同意を得るのはあなたの責任です。技術が容易であっても、倫理や法律が変わるわけではありません。そして重要度の高いナレーション作品や映画的な作品では、極めてスタイリッシュまたは演劇的な演技は、依然として人間のテイクの方が優れている場合があります。
研修・解説・大規模なナレーション向けに構築されたテキスト読み上げ
ナレーション付きのレッスンや解説を数十本も必要とする場合、一本ずつ録り直すのは論外です。私たちのテキスト読み上げツールは、内蔵のAI音声または自分のクローンした声を使って、スクリプトを自然に聞こえる音声へと変換します。ローカライゼーションのワークフロー内で、文字起こしを生成し、自然な発話のために翻訳・調整し、その後AIナレーションを生成してからセグメントとタイミングを微調整します。この流れは、研修動画、解説、音声主体のフォーマットに適しています。
差別化ポイント。 これは単なる読み上げユーティリティ以上のものです。TTSエンジンは吹き替えスタジオ内に組み込まれており、特定のセグメントを再生成したり、セグメントを結合・分割したり、感情的なトーンやタイミングを調整したりできます。音声クローンと組み合わせることで、翻訳されたスクリプトが各言語で実際にどう聞こえるかを細かくコントロールできます。
最適な対象。 ナレーション付きのレッスンやマイクロラーニングモジュールの大規模なカタログを構築するeラーニング制作者やインストラクショナルデザイナー。すべてのモジュールを録り直すことなく、地域をまたいでコンプライアンスやオンボーディングのコンテンツを更新する企業研修チーム。言語版をまたいで一貫性を保つ必要のある解説やデモのナレーションを制作するマーケティングや製品チーム。
制約。 AI音声は非常に自然になり得ますが、感情的に強烈なストーリーテリングや映画的なスポットでは、依然としてオーダーメイドの人間の演技が望ましい場合があります。字義的な正確さのために翻訳されたスクリプトは、発話の流れのために調整が必要になることが多いです。ワークフローはこれをサポートしますが、それでもあなたの関与が求められます。言い回しのレビューを飛ばすと、一部のターゲット言語ではぎこちなく、あるいは過度に堅苦しい仕上がりになることがあります。
吹き替え・TTS・音声クローン向けの開発者API
自社製品の中の機能としてローカライゼーションを提供する場合、手動でのエクスポートではスケールしません。私たちはコア機能をAPIを通じて公開しているため、メディアを取り込み、カスタム音声を作成し、プログラムで吹き替えを実行できます。AI吹き替えAPIは事前署名付きURLを発行するので、標準のHTTP PUTリクエストで動画ファイルをアップロードできます。また、音声クローンAPIは、MP3、WAV、AAC、M4A、FLACを含む一般的な音声フォーマットでのサンプルアップロードを受け付けます。APIで作成した音声は、その後テキスト読み上げや吹き替えに流し込めます。
差別化ポイント。 APIは、私たちのクリエイタースタジオを、プラットフォーム、SaaS製品、エージェンシーのワークフローに組み込めるエンジンへと変えます。ファイルを手作業でエクスポートする代わりに、アップロード、音声作成、吹き替え、取得を自動化し、ローカライゼーションを自社のアプリケーションやパイプラインに直接組み込めます。
最適な対象。 「この動画を吹き替える」ボタンを追加する動画プラットフォームやクリエイターツール。独自のフロントエンドを保ちながらAI吹き替えのバックエンドで標準化するエージェンシーやローカライゼーションプロバイダー。研修ポータル、サポートセンター、コンテンツ管理システムに多言語音声を組み込む社内エンジニアリングチーム。
制約。 APIの利用には、開発者リソースとHTTPおよびJSONへの習熟が前提となります。技術者でないチームは、多くの場合スタジオを好むでしょう。私たちが吹き替えのロジックを提供する一方で、レート制限、エラー処理、ファイルストレージのインフラは統合側の担当です。クローンされた音声を誰が作成・使用してよいかについてのガバナンスは、アプリケーションレベルで徹底する必要があります。
正確なタイミングを支える音声認識の基盤
言葉が完璧であっても、映像から一拍ずれてしまう吹き替えは違和感があります。私たちの音声認識レイヤーは、何かが再吹き替えされる前に、発話コンテンツを編集可能な文字起こしへと変換します。私たちが記載しているエンドツーエンドのチェーンは次のように進みます。元の動画の文字起こしを生成し、正確さと明瞭さのために編集し、自然な発話のために言い回しを翻訳・調整し、AIナレーションを生成し、吹き替えスタジオで音声を調整し、その後プレビューしてエクスポートします。
差別化ポイント。 私たちは音声認識を別個の製品として扱うのではなく、吹き替えパイプラインに組み込んでいます。つまり、音声とタイミングが生成される前に、文字起こしの誤りを修正し、セリフを書き直し、ペースを調整できるということです。これは、既存の映像に吹き替え音声を同期させる際に最も重要で、わずかなずれでも不快に感じられます。ノイズの多い複数話者の録音も扱う場合は、Speech Separator解説ガイドが、文字起こしの正確さを守るクリーンアップのステップをカバーしています。
最適な対象。 正確な発話タイミングが極めて重要なトーキングヘッドやチュートリアルのチャンネル。コンプライアンスのために逐語的な正確さを必要としつつ、自然な伝達のために言い回しを調整する研修・企業コミュニケーションチーム。声が特定の視覚的なタイミングに合わなければならない、ローカライズされた製品ウォークスルーやUIデモ。
制約。 文字起こしの正確さは依然として音声品質、話者のアクセント、専門用語に左右されるため、技術的またはノイズの多い録音はより多くのレビューが必要です。複雑な複数話者や大きく重なり合った音声は、事前のクリーンアップなしでは文字起こしと同期がより難しくなります。ワークフローは手作業を削減しますが、最終的な品質チェックをなくすものではありません。特に規制の厳しい業界ではそうです。
自分のチャンネルに最適な構成を選ぶ方法
構成要素が明確になれば、それらを自分のプロフィールに合わせるのは簡単です。どこから始めるべきかを決めるには、この対応表を使ってください。
| あなたのプロフィール | まず始めるもの | なぜ合うのか |
|---|---|---|
| YouTubeクリエイターや映像制作者 | 吹き替えスタジオ+音声クローン+タイミング制御 | 吹き替え版が再ナレーションではなく、オリジナルのように感じられる |
| 中小企業のマーケティング/研修 | TTS+吹き替えワークフロー | 編集可能で再利用可能なスクリプトで、解説と研修を言語をまたいで拡大できる |
| eラーニング/企業研修 | 文字起こし編集+セグメント制御+クローン音声 | コースの一貫性が保たれ、時間の経過とともに更新しやすい |
| 開発者やエージェンシー | AI吹き替え+音声クローンAPI | 事前署名付きアップロードとカスタム音声が、自分でオーケストレーションするバックエンドサービスになる |
単発の動画ではなく、フルの多言語チャンネルを計画しているなら、多言語YouTubeチャンネルの構築方法に関する私たちのガイドが戦略をエンドツーエンドで解説しており、動画内の音声言語を変更する方法が実務的な単一動画の道筋をカバーしています。米国拠点のクリエイターにとって有用なパターンは、フルの人間による吹き替え制作を前もって決め込むのではなく、まず単一言語のチャンネルやカタログから始め、需要を検証しながら多言語の音声トラックを追加していくことです。
よくある質問
AI吹き替えとは何で、字幕とはどう違うのですか?
AI吹き替えは、元のタイミング、トーン、意図を保ちながら、あなたの音声や動画を他の言語へと文字起こし・翻訳・再吹き替えします。字幕は画面上にテキストを重ねるものですが、吹き替えは音声トラックを置き換えたり追加したりするため、視聴者は自分の言語で聴くことができます。
DubSmartはいくつの言語に対応できますか?
私たちのワークフローは、60以上のソース言語からの発話コンテンツを、33のターゲット言語にわたる吹き替え版へと変換し、テキスト読み上げと音声クローンをひとつのプラットフォームで組み合わせます。
DubSmartはどのようなタイプのクリエイターに注力していますか?
私たちはグローバルなコンテンツクリエイター、エージェンシー、企業のために構築されており、AI吹き替え、音声クローン、テキスト読み上げ、音声認識を、メディア、マーケティング、eラーニング、研修分野の動画クリエイターに向けて提供しています。
大規模な動画カタログ全体で吹き替えを自動化できますか?
はい。私たちのAI吹き替えAPIと音声クローンAPIを使えば、事前署名付きURLでファイルをアップロードし、カスタム音声を作成し、プログラムで吹き替えを実行できるため、自社のアプリケーションやコンテンツパイプライン内で大規模なカタログをローカライズすることが実用的になります。
AI吹き替えを使う場合でも、人間によるレビューは必要ですか?
プロフェッショナルまたは重要度の高いコンテンツについては、文字起こし、翻訳、最終音声を正確さとニュアンスの観点から確認してください。私たちのワークフローは、文字起こし、翻訳、ナレーション、タイミングの各段階をひとつの統合スタジオで見えるようにすることで、こうしたチェックを容易にします。