Mengubah naskah menjadi narasi YouTube dulunya berarti mikrofon, ruangan yang tenang, dan banyak pengulangan rekaman. Kini youtube text to speech memungkinkan Anda menempelkan naskah, memilih suara, dan mengekspor narasi yang bisa Anda masukkan ke dalam video, Short, tutorial, atau versi terjemahan dari unggahan yang sudah Anda terbitkan. Keputusan yang sebenarnya bukanlah apakah akan menggunakan suara sintetis sama sekali. Melainkan metode produksi mana yang cocok untuk video tertentu yang ada di depan Anda: suara AI stok, kloning khusus, rekaman manusia, atau kombinasi dari ketiganya.
Panduan ini menjelaskan cara kerja teknologi tersebut sebenarnya, alur kerja mana yang sesuai dengan berbagai tujuan channel, dan apa yang perlu diverifikasi terkait hak dan pengungkapan sebelum Anda menekan tombol terbitkan. Ini adalah pusat dari kumpulan penjelasan kami yang lebih luas tentang ucapan dan transkripsi, jadi Anda akan menemukan tautan ke pembahasan lebih mendalam ketika sebuah topik layak mendapat halamannya sendiri.
Daftar isi
Apa sebenarnya arti YouTube text to speech
YouTube text to speech hanyalah penggunaan teknologi text-to-speech untuk menghasilkan narasi bagi konten YouTube. Anda menyediakan naskah, memilih suara dan bahasa, menyesuaikan cara penyampaiannya, dan mengekspor file audio untuk diedit atau diunggah. Di balik layar, sistem TTS mengonversi teks, atau Speech Synthesis Markup Language (SSML), menjadi data audio seperti audio yang kompatibel dengan MP3 atau WAV yang bisa Anda tambahkan ke video dan media lainnya.
Dua perbedaan dapat mengatasi sebagian besar kebingungan. Teks terjemahan (caption) melakukan tugas kebalikan dari TTS: caption mengubah audio ucapan menjadi teks, sementara text to speech mengubah teks tertulis menjadi audio ucapan. Dubbing lebih luas lagi. TTS biasanya dimulai dari naskah tertulis dan menghasilkan trek suara baru, sedangkan dubbing umumnya menerjemahkan video yang sudah ada dan mencocokkan ucapan pengganti dengan waktu dan makna aslinya. Jika batasan tersebut penting untuk alur kerja Anda, penjelasan kami tentang bahasa apa saja yang bisa di-dubbing AI membahas sisi lokalisasi secara rinci.
Bagaimana alur sintesis mengubah naskah menjadi suara
Sistem TTS menggabungkan empat bahan: naskah Anda, model suara yang dipilih, informasi bahasa, dan kontrol penyampaian. Dari situ, ia bekerja melalui urutan singkat yang menjelaskan mengapa kalimat yang sama bisa terdengar bagus atau janggal tergantung pada cara Anda menulisnya.
Pertama adalah input teks, yang bisa berupa naskah YouTube lengkap, kerangka yang diperluas menjadi narasi, versi terjemahan dari naskah yang sudah ada, atau caption yang dibentuk ulang menjadi sulih suara. Kualitas input menentukan kualitas output. Kalimat panjang, singkatan yang tidak dijelaskan, nama yang tidak biasa, dan tanda baca yang berantakan dapat membuat suara yang mumpuni terdengar aneh. Solusinya adalah menulis untuk didengarkan ketimbang untuk dibaca dalam hati: kalimat lebih pendek, transisi yang jelas, jeda yang disengaja.
Selanjutnya mesin menganalisis teks untuk memutuskan bagaimana kata-kata harus diucapkan dan dikelompokkan. Ia membaca batas kalimat, tanda baca dan jeda, angka dan tanggal, singkatan, nama, dan petunjuk pelafalan regional. Inilah sebabnya tanda baca mengubah penyampaian. Tambahkan koma, tulis ulang angka menjadi kata, atau ejakan sebuah akronim, dan suara akan merespons.
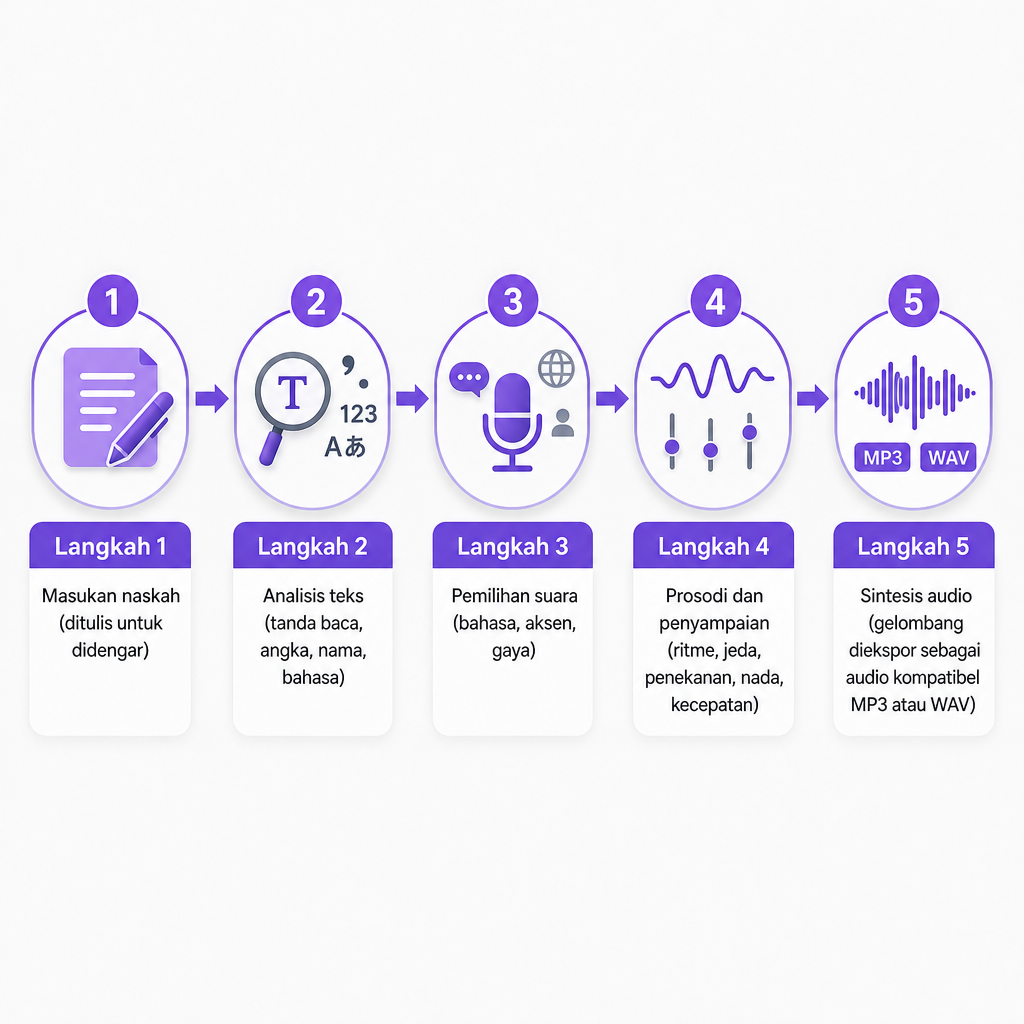
Kemudian Anda memilih suara. Suara berbeda berdasarkan bahasa, aksen, usia atau karakter vokal, presentasi gender, gaya bicara, energi, dan formalitas. Pengaturan output sering kali mencakup kecepatan bicara, nada, volume, dan sample rate. Untuk sebuah channel, konsistensi biasanya mengalahkan drama. Suara yang mudah dikenali dan dibawa ke seluruh video membuat channel terasa koheren, yang lebih penting daripada memilih opsi paling teatrikal untuk satu unggahan.
Mesin kemudian menghasilkan prosodi, yaitu irama, jeda, penekanan, pergerakan nada, dan intonasi yang membedakan ucapan ekspresif dari kata-kata yang berjarak merata. Beberapa alat menyediakan kontrol ini secara langsung; yang lain menyimpulkannya dari tanda baca, struktur kalimat, atau instruksi gaya. Di sinilah sebagian besar kesenjangan kualitas muncul. Sebuah suara bisa mengucapkan setiap kata dengan benar dan tetap terasa salah jika tempo atau nada emosionalnya bertentangan dengan video.
Akhirnya model mensintesis audio, mengubah teks yang dianalisis menjadi gelombang suara yang dikembalikan layanan sebagai file yang bisa diunduh. Alur kerja API mungkin mengembalikan data audio terenkode yang Anda dekode menjadi file yang bisa diputar, sementara alat kreator yang dihosting menangani langkah itu untuk Anda. Bahkan setelah itu, narasi belum menjadi video jadi. Anda masih harus menempatkannya di timeline, memotong keheningan mati, menambahkan musik dan efek, mencocokkannya dengan visual, menyeimbangkan level, menambahkan caption, serta meninjau pelafalan dan pengaturan waktu. Untuk sebuah penjelasan, suara harus mengikuti urutan visual; trek yang secara teknis bersih pun terasa sembrono jika gambar berubah sebelum kalimat yang sesuai dimulai. Jika Anda ingin gambaran lengkap tentang neural, pembahasan kami tentang cara kerja neural text to speech membahas lebih dalam tentang internal model.
Empat jalur produksi, dan kapan masing-masing unggul
Sebagian besar narasi YouTube mengerucut pada empat opsi, dan pilihan yang tepat bergantung pada apa yang dibutuhkan video ketimbang mana yang terdengar paling canggih dalam pratinjau.
| Jalur | Paling cocok untuk | Kompromi utama |
|---|---|---|
| Suara AI standar | Channel tanpa wajah, penjelasan, tutorial, rangkuman bergaya berita, Shorts | Cepat dan andal, tetapi tidak terikat pada orang tertentu |
| Kloning suara khusus | Mempertahankan satu identitas yang mudah dikenali di banyak video | Membutuhkan suara yang Anda berwenang untuk mereproduksinya |
| TTS multibahasa atau dubbing | Penjelasan terjemahan, video produk terlokalisasi, uji pasar baru | Membutuhkan peninjauan pelafalan dan budaya per bahasa |
| Sulih suara manusia | Akting bernuansa, kesaksian, kata-kata sensitif atau krusial bagi merek | Lebih lambat dan lebih sulit untuk diskalakan |
Suara standar yang diambil dari pustaka penyedia adalah jalur tercepat untuk konten bervolume tinggi di mana Anda tidak membutuhkan narasi yang terdengar seperti satu orang tertentu. Kloning suara khusus membangun suara sintetis dari sampel audio, yang membantu seorang kreator mempertahankan identitas yang konsisten tanpa merekam setiap naskah secara manual. Gunakan kloning hanya dengan izin dan dengan suara yang Anda berhak mereproduksinya; kloning bukanlah jalan pintas untuk memiliki identitas atau penampilan orang lain. Alat Text to Speech kami memberi Anda akses ke suara AI dan alur kerja kloning, dan halaman Voice Cloning kami adalah tempat untuk memulai ketika Anda menginginkan narator khusus yang dapat digunakan kembali ketimbang yang stok.
Narasi multibahasa memungkinkan Anda menerjemahkan naskah dan mensintesis trek suara baru dalam bahasa lain, yang berguna untuk mengembangkan channel edukasi di luar negeri, melokalisasi video produk, atau menguji permintaan di pasar baru. TTS dimulai dengan teks; alur kerja AI Dubbing kami menambahkan lapisan lokalisasi yang lebih luas, termasuk terjemahan dan audio pengganti untuk video yang sudah ada di 33 bahasa. Narator manusia tetap unggul ketika video bertumpu pada akting bernuansa, kesaksian pribadi, subjek sensitif, humor kompleks, kata-kata hukum atau krusial bagi merek, atau interpretasi pembawa yang khas. Banyak channel menjalankan pendekatan hibrida: narasi AI untuk draf, versi, dan unggahan bervolume tinggi, serta suara manusia untuk video unggulan.
Kapan text to speech layak mendapat tempat di sebuah channel
TTS YouTube paling menguntungkan ketika hambatan Anda adalah perekaman, bukan penulisan. Jika menulis naskah itu mudah tetapi memesan sesi rekaman adalah bagian yang lambat, narasi sintetis menghilangkan langkah yang paling lambat.
Video edukasi dan instruksional mendapat manfaat langsung. Perbarui naskah dan hasilkan ulang hanya bagian yang terpengaruh ketimbang mengatur rekaman baru, yang cocok untuk tutorial perangkat lunak, onboarding, dan konten kursus yang sering berubah. Channel tanpa wajah dapat menarasikan video yang dibangun dari rekaman layar, stok rekaman, animasi, slide, atau visual yang dihasilkan, meskipun suara tetap membutuhkan arahan editorial; audio yang ditempelkan di atas rekaman yang tidak berhubungan menggerus kepercayaan pemirsa. Shorts memperoleh keuntungan dari perubahan cepat dari naskah ke audio, memungkinkan Anda menguji beberapa hook atau variasi audiens selama suaranya tidak terdengar terburu-buru atau repetitif.
Aksesibilitas adalah penggunaan jujur lainnya. Versi lisan dari konten tertulis membantu pemirsa yang lebih menyukai audio atau kesulitan dengan teks di layar, tetapi narasi harus melengkapi caption yang akurat dan desain visual yang jelas ketimbang menggantikannya. Dan untuk ekspansi multibahasa, Anda dapat memproduksi trek suara terjemahan tanpa menjalankan proses produksi terpisah per bahasa. Fitur Audio multibahasa YouTube memungkinkan kreator yang memenuhi syarat melampirkan trek audio tambahan ke satu video atau Short alih-alih mengelola channel terpisah untuk setiap pasar.
Memilih dan menguji suara sebelum Anda berkomitmen
Nilai sebuah suara terhadap kebutuhan nyata video, bukan pratinjau sepuluh detik yang memikat. Suara yang sempurna pada satu baris bisa berantakan di sepanjang naskah lengkap, jadi uji tekanannya terlebih dahulu.
- Cocokkan suara dengan format. Penyampaian yang tenang cocok untuk dokumenter atau tutorial; suara berenergi lebih tinggi cocok untuk hook atau pengumuman format pendek. Biarkan subjek, tempo, dan audiens yang menentukan.
- Uji kata-kata yang sulit. Sebelum menghasilkan video lengkap, jalankan nama merek berulang, nama tempat, akronim, istilah ilmiah, kata asing, satuan, dan nama orang Anda. Suara yang menangani kalimat biasa bisa tersendat pada kosakata channel Anda.
- Periksa konsistensi format panjang. Hasilkan sampel yang lebih panjang dan dengarkan intonasi yang repetitif, jeda yang salah, irama yang tidak alami, pelafalan yang berubah-ubah, dan transisi paragraf yang tiba-tiba.
- Pertimbangkan audiens regional. Narasi bahasa Inggris mungkin memerlukan pelafalan AS, Inggris, Australia, atau lainnya. Untuk bahasa lain, pastikan suara terdengar alami bagi penutur asli, bukan sekadar bahwa alat tersebut mencantumkan bahasanya.
- Tinjau hak penggunaan. Sebelum memonetisasi atau beriklan, baca persyaratan penyedia dan konfirmasikan bahwa suara dan output telah diizinkan untuk konten YouTube komersial, pekerjaan klien, iklan berbayar, dan versi turunan.
Beberapa kebiasaan menulis juga meningkatkan kualitas dengan cepat. Tulis untuk ucapan dengan mengganti prosa yang padat menjadi kalimat percakapan dan menggunakan tanda baca untuk memandu jeda tanpa mengandalkannya untuk emosi. Ejakan istilah ambigu agar mesin membacanya dengan benar, uji varian seperti "AI" versus "A.I." atau "2026" versus "dua ribu dua puluh enam." Hasilkan per bagian ketimbang satu file raksasa sehingga Anda bisa menghasilkan ulang satu kesalahan, menyusun ulang adegan, dan mencocokkan audio dengan visual. Lalu tambahkan penyuntingan manusia: tonton seluruh video dengan trek diputar, potong jeda yang janggal, perbaiki pengaturan waktu, dan redam musik di bawah ucapan. AI memangkas waktu perekaman; ia tidak menghilangkan peninjauan editorial.
Hak, pengungkapan, dan mengunggah trek bahasa kedua
Bagian yang paling sering dilewatkan kreator juga merupakan bagian yang membuat video ditarik. Jika Anda membangun versi bahasa terpisah, Anda dapat menerbitkannya sebagai video baru atau menggunakan fitur Audio multibahasa YouTube jika tersedia, tetapi platform tidak membuat trek dubbing tersebut untuk Anda. Kreator harus menyiapkan dan mengunggah file audio mereka sendiri dalam format khusus audio yang didukung, kira-kira sama panjangnya dengan video. YouTube juga dapat menghapus file audio sekunder jika konten berhak ciptanya berbeda dari aslinya, yang membuat peninjauan hak menjadi penting ketika trek dubbing Anda menyertakan musik, klip, atau materi terlindungi lainnya.
Pengungkapan adalah kewajiban terpisah. YouTube mengharuskan kreator untuk mengungkapkan konten yang dihasilkan atau diubah AI yang tampak realistis, termasuk konten yang membuat orang nyata tampak mengatakan atau melakukan sesuatu yang tidak mereka lakukan, mengubah rekaman peristiwa atau tempat nyata, atau mengarang adegan yang realistis. Khususnya, YouTube mencantumkan kloning suara Anda sendiri untuk sulih suara atau dubbing sebagai contoh yang tidak memerlukan pengungkapan di bawah kebijakan spesifik tersebut. Itu bukan izin untuk mengkloning suara orang lain, dan memberi label pada konten sintetis tidak mengizinkan penggunaan wajah atau suara orang lain tanpa izin.
Kebijakan editorial yang aman adalah menggunakan suara Anda sendiri atau suara berlisensi, menyimpan catatan izin untuk sampel suara khusus apa pun, menghindari meniru orang nyata tanpa otorisasi, memeriksa persyaratan penggunaan komersial, mengungkapkan konten sintetis atau yang diubah yang realistis ketika YouTube mengharuskannya, serta meninjau hak musik, rekaman, dan audio terjemahan secara terpisah. Untuk tim yang menghasilkan narasi berulang kali dari sistem atau aplikasi konten, Text to Speech API kami dibangun untuk pembuatan ucapan secara terprogram sehingga Anda dapat memproduksi trek dalam jumlah besar tanpa membangun ulang alur kerja setiap kali.
Jadi, apakah YouTube text to speech layak? Ia sangat cocok ketika Anda membutuhkan narasi yang dapat diulang, revisi cepat, versi multibahasa, atau sulih suara tanpa peralatan rekaman. Ia kurang cocok ketika keberhasilan video bergantung pada akting bernuansa, kesaksian pribadi, atau penampilan yang sensitif secara hukum. Standar yang penting bukanlah apakah pemirsa bisa mengetahui bahwa sebuah suara itu sintetis. Melainkan apakah narasi tersebut jelas, sesuai, konsisten, dapat digunakan secara hukum, dan terintegrasi dengan baik dengan video.
Pertanyaan yang sering diajukan
Bisakah saya menggunakan audio text-to-speech di YouTube?
Ya. Anda dapat menggunakan narasi yang dihasilkan dalam video YouTube selama Anda menghormati persyaratan lisensi penyedia TTS, kebijakan YouTube, serta hak yang terkait dengan naskah, musik, rekaman, dan suara Anda.
Apakah YouTube secara otomatis mengubah naskah menjadi narasi?
Tidak. Fitur Audio multibahasa YouTube tidak membuat trek dubbing Anda untuk Anda. Kreator harus menyiapkan dan mengunggah file audio mereka sendiri.
Apa perbedaan antara YouTube text to speech dan auto-dubbing?
Text to speech mengonversi teks tertulis menjadi audio ucapan. Auto-dubbing adalah proses lokalisasi yang lebih luas yang mungkin menerjemahkan dan menghasilkan trek bahasa pengganti untuk konten yang sudah ada. Fitur persisnya bergantung pada platform dan alur kerja.
Bisakah saya mengkloning suara saya untuk video YouTube?
Anda dapat menggunakan kloning suara ketika Anda memiliki hak untuk membuat dan menggunakannya. YouTube mencantumkan kloning suara Anda sendiri untuk sulih suara atau dubbing sebagai contoh yang tidak memerlukan pengungkapan di bawah kebijakan konten realistisnya, meskipun konten lain yang dihasilkan atau diubah AI mungkin masih memerlukan pengungkapan.
File audio apa yang harus saya unggah untuk bahasa kedua?
Untuk fitur Audio multibahasa YouTube, file harus dalam format khusus audio yang didukung dan kira-kira sama panjangnya dengan video. Periksa antarmuka unggah YouTube Studio saat ini sebelum Anda mengekspor.