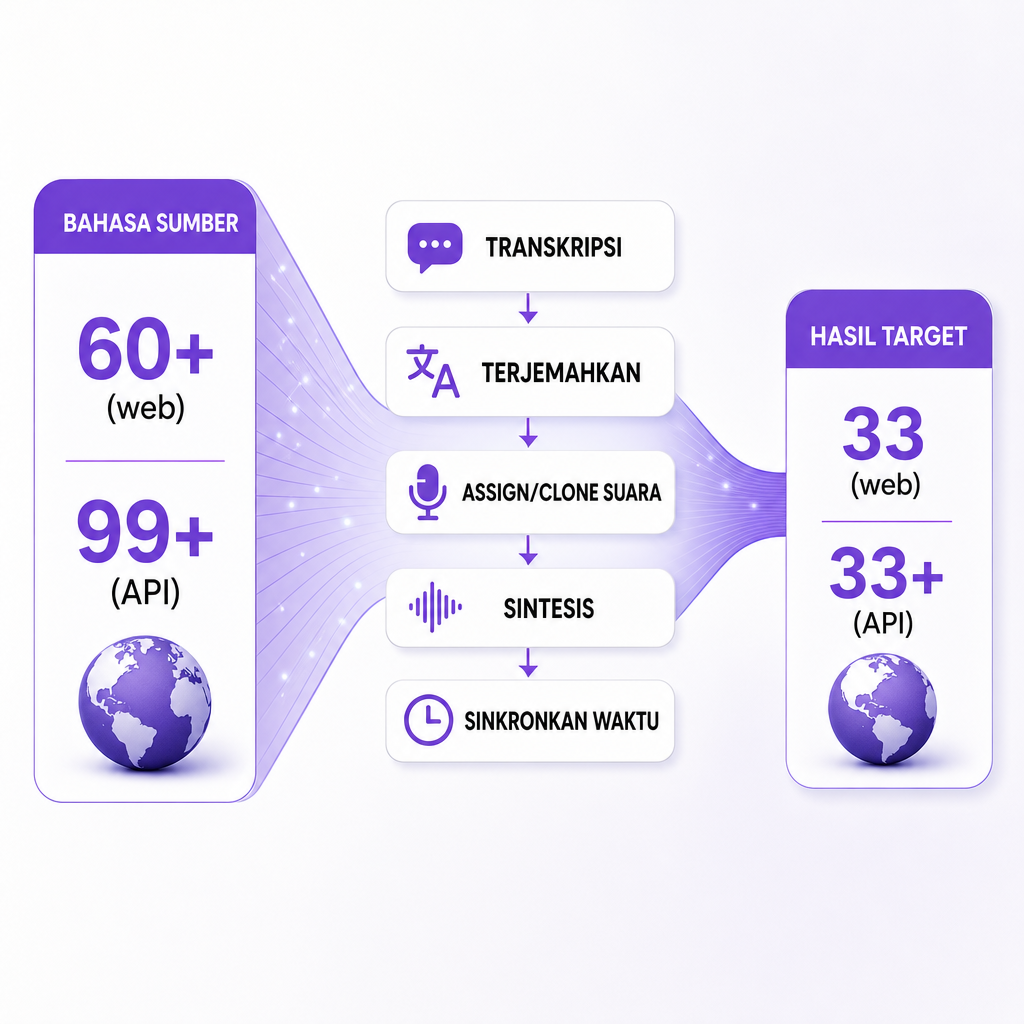
Jika Anda sedang mempertimbangkan ekspansi multibahasa, hal pertama yang perlu dipastikan adalah bahasa apa saja yang bisa dijadikan sulih suara oleh AI dengan platform yang benar-benar akan Anda gunakan. Jawaban jujurnya terdiri dari dua bagian: AI dubbing dapat mengenali konten lisan dalam daftar bahasa yang panjang, tetapi bahasa yang dapat ia hasilkan sebagai audio sulih suara jadi adalah daftar yang lebih pendek dan lebih menentukan. Dengan DubSmart AI, kami menyulihsuarakan konten dari 60+ bahasa sumber ke 33 bahasa target, dan API AI Dubbing kami dapat mendeteksi dan memproses konten dari 99+ bahasa sumber sambil menghasilkan 33+ keluaran bahasa target. Angka-angka itu tidak sama, dan menganggapnya dapat dipertukarkan adalah kesalahan perencanaan paling umum yang kami temui.
Sebelum Anda mengunci jadwal produksi berdasarkan jumlah bendera, ada baiknya memahami apa arti angka-angka itu, bahasa mana yang disebutkan, bagaimana keluaran multibahasa sebenarnya bekerja, dan apa yang masih memerlukan peninjauan manusia di setiap bahasa.
Daftar isi
Bahasa sumber versus bahasa target
Satu perbedaan yang mengatur seluruh topik ini adalah jarak antara input dan output. Bahasa sumber adalah apa pun yang diucapkan dalam file asli Anda. Bahasa target adalah apa yang diucapkan sulih suara jadi. Sebuah platform hampir selalu dapat mengenali lebih banyak bahasa sumber daripada yang dapat dihasilkannya sebagai keluaran yang halus, karena transkripsi dan terjemahan lebih mudah diperluas daripada pustaka lengkap suara yang terdengar alami dengan perilaku pengaturan waktu yang benar.
Jarak itu terlihat dalam angka-angka kami sendiri. Produk AI Dubbing berbasis web menyatakan 60+ bahasa sumber ke 33 target, sementara dokumentasi API menjelaskan pemrosesan konten dari 99+ bahasa sumber ke 33+ keluaran target. Angka-angka ini mencerminkan permukaan produk yang berbeda daripada satu statistik yang dapat dipertukarkan, jadi rencanakanlah berdasarkan daftar target, bukan angka pengenalan yang lebih besar.
| Kategori | Apa artinya | Bukti publik |
|---|---|---|
| Bahasa sumber | Diucapkan dalam file asli | 60+ (web), 99+ (API) |
| Bahasa target | Dihasilkan untuk sulih suara | 33 (web), 33+ (API) |
| Dialek / varian | Aksen atau kosakata regional | Didukung secara luas; tidak ada daftar publik lengkap |
| Bahasa suara | Apa yang dapat diucapkan oleh suara yang dipilih atau dikloning | Tergantung pada suara dan pengaturan proyek |
Kesimpulan praktisnya: jika file asli Anda dalam bahasa yang kurang umum, pengenalan jarang menjadi hambatan. Pertanyaan yang perlu dipastikan adalah apakah bahasa keluaran yang Anda tuju, dan varian regional spesifik, tersedia untuk suara yang Anda inginkan.
Bahasa target mana yang disebutkan DubSmart
Kami secara publik mengiklankan sulih suara ke 33 bahasa target, dan dokumentasi API secara eksplisit menyebutkan sekumpulan inti sambil mencatat "dan masih banyak lagi." Bahasa yang disebutkan adalah Inggris, Portugis, Spanyol, Prancis, Jerman, Mandarin, Jepang, Korea, Rusia, Arab, dan Hindi. Ini adalah contoh yang dikonfirmasi, bukan seluruh katalog.
Yang tidak kami publikasikan di halaman publik adalah daftar lengkap 33 bahasa atau inventaris dialek yang menyeluruh. Jadi, jawaban akurat dan tidak dilebih-lebihkan atas pertanyaan intinya adalah ini: kami dapat menyulihsuarakan ke 33 bahasa target, dengan sebelas bahasa di atas yang dikonfirmasi berdasarkan nama. Untuk bahasa yang kurang umum atau varian regional tertentu, pastikan ketersediaannya di dalam platform sebelum Anda mengikatkan jadwal produksi padanya.
AI dubbing di sini dapat menghasilkan 33 bahasa target, termasuk Inggris, Portugis, Spanyol, Prancis, Jerman, Mandarin, Jepang, Korea, Rusia, Arab, dan Hindi. Verifikasi bahasa atau dialek yang kurang umum dalam proyek sebelum menjadwalkannya.
Kebiasaan verifikasi-dulu itu lebih penting daripada angka utama. Sebuah bahasa yang muncul dalam daftar tidak menjamin jumlah suara, aksen, atau gaya ekspresif yang identik di setiap entri.
Bahasa mana yang masuk akal lebih dulu bagi kreator
Untuk kanal YouTube yang berbasis di AS, bahasa pertama yang tepat berasal dari analitik audiens Anda, bukan dari daftar sepanjang mungkin. Beberapa target saja membawa sebagian besar peluang awal.
Spanyol biasanya merupakan uji coba pertama yang logis karena menjangkau Amerika Serikat, Meksiko, Spanyol, dan sebagian besar Amerika Latin. Putuskan sejak awal apakah Anda menyasar Spanyol Amerika Latin atau Spanyol Eropa, karena kosakata, humor, dan referensinya berbeda. Portugis membuka Brasil dan Portugal, dan Portugis Brasil biasanya merupakan pilihan skala untuk kreator AS. Prancis menjangkau Prancis, Kanada, Belgia, Swiss, dan sebagian Afrika, meskipun idiom dan preferensi pengucapan bergeser di antara pasar-pasar tersebut.
Jerman cocok untuk konten edukatif, perangkat lunak, bisnis, dan teknis, dengan satu catatan yang perlu direncanakan: frasa bahasa Jerman yang diterjemahkan sering kali lebih panjang daripada aslinya dalam bahasa Inggris, sehingga pengaturan waktu mungkin perlu disesuaikan. Hindi bisa kuat untuk konten edukatif dan hiburan yang menyasar India dan audiens Hindi global, tetapi perhatikan ekspresi campuran Hindi-Inggris dan istilah teknis.
Mandarin, Jepang, dan Korea penting untuk ekspansi Asia Timur, di mana sapaan hormat, konvensi penulisan, dan gaya penyampaian menentukan apakah hasilnya terdengar native. Arab dan Rusia masing-masing mencakup beberapa wilayah, dan Arab khususnya membawa perbedaan nyata antara Bahasa Arab Standar Modern dan ragam regional. Kecocokan bahasa saja tidak pernah menjamin register yang tepat.
Bagaimana satu proyek menjadi beberapa bahasa
Alur kerja modern menghasilkan versi terlokalisasi terpisah per bahasa target daripada satu trek campuran. Dalam API kami, satu permintaan membawa beberapa kode target, misalnya Spanyol, Prancis, dan Jerman sebagai ["es", "fr", "de"], dan respons mengembalikan proyek grup terpisah untuk setiap bahasa. Struktur itulah yang memungkinkan agensi atau bisnis mengubah satu file master menjadi beberapa versi yang siap pasar tanpa mengunggah ulang.
Dalam sebuah proyek multibahasa, Anda dapat mencampur pendekatan: satu suara sintetis standar di mana-mana untuk konsistensi, suara yang terdengar native berbeda per pasar untuk kealamian, suara yang dikloning di mana Anda memegang hak, atau penyesuaian pengaturan waktu dan pengucapan per bahasa. Pilihannya biasanya bermuara pada satu pertimbangan: konsistensi merek versus keaslian lokal. Suara yang dikloning mempertahankan identitas pembicara di seluruh pasar; suara khusus pasar bisa saja terdengar lebih familier bagi audiens tertentu.
Jika Anda merencanakan ini di banyak aset, panduan kami tentang penskalaan produksi konten dengan AI membahas bagaimana satu master menjadi banyak keluaran terlokalisasi tanpa melipatgandakan perangkat alat Anda.
Dapatkah suara pembicara asli dibawa lintas bahasa?
Ya, dalam batas tertentu dan dengan tanggung jawab. AI Dubbing kami dapat mengkloning suara setiap pembicara, dan API AI Dubbing mendukung kloning suara di dalam alur kerja sulih suara, menganalisis kualitas seperti nada, pitch, aksen, dan gaya bicara. Itulah yang menjaga agar pembawa acara YouTube tetap dikenali dalam setiap bahasa, instruktur kursus konsisten di seluruh modul terlokalisasi, atau satu juru bicara koheren di seluruh pasar.
Bagian tanggung jawab tidak bisa ditawar. Kloning hanya audio yang Anda miliki atau yang Anda berwenang untuk memprosesnya. Untuk konten bermerek, komersial, atau yang menghadap publik, simpan catatan bahwa pembicara menyetujui kloning dan tujuan penggunaannya, terutama ketika karyawan, aktor, pelanggan, atau tokoh publik terlibat. Ketersediaan suara menurut bahasa juga bervariasi, jadi pastikan bahwa suara yang dikloning atau dipilih benar-benar mengucapkan bahasa target Anda sebelum Anda membangun satu musim atau kursus di sekitarnya.
Apa yang sebenarnya mengubah kualitas sulih suara per bahasa
Ketersediaan bahasa adalah filter pertama, bukan garis akhir. Beberapa faktor berinteraksi untuk menentukan apakah sulih suara terdengar native atau sekadar akurat.
Konteks terjemahan adalah tempat keluaran harfiah gagal. Humor, idiom, slogan, dan istilah khusus sering kali membutuhkan editor untuk merevisi naskah terjemahan sebelum audio dihasilkan. Pengucapan nama, akronim, istilah produk, dan lokasi sering kali memerlukan koreksi manual; sebuah transkrip bisa sempurna secara tata bahasa tetapi tetap terdengar salah saat diucapkan.
Pengaturan waktu dan laju bicara penting karena kalimat terjemahan jarang cocok dengan durasi aslinya. Alur kerja web kami mencakup pengaturan waktu yang dapat diedit, dan Dubbing Studio memungkinkan Anda meregangkan atau memampatkan audio agar pas. Identifikasi pembicara menjaga wawancara, panel, dan film tetap koheren; suara yang salah ditetapkan merusak kontinuitas bahkan ketika terjemahannya benar. Dialek dan aksen tidak dijamin oleh label bahasa, dan halaman publik kami tidak mencantumkan setiap dialek. Terakhir, adaptasi budaya menjangkau lebih dari sekadar trek suara: tinjau contoh, mata uang, teks di layar, dan ajakan bertindak secara terpisah.
Materi berisiko tinggi layak mendapat perhatian ekstra. Untuk konten medis, keuangan, hukum, keselamatan, atau kepatuhan, tambahkan peninjauan manusia dalam bahasa target daripada memercayai hasil pertama yang dihasilkan.
Menyesuaikan strategi bahasa dengan konten Anda
Rencana terbaik lebih bergantung pada audiens, jenis konten, dan sumber daya peninjauan Anda daripada pada cakupan mentah. Tabel di bawah ini memetakan situasi umum ke pendekatan yang masuk akal.
| Situasi | Pendekatan yang direkomendasikan |
|---|---|
| Menguji permintaan | Luncurkan satu atau dua bahasa berpotensi tinggi; bandingkan retensi dan geografi pemirsa |
| Kreator AS menuju global | Uji Spanyol lebih dulu, lalu tambahkan Portugis, Prancis, Jerman, atau bahasa yang didukung analitik |
| E-learning global | Prioritaskan bahasa dalam basis pembelajar; tinjau terminologi dengan pakar subjek |
| Video pemasaran | Lokalkan naskah, teks di layar, dan halaman arahan, bukan hanya suaranya |
| Podcast multi-pembicara | Pastikan deteksi pembicara, penetapan suara, dan penanganan latar belakang lebih dulu |
| Lokalisasi API dalam skala besar | Verifikasi kode bahasa, ketersediaan suara, batas, hak, dan penanganan kesalahan |
Dua pilihan tingkat klaster mendasari hampir setiap rencana. Pertama, sulih suara versus takarir: sulih suara menang untuk pemirsa yang melakukan banyak tugas, konten instruksional, dan branding bahasa lokal yang imersif, sementara subtitel menang ketika performa asli penting atau Anda membutuhkan cakupan cepat berdampak rendah di banyak bahasa. Rincian kami tentang sulih suara vs subtitel untuk video membahas keputusan itu secara mendalam. Kedua, untuk tim yang menjalankan peluncuran berulang, sebuah daftar periksa lokalisasi video menjaga bahasa, varian, pengaturan waktu, terminologi, dan persetujuan ditinjau setiap kali alih-alih secara ad hoc.
Sebelum merilis sulih suara apa pun, pastikan bahasa target cocok dengan pasar, varian regional sesuai, nama dan istilah teknis benar, pembicara ditetapkan secara konsisten, pengaturan waktu menghindari penyampaian yang terburu-buru atau teregang, teks di layar terlokalisasi, pemilik suara telah memberikan izin, dan peninjau tingkat native telah menyetujui. Jumlah bahasa yang dipublikasikan adalah sinyal cakupan, bukan jaminan kualitas.
Pertanyaan yang sering diajukan
Bahasa apa saja yang bisa dijadikan sulih suara oleh AI dengan DubSmart?
Kami secara publik mendukung 33 bahasa target, termasuk Inggris, Portugis, Spanyol, Prancis, Jerman, Mandarin, Jepang, Korea, Rusia, Arab, dan Hindi. Daftar lengkap 33 bahasa dan inventaris dialek penuh tidak dipublikasikan di halaman publik kami, jadi pastikan bahasa yang kurang umum di dalam platform.
Dapatkah satu video disulihsuarakan ke beberapa bahasa sekaligus?
Ya. API kami menerima beberapa kode target dalam satu permintaan, seperti Spanyol, Prancis, dan Jerman, dan mengembalikan proyek terlokalisasi terpisah untuk setiap bahasa dari satu file master.
Apakah AI dubbing mendukung dialek dan aksen regional?
Bisa, tetapi ketersediaannya bervariasi menurut bahasa dan suara. Kami mendukung beragam bahasa dan dialek serta terus memperluasnya, tanpa mempublikasikan daftar dialek lengkap. Mintalah peninjau native memeriksa pengucapan dan register sebelum menskalakan.
Apakah AI dubbing sama dengan text-to-speech?
Tidak. Text-to-speech mengubah teks yang disediakan menjadi audio. AI dubbing dimulai dari video atau audio yang sudah ada dan menambahkan transkripsi, terjemahan, penanganan pembicara, pembuatan suara, dan sinkronisasi dalam satu alur kerja.
Apakah semua bahasa AI dubbing sama-sama akurat?
Tidak. Kualitas bervariasi tergantung dialek, suara, kualitas audio, jumlah pembicara, terminologi, dan kompleksitas terjemahan. Perlakukan jumlah bahasa target sebagai cakupan, lalu verifikasi suara dan varian yang tepat untuk proyek spesifik Anda.