إذا سبق لك أن سمعت تعليقًا صوتيًا سلسًا على YouTube أو درسًا تعليميًا إلكترونيًا واضحًا وتساءلت عما إذا كان شخص ما قد سجله فعلًا، فأنت قد التقيت بالفعل بالتقنية التي تقف وراء هذا السؤال. ما هو مولّد الصوت بالذكاء الاصطناعي؟ ببساطة، هو برنامج يحوّل النص المكتوب أو مرجعًا صوتيًا إلى صوت منطوق باستخدام نماذج التعلم الآلي، بحيث يمكنك إنتاج التعليق الصوتي دون حجز استوديو أو ميكروفون أو ممثل صوتي مع كل تغيير في النص. هذه القدرة وحدها تغيّر كيفية تخطيط صانعي المحتوى والمسوّقين وبناة الدورات والمطورين لعملهم الصوتي.
يوضّح هذا الدليل ما هو مولّد الصوت بالذكاء الاصطناعي فعليًا، وكيف ينتج الكلام، وكيف يرتبط بتحويل النص إلى كلام واستنساخ الصوت، والمعايير التي تهم حقًا عند اختيار واحد منها. نحن نركّز على القرار، لا على الضجيج: الواقعية وحدها سبب ضعيف لاختيار أداة، لأن التحكم في النطق وتغطية اللغات والحقوق والخصوصية هي التي تقرر عادةً ما إذا كان المشروع سيُنجز بنظافة.
جدول المحتويات
كيف ينتج مولّد الصوت بالذكاء الاصطناعي الكلام فعليًا
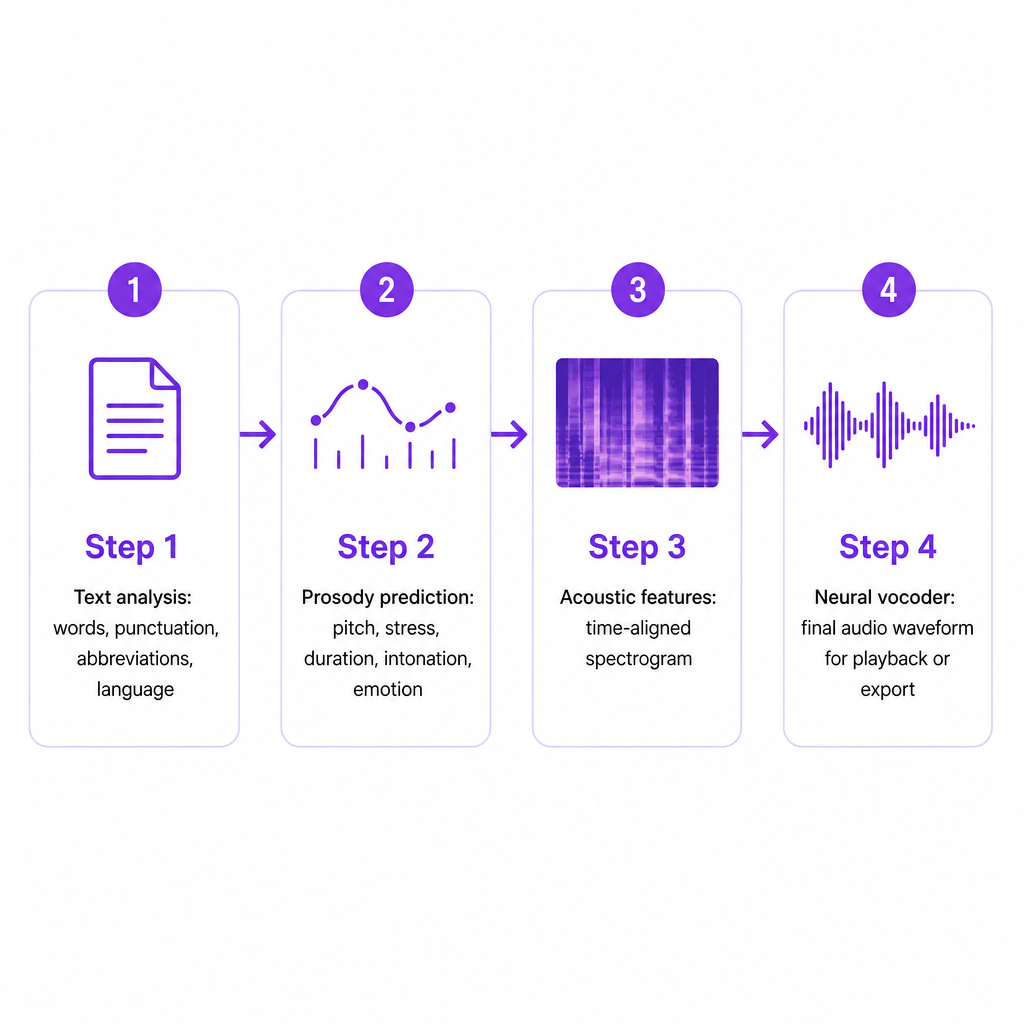
تعمل معظم مولّدات الصوت بالذكاء الاصطناعي على نماذج تحويل النص إلى كلام، أو TTS، ويحدث العمل على مرحلتين رئيسيتين: يحلّل النظام نصك، ثم يصنع الصوت من ذلك التحليل. تصف IBM أنظمة TTS بأنها تحلّل الكلمات وعلامات الترقيم وبنية الجملة والنطق والتوقيت والعروض الصوتية قبل تحويل النتيجة إلى موجة صوتية.
في مرحلة التحليل، يقرأ النموذج أكثر من الحروف الخام. فهو يحدد حدود الجمل، وعلامات الترقيم والوقفات، والاختصارات والأرقام، واللغة أو اللكنة المقصودة. هذا مهم لأن النص المكتوب نادرًا ما يخبرك كيف ينبغي أن يبدو. قد تحتاج كلمة "Dr." إلى أن تصبح "Doctor"، وقد يحتاج اسم منتج أو اختصار تقني إلى نطق مخصص لا يمكن لأي قاعدة افتراضية أن تخمّنه.
بعد ذلك، يتنبأ النموذج بطريقة الأداء: طبقة الصوت، والتشديد، ومدة الفونيم، والإيقاع، والتنغيم، والنبرة العاطفية. تُسمى هذه مجتمعةً العروض الصوتية (prosody)، وهي ما يفصل بين قراءة رتيبة وسرد يميّز السؤال عن التصريح. ثم يحوّل النظام هذا التحليل إلى سمات صوتية متوافقة زمنيًا، تُمثّل غالبًا كطيف ترددي يرسم تغيرات التردد عبر الزمن.
أخيرًا، يحوّل مرمّز صوتي عصبي (vocoder) تلك السمات الصوتية إلى موجة صوتية رقمية يمكن لمحررك تشغيلها أو تصديرها. تشير IBM إلى أن أنظمة TTS العصبية تتعلم العلاقة بين اللغة والسمات الصوتية من بيانات التدريب التي تحتوي على تسجيلات ونصوص مطابقة. إذا أردت المزيد من التفاصيل التقنية لهذه المرحلة، فإن شرحنا حول كيفية عمل تحويل النص إلى كلام العصبي يفصّل العملية أكثر.
مولّد الصوت بالذكاء الاصطناعي مقابل تحويل النص إلى كلام مقابل استنساخ الصوت
تأتي هذه المصطلحات معًا، لذا يفترض الناس أنها متطابقة. وهي ليست كذلك، والاختلافات تغيّر ما يمكنك فعله قانونيًا وعمليًا بالمخرجات.
| التقنية | ما تفعله | المدخل النموذجي | الأنسب لـ |
|---|---|---|---|
| مولّد الصوت بالذكاء الاصطناعي | مصطلح شامل للبرامج التي تنشئ كلامًا اصطناعيًا | نص، أو إعدادات صوت، أو مرجع صوتي | التعليقات الصوتية، والسرد، والمساعدين، والمحتوى |
| تحويل النص إلى كلام | يحوّل نصًا مكتوبًا إلى صوت منطوق | نص مكتوب | السرد، وإمكانية الوصول، والتعلم الإلكتروني، والبودكاست |
| استنساخ الصوت | يبني صوتًا اصطناعيًا مصممًا على أساس متحدث معين | تسجيلات صوتية مصرّح بها | سرد علامة تجارية أو صانع محتوى متسق، والشخصيات |
| الكلام إلى كلام | يعيد إنشاء صوت منطوق مع الحفاظ على الأداء | كلام مسجّل | الدبلجة، وتحويل الصوت، ونقل الأداء |
| الدبلجة بالذكاء الاصطناعي | يترجم ويعيد تصويت وسائط موجودة بلغة أخرى | فيديو أو صوت | النشر متعدد اللغات والترجمة والتوطين |
الفرق العملي هو المدخل والإذن المرتبط به. يُختار صوت TTS القياسي من مكتبة مزوّد الخدمة، لذا يمكنك استخدامه فورًا. أما الصوت المستنسخ فيُبنى من تسجيلات شخص معين، مما يعني أن الموافقة وحقوق الاستخدام تدخل في الاعتبار قبل أن تولّد كلمة واحدة. معاملة الاثنين كأنهما قابلان للتبادل هو الخطأ الأكثر شيوعًا لدى المبتدئين، وهو الخطأ ذو العواقب القانونية الأكبر.
ما يمكنك إنشاؤه به
نطاق المخرجات واسع: سرد YouTube، والتعليقات الصوتية القصيرة للمحتوى الاجتماعي، ومقدمات البودكاست، ومسودات الكتب الصوتية، وعروض المنتجات، ودروس الدورات عبر الإنترنت، ووحدات التدريب المؤسسي، وفيديوهات الشرح، وحوارات الألعاب، ورسائل خدمة العملاء، وصوت إمكانية الوصول، والنسخ متعددة اللغات لأي مما سبق.
ترتفع القيمة بشكل حاد عندما يتغير المحتوى كثيرًا، أو يحتاج إلى عدة لغات، أو يتطلب نسخًا متعددة لجماهير مختلفة. يمكن لشركة صغيرة كتابة نص منتج واحد وتوليد نسخ محلية. يمكن لصانع محتوى على YouTube استبدال مقدمة منقّحة دون إعادة تسجيل الفيديو بأكمله. يمكن لفريق تعلم إلكتروني تحديث درس بعد تعديل بضع جمل، بدلًا من إعادة حجز راوٍ. إذا كان صوتك يُنتَج مرة واحدة ولا يُمَس بعدها أبدًا، فإن المولّد يساعد أقل؛ أما إذا كان يتغير باستمرار، فإنه يساعد كثيرًا. يوضّح دليلنا حول تحويل النص إلى كلام عبر الإنترنت بسرعة كيف تتشكل تلك المسودة الأولى عمليًا.
الأنواع الشائعة للأصوات المولّدة بالذكاء الاصطناعي
لا يحمل كل خيار صوتي نفس تكلفة الإعداد أو نفس التزامات الحقوق، لذا من المفيد الفصل بين ثلاث فئات عملية قبل أن تلتزم.
الأصوات الجاهزة هي أصوات اصطناعية جاهزة توفرها المنصة، مصنّفة عادةً حسب الأسلوب، والتمثيل الجندري، والفئة العمرية، واللكنة، واللغة، والطاقة، ونوع السرد. تُتاح فورًا ولا تحتاج إلى أوراق موافقة، مما يجعلها الخيار الافتراضي الصحيح عندما تكون السرعة والاتساق أهم من مطابقة شخص بعينه.
الأصوات المخصصة أو المستنسخة تُولّد من تسجيلات متحدث معين، بحيث يمكن لصانع محتوى أو علامة تجارية أو مؤسسة الاحتفاظ براوٍ واحد يمكن التعرف عليه عبر العديد من الفيديوهات. ولأن الصوت يمكن أن يرتبط بهوية شخص حقيقي وسمعته، ينبغي ألا يحدث الاستنساخ إلا بإذن مستنير من المتحدث وفي إطار قواعد استخدام المزوّد.
أصوات الشخصيات والأصوات التعبيرية تستهدف سرد القصص، والألعاب، والرسوم المتحركة، أو التسويق، وغالبًا ما تتيح تحكمًا أدق في الإيقاع، والتشديد، والعاطفة، وأسلوب التحدث. يمكن للتعبيرية أن ترفع التفاعل، لكنها يجب أن تناسب المهمة: القراءة الدرامية تناسب إعلان فيلم خيالي وتضر فعليًا بتعليمات طبية أو إشعار امتثال.
المعايير التي تحدد الأداة المناسبة
يعتمد أفضل مولّد صوت بالذكاء الاصطناعي على المخرجات التي تحتاجها، لا على مدى جودة مقطع تجريبي. إليك ما يفصل فعليًا بين أداة يمكنك النشر بها وأداة تصارعها.
جودة الصوت، مُختبَرة بصدق. مرّر نصًا تمثيليًا من خلالها، لا جملة ترويجية قصيرة. أدرج الأسماء الحقيقية والمصطلحات وعلامات الترقيم وأطوال الجمل من مشروعك، ثم استمع إلى الأسماء المنطوقة بشكل خاطئ، والوقفات الغريبة، والتشديد غير الطبيعي، والكلمات المكررة، والعاطفة الرتيبة أو المبالغ فيها.
تغطية اللغات واللكنات. تأكد من أن الأداة تدعم اللغات واللكنات الإقليمية الدقيقة التي تحتاجها. قد تدعم منصة لغةً في واجهتها لكنها تقدّم أصواتًا أقل أو نطقًا أضعف بها. للتوطين، تحقق أيضًا مما إذا كانت تتعامل مع الترجمة، والدبلجة، واتساق الصوت عبر اللغات، ومحاذاة التوقيت.
عناصر التحكم في النطق والأداء. تحتاج إلى طريقة موثوقة لتصحيح الأسماء والاختصارات والأرقام من خلال قواميس النطق، أو التهجئة الصوتية، أو التنسيق القابل للتحرير، بالإضافة إلى عناصر تحكم في السرعة، والوقفات، والتشديد، وطبقة الصوت، والنبرة، والأداء العاطفي. تتيح لك أداة تحويل النص إلى كلام لدينا الاختيار من بين أكثر من 300 صوت ذكاء اصطناعي، وضبط معدل الكلام، وإضافة العاطفة من خلال علامات الحوار، والتأكيد على الكلمات، وكتابة الأرقام بالحروف عندما يحتاج النطق إلى تصحيح.
خيارات التحرير والتصدير وواجهة برمجة التطبيقات (API). قد يكفي محرر المتصفح لصانعي المحتوى. غالبًا ما يهتم المطورون والوكالات أكثر بتوليد الصوت تلقائيًا داخل تطبيق أو خط إنتاج فيديو، حيث يهم المصادقة، والصيغ المدعومة، والتوليد المتزامن مقابل غير المتزامن، وحدود المعدل، والتسعير المتوقع. إذا كنت تدرس الاستخدام البرمجي، فإن تمهيدنا حول ما هي واجهة برمجة تطبيقات الصوت بالذكاء الاصطناعي يغطي نقاط التقييم تلك بالتفصيل.
الحقوق التجارية وشروط الاستخدام. قبل النشر، تأكد مما إذا كان الاستخدام التجاري مسموحًا به، وما إذا كان يمكن تشغيل الصوت في إعلانات مدفوعة، وما إذا كان الاستنساخ يتطلب توثيق موافقة، وما إذا كان الترخيص يتغير بعد انتهاء الاشتراك. لا تفترض أن الخطة المجانية تمنح حقوقًا تجارية غير مقيدة.
الخصوصية ومعالجة البيانات. يمكن أن تحمل التسجيلات الصوتية معلومات بيومترية أو شخصية أو حساسة تجاريًا. راجع مدة التخزين، وعناصر التحكم في الحذف، والتشفير، وسياسات بيانات التدريب، خاصةً لتسجيلات الموظفين، ومكالمات العملاء، والوسائط غير المنشورة، والأصوات المستنسخة.
القيود والمخاطر التي تستحق أخذها على محمل الجد
توليد الصوت بالذكاء الاصطناعي مفيد، لكنه ليس معصومًا من الخطأ، وهناك بعض المخاطر التي تستحق اهتمامًا حقيقيًا.
أخطاء النطق والسياق أمر روتيني: تخطئ النماذج في قراءة الأسماء، والكلمات المتجانسة إملائيًا، والأرقام، ومصطلحات الصناعة، لذا يحتاج المحتوى القانوني والمالي والطبي والتعليمي والتقني دائمًا إلى استماع كامل قبل الإصدار. يمكن أن تفشل العاطفة أيضًا؛ قد يبدو الصوت طبيعيًا جملةً بجملة لكنه يضع التشديد في المكان الخطأ، مما يُقرأ على أنه مشتِّت أو حتى مضلِّل.
تتعلق المخاطر الأثقل بالهوية. يمكن إساءة استخدام استنساخ الصوت لتقليد أفراد العائلة، أو المديرين التنفيذيين، أو الشخصيات العامة. تحذّر لجنة التجارة الفيدرالية (FTC) من أن المحتالين يستخدمون أصواتًا مستنسخة لجعل طلبات المال أو المعلومات الشخصية تبدو أكثر مصداقية، وتوصي بالتواصل بشكل مستقل مع المتحدث المفترض عبر رقم موثوق أو قناة أخرى معروفة. وتحدد NIST بالمثل المحتوى الاصطناعي، بما في ذلك الصوت، كمادة يمكن استخدامها لتضليل الناس أو دعم الاحتيال، بما في ذلك محاولات هزيمة المصادقة البيومترية.
وهذا يقود إلى مجموعة مسؤوليات عملية: ولّد الأصوات فقط من نصوص وتسجيلات مصرّح لك باستخدامها، واحصل على موافقة واضحة قبل استنساخ أي شخص، واحتفظ بسجلات الإذن، ولا تنشر أبدًا صوتًا مستنسخًا للخداع. تحقق من صحة النص قبل التوليد النهائي، وأفصح عن السرد الاصطناعي عندما تكون الشفافية ملائمة أو مطلوبة، واحمِ التسجيلات المرفوعة، وعيّن مراجعًا بشريًا للمحتوى عالي التأثير. تنتج الأتمتة الصوت؛ لكنها لا تضمن الدقة أو الملاءمة الثقافية أو السلامة.
صوت بالذكاء الاصطناعي أم ممثل صوتي بشري؟
هذان ليسا بديلين تلقائيين، والإجابة الصادقة لكثير من الفرق هي "كلاهما، لمهام مختلفة".
| الاعتبار | مولّد الصوت بالذكاء الاصطناعي | ممثل صوتي بشري |
|---|---|---|
| سرعة الإنتاج | سريع للمراجعات والنسخ المتعددة | يحتاج إلى جدولة وتسجيل |
| هيكل التكلفة | عادةً قائم على الاستخدام أو الاشتراك | رسوم المواهب والاستوديو |
| الاتساق | قابل للتكرار عبر كميات كبيرة | يعتمد على الظروف والتوجيه |
| الدقة العاطفية | في تحسن، تختلف حسب الأداة والنص | يستجيب ديناميكيًا للتوجيه |
| إدارة الحقوق | يحتاج إلى مراجعة الصوت الاصطناعي والترخيص | يحتاج إلى اتفاقيات المواهب والاستخدام |
| أفضل حالة استخدام | محتوى عالي الحجم، ومنقّح، ومتعدد اللغات | العمل المتميز والمعقد عاطفيًا |
تقسيم شائع: دع صوت الذكاء الاصطناعي يتولى المسودات، والتدريب الداخلي، والنسخ المحلية، والتحديثات الروتينية، بينما يحمل مؤدٍّ بشري الحملة الرئيسية أو المواد الحساسة عاطفيًا. اتخذ قرارك بناءً على احتياجات الجودة، والحقوق، والخصوصية، وطاقة المراجعة، وتغطية اللغات، وإجمالي تكلفة الإنتاج بدلًا من لمعان العرض التجريبي وحده. عندما يكون التوطين هو الهدف، يعيد سير عمل الدبلجة بالذكاء الاصطناعي لدينا تصويت المحتوى الموجود عبر 33 لغة بحيث يمكن لمصدر واحد الوصول إلى عدة أسواق.
الأسئلة الشائعة
ما هو مولّد الصوت بالذكاء الاصطناعي بعبارات بسيطة؟
هو أداة تنشئ صوتًا منطوقًا من نص أو مدخل صوتي آخر. تعمل معظمها على نماذج تحويل النص إلى كلام مدرّبة على تسجيلات كلام ونصوص لإنتاج سرد اصطناعي.
هل مولّد الصوت بالذكاء الاصطناعي هو نفسه تحويل النص إلى كلام؟
ليس دائمًا. تحويل النص إلى كلام هو نوع واحد من توليد الصوت بالذكاء الاصطناعي. تشمل الفئة الأوسع أيضًا استنساخ الصوت، وتحويل الكلام إلى كلام، والدبلجة بالذكاء الاصطناعي.
هل يمكن لأصوات الذكاء الاصطناعي أن تبدو بشرية؟
يمكنها أن تبدو طبيعية للغاية، لكن الجودة تختلف حسب المزوّد، واللغة، والصوت، والنص، والأداء. لا تزال دقة النطق والعاطفة تحتاج إلى مراجعة بشرية قبل النشر.
هل يمكنني استخدام صوت مولّد بالذكاء الاصطناعي على YouTube؟
غالبًا نعم، شريطة أن يسمح ترخيص الأداة باستخدامك المقصود وأن يتبع المحتوى سياسات YouTube. تحقق من شروط الاستخدام التجاري، وقواعد الإفصاح، والسياسات المتعلقة بالمحتوى المضلِّل أو المنتحِل.
هل الأصوات المولّدة بالذكاء الاصطناعي مجانية؟
تقدّم بعض الخدمات وصولًا مجانيًا أو أرصدة مجانية؛ بينما تتقاضى أخرى رسومًا حسب الأحرف، أو المدة، أو الأرصدة، أو الاشتراك، أو استخدام واجهة برمجة التطبيقات. قارن التكلفة الكاملة لحجم إنتاجك المتوقع بدلًا من المخصص المجاني المعلن.