واجهة برمجة تطبيقات الصوت بالذكاء الاصطناعي (voice AI API) هي الاتصال القابل للبرمجة الذي يتيح لتطبيقك إنشاء الصوت المنطوق أو فهمه أو تحويله أو توطينه باستخدام نماذج ذكاء اصطناعي لا تحتاج إلى بنائها بنفسك. تُرسل نصًا أو صوتًا أو فيديو إلى نقطة نهاية وتحصل على شيء مفيد في المقابل: سرد مُركّب، أو نص مكتوب، أو صوت مخصص، أو فيديو مدبلج بالكامل. والسؤال الحقيقي عند البدء ليس ما إذا كنت بحاجة إلى "صوت الذكاء الاصطناعي"، بل أي قدرة صوتية يحتاجها منتجك فعليًا، لأن توليد الكلام، والتعرف على الكلام، واستنساخ الصوت، والدبلجة منتجات متمايزة تتشارك مصادفةً في اسم فئة واحد.
يستعرض هذا الدليل معنى المصطلح، وأنواع واجهات البرمجة الرئيسية وكيف تختلف، وكيف ينتقل الطلب عبر المسار، ومعايير القرار التي تفصل بين الخيار المناسب والخطأ المكلف، والمخاطر الجديرة بالإدارة قبل الإطلاق. إنه المحور لسلسلتنا الخاصة بالمطورين وواجهات البرمجة، لذا ستجد روابط للأدلة الأعمق حول التكامل حيثما كانت مفيدة.
جدول المحتويات
ماذا يعني "voice AI API" فعليًا
تجمع العبارة بين ثلاث أفكار. صوت الذكاء الاصطناعي هو ذكاء اصطناعي يعمل مع الكلام البشري أو يولّد كلامًا اصطناعيًا. API هي واجهة برمجة التطبيقات، أي طريقة محددة لنظامي برمجيات لتبادل الطلبات والاستجابات. والمزيج يعني أن معالجة النموذج الثقيلة تحدث على جانب المزوّد، بينما يتولى تطبيقك تجربة المستخدم وقواعد عملك والمحتوى النهائي.
يمكن أن يكون الطلب بسيطًا كحمولة JSON قصيرة تتضمن النص الذي تريد نطقه، ومُعرّف صوت، ورمز لغة. وتُرجع الاستجابة عادةً مُعرّف مشروع، وحالة معالجة، ورابطًا للصوت المُولّد بمجرد جاهزيته. أما لتوطين الفيديو، فيشير الطلب بدلاً من ذلك إلى ملف مرفوع وقائمة باللغات المستهدفة.
هذه البنية هي ما يفصل واجهة البرمجة عن مولّد الصوت المعتمد على المتصفح. فتطبيق الويب مُصمَّم ليشغّله شخص يدويًا، مهمة واحدة في كل مرة. أما واجهة البرمجة فمُصممة لتستدعيها البرمجيات بشكل متكرر وتلقائي وعلى نطاق واسع. إذا كنت تنتج تعليقًا صوتيًا عرضيًا واحدًا، فإن أداة الويب غالبًا ما تكون أسرع. أما إذا كنت تُوطّن كل فيديو تنشره، فإن واجهة البرمجة هي المقصد.
الأنواع الخمسة الرئيسية لواجهات برمجة الصوت بالذكاء الاصطناعي
"voice AI API" فئة وليست تقنية واحدة. تأخذ الأنواع الخمسة الشائعة مدخلات مختلفة وتُرجع مخرجات مختلفة، واختيار النوع الخاطئ يُهدر وقت التكامل. يُقدّم الجدول أدناه مطابقةً لها لتتمكن من مواءمة مادتك الأولية مع النتيجة التي تريدها.
| نوع واجهة البرمجة | المدخل | المخرج | الاستخدام المعتاد |
|---|---|---|---|
| تحويل النص إلى كلام | نص مكتوب | صوت كلام اصطناعي | السرد، وإمكانية الوصول، ومطالبات التطبيقات، والتدريب |
| تحويل الكلام إلى نص | كلام أو فيديو | نص مكتوب | التسميات التوضيحية، والبحث، ومحاضر الاجتماعات، وإعادة الاستخدام |
| استنساخ الصوت | عينة صوتية مُصرّح بها | صوت اصطناعي مخصص | أصوات العلامات التجارية، والمقدّمين المتكررين، والسرد متعدد اللغات |
| الدبلجة بالذكاء الاصطناعي | فيديو أو صوت | وسائط مترجمة ومنطوقة | توطين YouTube، والدورات، والأفلام، والبودكاست |
| تحويل الكلام إلى كلام | كلام مُسجّل | كلام مُحوّل أو مُترجم | تحويل الصوت، والإنتاج متعدد اللغات |
قاعدة الاختيار مباشرة. إذا كان لديك بالفعل نص، فإن تحويل النص إلى كلام هو عادةً المسار الأبسط. وإذا كان لديك تسجيل يحتاج إلى نص مكتوب، فأنت بحاجة إلى تحويل الكلام إلى نص. وإذا كنت تريد هوية المقدّم نفسها عبر عدة لغات، فإن استنساخ الصوت أو الدبلجة أكثر ملاءمة. وللحصول على شرح مركّز على جانب التحويل من النص إلى كلام فقط، يتعمّق دليلنا المرافق حول ماهية واجهة برمجة تحويل النص إلى كلام في مسار التركيب.
تمييز يستحق الذكر: استنساخ الصوت ليس مُغيّر صوت. فمُغيّر الصوت يحوّل أداءً موجودًا في مكانه، بينما يُنشئ الاستنساخ نموذج صوت قابلاً لإعادة الاستخدام يُولّد كلامًا جديدًا من النص أو من مدخل آخر مُتحكَّم فيه.
كيف ينتقل الطلب عبر المسار
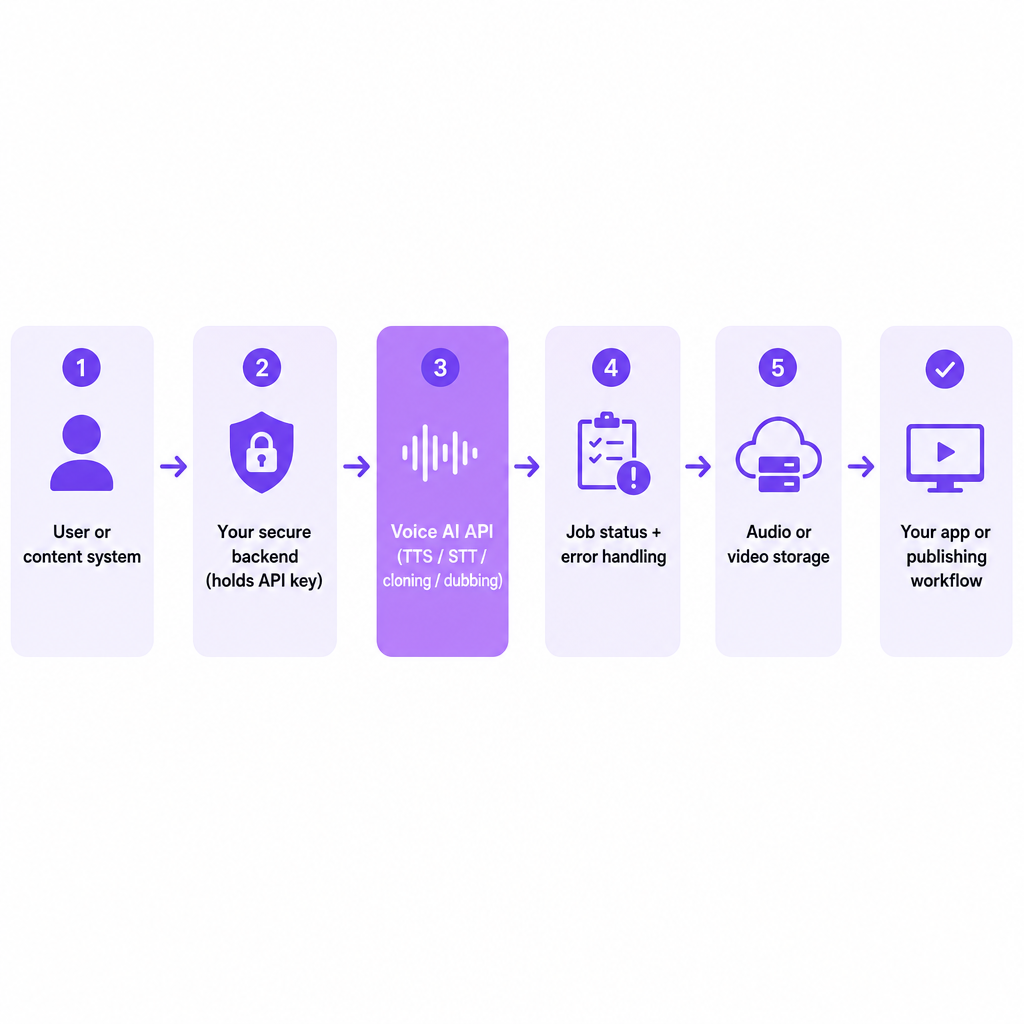
تتفاوت التطبيقات، لكن معظم واجهات برمجة الصوت تتبع المراحل الأربع نفسها. فهم شكل التدفق يوفّر ساعات من التخمين عندما يُرجع شيء ما حالة غير متوقعة.
أولًا، يُصادق تطبيقك على الهوية. يرسل مفتاح واجهة برمجة أو رمز bearer في ترويسة الطلب. فواجهة برمجة تحويل النص إلى كلام من DubSmart، على سبيل المثال، تستخدم نقطة نهاية REST مع مصادقة برمز bearer وطلبات JSON مقابل عنوان URL الأساسي https://dubsmart.ai/api/v1. وقاعدة أهم مما تبدو عليه: لا تضع أبدًا مفتاحًا خاصًا في JavaScript على جانب المتصفح أو في تطبيق جوال موزّع. خزّنه على خادم آمن واجعل عميلك يستدعي ذلك الخادم.
ثانيًا، يرسل تطبيقك المحتوى والإعدادات. يحمل الطلب عادةً مزيجًا من النص أو مرجع ملف، واللغة المصدر والمستهدفة، ومُعرّف صوت، والسرعة أو طبقة الصوت، ومعلومات المتحدث، وتفضيلات المخرج، وبيانات تعريف المشروع. ولتحويل النص إلى كلام البسيط، يكون المحتوى نصًا. أما للدبلجة، فغالبًا ما تتطلب واجهة البرمجة رفع فيديو أولًا، ثم طلبًا منفصلًا لإنشاء المشروع.
ثالثًا، تعالج الخدمة المحتوى. وبحسب المهمة، قد يعني ذلك تطبيع النص وتفسيره، والتنبؤ بالنطق والإيقاع، وترجمة المحتوى المنطوق، وفصل المتحدثين أو عزل الكلام عن الصوت الخلفي، وتوليد الصوت بصوت قياسي أو مخصص، ومزامنة النتيجة مع الخط الزمني للفيديو. تعمل المهام الأطول بشكل غير متزامن: فبدلًا من إرجاع ملف جاهز، تُرجع واجهة البرمجة مُعرّف مشروع.
رابعًا، يسترجع تطبيقك النتيجة، وهي رابط صوت أو فيديو، وروابط مقاطع فردية، ونص مكتوب، ونص مُترجم، وبيانات توقيت، وحقول حالة أو خطأ. توثّق واجهة برمجة تحويل النص إلى كلام من DubSmart حالات مشروع مثل pending وprocessing وcompleted وfailed، ويمكن للمشاريع المكتملة إرجاع روابط MP3 على مستوى المشروع أو المقطع.
المتزامن مقابل غير المتزامن: الفرق الذي يحدد بنية مشروعك
طريقة إرجاع واجهة البرمجة للنتائج تحدد كيفية بناء بنيتك حولها، لذا احسم هذا قبل كتابة كود التكامل.
تُبقي واجهة البرمجة المتزامنة الطلب مفتوحًا حتى تنتهي المعالجة، ثم تُرجع النتيجة. وهذا يعمل جيدًا للنصوص القصيرة، والمطالبات الصوتية الموجزة، والمقاطع الصوتية الصغيرة، والميزات التفاعلية منخفضة الكمون. ونقطة ضعفها أن المهام الطويلة قد تتجاوز مهل انتهاء الطلب.
تُرجع واجهة البرمجة غير المتزامنة مُعرّف مشروع أو مهمة على الفور. ثم يستطلع تطبيقك نقطة نهاية الحالة أو يتلقى webhook عند انتهاء المهمة. يناسب هذا النموذج السرد الطويل، ودبلجة الفيديو، واللغات المستهدفة المتعددة، والتوليد بالدفعات، والملفات الكبيرة. وتستخدم مسارات عمل تحويل النص إلى كلام والدبلجة الموثقة من DubSmart حالات المشاريع واسترجاع النتائج، وهو نمط غير متزامن مُصمّم لمهام الوسائط.
عند تقييم خيار ما، تحقّق مما إذا كان يدعم webhooks. فالاستطلاع كل بضع ثوانٍ تطبيقه تافه، لكن webhooks تقلّل الطلبات غير الضرورية وتتوسّع بشكل أفضل بمجرد تشغيلك العديد من المهام في آنٍ واحد.
ما الذي ينبغي تقييمه قبل الالتزام
تعتمد واجهة البرمجة المناسبة على المهمة، لكن حفنة من المعايير تنطبق على كل مشروع تقريبًا. استعرضها بتأنٍ بدلًا من الوثوق بعرض توضيحي قصير.
ملاءمة القدرة. تأكد من أن واجهة البرمجة تدعم المهمة بالضبط، سواء تحويل النص إلى كلام، أو الكلام إلى نص، أو استنساخ الصوت، أو الدبلجة، أو تعدد المتحدثين، أو المخرج الصوتي فقط أو مخرج الفيديو، أو الوقت الفعلي أو الدفعات. لا تفترض أن كل ما يُسوَّق على أنه "صوت ذكاء اصطناعي" يتضمن كل هذه.
تغطية اللغات. تحقّق من اللغات المصدر و المستهدفة. فعبارة "يدعم 30 لغة" قد تعني 30 صوتًا لتحويل النص إلى كلام، أو 30 هدف ترجمة، أو مزيجًا من اللغات واللهجات. ولقناة متعددة اللغات، وازن أيضًا جودة اللكنة، ونطق الأسماء والأماكن، والمفردات الإقليمية، وتوفر الأصوات لكل لغة، وما إذا كان صوت مستنسخ واحد ينتقل عبر اللغات.
دعم المخرجات والوسائط. تحقّق من صيغ الصوت، وحاويات الفيديو، ومعدل العيّنة ومعدل البت، والتنزيلات على مستوى المقطع، والفيديو المُقدَّم بالكامل، وتوفر النص المكتوب أو الترجمة، والحد الأقصى لحجم الملف. فهذه تُشكّل سير عمل التحرير وتكاليف التخزين لديك.
الجودة وإمكانية التحكم. أنصت للوقفات الطبيعية، والنطق الصحيح، ومستوى الصوت المستقر، وهوية المتحدث المتسقة، والتأكيد المناسب، والتوقيت الدقيق. قد يبدو صوت ما خاليًا من العيوب في عينة مدتها عشر ثوانٍ ثم يتعثّر في المصطلحات التقنية، أو الفقرات الطويلة، أو الأرقام، أو الأسماء غير المألوفة. اختبر محتوى تمثيليًا، لا المقطع الذي انتقاه البائع بعناية.
الكمون والإنتاجية. قِس الوقت مقابل عبء عملك الحقيقي. فتعليق صوتي قصير واحد ومئات مقاطع الفيديو المُوطّنة مشكلتان مختلفتان. اسأل عمّا إذا كانت المعالجة في الوقت الفعلي أم غير متزامنة، وما هي حدود المعدّل، وما إذا كانت المهام تعمل بالتوازي، وما إذا كانت المعالجة ذات الأولوية موجودة، وكيف تُعاد محاولة الإخفاقات. تذكر DubSmart أن معالجة فيديو مدته خمس دقائق عادةً تستغرق نحو دقيقة واحدة، مشيرةً إلى أن التوقيت يعتمد على الطول وحجم الملف.
نموذج التسعير. قد تحتسب واجهات برمجة الصوت الفاتورة حسب الأحرف، أو الكلمات، أو مدة الصوت أو الفيديو، أو الأرصدة، أو الطلبات، أو التخزين، أو المهام المتزامنة. وللدبلجة، يضاعف عدد اللغات المستهدفة التكلفة الفعلية. احسب سير عمل كاملًا، بما في ذلك إعادة المحاولات، والمقاطع المُعاد توليدها، ومراجعة الترجمة، والتخزين، لا الاستدعاء الأول فقط. يستعرض تحليلنا لـتسعير واجهة برمجة الصوت بالذكاء الاصطناعي حسابات الأرصدة بالتفصيل.
مخاطر تستحق الإدارة مبكرًا
يُدخل صوت الذكاء الاصطناعي أنماط إخفاق لا توجد في أدوات الوسائط العادية. ومعالجتها أثناء التصميم أرخص بكثير من معالجتها بعد خطأ علني.
الاستخدام غير المصرّح به للصوت. استنساخ صوت شخص دون إذن يخلق مخاطر قانونية وأخلاقية وتتعلق بالسمعة. استخدم عملية موافقة مكتوبة تُسمّي من يملك التسجيل، وما الذي يجوز توليده، وأين يجوز استخدام الصوت، وما إذا كان الاستخدام التجاري مسموحًا، وكيف يُحذف الصوت، وما الذي يحدث عند انتهاء الاتفاق.
الترجمة أو النطق غير الصحيح. قد يُسيء الكلام المُولّد التعامل مع الأسماء، والاختصارات، والعناوين، ومصطلحات القطاع. أبقِ المراجعة البشرية ضمن الحلقة للمحتوى الموجّه للجمهور: قراءة للنص المترجم، وإنصات من متحدث أصلي، وتدقيقات عشوائية للنطق، ومرور على التوقيت وحركة الشفاه، ومراجعة نهائية للوسائط المُصدَّرة.
انتحال الشخصية والاحتيال. يمكن إساءة استخدام الأصوات الاصطناعية في عمليات الاحتيال أو التأييدات الزائفة. تجنّب توليد أي شيء قد يجعل مستمعًا عاقلًا يظن أن شخصًا حقيقيًا قال شيئًا لم يقله. وللاتصالات الحساسة، أضف الإفصاح، وضوابط الموافقة، وسجلات التدقيق.
خصوصية الصوت والبيانات. قد تحتوي العينات على بيانات شخصية. قبل الرفع، احسم الموافقة، وقواعد الاحتفاظ، وقيود الوصول، وإجراءات الحذف، وشروط معالجة البيانات لدى البائع، وأي سياسة للاستخدام الثانوي. تذكر DubSmart أن ملفات الاستنساخ المرفوعة مُشفّرة وأن المستخدمين يمكنهم حذف الأصوات المخصصة وبيانات الصوت المرتبطة، وإن كان على الفرق مع ذلك تأكيد الشروط والضوابط الحالية لخطتهم المحددة.
تغييرات البائع والنموذج. قد تتغيّر مُعرّفات الأصوات، ودعم اللغات، وصيغ المخرجات، وحدود المعدّل. تعامل مع واجهة البرمجة بوصفها اعتمادًا خارجيًا: ثبّت التهيئة حيثما استطعت، وخزّن النصوص المصدر، واحفظ الصوت المُعتمد، وراقب معدلات الأخطاء، واحتفظ بسير عمل احتياطي، وأعد الاختبار بعد تحديثات البائع الكبرى. وللفرق التي تريد أجزاءً متحركة أقل، يشرح استعراضنا لـأدوات الفيديو الشاملة بالذكاء الاصطناعي المفاضلات في دمج هذه القدرات.
متى تتفوق واجهة البرمجة على سير العمل اليدوي
تستحق واجهة برمجة الصوت بالذكاء الاصطناعي تكلفة تكاملها عندما تحتاج إلى إنتاج قابل للتكرار وبرمجي. إنها خيار قوي عندما ينشر منشئ محتوى نسخًا مُوطّنة من كل فيديو، أو يُولّد نشاط تجاري صغير سردًا للمنتجات عبر عدة لغات، أو تُحدّث شركة تعليم إلكتروني مئات الدروس، أو يُطلق بودكاست إصدارات مترجمة، أو يضيف منتج برمجي إمكانية وصول منطوقة، أو تربط وكالة توليد الصوت بنظام إدارة المحتوى الخاص بها.
لا يزال بإمكان سير عمل الاستوديو اليدوي أن يفوز في حالات محددة: عندما يتوقف مشروع على أداء بشري بالغ الدقة، أو عندما تتطلب الموافقة القانونية ممثلًا محترفًا، أو عندما يحمل المحتوى ادعاءات حساسة، أو عندما يكون التسجيل لمرة واحدة أسرع من بناء تكامل، أو عندما تحتاج النتيجة إلى توجيه فني مكثّف. ليست الغاية استبدال كل صوت بشري، بل أتمتة الأجزاء التي يكون فيها الاتساق أو السرعة أو النطاق أو المخرجات متعددة اللغات هو الأهم.
لبناء صغير، أبقِ البنية بسيطة. تقع خلفية آمنة بين المستخدم أو نظام المحتوى لديك وبين واجهة برمجة الصوت. تُبقي هذه الخلفية بيانات الاعتماد خاصة، وتتحقق من المدخلات، وتُنشئ المشاريع، وتخزّن مُعرّفات المهام، وتستطلع الحالة أو تتلقى webhooks، وتعيد محاولة الإخفاقات المؤقتة، وتحفظ روابط النتائج وبياناتها التعريفية، وتطبّق حدود الاستخدام، وتسجّل الموافقة لأي صوت مستنسخ. وقد تقبل نسخة موجّهة لمنشئ المحتوى فيديو إنجليزيًا جاهزًا، وترسله إلى نقطة نهاية الدبلجة للغات المختارة، وتنتظر الاكتمال، وتوجّه النتائج إلى مجلد مراجعة، ولا تنشر إلا بعد الموافقة.
أين يناسب DubSmart
نحن نبني عدة قدرات لواجهات برمجة متعلقة بالصوت في منصة وسائط واحدة بالذكاء الاصطناعي، وهو ما يكون أهم ما يكون عندما تريد ربط التوليد والتوطين بسير عمل قائم بدلًا من تشغيل كل مهمة يدويًا.
توفّر واجهة برمجة تحويل النص إلى كلام لدينا توليد كلام برمجيًا بأصوات عصبية، واستنساخ الصوت، ودعمًا متعدد اللغات، وتتبّع حالة المشروع، ونتائج MP3؛ ويستخدم طلب المثال الخاص بها مقاطع نصية مع مُعرّف صوت، ولغة، وسرعة، وطبقة صوت. وتتّبع واجهة برمجة استنساخ الصوت لدينا نمطًا من ثلاث خطوات: طلب رابط رفع مُوقّع مسبقًا، ورفع عينة صوتية، ثم إنشاء صوت مخصص من مفتاح الملف المرفوع؛ وهي تقبل MP3 وWAV وAAC وM4A وFLAC، ونوصي بما لا يقل عن 20 ثانية من الصوت النظيف للحصول على نتائج أفضل. وتتعامل واجهة برمجة الدبلجة بالذكاء الاصطناعي لدينا مع توطين الفيديو بإنشاء مشاريع متعددة اللغات، وإعدادات المتحدثين، والمقاطع المترجمة، ومخرجات مدبلجة قابلة للتنزيل، وتقبل مدخلات مثل MP4 وMOV وAVI وMKV وWebM حتى 5 جيجابايت.
إذا كنت توازن بأي نقطة نهاية تبدأ، فطابقها مع محتواك: السرد المكتوب يشير إلى تحويل النص إلى كلام، والصوت المتكرر المُصرّح به يشير إلى الاستنساخ، والفيديو متعدد اللغات يشير إلى الدبلجة.
الأسئلة الشائعة
ما هي واجهة برمجة الصوت بالذكاء الاصطناعي ببساطة؟
إنها اتصال يتيح للبرمجيات توليد الكلام أو التعرف عليه أو استنساخه أو ترجمته أو تحويله دون بناء نظام صوت ذكاء اصطناعي خاص بها. يرسل تطبيقك طلبًا ويتلقى صوتًا أو نصًا أو فيديو مُعالَجًا.
هل واجهة برمجة الصوت بالذكاء الاصطناعي هي نفسها تحويل النص إلى كلام؟
لا. تحويل النص إلى كلام نوع واحد من واجهات برمجة الصوت بالذكاء الاصطناعي. تتضمن الفئة أيضًا التعرف على الكلام، واستنساخ الصوت، والدبلجة، ووظائف تحويل الكلام إلى كلام.
هل أحتاج إلى خبرة برمجية لاستخدام واحدة؟
عادةً بعض الخبرة، لأن واجهات البرمجة تنطوي على المصادقة، وطلبات HTTP، وJSON، ورفع الملفات، ومعالجة الحالة. وللمهام اليدوية العرضية، غالبًا ما يكون تطبيق ويب بلا كود أسهل.
هل يمكن لواجهة برمجة الصوت بالذكاء الاصطناعي ترجمة فيديو YouTube؟
يمكن لواجهة برمجة الدبلجة ترجمة فيديو وتوليد صوت جديد له عندما تدعم اللغات المصدر والمستهدفة المطلوبة، وصيغة الملف، وسير عمل المخرجات. راجع النتيجة قبل النشر.
هل يمكنني استنساخ صوت أي شخص؟
ما هو ممكن تقنيًا ليس هو نفسه ما هو مسموح قانونيًا أو أخلاقيًا. استنسخ صوتًا فقط بإذن مناسب، واتبع قواعد المزوّد، وعقودك، ومتطلبات الخصوصية والدعاية المعمول بها.