اسأل كيف يعمل تحويل النص إلى كلام العصبي والإجابة المختصرة هي هذه: إنه يحوّل النص المكتوب إلى صوت واقعي عن طريق تمرير نصك عبر شبكات عصبية عميقة تُحاكي كيفية تحدّث البشر فعليًا—النطق والإيقاع والتنغيم معًا. فبدلًا من دمج مقاطع مسجّلة مسبقًا كما كانت تفعل الأنظمة القديمة، يُولّد تحويل النص إلى كلام العصبي الكلام من الصفر، متعلّمًا الأنماط مباشرة من مجموعات بيانات ضخمة من التسجيلات البشرية الحقيقية المقترنة بالنص. هذا التمييز هو السبب في أن الأصوات الاصطناعية الحديثة تبدو مثل راوٍ يمكنك الاستماع إليه طوال مقطع فيديو كامل بدلًا من إعلان آلي. في DubSmart AI، نبني على هذا النهج العصبي نفسه لتشغيل ميزة تحويل النص إلى كلام لدينا، ونربطها باستنساخ الصوت والدبلجة بحيث يمكن لنص واحد أن ينتقل من لغة إلى لغات عديدة.
يستعرض هذا الدليل الآلية مرحلةً مرحلة، ثم يترجمها إلى قرارات عملية: أين يكون الصوت العصبي قويًا بما يكفي ليقف بمفرده، وأين لا تزال تريد أداءً بشريًا، وكيف تتلاءم القطع معًا داخل منصتنا.
جدول المحتويات
ماذا يعني حقًا "كيف يعمل تحويل النص إلى كلام العصبي"
تحويل النص إلى كلام العصبي هو شكل من أشكال تركيب الكلام يستخدم الشبكات العصبية العميقة لتوليد الكلام من الصفر. الاختلاف الجوهري عن الأساليب القائمة على القواعد أو التسلسلية هو أن النظام يتعلّم من مجموعات بيانات ضخمة من التسجيلات البشرية المقترنة بالنص، بحيث يمكنه التنبؤ بكيفية نطق الكلمات وكيف سيؤديها الإنسان بشكل طبيعي. هذا السلوك المتعلَّم هو ما يلتقط النبر—التشديد والإيقاع والوقفات والنبرة العاطفية—مما يجعل الصوت الناتج مريحًا خلال جلسات الاستماع الطويلة. تصف مزوّدات السحابة الكبرى هذه الأصوات العصبية بأنها كلام مُركَّب يشبه البشر يقلّل نطقه من إرهاق الاستماع في المساعدين وأدوات إمكانية الوصول وتجارب القراءة الصوتية.
يتبع محرك تحويل النص إلى كلام لدينا هذا المسار العصبي. فهو يحلّل نصك، ويقسّمه إلى فونيمات، ويستنتج الإيقاع والتنغيم، ثم يستخدم النماذج العصبية لإنتاج صوت سلس بدلًا من الأداء المسطّح المرتبط بأنظمة تحويل النص إلى كلام القديمة. النتيجة كلام واقعي يُولَّد من النص في ثوانٍ، مستمدّ من مكتبة تضم أكثر من 300 صوت مصمّمة لنبرات وحالات استخدام مختلفة.
لماذا يهمّ تحويل النص إلى كلام العصبي لصنّاع المحتوى والفرق
بالنسبة لصنّاع محتوى يوتيوب والشركات الصغيرة ومنتجي التعليم الإلكتروني وصنّاع الأفلام ومقدّمي البودكاست والمطوّرين، فإن السؤال الحقيقي ليس فقط كيف تعمل التقنية بل ما إذا كان ينبغي الاعتماد عليها في خط إنتاج. يهمّ تحويل النص إلى كلام العصبي لأنه ينقل الأصوات الاصطناعية من نطاق "الأدوات المساعدة"—إرشادات نظام تحديد المواقع، الأوامر الأساسية—إلى نطاق الأداء: جيد بما يكفي ليتصدّر المحتوى، ويروي دورات كاملة، ويحمل الرسائل التجارية دون أن يبدو اصطناعيًا بوضوح. اقرنها بالترجمة والدبلجة وتصبح مُضاعِفًا، إذ تتيح لنص واحد الوصول إلى عشرات اللغات بجزء بسيط من تكلفة ووقت العمل الاستوديوهي التقليدي.
لقد صمّمنا DubSmart حول هذا القرار بالضبط. تحويل النص إلى كلام، واستنساخ الصوت، والدبلجة بالذكاء الاصطناعي، وتحويل الكلام إلى نص، وفاصل الكلام، وتحويل النص إلى صورة، وتحويل الصورة إلى فيديو، كلها تجتمع في خط أنابيب واحد، بحيث ينتقل المحتوى المنطوق من الرفع إلى التصدير متعدد اللغات دون التلاعب بأدوات منفصلة. تختار مقدار الأتمتة ومقدار التخصيص في كل مرحلة—النص، الصوت، اللغة، المزج—داخل بيئة واحدة.
أين ينتهي هذا يعتمد على ما تصنعه:
- توسيع قناة يوتيوب إلى لغات جديدة: يتيح لك تحويل النص إلى كلام العصبي بالإضافة إلى الدبلجة إعادة استخدام النصوص والتوقيت مع استبدال الأصوات المحلية.
- ترجمة مقاطع التسويق أو التدريب: تحصل على سرد علامة تجارية متسق عبر اللغات دون حجز مواهب صوتية لكل تحديث.
- إنتاج التعليم الإلكتروني أو التدريب المؤسسي: يصبح السرد الطويل قابلًا للتوسّع وسهل المراجعة عند تغيّر المحتوى.
- تشغيل بودكاست أو فيلم مستقل: يمكنك إنشاء نسخ متعددة اللغات، أو إدراجات سردية، أو مسارات لإمكانية الوصول.
- بناء التطبيقات: تحوّل واجهات البرمجة لدينا الكلام العصبي إلى خدمة قابلة للاستدعاء لأنظمة الرد الصوتي التفاعلي والوكلاء وأدوات المحتوى.
فهم الآلية يساعدك على الحكم أين يمكن للصوت العصبي أن يقف بمفرده وأين ينبغي أن يبقى التسجيل البشري هو المصدر للاستنساخ أو الدبلجة.
تحت الغطاء: خط أنابيب تحويل النص إلى كلام العصبي
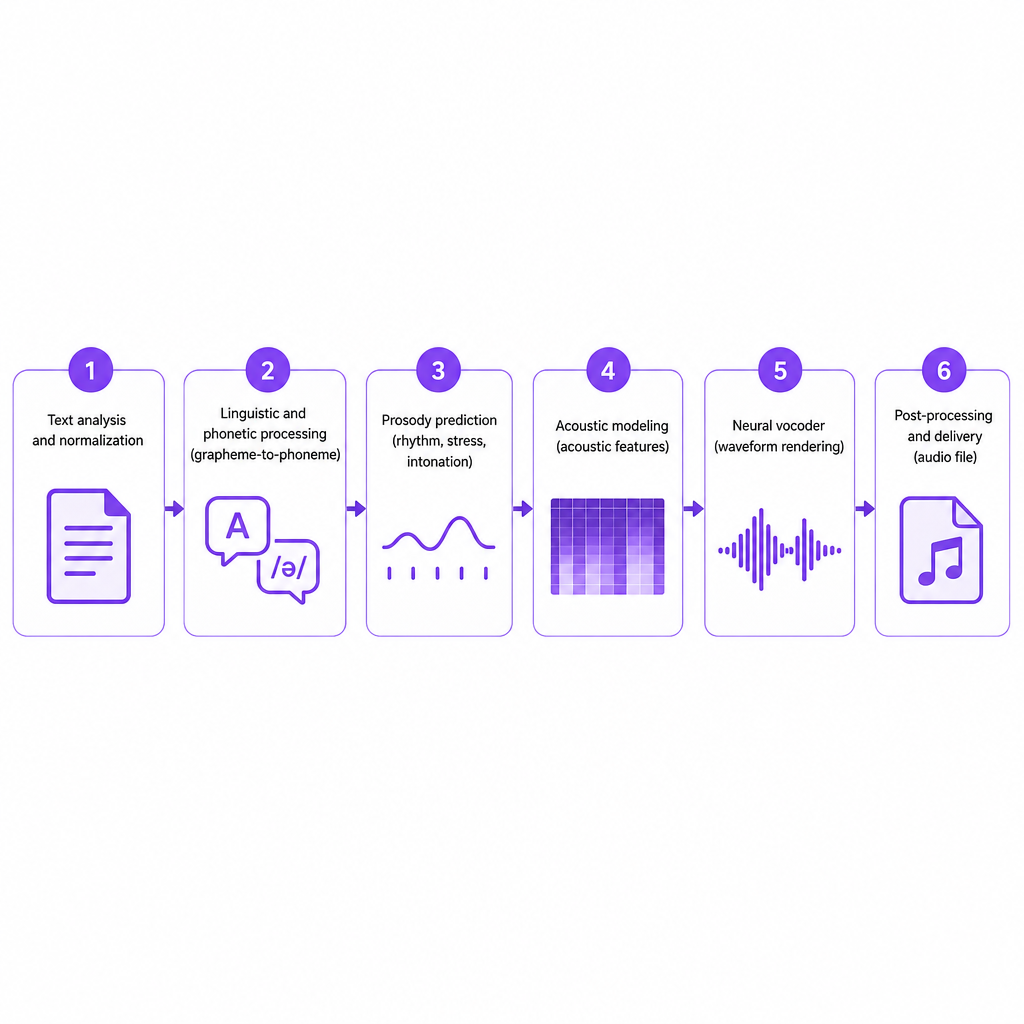
تختلف المحركات في التفاصيل، لكنها تشترك في خط أنابيب متشابه إلى حد كبير موصوف في الوثائق التقنية وإفصاحات الذكاء الاصطناعي المسؤول من المزوّدين الكبار، وتتوافق معه شروحاتنا الخاصة حول كيفية صنع التعليقات الصوتية بالذكاء الاصطناعي.
تحليل النص وتطبيعه
أولًا، يستوعب النظام نصك ويطبّعه إلى شكل قابل للنطق. وهذا يعني توسيع الأرقام ("2026" تصبح "ألفان وستة وعشرون")، والتواريخ، والاختصارات؛ وحل الرموز الغامضة مثل "US" مقابل "us" بناءً على السياق؛ وقراءة علامات الترقيم والبنية للتخطيط للوقفات والتشديد. يفسّر محركنا علامات الترقيم والبنية لاستنتاج الإيقاع والتدفق بدلًا من معاملة النص كسلسلة أحرف مسطّحة. تحمل هذه المرحلة وزنًا حقيقيًا للنصوص الأطول—الدورات، الشروحات، البودكاست—حيث تشكّل بنية الفقرات والعناوين كيفية قراءة الإنسان لها بشكل طبيعي.
المعالجة اللغوية والصوتية
يُحوَّل النص المطبَّع إلى فونيمات، وهي الوحدات الصوتية الأساسية للغة. يقوم نموذج تحويل الحروف إلى فونيمات بربط الأحرف بالأصوات، ومعالجة قواعد النطق والاستثناءات والمدخلات متعددة اللغات. هذا ما يتيح لميزة تحويل النص إلى كلام لدينا قبول النصوص عبر لغات عديدة وإنتاج التسلسل الصوتي الصحيح للّغة المختارة، سواء استخدمت صوتًا مدمجًا أو صوتًا مستنسخًا. تغطي أصواتنا العصبية أكثر من 33 لغة، بما في ذلك الإنجليزية والبرتغالية والإسبانية والفرنسية والألمانية والصينية واليابانية.
التنبؤ بالنبر
النبر—الإيقاع والتشديد والتنغيم—هو الفرق بين صوت آلي وأداء يشبه البشر. تتعلّم النماذج العصبية أنماط النبر مباشرة من التسجيلات، بحيث يمكنها تحديد أين تتوقف ولكم من الوقت، واختيار الكلمات التي تحمل التشديد، وضبط طبقة الصوت والطاقة عبر جملة أو فقرة. تذهب الأصوات العصبية عالية الدقة أبعد من ذلك، إذ تكتشف المشاعر في النص وتضبط النبرة مع الحفاظ على شخصية ثابتة، وهو ما يتيح الأداء الحواري أو المتعاطف لمحتوى الدعم والسرد. يستنتج محركنا النبر قبل تركيب الصوت للسبب نفسه: لتجنّب الأداء المسطّح وإنتاج كلام يمكنك الاستماع إليه لوحدة كاملة.
النمذجة الصوتية
بمجرد تحديد الفونيمات والنبر، يحوّل نموذج صوتي عصبي هذا التمثيل إلى سمات صوتية—مخطط لموجة الصوت. تشير إفصاحات الذكاء الاصطناعي المسؤول إلى أن هذه النماذج، إلى جانب تسجيلات موهبة صوتية محددة، تستمد أيضًا من مكتبة مصادر أوسع من العديد من المتحدثين. يساعد هذا المزيج الشبكة على تعلّم أنماط الكلام العامة مع الاستمرار في التقاط طابع صوت معين ولكنته وأسلوبه. في منصتنا، هذه النمذجة هي ما يتيح لأكثر من 300 صوت أن تبدو مميزة ومع ذلك طبيعية، وهي تدعم استنساخ الصوت السريع، حيث يتعلّم النظام البصمة الصوتية والنبرية لصوت من عينة قصيرة.
الفوكودر وإنتاج الصوت
تنتقل السمات الصوتية إلى فوكودر عصبي، الذي يحوّلها إلى موجة صوتية كاملة. تُنتج أجهزة الفوكودر الأحدث كلامًا عالي الدقة يكاد لا يُميَّز عن تسجيلات الاستوديو، مع حروف ساكنة واضحة، وحروف علة سلسة، وأدنى حد من التشوّهات. الجمع بين النموذج الصوتي العصبي والفوكودر هو السبب في أن الأصوات العصبية تبدو أكثر طبيعية بكثير من التقنية القديمة المستخدمة في قارئات الشاشة التقليدية وأنظمة الرد الصوتي التفاعلي. نستخدم تطورات مماثلة بحيث يكون الصوت المُولَّد جاهزًا للنشر مباشرة أو للإدراج في مزيج مع الموسيقى والمؤثرات الصوتية.
المعالجة اللاحقة والتسليم
أخيرًا، قد يطبّق النظام معالجة لاحقة—تشكيل الضوضاء، تطبيع مستوى الصوت، أو تحويل التنسيق—قبل إعادة الملف الصوتي. بالنسبة لسير عمل واجهات البرمجة، يُغلَّف هذا في نقطة نهاية RESTful تقبل النص ومعلمات الصوت وتعيد أصلًا جاهزًا للاستخدام. تتبع ميزة تحويل النص إلى كلام لدينا هذا التدفق بالضبط: ألصق أو أرسل النص، اختر اللغة والصوت، اضبط الأداء حيث تكون عناصر التحكم متاحة، أنشئ، ونزّل صوتًا بتنسيق قياسي. المحرك نفسه يقع تحت الدبلجة بالذكاء الاصطناعي لدينا، حيث تُربط النسخ والترجمة والتركيب لإنشاء نسخ متعددة اللغات.
الخيارات داخل DubSmart: الأصوات، الاستنساخ، الدبلجة، وواجهات البرمجة
معرفة الآليات تفسّر لماذا تُبنى مجموعة ميزاتنا بالطريقة التي هي عليها.
تحويل النص إلى كلام للسرد المباشر
أداة تحويل النص إلى كلام لدينا هي الواجهة الأساسية لتحويل النصوص إلى صوت. تلصق أو ترفع النص بأي لغة مدعومة، وتختار من بين أكثر من 300 صوت طبيعي، وتضبط اللغة وعناصر التحكم الأساسية في الأداء حيثما توفّرت، وتولّد الكلام في ثوانٍ. تغطي هذه الأداة خطافات يوتيوب وسرد الفيديو الكامل، والتعليقات الصوتية التوضيحية والترويجية للشركات الصغيرة، ووحدات التعليم الإلكتروني والتدريب الواضحة، ومقدّمات البودكاست وخواتمها وإدراجاتها الوسطى. إذا كنت تقارن الأدوات لهذه المهمة، فإن ملخّصنا حول أفضل برامج الدبلجة بالذكاء الاصطناعي لصنّاع المحتوى يوضّح كيف يترابط السرد والترجمة المحلية.
استنساخ الصوت: الحفاظ على صوت علامتك التجارية أو مقدّمك
يبني استنساخ الصوت على الخطوات العصبية نفسها—الفونيمات، النبر، السمات الصوتية—لكنه يُحسّن الشبكة لمطابقة طابع وأسلوب معينين، بحيث يمكنك توليد سطور جديدة بذلك الصوت دون إعادة التسجيل. يُنشئ استنساخ الصوت السريع لدينا أصواتًا مخصصة يمكنك استخدامها داخل تحويل النص إلى كلام أو الدبلجة بالذكاء الاصطناعي، مما يعني أن المحتوى المحلي لا يزال يبدو مثل مقدّمك أو راويك أو علامتك التجارية. هذا الاتساق يهمّ أكثر للقنوات والشركات التي استثمرت في هوية صوتية يمكن التعرّف عليها.
الدبلجة بالذكاء الاصطناعي: ربط تحويل الكلام إلى نص والترجمة وتحويل النص إلى كلام
تستخدم الدبلجة بالذكاء الاصطناعي محرك تحويل النص إلى كلام كخطوة أخيرة في سلسلة أطول: نسخ الصوت الموجود، وترجمة النص، ثم تركيب كلام جديد باللغة المستهدفة. تحافظ الدبلجة بالذكاء الاصطناعي لدينا على الدبلجة وتحويل النص إلى كلام وتحويل الكلام إلى نص والاستنساخ داخل سير عمل واحد بحيث ينتقل المحتوى من الرفع إلى التصدير متعدد اللغات دون مغادرة المنصة. عمليًا، يمكنك رفع فيديو أو بودكاست، وجعله يُنسَخ ويُفصَل عن الصوت الخلفي، وترجمته إلى لغة أو أكثر، ثم توليد مسارات مدبلجة باستخدام أصوات جاهزة أو مستنسخة تحافظ على التوقيت والنبرة. للحصول على شرح عملي حول المحتوى المنطوق، راجع دليلنا حول كيفية ترجمة بودكاست إلى لغة أخرى.
واجهات البرمجة للمطوّرين والوكالات
نُتيح تحويل النص إلى كلام العصبي والدبلجة عبر واجهات برمجة بحيث يمكن للمطوّرين والوكالات دمج توليد الصوت في منتجاتهم الخاصة. واجهة برمجة تحويل النص إلى كلام لدينا هي خدمة RESTful تقبل طلب POST بمحتوى نصي وتفضيلات صوتية وتعيد صوتًا عالي الجودة، مع الوصول إلى أصوات عصبية مميزة بأكثر من 33 لغة. توسّع واجهة برمجة الدبلجة بالذكاء الاصطناعي ذلك ليشمل الدبلجة متعددة اللغات الآلية. بالنسبة للوكالات التي تتعامل مع الترجمة المحلية عبر العملاء، توحّد هذه النقاط الطرفية توليد الصوت مع الاستمرار في تخصيص اللغات والشخصيات لكل علامة تجارية.
معايير القرار: اختيار واستخدام تحويل النص إلى كلام العصبي بشكل جيد
بمجرد وضوح الآلية، يكمن العمل العملي في تحديد متى وكيف تستخدمها.
الطبيعية وراحة الاستماع. الاختبار الأساسي هو ما إذا كان الصوت طبيعيًا بما يكفي ليقبله جمهورك كراوٍ رئيسي. بُنيت الشبكات العصبية العميقة والأصوات عالية الدقة لتقليل إرهاق الاستماع، لكن الاختيار الصحيح لا يزال يعتمد على نوع المحتوى. استخدم مكتبة أصواتنا الكبيرة لاختبار الشخصيات—نشطة، هادئة، مرحة، آمرة—وللدورات أو البودكاست الطويلة، فضّل الأصوات التي يبدو نبرها حواريًا بدلًا من كونه إعلانيًا.
تغطية اللغات وملاءمة اللكنة. للتوسّع متعدد اللغات، تحتاج إلى كل من اللغة ولكنة مناسبة للجمهور المستهدف. تمتد أصواتنا العصبية على أكثر من 33 لغة عبر الأسواق الرئيسية. عند اختيار المسارات المحلية، حدّد ما إذا كنت تريد لكنة محايدة أو خاصة بمنطقة، واختبر العينات مع متحدثين أصليين حيثما أمكن.
اتساق العلامة التجارية مقابل المرونة. يحمل الاستنساخ صوتًا معينًا عبر اللغات والمشاريع، لكنه يقدّم مسؤوليات تتعلّق بالموافقة والإفصاح. استخدمه عندما تكون الشخصية المتسقة محورية لعلامتك التجارية، ووثّق من يملك ذلك الصوت ويتحكّم به—خاصة في العمل المؤسسي أو الوكالات.
تكامل سير العمل. يقدّم تحويل النص إلى كلام العصبي أكبر قيمة عندما ينخرط في طريقة عملك الحالية. ولأن أدواتنا تجمع بين تحويل النص إلى كلام والاستنساخ والدبلجة وتحويل الكلام إلى نص وأدوات الوسائط، يمكنك أتمتة الكثير من سلسلة الترجمة المحلية مع الاستمرار في تحرير النصوص والصوت. قد يجد صنّاع المحتوى الأفراد أدوات المتصفح كافية؛ ويحصل المطوّرون والوكالات على نقاط طرفية قابلة للبرمجة للتوسّع.
المخاطر والحدود والاستخدام المسؤول
حتى النماذج المتقدمة لها حدود يستحق التخطيط لها.
- الفروق العاطفية الدقيقة: تستجيب الأصوات عالية الدقة للمشاعر، لكنها قد تفوّت إشارات دقيقة أو أداءً معقدًا قد يقدّمه ممثل ماهر. قد تظل الرسائل التجارية الحرجة أو الدراما السردية تستدعي التسجيل البشري كمصدر.
- حالات النطق الحدّية: قد تتحدى الأسماء النادرة أو المصطلحات الجديدة أو النصوص متعددة اللغات نماذج تحويل الحروف إلى فونيمات، لذا ادمج فحوصات يدوية.
- أخلاقيات الاستنساخ: يشدّد إرشاد الذكاء الاصطناعي المسؤول على أن الأصوات المخصصة ينبغي بناؤها واستخدامها بموافقة صريحة وعقود واضحة وإفصاح للجمهور. تقليد الأشخاص دون إذن يثير مخاوف قانونية وأخلاقية.
- التحيّز والتمثيل: تشكّل بيانات التدريب كيفية تعامل الأصوات مع اللكنات واللهجات، لذا تحقّق من أن الأصوات التي اخترتها تمثّل جمهورك بإنصاف وتجنّب تعزيز الصور النمطية.
ولأن سير عملنا المتكامل يجعل من السهل توليد ونشر الكلام الاصطناعي، فإن المراجعة الداخلية تهمّ أكثر وليس أقل—خاصة عند التعامل مع أصوات العملاء أو الموظفين. يساعد وجود مسار ملموس: يمكن لصانع محتوى كتابة نص إنجليزي واحد، وتوليد تعليق صوتي إنجليزي، ثم دبلجة نسخ بالإسبانية والبرتغالية والألمانية لقنوات إضافية مع الحفاظ على التوقيت والأداء نفسهما. يمكن لفريق تدريب بناء سرد معياري وإعادة توليده بسرعة كلما تغيّرت السياسات. هذا هو العائد الحقيقي لفهم خط الأنابيب—تعرف أي مرحلة يجب التحكّم بها وأيها تترك للنموذج ليتعامل معها.
الأسئلة الشائعة
ما هو تحويل النص إلى كلام العصبي بعبارات بسيطة؟
تحويل النص إلى كلام العصبي هو ذكاء اصطناعي يحوّل النص المكتوب إلى كلام باستخدام شبكات عصبية عميقة مُدرَّبة على مجموعات بيانات ضخمة من التسجيلات البشرية، مُنتجًا أصواتًا تبدو أقرب بكثير إلى البشر الحقيقيين من أنظمة تحويل النص إلى كلام القديمة.
كيف يختلف تحويل النص إلى كلام لدى DubSmart عن تحويل النص إلى كلام الأساسي؟
نستخدم نماذج عصبية تحلّل نصك، وتستنتج النبر، وتركّب الكلام من الصفر، مدعومة بأكثر من 300 صوت طبيعي واستنساخ صوت سريع، بحيث يعمل الناتج كراوٍ رئيسي للفيديوهات والدورات والبودكاست.
هل يمكن لـ DubSmart الحفاظ على صوتي الخاص في لغات أخرى؟
نعم. يمكن لاستنساخ الصوت لدينا تعلّم صوتك من التسجيلات ثم استخدامه في تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي، بحيث تظل النسخ المحلية من محتواك تبدو مثلك أو مثل راوي علامتك التجارية.
كيف تعمل الدبلجة بالذكاء الاصطناعي مع تحويل النص إلى كلام العصبي؟
تربط الدبلجة بالذكاء الاصطناعي نسخ الكلام إلى نص والترجمة وتحويل النص إلى كلام العصبي، محوّلةً صوتك الموجود إلى مسارات مدبلجة متعددة اللغات في سير عمل واحد، باستخدام إما أصوات جاهزة أو صوتك المستنسخ.
هل تحويل النص إلى كلام العصبي آمن وأخلاقي للاستخدام؟
عند استخدامه بموافقة وإفصاح واضح وضمانات مناسبة، يكون تحويل النص إلى كلام العصبي أداة قوية لإمكانية الوصول والترجمة المحلية. يؤكّد إرشاد الذكاء الاصطناعي المسؤول على احترام حقوق المواهب الصوتية وتجنّب الاستخدامات الخادعة للأصوات الاصطناعية.