Biến một kịch bản thành lời dẫn cho YouTube trước đây đồng nghĩa với việc cần một chiếc micro, một căn phòng yên tĩnh và rất nhiều lần thu lại. Giờ đây chuyển văn bản thành giọng nói cho YouTube cho phép bạn dán kịch bản vào, chọn một giọng đọc và xuất ra lời dẫn mà bạn có thể đưa vào video, một Short, một hướng dẫn, hoặc một phiên bản dịch của một video bạn đã đăng tải. Quyết định thực sự không phải là có nên dùng giọng nói tổng hợp hay không. Mà là phương pháp sản xuất nào phù hợp với video cụ thể bạn đang có trước mắt: một giọng AI có sẵn, một bản nhân bản tùy chỉnh, một bản thu âm con người, hay sự kết hợp nào đó của cả ba.
Hướng dẫn này giải thích công nghệ thực sự hoạt động như thế nào, quy trình nào phù hợp với các mục tiêu kênh khác nhau, và cần xác minh điều gì về bản quyền và tiết lộ trước khi bạn nhấn đăng tải. Đây là trung tâm cho bộ bài giải thích rộng hơn của chúng tôi về giọng nói và phiên âm, nên bạn sẽ tìm thấy các liên kết đến những bài chuyên sâu nơi một chủ đề riêng lẻ xứng đáng có trang riêng.
Mục lục
Chuyển văn bản thành giọng nói cho YouTube thực sự nghĩa là gì
Chuyển văn bản thành giọng nói cho YouTube đơn giản là sử dụng công nghệ text-to-speech để tạo lời dẫn cho nội dung YouTube. Bạn cung cấp một kịch bản, chọn một giọng đọc và ngôn ngữ, điều chỉnh cách thể hiện, và xuất ra một tệp âm thanh để chỉnh sửa hoặc đăng tải. Ẩn bên dưới, một hệ thống TTS chuyển đổi văn bản, hoặc Speech Synthesis Markup Language (SSML), thành dữ liệu âm thanh như MP3 hoặc âm thanh tương thích WAV mà bạn có thể thêm vào video và các phương tiện khác.
Hai sự phân biệt giải quyết được hầu hết những nhầm lẫn. Phụ đề làm công việc ngược lại của TTS: phụ đề biến âm thanh được nói thành văn bản, trong khi chuyển văn bản thành giọng nói biến văn bản viết thành âm thanh được nói. Lồng tiếng thì rộng hơn nữa. TTS thường bắt đầu từ một kịch bản viết và tạo ra một track giọng nói mới, trong khi lồng tiếng thường dịch một video có sẵn và khớp lời nói thay thế với thời điểm và ý nghĩa gốc. Nếu những ranh giới đó quan trọng với quy trình của bạn, bài giải thích của chúng tôi về những ngôn ngữ mà AI có thể lồng tiếng trình bày chi tiết khía cạnh bản địa hóa.
Quy trình tổng hợp biến kịch bản thành giọng nói như thế nào
Một hệ thống TTS kết hợp bốn thành phần: kịch bản của bạn, một mô hình giọng nói được chọn, thông tin ngôn ngữ, và các tùy chọn kiểm soát cách thể hiện. Từ đó, nó xử lý qua một chuỗi ngắn giải thích tại sao cùng một câu có thể nghe hay hoặc lủng củng tùy vào cách bạn viết.
Đầu tiên là phần nhập văn bản, có thể là một kịch bản YouTube đầy đủ, một dàn ý được mở rộng thành lời dẫn, một phiên bản dịch của một kịch bản có sẵn, hoặc phụ đề được định hình lại thành lời thoại. Chất lượng đầu vào quyết định chất lượng đầu ra. Những câu dài, các từ viết tắt không được giải thích, những cái tên bất thường, và dấu câu lộn xộn có thể khiến một giọng đọc có khả năng tốt nghe không ổn. Cách khắc phục là viết để nghe thay vì đọc thầm: câu ngắn hơn, chuyển ý rõ ràng, ngắt nghỉ có chủ đích.
Tiếp theo, bộ máy phân tích văn bản để quyết định các từ nên được phát âm và nhóm lại như thế nào. Nó đọc ranh giới câu, dấu câu và chỗ ngắt nghỉ, số và ngày tháng, từ viết tắt, tên riêng, và các gợi ý phát âm theo vùng miền. Đây là lý do dấu câu thay đổi cách thể hiện. Thêm một dấu phẩy, viết lại một con số thành chữ, hoặc đánh vần ra một từ viết tắt, và giọng đọc sẽ phản ứng theo.
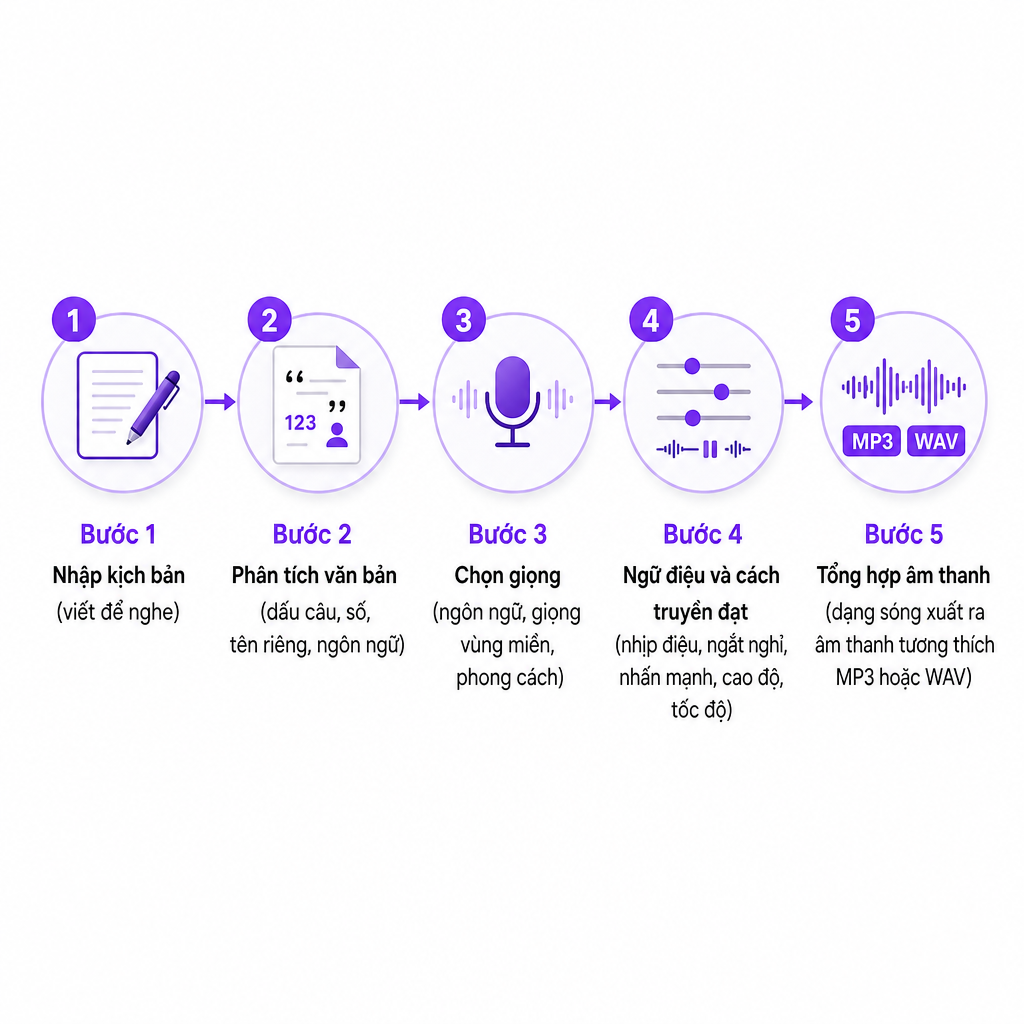
Sau đó bạn chọn một giọng đọc. Các giọng khác nhau về ngôn ngữ, giọng điệu vùng miền, độ tuổi hoặc đặc tính giọng, cách thể hiện giới tính, phong cách nói, năng lượng, và mức độ trang trọng. Các thiết lập đầu ra thường bao gồm tốc độ nói, cao độ, âm lượng, và tần số lấy mẫu. Đối với một kênh, sự nhất quán thường quan trọng hơn sự kịch tính. Một giọng đọc dễ nhận biết được duy trì xuyên suốt các video khiến kênh có cảm giác mạch lạc, điều này quan trọng hơn việc chọn lựa phương án kịch tính nhất cho một video đơn lẻ.
Bộ máy sau đó tạo ra ngữ điệu, tức nhịp điệu, chỗ ngắt nghỉ, sự nhấn mạnh, biến chuyển cao độ, và ngữ điệu ngắt quãng phân biệt lời nói biểu cảm với những từ cách đều nhau. Một số công cụ cho phép kiểm soát trực tiếp những yếu tố này; những công cụ khác suy ra chúng từ dấu câu, cấu trúc câu, hoặc chỉ dẫn phong cách. Đây là nơi hầu hết các khoảng cách chất lượng xuất hiện. Một giọng đọc có thể phát âm đúng mọi từ mà vẫn cảm thấy sai nếu nhịp điệu hoặc tông cảm xúc xung đột với video.
Cuối cùng mô hình tổng hợp âm thanh, biến đổi văn bản đã phân tích thành một dạng sóng mà dịch vụ trả về dưới dạng một tệp có thể tải xuống. Một quy trình API có thể trả về dữ liệu âm thanh đã mã hóa mà bạn giải mã thành một tệp có thể phát, trong khi các công cụ dành cho creator được lưu trữ sẽ xử lý bước đó cho bạn. Ngay cả khi đó, lời dẫn vẫn không phải là một video hoàn chỉnh. Bạn vẫn phải đặt nó lên dòng thời gian, cắt khoảng lặng, thêm nhạc và hiệu ứng, khớp nó với hình ảnh, cân bằng âm lượng, thêm phụ đề, và kiểm tra lại phát âm và thời điểm. Đối với một video giải thích, giọng đọc nên bám theo trình tự hình ảnh; một track sạch về mặt kỹ thuật vẫn cảm thấy cẩu thả nếu hình ảnh thay đổi trước khi câu tương ứng bắt đầu. Nếu bạn muốn bức tranh neural đầy đủ, bài phân tích của chúng tôi về cách chuyển văn bản thành giọng nói neural hoạt động đi sâu hơn vào cấu trúc bên trong mô hình.
Bốn hướng sản xuất, và khi nào từng hướng thắng thế
Hầu hết lời dẫn YouTube quy về bốn lựa chọn, và lựa chọn đúng phụ thuộc vào những gì video cần hơn là lựa chọn nào nghe tiên tiến nhất trong một bản xem thử.
| Hướng | Phù hợp nhất cho | Đánh đổi chính |
|---|---|---|
| Giọng AI tiêu chuẩn | Kênh không lộ mặt, video giải thích, hướng dẫn, tổng hợp kiểu tin tức, Shorts | Nhanh và đáng tin cậy, nhưng không gắn với một người cụ thể |
| Nhân bản giọng tùy chỉnh | Giữ một bản sắc dễ nhận biết xuyên suốt nhiều video | Yêu cầu một giọng nói mà bạn được phép tái tạo |
| TTS đa ngôn ngữ hoặc lồng tiếng | Video giải thích được dịch, video sản phẩm bản địa hóa, thử nghiệm thị trường mới | Cần kiểm tra phát âm và văn hóa cho từng ngôn ngữ |
| Lồng tiếng con người | Diễn xuất tinh tế, lời chứng thực, từ ngữ nhạy cảm hoặc quan trọng với thương hiệu | Chậm hơn và khó mở rộng quy mô hơn |
Một giọng tiêu chuẩn lấy từ thư viện của nhà cung cấp là con đường nhanh nhất cho nội dung số lượng lớn khi bạn không cần lời dẫn nghe giống một người cụ thể. Nhân bản giọng tùy chỉnh xây dựng một giọng nói tổng hợp từ một mẫu âm thanh, giúp một creator giữ một bản sắc nhất quán mà không cần thu âm từng kịch bản bằng tay. Chỉ sử dụng nhân bản khi có sự cho phép và với một giọng nói mà bạn có quyền tái tạo; một bản nhân bản không phải là con đường tắt để sở hữu bản sắc hoặc phần trình diễn của ai đó. Công cụ Text to Speech của chúng tôi cho bạn quyền truy cập vào các giọng AI và quy trình nhân bản, và trang Voice Cloning của chúng tôi là nơi để bắt đầu khi bạn muốn một người dẫn tùy chỉnh có thể tái sử dụng thay vì một giọng có sẵn.
Lời dẫn đa ngôn ngữ cho phép bạn dịch một kịch bản và tổng hợp một track giọng nói mới bằng một ngôn ngữ khác, điều này hữu ích cho việc phát triển một kênh giáo dục ở nước ngoài, bản địa hóa video sản phẩm, hoặc thử nghiệm nhu cầu ở một thị trường mới. TTS bắt đầu bằng văn bản; quy trình AI Dubbing của chúng tôi bổ sung lớp bản địa hóa rộng hơn, bao gồm dịch thuật và âm thanh thay thế cho một video có sẵn trên 33 ngôn ngữ. Một người dẫn con người vẫn thắng thế khi video dựa vào diễn xuất tinh tế, lời chứng thực cá nhân, chủ đề nhạy cảm, hài hước phức tạp, từ ngữ pháp lý hoặc quan trọng với thương hiệu, hoặc cách diễn giải đặc trưng của một người trình diễn riêng biệt. Rất nhiều kênh vận hành theo mô hình lai: lời dẫn AI cho bản nháp, các phiên bản, và video đăng số lượng lớn, còn giọng con người cho các video chủ lực.
Khi nào chuyển văn bản thành giọng nói xứng đáng có chỗ đứng trên một kênh
YouTube TTS phát huy hiệu quả nhất khi nút thắt của bạn là khâu thu âm, không phải khâu viết. Nếu viết kịch bản là dễ nhưng đặt lịch một buổi thu âm mới là phần chậm chạp, thì lời dẫn tổng hợp loại bỏ bước chậm nhất.
Video giáo dục và hướng dẫn hưởng lợi trực tiếp. Cập nhật một kịch bản và chỉ tạo lại phần bị ảnh hưởng thay vì sắp xếp một buổi thu âm mới, điều này phù hợp với hướng dẫn phần mềm, hướng dẫn nhập môn, và nội dung khóa học thường thay đổi. Các kênh không lộ mặt có thể dẫn lời cho video được dựng từ bản thu màn hình, cảnh quay có sẵn, hoạt hình, slide, hoặc hình ảnh được tạo ra, mặc dù giọng đọc vẫn cần sự chỉ đạo biên tập; âm thanh đặt lên cảnh quay không liên quan sẽ làm xói mòn lòng tin của người xem. Shorts hưởng lợi từ tốc độ chuyển kịch bản thành âm thanh nhanh chóng, cho phép bạn thử nghiệm nhiều điểm thu hút hoặc biến thể khán giả miễn là giọng đọc không nghe vội vã hoặc lặp đi lặp lại.
Khả năng tiếp cận là một công dụng chân thực khác. Một phiên bản được đọc của nội dung viết giúp những người xem thích âm thanh hoặc gặp khó khăn với văn bản trên màn hình, nhưng lời dẫn nên bổ trợ cho phụ đề chính xác và thiết kế hình ảnh rõ ràng chứ không thay thế chúng. Và đối với mở rộng đa ngôn ngữ, bạn có thể tạo ra các track giọng nói đã dịch mà không cần chạy một quy trình sản xuất riêng cho từng ngôn ngữ. Tính năng Âm thanh đa ngôn ngữ của YouTube cho phép các creator đủ điều kiện đính kèm các track âm thanh bổ sung vào một video hoặc Short duy nhất thay vì quản lý một kênh riêng cho mỗi thị trường.
Chọn và thử nghiệm một giọng đọc trước khi cam kết
Đánh giá một giọng đọc dựa trên yêu cầu thực sự của video, không phải một bản xem thử mười giây hấp dẫn. Một giọng đọc hoàn hảo ở một câu có thể sụp đổ khi trải qua cả một kịch bản đầy đủ, nên hãy kiểm tra áp lực trước.
- Khớp giọng đọc với định dạng. Một cách thể hiện điềm tĩnh phù hợp với một phim tài liệu hoặc hướng dẫn; một giọng đọc năng lượng cao hơn phù hợp với một điểm thu hút dạng ngắn hoặc một thông báo. Hãy để chủ đề, nhịp điệu, và khán giả quyết định.
- Thử các từ khó. Trước khi tạo một video đầy đủ, hãy chạy thử các tên thương hiệu lặp lại, tên địa danh, từ viết tắt, thuật ngữ khoa học, từ nước ngoài, đơn vị, và tên người của bạn. Một giọng đọc xử lý được những câu bình thường có thể vấp ngã với vốn từ vựng của kênh bạn.
- Kiểm tra sự nhất quán ở dạng dài. Tạo một mẫu dài hơn và lắng nghe ngữ điệu lặp lại, chỗ ngắt nghỉ sai, nhịp điệu không tự nhiên, phát âm thay đổi, và chuyển đoạn đột ngột.
- Cân nhắc khán giả theo vùng miền. Lời dẫn tiếng Anh có thể cần cách phát âm Mỹ, Anh, Úc, hoặc một cách khác. Đối với các ngôn ngữ khác, hãy xác nhận giọng đọc nghe tự nhiên với tai của người bản ngữ, không chỉ là việc công cụ liệt kê ngôn ngữ đó.
- Xem lại quyền sử dụng. Trước khi kiếm tiền hoặc chạy quảng cáo, hãy đọc các điều khoản của nhà cung cấp và xác nhận giọng đọc cùng sản phẩm đầu ra được phép dùng cho nội dung YouTube thương mại, công việc khách hàng, quảng cáo trả phí, và các phiên bản phái sinh.
Một vài thói quen viết cũng nâng cao chất lượng nhanh chóng. Hãy viết để nói bằng cách đổi những đoạn văn dày đặc sang câu đối thoại và dùng dấu câu để dẫn dắt chỗ ngắt nghỉ mà không dựa vào nó để tạo cảm xúc. Đánh vần ra những thuật ngữ mơ hồ để bộ máy đọc đúng, thử nghiệm các biến thể như "AI" so với "A.I." hoặc "2026" so với "hai nghìn không trăm hai mươi sáu." Tạo theo từng phần thay vì một tệp khổng lồ để bạn có thể tạo lại một lỗi đơn lẻ, sắp xếp lại các cảnh, và khớp âm thanh với hình ảnh. Sau đó thêm khâu chỉnh sửa của con người: xem toàn bộ video với track đang phát, cắt những khoảng ngắt nghỉ vụng về, sửa thời điểm, và hạ nhạc nền xuống dưới lời nói. AI cắt giảm thời gian thu âm; nó không loại bỏ khâu xét duyệt biên tập.
Bản quyền, tiết lộ, và đăng tải một track ngôn ngữ thứ hai
Phần mà các creator thường bỏ qua nhất cũng là phần khiến video bị gỡ xuống. Nếu bạn xây dựng một phiên bản ngôn ngữ riêng, bạn có thể đăng nó như một video mới hoặc dùng tính năng Âm thanh đa ngôn ngữ của YouTube nơi có sẵn, nhưng nền tảng không tạo những track lồng tiếng đó cho bạn. Các creator phải chuẩn bị và đăng tải các tệp âm thanh của riêng mình ở một định dạng chỉ âm thanh được hỗ trợ, có độ dài xấp xỉ với video. YouTube cũng có thể gỡ bỏ một tệp âm thanh phụ nếu nội dung có bản quyền của nó khác với bản gốc, điều này khiến việc xét duyệt bản quyền trở nên thiết yếu khi track lồng tiếng của bạn bao gồm nhạc, clip, hoặc tài liệu được bảo vệ khác.
Tiết lộ là một nghĩa vụ riêng biệt. YouTube yêu cầu các creator tiết lộ nội dung được tạo bởi AI hoặc bị chỉnh sửa mà trông có vẻ chân thực, bao gồm nội dung khiến một người thật có vẻ nói hoặc làm điều gì đó họ không làm, chỉnh sửa cảnh quay của một sự kiện hoặc địa điểm có thật, hoặc dựng nên một cảnh chân thực. Đáng chú ý, YouTube liệt kê việc nhân bản giọng nói của chính bạn cho lời thoại hoặc lồng tiếng là một trong những ví dụ không yêu cầu tiết lộ theo chính sách cụ thể đó. Đó không phải là giấy phép để nhân bản giọng nói của người khác, và việc gắn nhãn nội dung tổng hợp không cho phép sử dụng khuôn mặt hoặc giọng nói của người khác mà không có sự cho phép.
Một chính sách biên tập an toàn là sử dụng giọng nói của chính bạn hoặc một giọng được cấp phép, giữ hồ sơ cho phép đối với bất kỳ mẫu giọng tùy chỉnh nào, tránh bắt chước một người thật khi không được phép, kiểm tra các điều khoản sử dụng thương mại, tiết lộ nội dung tổng hợp hoặc bị chỉnh sửa chân thực khi YouTube yêu cầu, và xem xét riêng biệt bản quyền của nhạc, cảnh quay, và âm thanh đã dịch. Đối với các nhóm tạo lời dẫn lặp đi lặp lại từ một hệ thống nội dung hoặc ứng dụng, Text to Speech API của chúng tôi được xây dựng để tạo giọng nói theo lập trình để bạn có thể sản xuất các track với số lượng lớn mà không cần dựng lại quy trình mỗi lần.
Vậy chuyển văn bản thành giọng nói cho YouTube có đáng không? Nó rất phù hợp khi bạn cần lời dẫn có thể lặp lại, chỉnh sửa nhanh, các phiên bản đa ngôn ngữ, hoặc một lời thoại mà không cần thiết bị thu âm. Nó kém phù hợp hơn khi sự thành công của video dựa vào diễn xuất tinh tế, lời chứng thực cá nhân, hoặc một phần trình diễn nhạy cảm về mặt pháp lý. Tiêu chuẩn quan trọng không phải là người xem có thể nhận ra một giọng nói là tổng hợp hay không. Mà là liệu lời dẫn có rõ ràng, phù hợp, nhất quán, có thể dùng được về mặt pháp lý, và được tích hợp tốt với video hay không.
Câu hỏi thường gặp
Tôi có thể dùng âm thanh chuyển văn bản thành giọng nói trên YouTube không?
Có. Bạn có thể dùng lời dẫn được tạo ra trong một video YouTube miễn là bạn tôn trọng các điều khoản cấp phép của nhà cung cấp TTS, các chính sách của YouTube, và các quyền gắn với kịch bản, nhạc, cảnh quay, và giọng nói của bạn.
YouTube có tự động biến một kịch bản thành lời dẫn không?
Không. Tính năng Âm thanh đa ngôn ngữ của YouTube không tạo những track lồng tiếng của bạn cho bạn. Các creator phải chuẩn bị và đăng tải các tệp âm thanh của riêng mình.
Sự khác biệt giữa chuyển văn bản thành giọng nói cho YouTube và tự động lồng tiếng là gì?
Chuyển văn bản thành giọng nói chuyển đổi văn bản viết thành âm thanh được nói. Tự động lồng tiếng là một quy trình bản địa hóa rộng hơn, có thể dịch và tạo ra một track ngôn ngữ thay thế cho nội dung có sẵn. Các tính năng chính xác phụ thuộc vào nền tảng và quy trình.
Tôi có thể nhân bản giọng nói của mình cho video YouTube không?
Bạn có thể dùng một bản nhân bản giọng nói khi bạn có quyền tạo và sử dụng nó. YouTube liệt kê việc nhân bản giọng nói của chính bạn cho lời thoại hoặc lồng tiếng là một ví dụ không yêu cầu tiết lộ theo chính sách nội dung chân thực của họ, mặc dù nội dung khác được tạo bởi AI hoặc bị chỉnh sửa vẫn có thể yêu cầu tiết lộ.
Tôi nên đăng tải tệp âm thanh nào cho một ngôn ngữ thứ hai?
Đối với tính năng Âm thanh đa ngôn ngữ của YouTube, tệp phải ở một định dạng chỉ âm thanh được hỗ trợ và có độ dài xấp xỉ với video. Hãy kiểm tra giao diện đăng tải hiện tại của YouTube Studio trước khi bạn xuất.