Hỏi cách văn bản thành giọng nói bằng mạng nơ-ron hoạt động như thế nào và câu trả lời ngắn gọn là: nó chuyển đổi văn bản viết thành âm thanh sống động bằng cách đưa kịch bản của bạn qua các mạng nơ-ron sâu mô phỏng cách con người thực sự nói—phát âm, nhịp điệu và ngữ điệu cùng nhau. Thay vì ghép nối các đoạn ghi âm sẵn như cách các hệ thống cũ làm, TTS nơ-ron tạo ra giọng nói từ đầu, học các mẫu trực tiếp từ các tập dữ liệu lớn gồm bản ghi âm giọng người thực được ghép với văn bản. Sự khác biệt đó là lý do tại sao giọng nói tổng hợp hiện đại nghe giống như một người dẫn chuyện mà bạn có thể nghe suốt cả video thay vì một thông báo máy móc. Tại DubSmart AI, chúng tôi xây dựng dựa trên chính phương pháp nơ-ron này để cung cấp năng lượng cho Text to Speech của mình, kết nối nó với nhân bản giọng nói và lồng tiếng để một kịch bản duy nhất có thể chuyển từ một ngôn ngữ sang nhiều ngôn ngữ.
Hướng dẫn này đi qua cơ chế theo từng giai đoạn, sau đó chuyển nó thành các quyết định thực tế: nơi mà một giọng nói nơ-ron đủ mạnh để đứng độc lập, nơi bạn vẫn muốn một màn trình diễn của con người, và cách các mảnh ghép kết hợp với nhau bên trong nền tảng của chúng tôi.
Mục lục
"Cách văn bản thành giọng nói bằng mạng nơ-ron hoạt động" thực sự có nghĩa là gì
Văn bản thành giọng nói bằng mạng nơ-ron là một dạng tổng hợp giọng nói sử dụng các mạng nơ-ron sâu để tạo ra giọng nói từ đầu. Sự khác biệt cốt lõi so với các phương pháp dựa trên quy tắc hoặc ghép nối là hệ thống học hỏi từ các tập dữ liệu lớn gồm bản ghi âm giọng người được ghép với văn bản, vì vậy nó có thể dự đoán cả cách các từ nên phát âm và cách một người sẽ tự nhiên truyền tải chúng. Hành vi được học đó là những gì nắm bắt ngữ điệu—trọng âm, nhịp điệu, khoảng dừng và tông cảm xúc—khiến giọng nói kết quả nghe thoải mái trong các buổi nghe dài. Các nhà cung cấp đám mây lớn mô tả những giọng nói nơ-ron này là giọng nói tổng hợp giống con người mà cách phát âm của chúng giảm mệt mỏi khi nghe trong các trợ lý, công cụ trợ năng và trải nghiệm đọc thành tiếng.
Công cụ Text to Speech của chúng tôi tuân theo con đường nơ-ron này. Nó phân tích kịch bản của bạn, chia thành các âm vị, suy ra nhịp điệu và ngữ điệu, sau đó sử dụng các mô hình nơ-ron để tạo ra âm thanh mượt mà thay vì cách truyền tải phẳng lì gắn liền với TTS thế hệ cũ. Kết quả là giọng nói chân thực được tạo ra từ văn bản trong vài giây, lấy từ thư viện hơn 300 giọng nói được điều chỉnh cho các tông và trường hợp sử dụng khác nhau.
Tại sao TTS nơ-ron quan trọng đối với người sáng tạo và các nhóm
Đối với người sáng tạo YouTube, doanh nghiệp nhỏ, nhà sản xuất e-learning, nhà làm phim, người làm podcast và nhà phát triển, câu hỏi thực sự không chỉ là công nghệ hoạt động như thế nào mà còn là có nên dựa vào nó trong một quy trình sản xuất hay không. TTS nơ-ron quan trọng vì nó đưa giọng nói tổng hợp ra khỏi lãnh địa "tiện ích"—chỉ dẫn GPS, lời nhắc cơ bản—và vào lãnh địa của người biểu diễn: đủ tốt để dẫn dắt nội dung tuyến đầu, thuyết minh toàn bộ khóa học và truyền tải thông điệp thương hiệu mà không nghe rõ ràng là nhân tạo. Kết hợp nó với dịch thuật và lồng tiếng, nó trở thành một cấp số nhân, cho phép một kịch bản tiếp cận hàng chục ngôn ngữ với một phần nhỏ chi phí và thời gian của công việc studio truyền thống.
Chúng tôi thiết kế DubSmart xoay quanh chính quyết định đó. Text to Speech, Voice Cloning, AI Dubbing, Speech to Text, Speech Separator, Text to Image và Image to Video nằm trong một quy trình duy nhất, vì vậy nội dung nói chuyển từ tải lên đến xuất đa ngôn ngữ mà không cần loay hoay với các công cụ riêng biệt. Bạn chọn mức độ tự động hóa và mức độ tùy chỉnh tại mỗi giai đoạn—kịch bản, giọng nói, ngôn ngữ, hòa âm—trong một môi trường duy nhất.
Điều đó rơi vào đâu tùy thuộc vào những gì bạn tạo ra:
- Mở rộng kênh YouTube sang các ngôn ngữ mới: TTS nơ-ron cùng với lồng tiếng cho phép bạn tái sử dụng kịch bản và thời điểm trong khi thay thế bằng các giọng nói được bản địa hóa.
- Bản địa hóa video tiếp thị hoặc đào tạo: bạn có được thuyết minh thương hiệu nhất quán trên các ngôn ngữ mà không cần thuê diễn viên lồng tiếng cho mỗi lần cập nhật.
- Sản xuất e-learning hoặc đào tạo doanh nghiệp: thuyết minh dạng dài trở nên có khả năng mở rộng và dễ chỉnh sửa khi nội dung thay đổi.
- Điều hành podcast hoặc phim độc lập: bạn có thể tạo các phiên bản đa ngôn ngữ, các đoạn chèn thuyết minh hoặc các track trợ năng.
- Xây dựng ứng dụng: các API của chúng tôi biến giọng nói nơ-ron thành một dịch vụ có thể gọi được cho IVR, tác nhân và các công cụ nội dung.
Hiểu cơ chế giúp bạn đánh giá nơi một giọng nói nơ-ron có thể đứng độc lập và nơi bản ghi âm của con người nên vẫn là nguồn để nhân bản hoặc lồng tiếng.
Bên trong: quy trình TTS nơ-ron
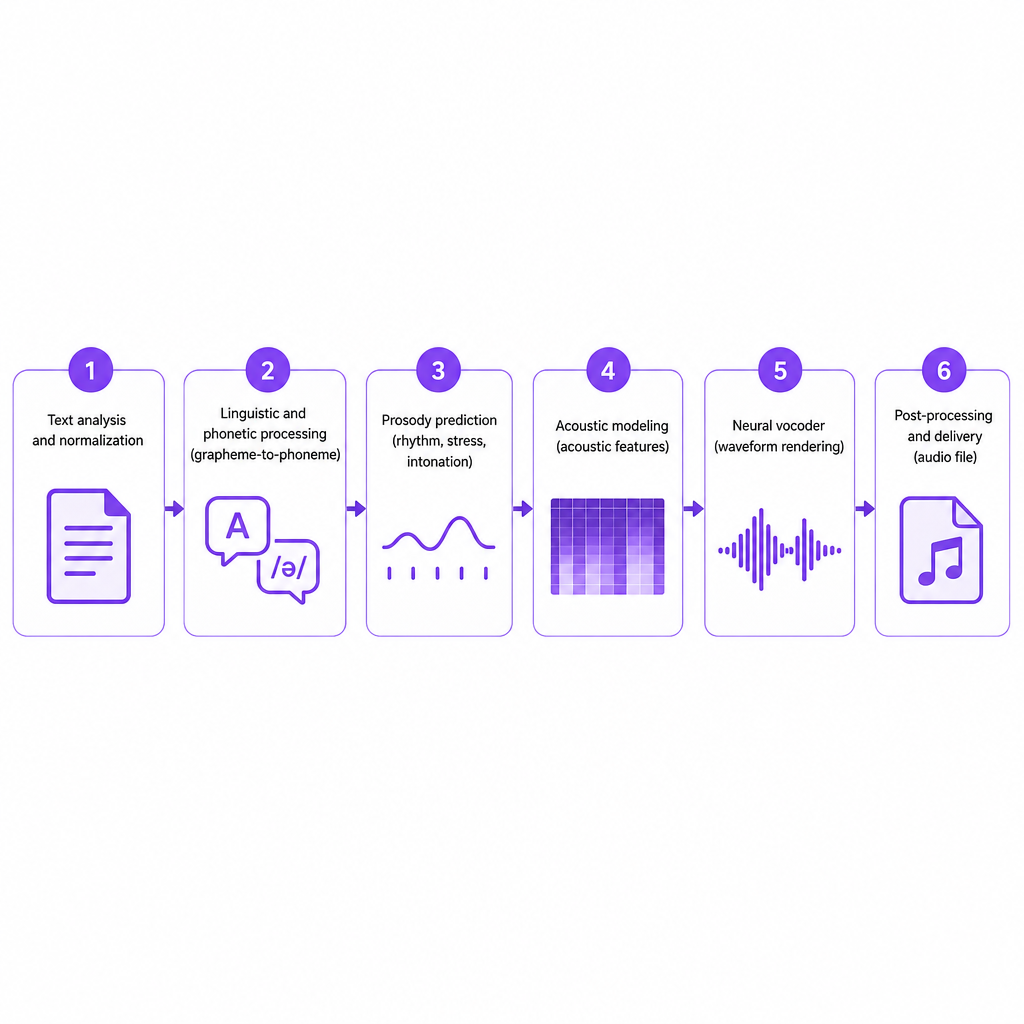
Các công cụ khác nhau về chi tiết, nhưng chúng chia sẻ một quy trình tương tự nhau về tổng thể được mô tả trong tài liệu kỹ thuật và các công bố về AI có trách nhiệm từ các nhà cung cấp lớn, và những giải thích của chúng tôi về cách tạo ra giọng thuyết minh AI cũng phù hợp với nó.
Phân tích và chuẩn hóa văn bản
Đầu tiên hệ thống tiếp nhận văn bản của bạn và chuẩn hóa nó thành dạng có thể nói được. Điều đó có nghĩa là mở rộng các số ("2026" trở thành "hai nghìn không trăm hai mươi sáu"), ngày tháng và chữ viết tắt; giải quyết các mã thông báo mơ hồ như "US" so với "us" dựa trên ngữ cảnh; và đọc dấu câu cùng cấu trúc để lên kế hoạch cho khoảng dừng và nhấn mạnh. Công cụ của chúng tôi diễn giải dấu câu và cấu trúc để suy ra nhịp điệu và dòng chảy thay vì xử lý văn bản như một chuỗi ký tự phẳng. Giai đoạn này có trọng lượng thực sự đối với các kịch bản dài hơn—khóa học, video giải thích, podcast—nơi cấu trúc đoạn văn và tiêu đề định hình cách một người sẽ đọc một cách tự nhiên.
Xử lý ngôn ngữ học và ngữ âm học
Văn bản đã chuẩn hóa được chuyển đổi thành các âm vị, đơn vị âm thanh cơ bản của một ngôn ngữ. Một mô hình chuyển đổi ký tự thành âm vị ánh xạ các ký tự thành âm thanh, xử lý các quy tắc phát âm, ngoại lệ và đầu vào đa ngôn ngữ. Đây là những gì cho phép Text to Speech của chúng tôi chấp nhận các kịch bản trên nhiều ngôn ngữ và tạo ra chuỗi ngữ âm chính xác cho ngôn ngữ được chọn, cho dù bạn sử dụng giọng tích hợp sẵn hay giọng đã nhân bản. Các giọng nói nơ-ron của chúng tôi bao phủ hơn 33 ngôn ngữ, bao gồm tiếng Anh, tiếng Bồ Đào Nha, tiếng Tây Ban Nha, tiếng Pháp, tiếng Đức, tiếng Trung và tiếng Nhật.
Dự đoán ngữ điệu
Ngữ điệu—nhịp điệu, trọng âm và ngữ điệu—là sự khác biệt giữa một giọng nói máy móc và một màn trình diễn giống con người. Các mô hình nơ-ron học các mẫu ngữ điệu trực tiếp từ bản ghi âm, vì vậy chúng có thể quyết định nơi dừng lại và trong bao lâu, chọn từ nào mang tính nhấn mạnh, và điều chỉnh cao độ cùng năng lượng trên một câu hoặc đoạn văn. Các giọng nói nơ-ron độ nét cao đi xa hơn, phát hiện cảm xúc trong văn bản và điều chỉnh tông trong khi giữ một nhân cách ổn định, đó là những gì cho phép truyền tải mang tính đàm thoại hoặc đồng cảm cho nội dung hỗ trợ và thuyết minh. Công cụ của chúng tôi suy ra ngữ điệu trước khi tổng hợp âm thanh vì cùng lý do: để tránh cách truyền tải phẳng lì và tạo ra giọng nói mà bạn có thể nghe suốt cả một mô-đun.
Mô hình âm học
Sau khi các âm vị và ngữ điệu được thiết lập, một mô hình âm học nơ-ron chuyển đổi biểu diễn đó thành các đặc trưng âm học—một bản thiết kế cho sóng âm. Các công bố về AI có trách nhiệm lưu ý rằng, cùng với các bản ghi âm của một diễn viên lồng tiếng cụ thể, các mô hình này cũng dựa trên một thư viện nguồn rộng hơn gồm nhiều người nói. Sự kết hợp đó giúp mạng học các mẫu giọng nói chung trong khi vẫn nắm bắt được âm sắc, giọng điệu và phong cách của một giọng cụ thể. Trong nền tảng của chúng tôi, mô hình hóa này là những gì cho phép hơn 300 giọng nói nghe khác biệt nhưng tự nhiên, và nó làm nền tảng cho nhân bản giọng nói nhanh, nơi hệ thống học chữ ký âm học và ngữ điệu của một giọng nói từ một mẫu ngắn.
Vocoder và kết xuất âm thanh
Các đặc trưng âm học chuyển đến một vocoder nơ-ron, kết xuất chúng thành một dạng sóng âm thanh hoàn chỉnh. Các vocoder mới hơn tạo ra giọng nói độ trung thực cao gần như không thể phân biệt với bản ghi âm studio, với phụ âm rõ ràng, nguyên âm mượt mà và tối thiểu tạp âm. Sự kết hợp của mô hình âm học nơ-ron cùng với vocoder là lý do tại sao các giọng nói nơ-ron nghe tự nhiên hơn nhiều so với công nghệ cũ được sử dụng trong các trình đọc màn hình và IVR truyền thống. Chúng tôi sử dụng những tiến bộ tương tự để âm thanh được tạo ra sẵn sàng để xuất bản trực tiếp hoặc đưa vào một bản hòa âm với nhạc và hiệu ứng âm thanh.
Hậu xử lý và truyền tải
Cuối cùng hệ thống có thể áp dụng hậu xử lý—định hình tạp âm, chuẩn hóa độ lớn hoặc chuyển đổi định dạng—trước khi trả về tệp âm thanh. Đối với các quy trình API, điều này được bọc trong một điểm cuối RESTful chấp nhận văn bản và các tham số giọng nói và trả về một tài sản sẵn sàng sử dụng. Text to Speech của chúng tôi tuân theo chính xác luồng này: dán hoặc gửi văn bản, chọn ngôn ngữ và giọng nói, điều chỉnh cách truyền tải nơi các điều khiển được hiển thị, tạo và tải xuống âm thanh định dạng chuẩn. Cùng một công cụ nằm bên dưới AI Dubbing của chúng tôi, nơi phiên âm, dịch thuật và tổng hợp được liên kết với nhau để tạo ra các phiên bản đa ngôn ngữ.
Các tùy chọn bên trong DubSmart: giọng nói, nhân bản, lồng tiếng và API
Biết cơ chế giải thích tại sao bộ tính năng của chúng tôi được xây dựng theo cách nó là.
Text to Speech cho thuyết minh trực tiếp
Công cụ Text to Speech của chúng tôi là giao diện cốt lõi để biến kịch bản thành âm thanh. Bạn dán hoặc tải lên văn bản bằng bất kỳ ngôn ngữ được hỗ trợ nào, chọn từ hơn 300 giọng nói nghe tự nhiên, thiết lập ngôn ngữ và các điều khiển truyền tải cơ bản nơi có sẵn, và tạo giọng nói trong vài giây. Nó bao phủ các đoạn mở đầu YouTube và thuyết minh toàn bộ video, thuyết minh giải thích và quảng bá cho doanh nghiệp nhỏ, các mô-đun e-learning và đào tạo rõ ràng, cùng các phần mở đầu, kết thúc và giữa chương trình của podcast. Nếu bạn đang cân nhắc các công cụ cho công việc đó, bản tổng hợp của chúng tôi về phần mềm lồng tiếng AI tốt nhất cho người sáng tạo cho thấy cách thuyết minh và bản địa hóa kết nối với nhau.
Nhân bản giọng nói: giữ giọng nói thương hiệu hoặc người dẫn của bạn
Nhân bản giọng nói xây dựng dựa trên cùng các bước nơ-ron—âm vị, ngữ điệu, đặc trưng âm học—nhưng tối ưu hóa mạng để khớp với một âm sắc và phong cách cụ thể, vì vậy bạn có thể tạo ra các dòng mới bằng giọng nói đó mà không cần ghi âm lại. Nhân bản giọng nói nhanh của chúng tôi tạo ra các giọng nói tùy chỉnh mà bạn có thể sử dụng bên trong Text to Speech hoặc AI Dubbing, có nghĩa là nội dung được bản địa hóa vẫn nghe giống như người dẫn, người thuyết minh hoặc thương hiệu của bạn. Sự liên tục đó quan trọng nhất đối với các kênh và công ty đã đầu tư vào một bản sắc giọng nói dễ nhận biết.
AI Dubbing: liên kết văn bản thành giọng nói, dịch thuật và TTS
Lồng tiếng AI sử dụng công cụ TTS làm bước cuối cùng trong một chuỗi dài hơn: phiên âm âm thanh hiện có, dịch bản phiên âm, sau đó tổng hợp giọng nói mới bằng ngôn ngữ đích. AI Dubbing của chúng tôi giữ lồng tiếng, văn bản thành giọng nói, giọng nói thành văn bản và nhân bản bên trong một quy trình duy nhất để nội dung chuyển từ tải lên đến xuất đa ngôn ngữ mà không rời khỏi nền tảng. Trong thực tế, bạn có thể tải lên một video hoặc podcast, cho nó được phiên âm và tách khỏi âm thanh nền, dịch sang một hoặc nhiều ngôn ngữ, sau đó tạo các track lồng tiếng bằng giọng có sẵn hoặc giọng đã nhân bản mà bảo tồn thời điểm và tông. Để xem hướng dẫn từng bước về nội dung nói, hãy xem hướng dẫn của chúng tôi về cách dịch podcast sang ngôn ngữ khác.
API cho nhà phát triển và agency
Chúng tôi cung cấp TTS nơ-ron và lồng tiếng thông qua các API để nhà phát triển và agency có thể tích hợp việc tạo giọng nói vào các sản phẩm của riêng họ. API Text to Speech của chúng tôi là một dịch vụ RESTful chấp nhận yêu cầu POST với nội dung văn bản và tùy chọn giọng nói và trả về âm thanh chất lượng cao, với quyền truy cập vào các giọng nói nơ-ron cao cấp trong hơn 33 ngôn ngữ. API AI Dubbing mở rộng điều đó sang lồng tiếng đa ngôn ngữ tự động. Đối với các agency xử lý bản địa hóa trên nhiều khách hàng, các điểm cuối này chuẩn hóa việc tạo giọng nói trong khi vẫn tùy chỉnh ngôn ngữ và nhân cách theo từng thương hiệu.
Tiêu chí quyết định: lựa chọn và sử dụng TTS nơ-ron hiệu quả
Một khi cơ chế đã rõ ràng, công việc thực tế là quyết định khi nào và làm thế nào để sử dụng nó.
Tính tự nhiên và sự thoải mái khi nghe. Bài kiểm tra cốt lõi là liệu giọng nói có đủ tự nhiên để khán giả của bạn chấp nhận là người thuyết minh chính hay không. Các mạng nơ-ron sâu và giọng nói HD được xây dựng để giảm mệt mỏi khi nghe, nhưng lựa chọn đúng vẫn phụ thuộc vào loại nội dung. Sử dụng thư viện giọng nói lớn của chúng tôi để thử nghiệm các nhân cách—năng động, bình tĩnh, vui tươi, uy quyền—và đối với các khóa học hoặc podcast dạng dài, hãy ưu tiên các giọng nói có ngữ điệu mang tính đàm thoại hơn là kiểu thông báo.
Độ bao phủ ngôn ngữ và sự phù hợp về giọng điệu. Đối với việc mở rộng đa ngôn ngữ, bạn cần cả ngôn ngữ và giọng điệu phù hợp với khán giả đích. Các giọng nói nơ-ron của chúng tôi trải rộng hơn 33 ngôn ngữ trên các thị trường lớn. Khi chọn các track được bản địa hóa, hãy quyết định xem bạn muốn giọng điệu trung tính hay đặc trưng theo vùng, và thử nghiệm các mẫu với người bản ngữ khi có thể.
Sự nhất quán thương hiệu so với tính linh hoạt. Nhân bản mang một giọng nói cụ thể qua các ngôn ngữ và dự án, nhưng nó đưa ra các trách nhiệm xung quanh sự đồng ý và công bố. Sử dụng nó khi một nhân cách nhất quán là trung tâm của thương hiệu của bạn, và ghi lại ai sở hữu và kiểm soát giọng nói đó—đặc biệt là trong công việc doanh nghiệp hoặc agency.
Tích hợp quy trình làm việc. TTS nơ-ron mang lại giá trị nhiều nhất khi nó phù hợp với cách bạn đã làm việc. Vì các công cụ của chúng tôi kết hợp văn bản thành giọng nói, nhân bản, lồng tiếng, giọng nói thành văn bản và các tiện ích truyền thông, bạn có thể tự động hóa phần lớn chuỗi bản địa hóa trong khi vẫn chỉnh sửa kịch bản và âm thanh. Người sáng tạo đơn lẻ có thể thấy các công cụ trình duyệt là đủ; các nhà phát triển và agency có được các điểm cuối có thể lập trình để mở rộng quy mô.
Rủi ro, giới hạn và sử dụng có trách nhiệm
Ngay cả các mô hình tiên tiến cũng có những ranh giới đáng để lên kế hoạch xung quanh.
- Sắc thái cảm xúc: Các giọng nói HD phản hồi với cảm xúc, nhưng có thể bỏ lỡ các tín hiệu tinh tế hoặc các màn trình diễn phức tạp mà một diễn viên lành nghề sẽ truyền tải. Thông điệp thương hiệu quan trọng hoặc kịch tính tường thuật có thể vẫn cần bản ghi âm của con người làm nguồn.
- Các trường hợp phát âm biên: Các tên hiếm, thuật ngữ mới lạ hoặc các kịch bản đa ngôn ngữ có thể thách thức các mô hình chuyển đổi ký tự thành âm vị, vì vậy hãy tích hợp các kiểm tra thủ công.
- Đạo đức nhân bản: Hướng dẫn về AI có trách nhiệm nhấn mạnh rằng các giọng nói tùy chỉnh nên được xây dựng và sử dụng với sự đồng ý rõ ràng, hợp đồng rõ ràng và công bố cho khán giả. Việc bắt chước người khác mà không có sự cho phép làm nảy sinh những lo ngại về pháp lý và đạo đức.
- Thiên kiến và tính đại diện: Dữ liệu huấn luyện định hình cách các giọng nói xử lý giọng điệu và phương ngữ, vì vậy hãy kiểm tra rằng các giọng nói bạn chọn đại diện công bằng cho khán giả của bạn và tránh củng cố các khuôn mẫu.
Bởi vì quy trình tích hợp của chúng tôi giúp dễ dàng tạo ra và triển khai giọng nói tổng hợp, việc xem xét nội bộ quan trọng hơn, chứ không phải ít hơn—đặc biệt là khi bạn xử lý giọng nói của khách hàng hoặc nhân viên. Một con đường cụ thể sẽ giúp ích: một người sáng tạo có thể viết một kịch bản tiếng Anh, tạo một giọng thuyết minh tiếng Anh, sau đó lồng tiếng các phiên bản tiếng Tây Ban Nha, tiếng Bồ Đào Nha và tiếng Đức cho các kênh bổ sung trong khi vẫn giữ cùng thời điểm và cách truyền tải. Một nhóm đào tạo có thể xây dựng thuyết minh mô-đun và tạo lại nó nhanh chóng bất cứ khi nào chính sách thay đổi. Đó là phần thưởng thực sự của việc hiểu quy trình—bạn biết giai đoạn nào cần kiểm soát và giai đoạn nào để mô hình xử lý.
Câu hỏi thường gặp
Văn bản thành giọng nói bằng mạng nơ-ron là gì theo cách đơn giản?
Văn bản thành giọng nói bằng mạng nơ-ron là AI biến văn bản viết thành giọng nói bằng cách sử dụng các mạng nơ-ron sâu được huấn luyện trên các tập dữ liệu lớn gồm bản ghi âm giọng người, tạo ra các giọng nói nghe gần với người thật hơn nhiều so với các hệ thống TTS cũ.
Text to Speech của DubSmart khác gì so với TTS cơ bản?
Chúng tôi sử dụng các mô hình nơ-ron phân tích kịch bản của bạn, suy ra ngữ điệu và tổng hợp giọng nói từ đầu, được hỗ trợ bởi hơn 300 giọng nói tự nhiên và nhân bản giọng nói nhanh, vì vậy đầu ra hoạt động như một người thuyết minh chính cho video, khóa học và podcast.
DubSmart có thể giữ giọng nói của riêng tôi trong các ngôn ngữ khác không?
Có. Nhân bản giọng nói của chúng tôi có thể học giọng nói của bạn từ các bản ghi âm và sau đó sử dụng nó trong văn bản thành giọng nói và lồng tiếng AI, vì vậy các phiên bản được bản địa hóa của nội dung của bạn vẫn nghe giống như bạn hoặc người thuyết minh thương hiệu của bạn.
Lồng tiếng AI hoạt động như thế nào với TTS nơ-ron?
Lồng tiếng AI liên kết phiên âm giọng nói thành văn bản, dịch thuật và văn bản thành giọng nói bằng mạng nơ-ron, biến âm thanh hiện có của bạn thành các track lồng tiếng đa ngôn ngữ trong một quy trình duy nhất, sử dụng giọng có sẵn hoặc giọng đã nhân bản của bạn.
Văn bản thành giọng nói bằng mạng nơ-ron có an toàn và có đạo đức để sử dụng không?
Được sử dụng với sự đồng ý, công bố rõ ràng và các biện pháp bảo vệ phù hợp, TTS nơ-ron là một công cụ mạnh mẽ cho trợ năng và bản địa hóa. Hướng dẫn về AI có trách nhiệm nhấn mạnh việc tôn trọng quyền của diễn viên lồng tiếng và tránh các cách sử dụng lừa dối giọng nói tổng hợp.