Một bản ghi chép sạch sẽ từ podcast dài 30 phút hoặc video đào tạo hoàn toàn khả thi trong chưa đầy 10 phút với DubSmart AI, và hầu hết các nhà sáng tạo xử lý việc này với chi phí từ 0 đến khoảng 20–50 USD mỗi tháng tùy theo khối lượng. Nếu bạn muốn biết cách chuyển âm thanh thành văn bản mà không cần ghép nối một ứng dụng phiên âm riêng, một công cụ khử tiếng ồn và một trình chỉnh sửa phụ đề, công cụ Speech to Text của chúng tôi chạy toàn bộ công việc trong một không gian làm việc duy nhất: tải lên phương tiện, tạo văn bản với độ chính xác trên 95% trên âm thanh rõ ràng, chỉnh sửa nhãn người nói và dấu câu, rồi xuất bản ghi chép hoặc phụ đề sẵn sàng để xuất bản.
Lợi thế thực sự ở đây không chỉ là tốc độ. Vì phiên âm, làm sạch âm thanh, lồng tiếng và thuyết minh dùng chung một nguồn tín dụng, nên cùng một bản ghi chép bạn tạo hôm nay có thể cung cấp cho AI Dubbing sang 33 ngôn ngữ đích hoặc Text to Speech với hơn 300 giọng nói sau này. Điều đó quan trọng nếu bạn vận hành một kênh YouTube, xây dựng các khóa học trực tuyến hoặc bản địa hóa các khóa đào tạo doanh nghiệp.
Mục lục
Những gì bạn cần trước khi bắt đầu
Chất lượng phiên âm được quyết định trước khi bạn nhấn một nút nào. Hãy xem qua danh sách kiểm tra này trước:
- Một tài khoản DubSmart có quyền truy cập vào Speech to Text và Speech Separator trên gói Miễn phí, Starter, hoặc gói cao hơn.
- Các tệp nguồn của bạn đã sẵn sàng: các tập podcast, hội thảo trực tuyến, phỏng vấn, hoặc một liên kết YouTube.
- Quyền và sự cho phép để phiên âm nội dung, điều quan trọng nhất đối với công việc của khách hàng và các bản ghi của bên thứ ba.
- Một đầu ra mục tiêu rõ ràng trong đầu: một bản ghi chép đầy đủ (DOC/TXT), phụ đề (SRT/VTT), hoặc một kịch bản để lồng tiếng và thuyết minh.
- Thông tin cơ bản về bản ghi: ngôn ngữ nguồn, số lượng người nói, và liệu có nhạc hoặc tiếng ồn nền nhiều hay không.
- Đối với các nhóm chịu sự quản lý, hãy nắm hướng dẫn nội bộ về việc xử lý dữ liệu cá nhân hoặc nhạy cảm trong các công cụ đám mây.
Biết trước định dạng đầu ra của bạn sẽ tiết kiệm được một vòng làm lại. Công việc ghi chú cho blog cần văn bản thuần túy; một bản tải lên YouTube cần phụ đề có thời gian; một công việc bản địa hóa cần một kịch bản sạch sẽ mà bạn có thể đẩy thẳng vào lồng tiếng.
Từng bước: chuyển âm thanh thành văn bản với DubSmart
1. Chọn đúng công cụ cho bản ghi
Speech to Text chuyển đổi âm thanh nói thành văn bản viết, và nó hoạt động cùng với Speech Separator cho các bản ghi ồn ào. Tín dụng được chia sẻ giữa AI Dubbing, Text to Speech, Voice Cloning, Speech to Text, và Speech Separator, vì vậy mỗi phút bạn xử lý đều rút từ cùng một nguồn.
Quyết định rất đơn giản. Nếu bản ghi có nhạc, tiếng ồn đám đông, hoặc tiếng vọng phòng, hãy bắt đầu với Speech Separator để tách riêng giọng nói. Nếu âm thanh đã sạch, hãy bỏ qua và chuyển thẳng đến phiên âm.
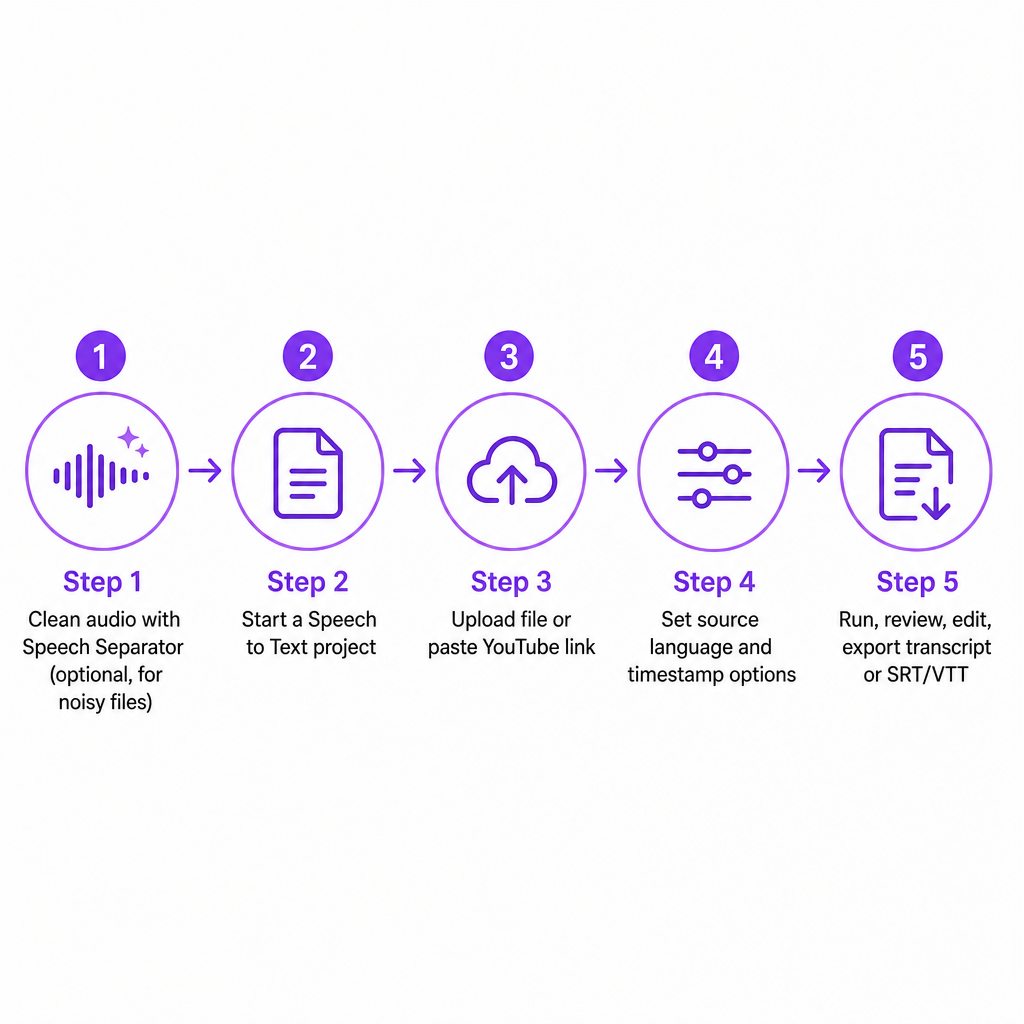
2. Làm sạch âm thanh với Speech Separator (khuyến nghị)
Đầu vào chất lượng cao là yếu tố lớn nhất quyết định độ chính xác của phiên âm tự động, đặc biệt với các podcast, phỏng vấn và tọa đàm có nhiều người nói. Speech Separator tách giọng nói khỏi nhạc và tiếng ồn nền trong các định dạng phổ biến như MP3, WAV, và AAC, để lại một bản nhạc giọng nói sạch hơn.
- Mở công cụ Speech Separator trong tài khoản của bạn.
- Tải lên âm thanh hoặc video của bạn từ thiết bị, hoặc chọn từ các dự án của bạn.
- Để AI tách giọng nói khỏi nền; việc này thường hoàn tất trong vài giây đến vài phút tùy theo độ dài.
- Lưu tệp giọng nói sạch vào thư viện dự án của bạn.
Với bản nhạc đã được làm sạch trong tay, giai đoạn phiên âm tạo ra ít lỗi hơn và cần ít chỉnh sửa thủ công hơn.
3. Bắt đầu một dự án Speech to Text mới
Quy trình được thiết kế ngắn gọn có chủ đích: chọn tính năng, tải lên phương tiện, chỉnh sửa, xuất.
- Đăng nhập và mở bảng điều khiển không gian làm việc.
- Chọn Speech to Text từ danh sách công cụ.
- Tạo một dự án mới và đặt cho nó một cái tên mô tả, chẳng hạn như "Hội thảo sản phẩm – Tháng Mười."
Việc đặt tên dự án giúp giữ các bản ghi chép được tổ chức ngăn nắp và dễ dàng tái sử dụng để làm phụ đề, lồng tiếng, hoặc chuyển văn bản thành giọng nói sau này.
4. Tải lên âm thanh hoặc video của bạn
Bạn có thể tải tệp lên trực tiếp hoặc lấy từ một URL YouTube, điều này tiện lợi cho các nhà sáng tạo và đại lý quản lý kênh của khách hàng.
- Tải lên âm thanh hoặc video từ thiết bị của bạn ở các định dạng chuẩn như MP3, WAV, và MP4.
- Dán một URL YouTube để đưa video thẳng vào dự án, bao gồm cả các bản tải lên 1080p nơi được hỗ trợ.
DubSmart sau đó phân tích tệp, trích xuất âm thanh, và chuẩn bị nó cho việc nhận dạng.
5. Thiết lập ngôn ngữ và các tùy chọn nhận dạng
Speech to Text hỗ trợ hơn 60 ngôn ngữ bao gồm tiếng Anh, Tây Ban Nha, Đức, Hindi, Thổ Nhĩ Kỳ, Bồ Đào Nha, Nhật, Nga, Trung, và Ả Rập. Thiết lập đúng ngôn ngữ nguồn không phải là chi tiết tùy chọn; công cụ dựa vào các mô hình đặc thù theo ngôn ngữ để giải mã lời nói thành văn bản.
- Chọn ngôn ngữ nguồn phù hợp với bản ghi. Đối với nội dung đa ngôn ngữ, hãy bắt đầu với ngôn ngữ chủ đạo.
- Nếu có nhiều người nói, hãy lên kế hoạch thêm nhãn người nói trong quá trình chỉnh sửa.
- Xác nhận các tùy chọn dấu thời gian và phân đoạn nếu bạn dự định xuất phụ đề SRT hoặc VTT thay vì một bản ghi chép thuần túy.
Đối với hầu hết các tệp một người nói, việc nhận dạng chạy ở tốc độ bằng hoặc nhanh hơn thời gian thực, vì vậy quá trình xử lý thường hoàn tất trong khoảng thời gian bằng độ dài của bản ghi.
6. Chạy phiên âm
Khởi động quá trình và để công cụ làm việc. Nó phân đoạn âm thanh, xác định các âm vị và từ ngữ, và áp dụng các mô hình ngôn ngữ để tạo ra văn bản. Trên âm thanh rõ ràng, độ chính xác đạt trên 95%, giúp giảm mạnh khối lượng chỉnh sửa của bạn. Trong khi nó chạy, hãy chuẩn bị một bảng thuật ngữ ngắn gồm tên, thương hiệu, hoặc thuật ngữ kỹ thuật mà bạn đã biết sẽ cần chuẩn hóa.
7. Xem lại và chỉnh sửa bản ghi chép
Đầu ra tự động thì nhanh, nhưng văn bản đạt chuẩn chuyên nghiệp vẫn cần một lần rà soát của con người, đặc biệt với tên riêng, từ viết tắt, và thuật ngữ chuyên ngành. Hãy chỉnh sửa trực tiếp bên trong trình chỉnh sửa dự án:
- Đọc qua trong khi nghe các đoạn quan trọng để bắt các từ bị nghe nhầm.
- Thêm nhãn người nói như Người dẫn chương trình, Khách mời, hoặc Giảng viên để dễ theo dõi cuộc đối thoại.
- Sửa dấu câu và viết hoa, vốn ảnh hưởng đến cả khả năng đọc hiểu và thời gian của phụ đề.
- Chuẩn hóa thuật ngữ, như tên sản phẩm, thuật ngữ y tế, hoặc cụm từ pháp lý, dựa theo bảng thuật ngữ thương hiệu hoặc tuân thủ của bạn.
Vì cùng một bản ghi chép sau này có thể cung cấp cho AI Dubbing sang hơn 33 ngôn ngữ và Text to Speech với hơn 300 giọng nói, một lần chỉnh sửa cẩn thận bây giờ sẽ mang lại lợi ích mỗi khi bạn tái sử dụng nội dung.
8. Xuất văn bản hoặc phụ đề
Khi các chỉnh sửa trông đã ổn, hãy xuất ở định dạng mà trường hợp sử dụng của bạn cần:
- Phụ đề (SRT hoặc VTT) cho YouTube, các nền tảng LMS, và cổng video doanh nghiệp.
- Văn bản thuần túy (TXT) hoặc các định dạng tài liệu cho blog, ghi chú chương trình, sổ tay đào tạo, và biên bản cuộc họp.
Chọn định dạng, rồi tải xuống hoặc lưu dự án đã hoàn thành. Điều đó hoàn tất quy trình cốt lõi về cách chuyển âm thanh thành văn bản trong DubSmart.
Thời gian và chi phí: điều cần mong đợi
DubSmart chạy trên một hệ thống dựa trên tín dụng áp dụng cho AI Dubbing, Text to Speech, Voice Cloning, Speech to Text, và Speech Separator. Tín dụng có thể hoán đổi, vì vậy một nguồn chung bao phủ số phút phiên âm, làm sạch âm thanh, và lồng tiếng. Từ bảng giá đã công bố của chúng tôi:
| Gói | Giá hàng tháng | Tín dụng hàng tháng | Ghi chú |
|---|---|---|---|
| Miễn phí | $0 | 2.000 | Khoảng 2 phút AI Dubbing/TTS để thử nghiệm quy trình |
| Starter | ~$20 | 50.000 | Khoảng 50 phút AI Dubbing/TTS; tín dụng chưa dùng được chuyển sang tháng sau |
| Standard | ~$50 | 150.000 | Khối lượng cao hơn với chi phí thấp hơn trên mỗi 1.000 tín dụng |
Vì tín dụng trải rộng cho phiên âm, làm sạch giọng nói, và lồng tiếng, bạn có thể xem toàn bộ quy trình như một ngân sách duy nhất thay vì các công cụ riêng lẻ. Đối với hầu hết các nhà sáng tạo, điều đó có nghĩa là phiên âm hàng chục video ngắn mỗi tháng với mức giá gói Starter trong khi vẫn giữ lại dung lượng tín dụng cho lồng tiếng và thuyết minh.
Các lỗi thường gặp và cách khắc phục
Sử dụng âm thanh ồn ào mà không làm sạch. Nhạc nền, tiếng ồn đám đông, hoặc tiếng vọng gây ra nhận dạng sai và chỉnh sửa thêm. Hãy chạy tệp qua Speech Separator trước, rồi phiên âm bản nhạc giọng nói đã được tách để có độ chính xác cao hơn và thời gian phụ đề sạch hơn.
Chọn sai ngôn ngữ nguồn. Nếu bạn để nó ở tiếng Anh trong khi âm thanh là tiếng Tây Ban Nha, công cụ sẽ hiểu sai các âm vị và tạo ra văn bản không dùng được. Hãy kiểm tra kỹ ngôn ngữ trước khi bắt đầu, và đối với các video đa ngôn ngữ, hãy phân đoạn theo ngôn ngữ hoặc ưu tiên ngôn ngữ chính cho lượt đầu tiên.
Bỏ qua nhãn người nói. Các podcast và tọa đàm nhiều người nói rất khó đọc nếu không có quy gán. Hãy thêm các nhãn như Người dẫn, Khách mời 1, hoặc các thẻ dựa trên tên trong quá trình chỉnh sửa, và giữ chúng nhất quán qua các tập.
Bỏ qua việc rà soát của con người đối với nội dung quan trọng. Đối với tài liệu pháp lý, y tế, hoặc nhạy cảm về tuân thủ, một lỗi nhỏ có thể làm thay đổi ý nghĩa. Hãy xem bản ghi chép tự động như một bản nháp đầu tiên và tiến hành kiểm định đầy đủ của con người, kết hợp với người rà soát nội bộ hoặc kiểm tra tuân thủ bên ngoài khi cần thiết.
Ước tính sai tín dụng. Chạy một kho nội dung cũ lớn mà không hiểu rõ mức sử dụng có thể làm cạn hạn mức của bạn. Hãy kiểm tra tín dụng hàng tháng và chính sách chuyển tiếp của gói bạn trước, rồi chạy một lô thử nghiệm nhỏ để đo số phút trên mỗi tín dụng qua Speech Separator và Speech to Text trước khi cam kết công việc hàng loạt.
Tự làm so với hỗ trợ chuyên nghiệp: ranh giới ở đâu
DubSmart được xây dựng để tự phục vụ bởi các nhà sáng tạo, doanh nghiệp nhỏ, các nhóm học trực tuyến, và đại lý muốn có nội dung đa ngôn ngữ có khả năng mở rộng mà không cần tung hứng nhiều nhà cung cấp. Các công cụ dựa trên trình duyệt, một gói miễn phí, và một mô hình tín dụng chung cho phép hầu hết người dùng tự xử lý phiên âm, làm sạch, và lồng tiếng.
Tự phục vụ thường là đủ khi:
- Bạn phiên âm nội dung theo tập như podcast, video YouTube, bản giới thiệu sản phẩm, hoặc đào tạo nội bộ.
- Âm thanh tương đối sạch hoặc có thể được cải thiện bằng Speech Separator.
- Độ chính xác cần cao nhưng không mang tính ràng buộc pháp lý, chẳng hạn như phụ đề hỗ trợ tiếp cận, tài liệu khóa học, hoặc tài liệu tiếp thị.
- Khối lượng hàng tháng của bạn nằm trong tín dụng khả dụng với dư địa còn lại cho lồng tiếng hoặc thuyết minh.
Hãy nghiêng về hỗ trợ chuyên nghiệp hoặc cấp doanh nghiệp khi:
- Bạn quản lý các kho nội dung lớn, hàng trăm giờ, cần QA, phong cách, và thuật ngữ nhất quán qua các khu vực.
- Nội dung của bạn thuộc các tiêu chuẩn pháp lý hoặc quy định nghiêm ngặt, như thủ tục tố tụng tại tòa, hồ sơ y tế, hoặc công bố tài chính.
- Bạn cần tích hợp AI Dubbing API hoặc Text to Speech API của chúng tôi vào các quy trình phức tạp với yêu cầu về thời gian hoạt động và thông lượng cho khách hàng.
Trong những trường hợp đó, kết hợp tự động hóa của chúng tôi với rà soát ngôn ngữ hoặc tuân thủ chuyên nghiệp mang lại cho bạn sự cân bằng tốt nhất giữa tốc độ, chi phí, và rủi ro. Đối với hầu hết việc phiên âm hàng ngày, con đường tự phục vụ nhanh hơn và rẻ hơn, và nó giữ cho bản ghi chép của bạn luôn sẵn sàng để trở thành phụ đề, bản lồng tiếng, hoặc thuyết minh bất cứ khi nào bạn cần.
Câu hỏi thường gặp
DubSmart có thể phiên âm những loại nội dung nào?
Speech to Text xử lý podcast, video YouTube, hội thảo trực tuyến, phỏng vấn, phim, và đào tạo doanh nghiệp, miễn là âm thanh có sẵn thông qua tải lên hoặc một liên kết.
Những ngôn ngữ nào được hỗ trợ cho phiên âm?
Speech to Text hỗ trợ hơn 60 ngôn ngữ, bao gồm tiếng Anh, Tây Ban Nha, Đức, Hindi, Thổ Nhĩ Kỳ, Bồ Đào Nha, Nhật, Nga, Trung, và Ả Rập, và cùng một nền tảng lồng tiếng sang 33 ngôn ngữ đích.
Speech to Text của DubSmart chính xác đến mức nào?
Trên âm thanh rõ ràng với ngôn ngữ đúng được chọn, độ chính xác đạt trên 95%, phù hợp với nhận dạng giọng nói tự động hiện đại.
Chi phí phiên âm với DubSmart là bao nhiêu?
Giá bắt đầu từ $0/tháng với gói miễn phí gồm 2.000 tín dụng. Các gói trả phí như Starter (khoảng $20/tháng) và Standard (khoảng $50/tháng) bổ sung tín dụng và giảm chi phí trên mỗi tín dụng, và tín dụng được chia sẻ qua phiên âm, lồng tiếng, và các công cụ liên quan.
Tôi có thể dùng bản ghi chép cho lồng tiếng và thuyết minh không?
Có. Đầu ra của Speech to Text có thể được đưa trực tiếp vào AI Dubbing và Text to Speech để tạo ra các phiên bản lồng tiếng đa ngôn ngữ và thuyết minh AI sử dụng hơn 300 giọng nói tự nhiên.