Khi mọi người tìm kiếm ghostface text to speech, họ thường muốn một thứ: biến một kịch bản viết thành một giọng nói u ám, đe dọa gợi nhớ đến kẻ gọi điện đeo mặt nạ trong loạt phim Scream. Điều họ hiếm khi nhận ra là việc này gần như không bao giờ có nghĩa là tạo ra giọng nói nhân vật chính thức. Trong phim, màn thể hiện đó thuộc về diễn viên lồng tiếng Roger L. Jackson, được truyền tải qua một thiết bị biến đổi giọng nói trong câu chuyện. Một công cụ chuyển văn bản thành giọng nói làm điều khác biệt: nó tạo ra lời nói hoàn toàn mới từ văn bản của bạn bằng cách sử dụng mô hình giọng nói tổng hợp hoặc được cấp phép. Vậy câu hỏi thực sự không phải là "làm thế nào để tôi có được giọng Ghostface?" Mà là "tôi cần một màn thể hiện được cấp phép, hay một giọng kinh dị nguyên bản với cùng những phẩm chất gây bất an—âm vực trầm, nhịp độ chủ đích, những khoảng lặng đầy ẩn ý, và cách truyền tải đe dọa?"
Sự phân biệt đó định hình mọi lựa chọn tiếp theo, từ việc bạn chọn giọng nói nào đến những gì bạn có thể xuất bản hợp pháp. Chúng ta sẽ đi qua cách âm thanh thực sự được xây dựng, DubSmart AI phù hợp ở đâu, và cách giữ đúng với các quy tắc về quyền giọng nói tại Hoa Kỳ.
Mục lục
Ghostface text to speech thực sự có nghĩa là gì
Về cốt lõi, ghostface text to speech là một trường hợp sử dụng tường thuật kinh dị cho một công cụ giọng nói AI đa dụng. Các nhà sáng tạo tìm đến nó để lồng tiếng cho video Halloween, truyện kinh dị hư cấu, trailer game, các tiểu phẩm hài-kinh dị, podcast hồi hộp, nhân vật hoạt hình, và phim ngắn với dàn diễn viên nguyên bản.
Một hệ thống chuyển văn bản thành giọng nói đọc văn bản của bạn, chuyển đổi các từ thành thông tin về phát âm và ngôn ngữ, dự đoán các đặc điểm giọng nói như nhịp điệu, cao độ, nhấn nhá và các khoảng lặng, rồi tổng hợp những đặc điểm đó thành một sóng âm thanh. Đầu ra là một bản thu mới được tạo ra từ văn bản thay vì các câu thoại được thu từng câu từ một diễn viên thật. Công cụ Text to Speech của chúng tôi chạy chính xác quy trình này, sử dụng các thuật toán mô phỏng ngữ điệu con người trên hơn 300 giọng nói, nhiều ngôn ngữ và giọng điệu, với các điều khiển cho tốc độ nói, cảm xúc, và nhấn nhá, cùng âm thanh có thể tải xuống.
Nhân vật đe dọa mà bạn muốn không phải là một nút bấm duy nhất. Nó xuất hiện từ cách bạn kết hợp giọng nói mình chọn với cách bạn viết và xử lý kịch bản. Nếu bạn mới làm quen với công nghệ nền tảng, bài giải thích của chúng tôi về cách chuyển văn bản thành giọng nói bằng mạng nơ-ron hoạt động trình bày quy trình sâu hơn.
Đó có phải là giọng Ghostface thật không?
Thường thì không—và điều này quan trọng hơn so với cái nhìn ban đầu. Một "giọng Ghostface" được cung cấp bởi một trình tạo trực tuyến thường là một trong bốn thứ: một giọng kinh dị chung chung được tạo ra để nghe u ám và kịch tính; một preset bắt chước phong cách nhằm gợi lên nhịp độ và thái độ của nhân vật; một hiệu ứng chuyển đổi giọng nói định hình lại một bản thu bằng cao độ và sự méo tiếng; hoặc một bản sao trái phép được huấn luyện để bắt chước một người thể hiện dễ nhận biết mà không có sự cho phép rõ ràng.
Chúng không thể thay thế cho nhau, cả về mặt pháp lý lẫn kỹ thuật. Một giọng kinh dị nguyên bản lấy cảm hứng là ổn cho một nhân vật mà bạn tự tạo ra. Một sự bắt chước chân thực của một diễn viên nổi tiếng hoặc một nhân vật hư cấu có thương hiệu kéo theo các vấn đề về quyền và cấp phép chẳng liên quan gì đến chất lượng âm thanh nghe hay đến đâu.
Trang Text to Speech công khai của chúng tôi liệt kê các giọng có sẵn và tính năng nhân bản giọng nói; nó không cung cấp giọng Ghostface Scream chính thức hay giọng Roger L. Jackson. Vậy nên hãy coi bất kỳ trang của bên thứ ba nào gắn nhãn "Ghostface" lên một preset là tiếp thị, không phải bằng chứng về việc cấp phép. Đừng trình bày âm thanh được tạo ra là chính thức, được phê chuẩn, hay do Jackson thể hiện trừ khi bạn có sự cho phép riêng.
Cách âm thanh đe dọa được tạo ra
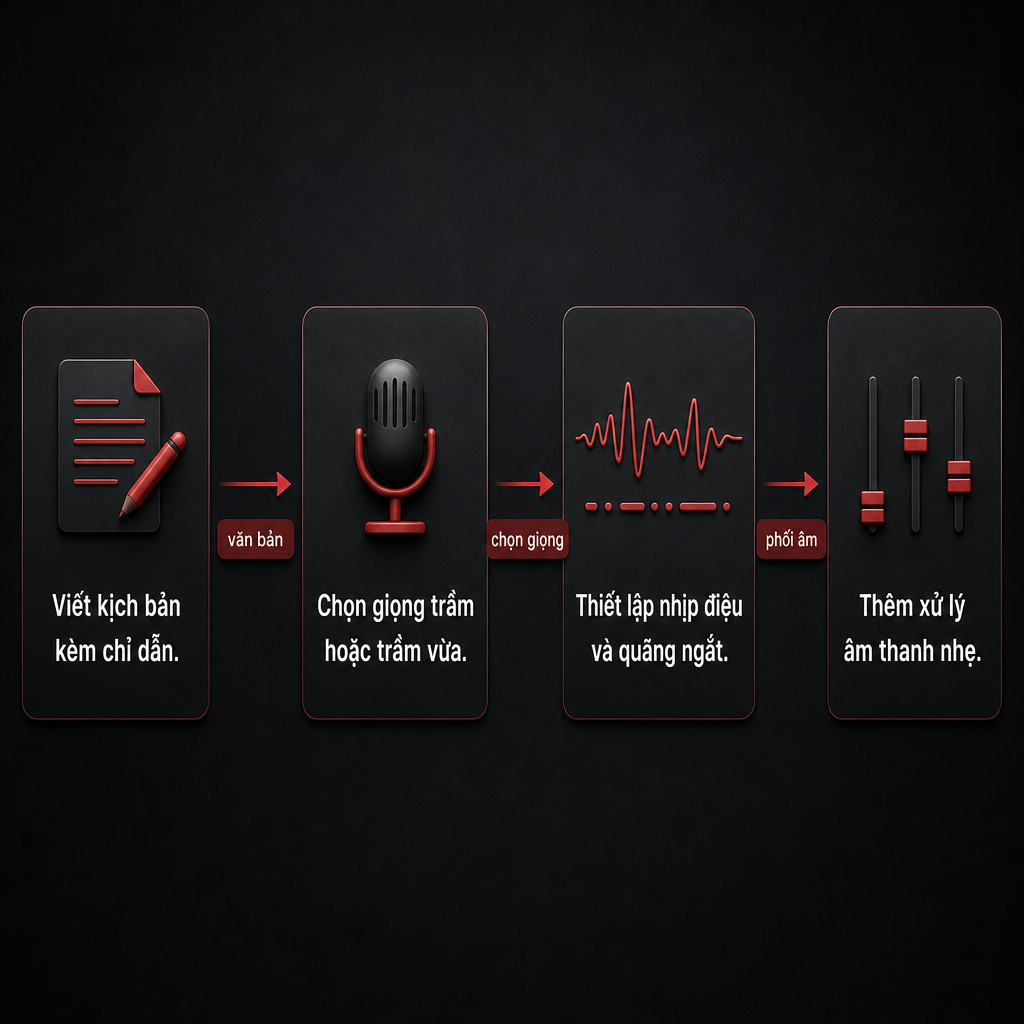
Hiệu ứng dễ nhận biết đến từ các lựa chọn xếp lớp, không phải một thanh trượt. Mỗi lớp là một đòn bẩy bạn có thể thử nghiệm độc lập.
Âm vực giọng nói. Cao độ thấp hơn thêm trọng lượng và sự đe dọa, nhưng hạ xuống mức thấp nhất có sẵn thường tạo ra kết quả không tự nhiên, bị méo tiếng. Hãy nhắm đến một mức giảm vừa phải để giữ cho các từ dễ nghe trên loa điện thoại, loa laptop, và tai nghe như nhau.
Nhịp độ được kiểm soát. Lời thoại kiểu Ghostface cảm giác có chủ đích. Cách truyền tải chậm hơn cho phép người nghe dự đoán câu tiếp theo và khiến những câu ngắn trở thành những lời đối đầu. Tốc độ nói có thể điều chỉnh trong quy trình của chúng tôi, nơi mặc định 1.00x có thể được tinh chỉnh theo từng dự án. Bước đi khôn ngoan là chỉ làm chậm những câu đe dọa; làm chậm mọi thứ sẽ làm bẹt sự căng thẳng và nghe giả tạo.
Khoảng lặng. Sự im lặng tạo ra nhiều nỗi sợ hãi hơn so với sự méo tiếng liên tục. Chèn dấu câu, ngắt dòng, hoặc tách các đoạn thoại riêng biệt ở nơi người nói nên ngập ngừng. "Bạn có thích phim kinh dị không?" trở nên bất an hơn nhiều khi thành "Bạn có thích… phim kinh dị không?" Các khoảng lặng ngắn hoạt động tốt nhất ngay trước một cái tên, một tiết lộ, một lời đe dọa, hoặc một câu hỏi.
Nhấn nhá thông qua chỉ dẫn bằng văn bản. Giọng nói tổng hợp phản hồi với các chỉ dẫn rõ ràng tốt hơn các chỉ dẫn mơ hồ. Bạn có thể sử dụng các thẻ thoại như "anh ấy nói vui vẻ" hoặc "anh ấy hét lên giận dữ" để báo hiệu tông cảm xúc, và viết hoa để nhấn một nguyên âm. Với kinh dị, hãy mô tả cách truyền tải ngay trong kịch bản:
[khẽ khàng, kiểm soát, đe dọa] Lẽ ra ngươi không nên bắt máy.
Hãy cưỡng lại thôi thúc hét lên bằng chữ in hoa ở khắp nơi. Nhấn nhá quá mức sẽ được hiểu là la hét, không phải sự đe dọa.
Độ dài câu. Các câu ngắn cho mô hình nhiều không gian hơn để kiểm soát kịch tính. So sánh "Tôi đã theo dõi anh trong vài phút, và tôi biết chính xác anh đã làm gì tối qua" với:
Tôi đã thấy anh. Tôi biết anh đã làm gì.
Phiên bản ngắt gãy trao cho giọng nói nhiều cơ hội hơn để tạm dừng và thay đổi cường độ.
Xử lý âm thanh. TTS tạo ra giọng nói; việc chỉnh sửa định hình nỗi kinh dị. Sau khi bạn có một bản thu sạch, thêm tiếng vang phòng tinh tế, lọc dải tần điện thoại, bão hòa nhẹ, nén được kiểm soát, âm nền môi trường, và nhạc hay hiệu ứng được pha trộn cẩn thận. Áp dụng những thứ này cuối cùng. Xử lý nặng tay ngay từ đầu che giấu các vấn đề về phát âm và chôn vùi các từ.
Giọng có sẵn, nhân bản, hay người thể hiện thật
Chuyển văn bản thành giọng nói và nhân bản giọng nói giải quyết các vấn đề khác nhau, và việc chọn sai tạo ra hoặc một màn thể hiện yếu hoặc một cơn đau đầu về quyền. Bảng so sánh này vạch ra những sự đánh đổi.
| Lựa chọn | Phù hợp nhất cho | Đầu vào chính | Rủi ro chính |
|---|---|---|---|
| Giọng AI có sẵn | Tường thuật nhanh, nhân vật nguyên bản | Văn bản | Giọng có thể không khớp với nhân vật dự định |
| Nhân bản giọng nói | Tái sử dụng danh tính của người tường thuật được cấp phép | Mẫu giọng sạch và văn bản | Các lo ngại về sự đồng ý và mạo danh |
| Chuyển đổi giọng nói | Biến đổi một màn thể hiện đã có | Lời nói đã thu | Có thể bắt chước một người thật quá sát |
| Diễn viên lồng tiếng thật | Công việc nhân vật được cấp phép, diễn xuất tinh tế | Kịch bản và chỉ đạo | Chi phí và thời gian sản xuất cao hơn |
Chúng tôi giữ Text to Speech và Nhân bản giọng nói là các công cụ riêng biệt vì lý do này. Sản phẩm Text to Speech của chúng tôi hỗ trợ các giọng có sẵn và cho phép bạn nhân bản giọng nói để sử dụng trên nhiều ngôn ngữ, nhưng các trang công khai của chúng tôi không thiết lập bất kỳ quyền nào để nhân bản một người nổi tiếng, nhân vật hư cấu, hay màn thể hiện có bản quyền mà không có sự cho phép. Với một nhân vật kinh dị tự tạo, một giọng có sẵn với chỉ đạo bằng văn bản sắc bén thường là con đường an toàn và nhanh hơn. Với một người tường thuật kênh định kỳ, hãy nhân bản giọng của chính bạn hoặc sử dụng một người thể hiện đã cho phép rõ ràng.
Xây dựng giọng kinh dị nguyên bản trong DubSmart AI
Quy trình Text to Speech của chúng tôi biến một kịch bản thành âm thanh được tạo ra: mở Text to Speech, nhập văn bản của bạn, chọn người nói, tạo lời nói, chỉnh sửa dự án, và tải xuống kết quả. Để có kết quả lấy cảm hứng từ Ghostface nhưng nguyên bản, một vài thói quen tạo ra sự khác biệt giữa một kẻ phản diện thuyết phục và một con robot lộ liễu.
Chọn giọng theo hành vi, không theo tên. Tìm một giọng điềm tĩnh thay vì sôi nổi, âm vực trầm hoặc trung trầm, rành mạch ở tốc độ chậm hơn, có khả năng truyền tải cảm xúc được kiểm soát, và phù hợp với tuổi tác và danh tính của nhân vật của bạn. Tránh chọn một giọng chỉ vì một trang gắn nhãn nó là "Ghostface"; nhãn đó thường mô tả một sự bắt chước, không phải một màn thể hiện được cấp phép.
Viết màn thể hiện vào kịch bản bằng các chỉ dẫn tiết chế:
[trầm, điềm tĩnh, gần như thích thú] Ngươi đã bắt máy. [khoảng lặng] Đó là một sai lầm.
Mục đích là định hướng tông giọng mà không yêu cầu hệ thống tái tạo chính xác cách truyền tải của một diễn viên có tên.
Sửa phát âm trước khi thêm hiệu ứng. Nếu một cái tên hoặc một con số bị đọc sai, hãy viết lại theo phiên âm hoặc đánh vần ra—viết các con số thành chữ sẽ giúp khi hệ thống đọc sai chúng. Tạo ra nhiều phiên bản của các câu khó; một bản thu sạch, chính xác thắng một bản xử lý nặng nề mà không ai hiểu được.
Cuối cùng, so sánh các mẫu thử ngắn trước khi cam kết với một tập đầy đủ. Chạy ba câu giống nhau qua vài giọng và tốc độ: một câu trung tính, một câu thì thầm hoặc khẽ khàng, và một lời đe dọa bất ngờ. Chọn giọng vẫn giữ được sự đáng tin qua cả ba. Một giọng gây choáng ngợp trong một câu có thể trở nên máy móc qua một kịch bản dài hơn. Nếu câu chuyện của bạn đi xa hơn, AI Dubbing của chúng tôi có thể mang giọng nói sang các ngôn ngữ khác—chỉ cần xem lại từng cái, vì việc dịch thuật thay đổi nhịp điệu và sức nặng văn hóa của một lời đe dọa.
Quyền giọng nói và đạo đức tại Hoa Kỳ
Việc bắt chước giọng nói liên quan nhiều hơn bản quyền. Báo cáo của Văn phòng Bản quyền Hoa Kỳ về các bản sao kỹ thuật số đề cập đến công nghệ tái tạo một cách chân thực giọng nói hoặc ngoại hình của một người; nó lưu ý rằng luật bản quyền không thay thế các luật hạn chế việc tạo bản sao giọng nói trái phép và thảo luận về quyền công khai, đặc biệt là nơi danh tính của một người được sử dụng cho mục đích thương mại. Bạn có thể đọc nguồn gốc trong báo cáo về bản sao kỹ thuật số của Văn phòng Bản quyền.
Các thực hành an toàn nhất rất đơn giản: đừng nhân bản giọng nói của người khác mà không có sự cho phép; đừng mô tả một sự bắt chước là giọng nói chính thức; đừng sử dụng giọng của một diễn viên dễ nhận biết để bán sản phẩm mà không có sự ủy quyền; và không bao giờ sử dụng âm thanh được tạo ra cho lừa đảo, quấy rối, đe dọa, hoặc dối trá. Công bố sự tham gia của AI khi bối cảnh có thể gây nhầm lẫn cho người xem, lưu giữ hồ sơ về sự đồng ý và các mục đích sử dụng được cho phép đối với bất kỳ mẫu giọng nào, và xem lại riêng các quyền gắn với nhạc, đoạn phim, kịch bản, và tên nhân vật.
Có một lý do thực tế để coi trọng việc mạo danh. Ủy ban Thương mại Liên bang đã cảnh báo rằng nhân bản giọng nói khiến các trò lừa đảo trở nên đáng tin hơn, bao gồm các mưu đồ mạo danh người thân hoặc giám đốc điều hành để yêu cầu tiền hoặc thông tin; hướng dẫn của họ về nhân bản giọng nói gây hại đáng để đọc. Ngay cả trong lĩnh vực giải trí, hãy tránh sự bắt chước chân thực có thể gây hiểu lầm cho người nghe. Đây là thông tin chung, không phải tư vấn pháp lý; các dự án thương mại liên quan đến một nhân vật hoặc người thể hiện dễ nhận biết nên được xem xét bởi luật sư đủ năng lực hoặc các chủ sở hữu quyền liên quan.
Một khuôn khổ ra quyết định đơn giản giữ cho bạn rõ ràng: chọn một giọng AI có sẵn khi nhân vật là nguyên bản, bạn cần tường thuật nhanh, hoặc bạn đang sản xuất nội dung thường xuyên. Chọn một bản sao giọng nói được ủy quyền khi bạn sở hữu giọng nguồn hoặc có sự cho phép bằng văn bản, cần tường thuật nhất quán qua các tập, và có thể ghi lại các mục đích sử dụng được cho phép. Thuê hoặc cấp phép một người thể hiện thật khi dự án phụ thuộc vào diễn xuất nhân vật dễ nhận biết, khi sắc thái cảm xúc là trung tâm, hoặc khi ranh giới giữa cảm hứng và bắt chước không thể chấp nhận được cho một bản phát hành thương mại.
Trước khi bạn xuất bản, hãy chạy một bộ lọc nhanh: Giọng nói có được trình bày là nguyên bản thay vì chính thức không? Có thể hiểu được mọi từ mà không cần tai nghe không? Các khoảng lặng có tạo ra sự hồi hộp thay vì những chỗ ngắt vụng về không? Nhân vật có nghe ổn định qua các cảnh không? Tên, số, và từ nước ngoài có chính xác không? Giọng nói có to hơn và rõ hơn nhạc không? Người xem có thể nhầm âm thanh với một bản thu chính thức không? Bạn có sự cho phép cho mọi mẫu giọng, bản nhạc, đoạn phim, kịch bản, và tham chiếu nhân vật không? Và nó có vẫn hiệu quả trên di động và các nền tảng dạng ngắn không?
Câu hỏi thường gặp
Ghostface text to speech có miễn phí không?
Một số công cụ cung cấp bản dùng thử miễn phí hoặc tạo giới hạn, nhưng tính sẵn có và quyền sử dụng khác nhau. Chúng tôi cung cấp Text to Speech với các giọng AI có sẵn và chức năng nhân bản giọng nói; hãy kiểm tra các điều khoản tài khoản và tín dụng hiện tại của bạn trước khi sản xuất một dự án thương mại.
Tôi có thể sử dụng giọng AI Ghostface trên YouTube không?
Bạn có thể sử dụng một giọng AI kinh dị nguyên bản lấy cảm hứng miễn là kịch bản, âm thanh, nhạc, và hình ảnh của bạn được cấp phép đúng cách và cách trình bày không ngụ ý sai lệch về sự tham gia chính thức của Scream. Một sự bắt chước dễ nhận biết có thể tạo ra thêm rủi ro về quyền và nền tảng.
DubSmart AI có thể tạo ra giọng Ghostface chính thức không?
Trang Text to Speech công khai của chúng tôi không xác định giọng Ghostface chính thức hay giọng Roger L. Jackson. Hãy sử dụng dịch vụ để tạo một bản tường thuật kinh dị nguyên bản hoặc một bản sao giọng nói được ủy quyền thay vì cho rằng một nhãn "Ghostface" chung chung là chính thức.
Tôi có thể nhân bản giọng của Roger L. Jackson không?
Không được nếu không có sự ủy quyền rõ ràng từ chủ sở hữu quyền liên quan và người thể hiện. Một bản sao chân thực của giọng nói một người có thể làm nảy sinh các vấn đề về quyền công khai và bản sao kỹ thuật số, đặc biệt trong sử dụng thương mại.
Điều gì khiến một giọng nói nghe đáng sợ?
Nhịp độ được kiểm soát, các khoảng lặng có ý nghĩa, nhấn nhá tiết chế, phát âm rõ ràng, và một âm vực phù hợp thường quan trọng hơn việc thay đổi cao độ cực đoan. Một màn thể hiện sạch, dễ hiểu thắng một màn bị méo tiếng nặng nề.