วิธีแปลงวิดีโอเป็นข้อความด้วย AI ในเวลาเพียงไม่กี่นาที
คุณกำลังนั่งอยู่กับการสัมภาษณ์ยาว 45 นาทีที่ต้องมีสูจิบัญชี (transcript) ภายในพรุ่งนี้ ผู้รับเหมาที่คุณเคยใช้ในไตรมาสที่แล้วคิดราคา $90 และใช้เวลา 3 วันในการส่งมอบ ตัวเลือกอื่นของคุณคือทำเอง ซึ่งหมายถึงการใช้เวลาทั้งอันหลังนั่งมองหน้าจออพื่อค้นหาเสียง โดยการไปกลับ 5 วินาทีครั้งละครั้ง และเกลียดทุกนาที มีทางที่สามที่ไม่มีอยู่สำหรับผู้สร้างส่วนใหญ่เมื่อสามปีที่แล้ว: video to text transcription ai ที่แปลงไฟล์เต็มของคุณในเวลาที่ใช้ในการชงกาแฟหม้อ
คู่มือนี้ทำให้เข้าใจว่าเกิดอะไรขึ้นจริงในเครื่องมือเหล่านั้น วิธีเลือกรูปแบบผลลัพธ์ที่ถูกต้องตั้งแต่แรก ขั้นตอนทีละขั้นตอนตั้งแต่ไฟล์ดิบไปจนถึงสูจิบัญชีที่ขัดเงา และเวิร์กโฟลว์ที่เปลี่ยนสูจิบัญชีหนึ่งฉบับให้เป็นช่องทางการจำหน่ายห้าช่องทาง
สารบัญ
- ต้นทุนที่แท้จริงของการแปลงวิดีโอเป็นข้อความด้วยตนเอง (และเหตุผลที่ผู้สร้างส่วนใหญ่ยังทำผิด)
- วิธีการทำงานของเครื่องมือแปลงวิดีโอเป็นข้อความ AI จริงๆ ในปี 2025
- การเลือกรูปแบบผลลัพธ์ที่ถูกต้องก่อนที่คุณกดแปลงเป็นข้อความ
- ขั้นตอนที่ 6 - ตั้งแต่ไฟล์วิดีโอดิบไปจนถึงสูจิบัญชีที่ขัดเงาในเวลาต่ำกว่า 5 นาที
- ความแม่นยำเกี่ยวกับคุณภาพเสียง ไม่ใช่การเลือกเครื่องมือ - นี่คือวิธีการพิสูจน์
- สิ่งที่ต้องทำกับสูจิบัญชีของคุณเมื่อคุณมีมันแล้ว - เวิร์กโฟลว์ห้าอย่างที่มีผลกระทบสูง
- การแปลงเป็นข้อความครั้งแรกของคุณ - รายการตรวจสอบก่อนบิน ระหว่างบิน และหลังบิน
ต้นทุนที่แท้จริงของการแปลงวิดีโอเป็นข้อความด้วยตนเอง (และเหตุผลที่ผู้สร้างส่วนใหญ่ยังทำผิด)
เริ่มต้นด้วยคณิตศาสตร์ของเวลา ผู้แปลงข้อความมนุษย์ที่ได้รับการฝึกอบรมจำเป็นต้องทำงานเฉลี่ย 4–6 ชั่วโมงต่อชั่วโมงของวิดีโอที่เสร็จสิ้น ตามที่บอกโดยผู้ให้บริการแปลงข้อความ SpeakWrite สำหรับผู้สร้างที่ไม่ได้รับการฝึกอบรมในการแปลงข้อความวิดีโอของตนเอง ก้าวที่สมจริงใกล้เคียงกับหกนาทีของงานสำหรับทุกนาทีของวิดีโอ - ซึ่งหมายความว่าการสัมภาษณ์ 45 นาทีจะใช้เวลาทำงานเต็มวัน เมื่อพิจารณาถึงการย้อนกลับ การตรวจสอบข้อเท็จจริง และช่วงเวลาที่หลีกเลี่ยงไม่ได้ของ "รอ เขาเพิ่งพูดอะไร?"
AI บีบอัดการสัมภาษณ์ 45 นาทีเดียวกันเป็น ประมาณ 5 นาทีของเวลาประมวลผล ตามเกณฑ์มาตรฐานที่เผยแพร่โดย TrulyScribe นั่นไม่ใช่การปรับปรุง 10% นั่นไม่ใช่แม้แต่การปรับปรุง 10 เท่า มันเป็นการเปลี่ยนแปลงหมวดหมู่ในวิธีการแปลงข้อความที่เข้าสู่เวิร์กโฟลว์ของคุณ
ตอนนี้รันคณิตศาสตร์ของเงิน การแปลงข้อความอิสระในตลาดสหรัฐฯ ประมาณ $1.50–$3.00 ต่อนาทีเสียง บวกกับการส่งมอบ 24–72 ชั่วโมง การดำเนินการพอดแคสต์รายเดือนที่ผลิตตอน 60 นาทีสี่ตอนที่จุดกึ่งกลางของช่วงนั้นมีค่าใช้จ่ายประมาณ $480 ต่อเดือน ก่อนการเรียกเก็บเงินการแก้ไขใดๆ ช่องสัญญาณ YouTube รายสัปดาห์ที่มีโปรแกรม 30 นาทีจ่ายประมาณ $180–$360 ต่อเดือน ตลอดทั้งปี นั่นคือ $2,000–$5,800 ที่ใช้ไปกับข้อความที่ AI สามารถผลิตได้ในเศษส่วนของเงินดอลลาร์ต่อชั่วโมง
ต้นทุนเงินเป็นปัญหาที่ชัดเจน ต้นทุนที่ซ่อนอยู่นั้นแย่กว่า
เมื่อผู้รับเหมาแปลงข้อความเนื้อหาของคุณ พวกเขาไม่รู้ว่า "Cura Nettis" ควรเป็น "Kubernetes" พวกเขาไม่รู้ว่า CFO ของคุณชื่อ Aoife ไม่ใช่ Eva พวกเขาไม่รู้ว่าผลิตภัณฑ์ของคุณเปิดตัวเป็น "DubKit" และเปลี่ยนชื่อเป็น "DubFlow" เมื่อแปดเดือนที่แล้ว ทุกเทอมที่เฉพาะเจาะจงในโดเมน - ทุกชื่อ ทุกตัวย่อ ทุกชื่อโค้ดภายใน - ต้องใช้ขั้นตอนการแก้ไขในส่วนของคุณต่อไป คุณกำลังจ่าย $90 สำหรับร่างที่ยังต้องใช้สายตาของคุณในทุกบรรทัด
คำถามไม่ใช่ว่าจะแปลงวิดีโอเป็นข้อความหรือไม่ - มันคือว่าคุณสามารถรักษาภาษีเวลา 6 ชั่วโมงได้หรือไม่เมื่อขั้นตอน AI 5 นาทีจะได้รับ 95% ของวิธี
กับดักที่ลึกกว่าคือเวิร์กโฟลว์นั้นเอง ผู้สร้างส่วนใหญ่ชะลอการแปลงข้อความแบบตรวจสอบเนื่องจากดูเหมือนว่าเป็นทางเลือก คำบรรยายสามารถรอได้ หมายเหตุแสดงสามารถรอได้ การใช้ประโยชน์ใหม่จากบล็อกสามารถรอได้ ผลลัพธ์: เก็บถาวรวิดีโอที่ไม่สามารถค้นหาได้ ทีมที่นั่งอยู่บนการบันทึก Zoom 200 ชั่วโมงไม่มีความสามารถในการตอบ "เราเคยพูดเกี่ยวกับการเปลี่ยนแปลงราคา Q3 เมื่อใด" เก็บถาวรนั้นไม่ใช่สินทรัพย์ - มันเป็นสองเท่าที่คุณจะไม่เคยค้นหา
การแปลงข้อความแบบตรวจสอบยังแตกสลายตามโครงสร้างเมื่อผลลัพธ์ของคุณปรับขนาด ผู้สร้างที่เผยแพร่วิดีโอสองรายการต่อสัปดาห์อาจสามารถแปลงข้อความของฉากหนึ่งได้อย่างอับอายในคืนวันอาทิตย์ ทีมที่เผยแพร่วิดีโอยี่สิบรายการต่อเดือนไม่สามารถทำได้ พวกเขาท้อแท้ทั้งหมดและส่งวิดีโอด้วยคำบรรยายอัตโนมัติที่ไม่มีใครตรวจสอบ การค้นหาสูญเสีย การเข้าถึงสูญเสีย การแปลสูญเสีย
การแปลงข้อความ AI ไม่เพียงแต่ทำให้เวลาและต้นทุนเงินลดลง มันเปลี่ยนเวิร์กโฟลว์ที่เป็นไปได้ เมื่อวิดีโอ 30 นาทีกลายเป็นสูจิบัญชีที่มีตราประทับเวลาครบถ้วนในห้านาทีสำหรับต่ำกว่าเงินดอลลาร์ คุณไม่ได้คิดถึงการแปลงข้อความว่าเป็นค่าใช้จ่ายต่อวิดีโอและเริ่มต้นการปฏิบัติต่อว่าเป็นขั้นตอนแรกหลังค่อยเริ่มหลัง คำบรรยายตามมา ร่างบล็อกตามมา การแปลตามมา เก็บถาวรกลายเป็นที่ค้นหาได้ คณิตศาสตร์ไม่ได้ใกล้เคียงกันอีกต่อไป
เดือยนั้นเป็นเรื่องง่าย: การแปลงข้อความ AI ได้เติบโตถึงจุดที่เหตุผลเดียวในการรักษาภาษีเวลาคือความเฉื่อย เวิร์กโฟลว์ video to text transcription ai ที่ส่งออกที่มีความแม่นยำ 95%+ เสียงสะอาด ในห้านาที สำหรับเซนต์ต่อชั่วโมงของวิดีโอ - และให้คุณขัดเงาผลลัพธ์ในอีกสิบนาทีทำให้พ้นเส้นตั้งแต่เครื่องมือที่น่าสนใจไปจนถึงโครงสร้างพื้นฐานเริ่มต้นสำหรับใครก็ตามที่เผยแพร่มากกว่าสองวิดีโอต่อเดือน
ส่วนที่เหลือของคู่มือนี้ถือว่าคุณได้ตัดสินใจแล้วและต้องการใช้ speech to text ให้ดี ไม่ใช่แค่ชี้ที่มันและหวังเท่านั้น
วิธีการทำงานของเครื่องมือแปลงวิดีโอเป็นข้อความ AI จริงๆ ในปี 2025
คุณไม่ต้องอ่านเอกสารวิจัยเพื่อใช้การแปลงข้อความ AI ได้ดี แต่การทำความเข้าใจไปป์ไลน์จะบอกคุณว่าปุ่มไหนมีความสำคัญและข้อร้องเรียนไหนที่เกี่ยวกับเสียง ไม่ใช่อัลกอริทึม
เครื่องมือการแปลงข้อความ AI ที่ทันสมัยเคลื่อนไฟล์ของคุณผ่านห้าขั้นตอนที่แตกต่างกัน:
- การสกัดเสียงและการทำให้เป็นมาตรฐาน ก่อนอื่น ระบบจะแยกแทร็กเสียงออกจากตู้คอนเทนเนอร์ (MP4, MOV, WebM) และทำให้ระดับความดังเป็นมาตรฐานเพื่อให้ส่วนเงียบและดังนั่งอยู่ในระดับเทียบเคียง อินพุตที่สะอาดกว่านี้ยิ่งดีสำหรับทุกสิ่งที่อยู่ด้านล่าง เสียงต่ำกว่า ~65 dB signal-to-noise ratio ต้องการการประมวลผลล่วงหน้าที่หนัก ในขณะที่การแปลงข้อความการออกอากาศระดับวิทยุคาดหวัง ≥85 dB SNR ตามคำแนะนำวิศวกรรม National Association of Broadcasters Engineering Handbook
- การอนุมานการรู้จำเสียง (ASR) โมเดลอะคูสติกประสาทเทียม - โดยทั่วไปแล้วเป็นรูปแบบการแปลง Whisper, NVIDIA Canary หรือเทียบเท่า - แปลงรูปคลื่นเสียงเป็นโฟนีม จากนั้นโฟนีมเป็นคำ Word Error Rate เสียงสตูดิโอนั่งอยู่ที่ 3–5% แต่ปีนขึ้นไปเป็น 15–30% บนการบันทึกสนามรบแบบเสียงดัง ตามเกณฑ์มาตรฐานรวมกลุ่มโดย WhisperBot นี่คือขั้นตอนที่ถูกตำหนิสำหรับการแปลงข้อความ AI แบบ "ไม่ดี" เมื่อปัญหาที่แท้จริงเกือบจะนั่งอยู่ด้านบน
- การระบุภาษาและการสลับโค้ด เครื่องมือสมัยใหม่สามารถตรวจสอบภาษาโดยอัตโนมัติจากการบันทึกครั้งแรก 5–15 วินาทีและสามารถจัดการการสลับโค้ดในประโยคที่อยู่ตรงกลางข้ามภาษาต้นทาง 60+ ภาษา ความแม่นยำลดลง 15–30% บนผู้พูดที่ไม่ใช่เจ้าของภาษาและศัพท์เทคนิค ตามที่ NIST speech recognition evaluations - ซึ่งเป็นเหตุผลที่การตั้งค่าภาษาด้วยตนเองจะชนะการเชื่อถือการตรวจหาโดยอัตโนมัติเมื่อใดก็ตามที่คุณรู้แหล่งที่มา
- ไดการ์ชันลำโพง (ชั้น "ใครพูดอะไร") โมเดลแยกต่างหากจะจัดกลุ่มส่วนเสียงตามตัวตนลำโพง ในสภาพแวดล้อมที่ควบคุมไว้สองลำโพง ความแม่นยำจะลงจอด 78–85% ในการสนทนาตามธรรมชาติที่มีการหมุนเวียนบ่อยครั้งและการพูดพ้องพากย์ มันยุบลง 45–60% ตามเกณฑ์มาตรฐาน NVIDIA Canary-1B ที่อ้างอิงใน Latenode's research video ไดการ์ชันเป็นขั้นตอนที่ไปป์ไลน์ส่วนใหญ่ถือว่าเป็นเรื่องตามลำดับความสำคัญ และเป็นที่ที่เนื้อหาหลายลำโพงมักจะพังทลาย
- การจัดตำแหน่งตราประทับเวลาและการประมวลผลหลัง ทุกคำได้รับตราประทับเวลาระดับมิลลิวินาที ซึ่งเป็นสิ่งที่เปิดใช้งานการแปลงข้อความที่คลิกได้ คำบรรยายที่แม่นยำกรอบ และการค้นหาระดับคำ มาตรฐาน broadcast ระดับมืออาชีพต้องการดริฟต์โทดtimecode ต่ำกว่า 150ms ต่อชั่วโมง ตาม SMPTE และเครื่องมือคุณภาพอยู่ภายในความอดทนนั้นอย่างดี

นี่คือเหตุผลว่าทำไมมันถึงเป็นงาน 5 นาทีแทน 5 ชั่วโมง: การอนุมาน GPU บนเมฆบน A100 และ H100 ประมวลผลเสียงที่ 50–100x real-time speed เหตุผลที่การแปลงข้อความ AI ระดับผู้บริโภคไม่สามารถใช้งานได้ในปี 2018 ไม่ใช่อัลกอริทึมแบบไม่ดี - นักวิจัยมีโมเดลอะคูสติกที่ดีเป็นสิบปีที่แล้ว คอขวดจำเป็นต้องให้ใครก็ตามสามารถเช่า GPU ได้ วันนี้ต้นทุนการคำนวณต่อนาทีสำหรับการอนุมาน ASR คือเศษส่วนของเซ็นต์ ซึ่งเป็นเหตุผลที่แพลตฟอร์มที่ใช้เครดิตสามารถเรียกเก็บเงินในเดือนเดียวต่อชั่วโมงของ video to text conversion และยังดำเนินการอยู่อย่างยั่งยืน ไปป์ไลน์เครื่องมือไม่เปลี่ยนแปลงในระหว่างคืน เศรษฐศาสตร์รอบตัวมันแล้ว และนั่นคือสิ่งที่สุดท้ายผลักดันการแปลงข้อความ AI ไปสู่อาณาเขตเครื่องมือเริ่มต้นสำหรับใครก็ตาม
การเลือกรูปแบบผลลัพธ์ที่ถูกต้องก่อนที่คุณกดแปลงเป็นข้อความ
เลือกรูปแบบผลลัพธ์ก่อนที่คุณอัปโหลด ไม่ใช่หลังจากนั้น การรีรัน ไฟล์ 90 นาทีเนื่องจากคุณส่งออก TXT เมื่อคุณต้องการ SRT คือข้อผิดพลาด 20 นาทีที่ไม่จำเป็นต้องเกิดขึ้น
| รูปแบบ | กรณีการใช้ที่ดีที่สุด | รายละเอียด Timecode | ความยาวบรรทัด | โดยเสียบเข้า |
|---|---|---|---|---|
| ข้อความธรรมดา (TXT) | บล็อกโพสต์ ฐานความรู้ อินพุตการสรุป AI | ไม่มี | ไม่มีขีด จำกัด | Notion, Google Docs, CMS paste |
| SRT (SubRip) | YouTube คำบรรยายวิดีโอโซเชียล | ความแม่นยำของเฟรม HH:MM:SS,ms | 42 ตัวอักษร/บรรทัด สูงสุด 2 บรรทัด | YouTube Studio, Premiere, DaVinci |
| WebVTT (.vtt) | วิดีโอ HTML5 ของเว็บ คำบรรยายที่มีสไตล์ | ความแม่นยำของเฟรม + การจัดแต่งทำนายแบบ CSS | 42 ตัวอักษร/บรรทัดแนะนำ | JW Player, Video.js, web players |
| ข้อความที่มีตราประทับเวลา | โน้ตแสดง Podcast ลิงก์การนำทาง | ต่อย่อหน้า หรือต่อผู้พูด | ไม่มีขีด จำกัด | Podcast hosts, blog embeds |
| JSON | เวิร์กโฟลว์ API การจัดดัชนีการค้นหา แอปพลิเคชันที่กำหนดเอง | ตราประทับเวลาระดับคำ | N/A (โครงสร้าง) | Developer pipelines, databases |
ข้อ จำกัด 42 ตัวอักษรต่อบรรทัด สองบรรทัดต่อเฟรม SRT ไม่ได้เป็นไป โดยพลการ - มันเป็น SubRip specification และเหตุผลที่แพลตฟอร์มปฏิเสธไฟล์ SRT ที่ละเมิดมัน การจัดแต่งทำนายแบบ CSS ของ WebVTT ถูกกำหนดใน W3C WebVTT specification และการจัดรูปแบบข้อความมีกำหนดเวลากว้างมากขึ้นจะอยู่ภายใต้ ISO/IEC 23009-1
ตอนนี้ผลกระทบของการเลือกผิด สามเวิร์กโฟลว์ สามรูปแบบ การตัดสินใจสามประการ:
ผู้สร้าง YouTube ที่ทำการค้นหาในระดับโลกควรส่งออก SRT ก่อน YouTube Studio กินพอสนใจ SRT โดยตรงสำหรับคำบรรยาย และไฟล์ SRT เดียวกันกลายเป็นอินพุตสำหรับการสร้างคำบรรยายแบบแปลและเพื่อเป็นเอกสารแหล่งความเป็นจริงสำหรับการ แปลคำบรรยายและลักษณะลักษณ์เสียงที่ถูกแปล ที่คุณผลิตต่อไป เลือก TXT ที่นี่และคุณจะโยนตราประทับเวลาออก คุณจะแปลข้อความอีกครั้งหรือจัดตำแหน่งใหม่ทีละเสียง
พอดแคสเตอร์ B2B ที่สร้างโน้ตแสดงควรส่งออก ข้อความที่มีตราประทับเวลา ผู้ฟังคลิกตราประทับเวลาเพื่อข้ามไปยังหัวข้อ ตัวสร้างโน้ตแสดง เช่น Descript, Castos และ Podpage แยกวิเคราะห์รูปแบบในตัว SRT จะทำงานทางเทคนิค แต่อักษรแบบ จำกัด ความยาวของเส้นสู้กับจังหวะย่อหน้าธรรมชาติของโน้ตแสดง และคุณจะใช้เวลาลอก bracketed timecodes ออกจากข้อความ
นักพัฒนาที่สร้างเครื่องมือค้นหาวิดีโอควรส่งออก JSON พร้อมตราประทับเวลาระดับคำ ตอนนี้ทุกคำสำคัญในสูจิบัญชีสามารถเชื่อมโยงไปยังมิลลิวินาทีที่แน่นอนในวิดีโอ ผู้ใช้ค้นหา "ประเมินราคากลยุทธ์" และผลลัพธ์กระโดดไปที่เครื่องเล่นที่สอง 1,847 นี่เป็นไปไม่ได้กับเม็ดละเอียด SRT-level ที่ตราประทับเวลาทำเครื่องหมายเฉพาะบล็อกคำบรรยาย ไม่ใช่คำแต่ละคำ
พิจารณาเพิ่มเติมหากเป้าหมายสุดท้ายของคุณคือการเข้าถึงหลายภาษา: ไฟล์ SRT ที่คุณสร้างวันนี้กลายเป็นเอกสารแหล่งความเป็นจริงสำหรับคำบรรยายที่แปลและเสียงพากย์ที่ถูกแปลของพรุ่งนี้ เลือก SRT ตอนนี้หมายความว่าไปป์ไลน์การแปลสถานที่เริ่มต้นเมื่อคุณพร้อม - ไม่ใช่ต่อมา เมื่อคุณต้องย้อนกลับเพื่อสร้างตราประทับเวลาที่คุณข้ามไป
ขั้นตอนที่ 6 - ตั้งแต่ไฟล์วิดีโอดิบไปจนถึงสูจิบัญชีที่ขัดเงาในเวลาต่ำกว่า 5 นาที
นี่คือเส้นทางการคลิก เริ่มต้นจากจบ เวลาที่ผ่านไปทั้งหมดสำหรับวิดีโอ 30 นาที: ประมาณ 15 นาทีรวมถึงขั้นตอนการแก้ไข
ขั้นตอนที่ 1 - เตรียมไฟล์ของคุณ (90 วินาที)
ยืนยันความเข้ากันได้ของรูปแบบก่อน: MP4, MOV, WebM, M4A, WAV และ MP3 ได้รับการสนับสนุนทั่วโลกบนแพลตฟอร์มหลัก เครื่องมือส่วนใหญ่จำเป็นต้องปล่อย ขีดจำกัด 1–2 GB หรือ 4 ชั่วโมงของระยะเวลา แยกวิดีโอที่นานกว่านี้ก่อนที่คุณเริ่ม หากเสียงของคุณมีเสียงดัง - การสัมภาษณ์ที่บันทึกผ่านโทรศัพท์ ไมโครโฟนห้องประชุม วิดีโอกลางแจ้งที่มีลมหรือการจราจร - เรียกใช้มันผ่าน speech separator ก่อนเพื่อแยกเสียงออกจากเสียงพื้นหลัง ขั้นตอนการประมวลผลล่วงหน้าขั้นเดียวนี้สามารถลด Word Error Rate จาก 18% เป็นต่ำกว่า 5% ซึ่งเป็นความแตกต่างระหว่างสูจิบัญชีที่คุณขัดเงาในสิบนาทีและสูจิบัญชีที่ใช้เวลาหนึ่งชั่วโมงในการแก้ไข
ขั้นตอนที่ 2 - อัพโหลดและเลือกภาษา (30 วินาที)
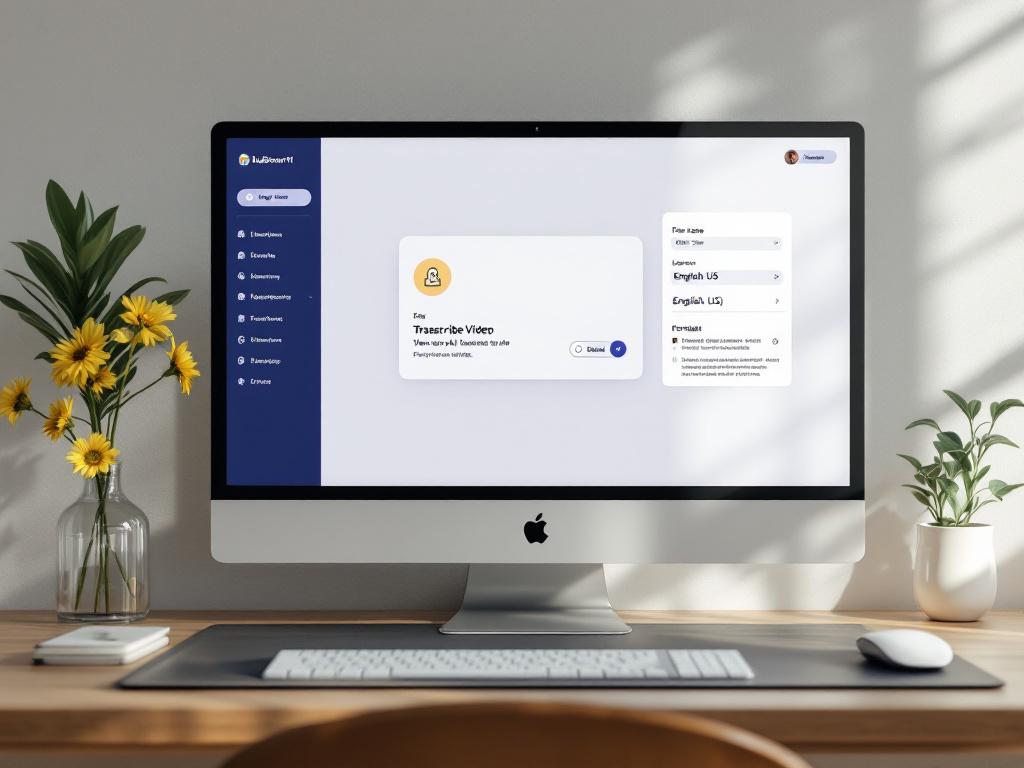
ลากไฟล์ลงในโซนอัพโหลดของแพลตฟอร์ม ตั้งค่าภาษาต้นทางอย่างชัดแจ้งเมื่อคุณรู้ว่า แทนที่จะพึ่งพาการตรวจหาอัตโนมัติ การเลือกด้วยตนเองหลีกเลี่ยงข้อผิดพลาดในการระบุภาษา 10 วินาทีแรกของเสียง - ซึ่งเป็นสถานที่ที่ auto-detect ทำการตัดสินใจ และจึงเป็นสถานที่ที่อินโตร เพลงเรียม และความเงียบมักจะอาศัยอยู่
ขั้นตอนที่ 3 - เลือกรูปแบบผลลัพธ์ของคุณและเริ่มประมวลผล (15 วินาที)
อ้างอิงตารางรูปแบบจากส่วนก่อนหน้า: TXT สำหรับบล็อก SRT สำหรับคำบรรยาย ข้อความที่มีตราประทับเวลาสำหรับพอดแคสต์ JSON สำหรับนักพัฒนา สลับไดการ์ชันลำโพงสำหรับวิดีโอใดๆ ที่มีลำโพงมากกว่าหนึ่งเสียง กดแปลงเป็นข้อความ
ขั้นตอนที่ 4 - ใช้หน้าต่างการประมวลผลได้อย่างมีประสิทธิผล (3–5 นาที)
วิดีโอ 30 นาทีโดยทั่วไปประมวลผลในเวลา 3–5 นาทีบนโครงสร้างพื้นฐานบนเมฆสมัยใหม่ อย่านั่งดูแถบความคืบหน้า ร่างคำอธิบาย YouTube ของคุณ เขียนหัวข้อบล็อกของคุณ คิวลิพวิดีโอถัดไปเพื่ออัพโหลด หรือตอบอีเมล ได้ลาภที่ใหญ่ที่สุดของเวิร์กโฟลว์จากการแปลงข้อความ AI ไม่ใช่การแปลงข้อความเอง - มันว่า คุณสามารถ Multitask ในขณะที่มันเรียกใช้งาน การแปลงข้อความแบบตรวจสอบล็อกความสนใจของคุณเป็นเวลาหลายชั่วโมง การแปลงข้อความ AI จะส่งคืนในเวลาต่ำกว่า 5 นาที
ขั้นตอนที่ 5 - ตรวจสอบการผ่านแรกและแก้ไขข้อผิดพลาดที่คาดการณ์ได้ (8–10 นาที)
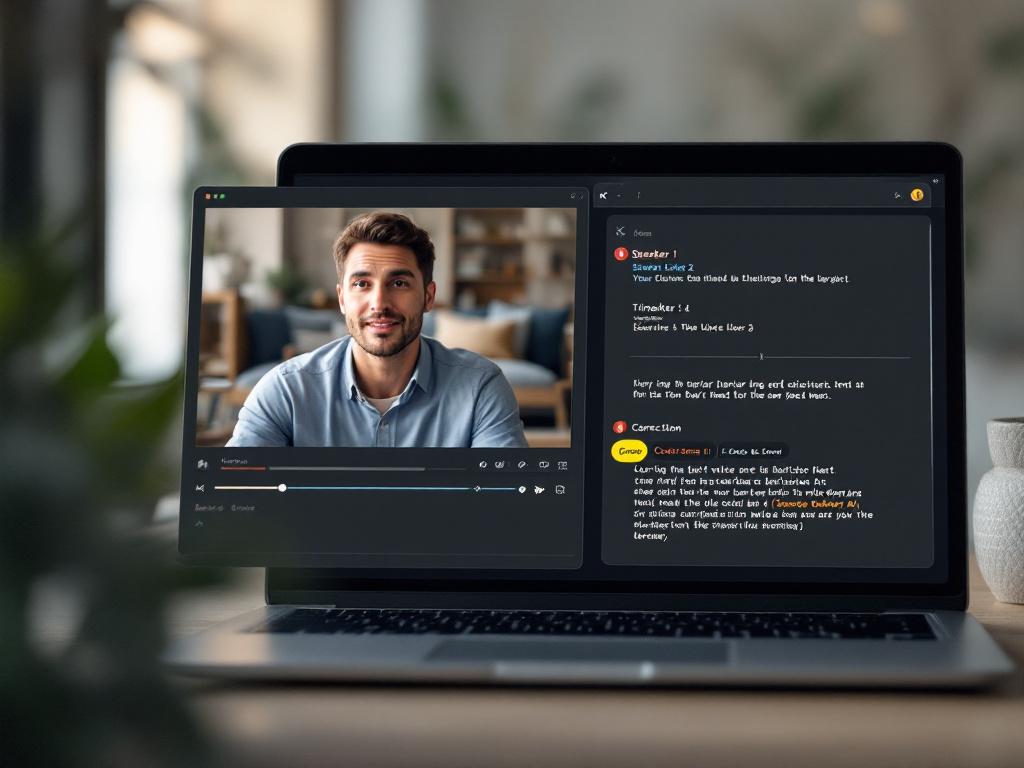
AI โดยทั่วไปจะลงจอดที่ความแม่นยำ 95–99% เสียงสะอาด ตามเกณฑ์มาตรฐานที่เผยแพร่โดย TechSmith แต่ ข้อบกพร่องคลัสเตอร์ที่คาดการณ์ได้:
- ชื่อที่เหมาะสม - นามสกุลผู้เข้าเยี่ยมของคุณ ชื่อผลิตภัณฑ์ของคุณ ชื่อเมืองที่มีการสะกด
- สัญญาศัพท์เทคนิค - Kubernetes, OAuth, FFmpeg สิ่งใดที่เฉพาะเจาะจงในโดเมน
- Homophones - ของพวกเขา/ที่นั่น/พวกเขาเป็น เพื่อ/สอง/เกินไป โดยเฉพาะในการพูดนอกตัวซึ่ง prosody เป็นตัวแยกแยะเพียงอย่างเดียว
- Cross-talk ที่ทับซ้อนกัน - เมื่อผู้พูดสองคนขัดจังหวะกันและ ASR ต้องเดาว่าเสียงไหนจะตามมา
ใช้การค้นหาและแทนที่ของตัวแก้ไขเพื่อแก้ไขข้อผิดพลาดที่เกิดขึ้นซ้ำในการผ่านครั้งเดียวแทนการแก้ไขแต่ละอินสแตนซ์โดยแต่ละอินสแตนซ์ หากชื่อผู้เข้าเยี่ยมของคุณคือ "Siobhan" และสูจิบัญชีเขียน "Shavon" สิบเอ็ดครั้ง นั่นคือการดำเนินการแทนที่หนึ่งครั้ง ไม่ใช่การแก้ไขด้วยตนเองสิบเอ็ดครั้ง ขั้นตอนการแก้ไขแบบเต็มโดยทั่วไปทำงาน 8–12 นาทีต่อชั่วโมงของวิดีโอเสียงสะอาด - เรียก 10 นาทีสำหรับไฟล์ 30 นาที
ขั้นตอนที่ 6 - ส่งออกและเส้นทางเพื่อไปยังเวิร์กโฟลว์ของคุณ
ดาวน์โหลดไฟล์ในรูปแบบที่เลือก อัพโหลด SRT โดยตรงไปยัง YouTube Studio สำหรับคำบรรยายทันที วางลาด TXT ลงในแผน CMS ของคุณเป็นร่างบล็อก ผลักดัน JSON ไปยังดัชนีการค้นหาของคุณหรือสอบส่งผ่าน programmatic TTS workflow สำหรับการประมวลผลแบบแบตช์ สูจิบัญชีเป็นสินทรัพย์ที่มีบ้านถาวรแล้ว - ที่ค้นหาได้ สามารถใช้ประโยชน์ได้ใหม่ สามารถใช้ประโยชน์ได้ - ไม่ใช่ไฟล์ชั่วคราวเน่าโรยในโฟลเดอร์ดาวน์โหลดของคุณ การเลื่อนครั้งเดียวนั้น จาก "transcript as one-off task" ไปยัง "transcript as durable asset" เป็นสิ่งที่ทำให้ video to text transcription ai มีค่าในการรวมเข้าเป็นโครงสร้างพื้นฐานเริ่มต้นแทนการทดลองครั้งเดียว
ความแม่นยำเกี่ยวกับคุณภาพเสียง ไม่ใช่การเลือกเครื่องมือ - นี่คือวิธีการพิสูจน์
ข้อร้องเรียน "เครื่องมือ AI นี้ไม่แม่นยำ" ส่วนใหญ่เป็นข้อร้องเรียน "เสียงของฉันไม่ดี" ที่แต่งตัว การแก้ไขแทบจะไม่เคยสลับเครื่องมือ การแก้ไขคือการแก้ไขเสียง
ข้อร้องเรียนส่วนใหญ่เกี่ยวกับความแม่นยำในการแปลงข้อความ AI คือข้อร้องเรียนเกี่ยวกับคุณภาพเสียงที่สวมชุด
ดร. Jane Chen ผู้อำนวยการวิจัยเทคโนโลยีการพูดที่มหาวิทยาลัย Carnegie Mellon ได้พูดอย่างตัดสินใจใน MIT Technology Review: "ข้อ จำกัด ของการแปลงข้อความ AI ปัจจุบันไม่ใช่เทคโนโลยีเอง แต่ความเข้าใจผิดระหว่างความคาดหวังของผู้ใช้และความจริงของเสียง ข้อร้องเรียนความแม่นยำส่วนใหญ่มาจากเสียงต้นทางที่ไม่ดี ไม่ใช่ข้อบกพร่องในการแปลงข้อความ"
ว่ากันว่า คุณภาพเสียงไม่ใช่ตัวแปรเพียงตัวเดียว มีหลักฐานตอบโต้ที่ยากขึ้นก่อนที่คุณจะสมมติว่าการบันทึกที่สะอาดอย่างแน่นอนรับประกันผลลัพธ์ที่สะอาด การวิจัยจากนักวิทยาศาสตร์ภาษาศาสตร์ Stanford ดร. Lisa Kim (Stanford News, 2024) แสดงว่าการแปลงข้อความ AI อย่างเป็นระบบแสดงข้อบกพร่องสำหรับเสียงสะสมแบบไม่มาตรฐานและภาษาท้องถิ่น - ความหมายว่า หากเนื้อหาของคุณมีลำโพงที่มีสำเนียงภูมิภาค AAVE หรือภาษาอังกฤษที่ไม่ใช่เจ้าของภาษา คุณควรคาดหวังอัตราข้อผิดพลาดที่สูงขึ้นที่ไม่ใช่ความผิดของคุณและไม่สามารถแก้ไขได้โดยเพียงแค่สลับแพลตฟอร์ม ส่วนประกอบค่อนข้างเท่าเทียมกันใน Journal of the American Medical Informatics Association เอกสารแปลงข้อความ AI อย่างเป็นระบบละเว้นหรือแสดงข้อบกพร่องศัพท์เทคนิคทางการแพทย์ที่มีผลกระทบที่อาจเกิดอันตรายในการตั้งค่าหลังคลอด - การเตือนที่ใช้ ในรูปแบบต่ำความเสี่ยง เพื่อหมวดหมู่เนื้อหาเทคนิคหรือ ผู้เชี่ยวชาญใดๆ
การอ้างสิทธิ์ความแม่นยำของผู้ขายตัวเองสมควรสงสัย วิจัย 2023 Federal Trade Commission notice เตือนว่าการอ้างสิทธิ์ "ความแม่นยำ 99%" โดยทั่วไปจะขึ้นอยู่กับเงื่อนไขห้องแล้ - ผู้พูดหนึ่งคน ไมโครโฟนสตูดิโอ ไม่มีเสียงพื้นหลัง คำศัพท์ทั่วไป - และไม่สะท้อนให้เห็นสถานการณ์การใช้งานในโลกแห่งความจริง ดร. Marcus Rodriguez IEEE Senior Member ได้ทำจุดที่เกี่ยวข้องใน IEEE Spectrum เกี่ยวกับไดการ์ชันที่ได้รับการปฏิบัติเป็นเรื่องตามลำดับความสำคัญในไปป์ไลน์ส่วนใหญ่ซึ่งสร้างข้อผิดพลาดแบบ Cascading ในเนื้อหาหลายลำโพงแม้เมื่อ ASR ที่เป็นพื้นฐานนั้นยอดเยี่ยม

ผลข้างเคียงของปฏิบัติการ: คุณสามารถคาดการณ์คุณภาพอพยพของคุณก่อนที่คุณจะต้องอัพโหลด และคุณสามารถแก้ไขส่วนใหญ่ที่เวทีเสียง นี่คือรายการตรวจสอบความแม่นยำก่อนการแปลงข้อความที่มีค่าในการรันบนไฟล์ใดๆ ที่คุณสนใจ
- วัดห้องของคุณก่อนที่คุณจะบันทึก หากคุณสามารถได้ยินเครื่องปรับอากาศ ตู้เย็น หรือเสียงการจราจรบนท้องถนน AI ก็สามารถเช่นกัน มีเป้าหมายสำหรับเสียงรบกวนได้ยินที่ต่ำกว่า 65 dB SNR มาตรฐานการแปลงข้อความระดับวิทยุคาดหวัง ≥85 dB SNR ต่อ NAB