การถอดเสียงที่สะอาดจากพอดแคสต์หรือวิดีโอฝึกอบรมความยาว 30 นาที สามารถทำได้จริงในเวลาไม่ถึง 10 นาทีด้วย DubSmart AI และครีเอเตอร์ส่วนใหญ่จัดการมันได้ในราคาระหว่าง $0 ถึงประมาณ $20–$50 ต่อเดือนขึ้นอยู่กับปริมาณงาน หากคุณอยากรู้วิธีถอดเสียงเป็นข้อความโดยไม่ต้องประกอบแอปถอดเสียง เครื่องมือลดเสียงรบกวน และโปรแกรมแก้ไขคำบรรยายแยกกัน เอนจิน Speech to Text ของเราทำงานทั้งหมดในพื้นที่ทำงานเดียว: อัปโหลดสื่อ สร้างข้อความด้วยความแม่นยำสูงกว่า 95% สำหรับเสียงที่ชัดเจน แก้ไขป้ายกำกับผู้พูดและเครื่องหมายวรรคตอน จากนั้นส่งออกเป็นการถอดเสียงหรือคำบรรยายที่พร้อมเผยแพร่
ข้อได้เปรียบที่แท้จริงที่นี่ไม่ได้มีเพียงความเร็ว เนื่องจากการถอดเสียง การทำความสะอาดเสียง การพากย์เสียง และการบรรยายเสียงใช้แหล่งเครดิตเดียวกัน การถอดเสียงเดียวกันที่คุณสร้างวันนี้สามารถป้อนให้ AI Dubbing เป็น 33 ภาษาเป้าหมาย หรือ Text to Speech ด้วยเสียงกว่า 300 เสียงในภายหลัง สิ่งนี้สำคัญหากคุณดำเนินการช่อง YouTube สร้างคอร์ส e-learning หรือทำโลคัลไลเซชันการฝึกอบรมองค์กร
สารบัญ
สิ่งที่คุณต้องมีก่อนเริ่ม
คุณภาพของการถอดเสียงถูกกำหนดก่อนที่คุณจะกดปุ่มแม้แต่ปุ่มเดียว ตรวจสอบรายการตรวจสอบนี้ก่อน:
- บัญชี DubSmart ที่มีสิทธิ์เข้าถึง Speech to Text และ Speech Separator ในแผน Free, Starter หรือแผนที่สูงกว่า
- ไฟล์ต้นฉบับของคุณที่พร้อมใช้งาน: ตอนพอดแคสต์ เว็บบินาร์ การสัมภาษณ์ หรือลิงก์ YouTube
- สิทธิ์และการอนุญาตในการถอดเสียงเนื้อหา ซึ่งสำคัญที่สุดสำหรับงานของลูกค้าและการบันทึกจากบุคคลที่สาม
- มีผลลัพธ์เป้าหมายที่ชัดเจนในใจ: การถอดเสียงฉบับเต็ม (DOC/TXT), คำบรรยาย (SRT/VTT) หรือสคริปต์สำหรับการพากย์เสียงและการบรรยายเสียง
- ข้อมูลพื้นฐานเกี่ยวกับการบันทึก: ภาษาต้นฉบับ จำนวนผู้พูด และมีดนตรีหรือเสียงรบกวนพื้นหลังหนักหรือไม่
- สำหรับทีมที่อยู่ภายใต้การกำกับดูแล แนวทางภายในของคุณในการจัดการข้อมูลส่วนบุคคลหรือข้อมูลที่ละเอียดอ่อนในเครื่องมือคลาวด์
การรู้รูปแบบผลลัพธ์ของคุณล่วงหน้าช่วยประหยัดการทำงานซ้ำ งานบันทึกย่อของรายการบล็อกต้องการข้อความธรรมดา การอัปโหลด YouTube ต้องการคำบรรยายแบบมีจังหวะเวลา งานโลคัลไลเซชันต้องการสคริปต์ที่สะอาดซึ่งคุณสามารถส่งเข้าสู่การพากย์เสียงได้โดยตรง
ทีละขั้นตอน: ถอดเสียงเป็นข้อความด้วย DubSmart
1. เลือกเครื่องมือที่เหมาะสมสำหรับการบันทึก
Speech to Text แปลงเสียงพูดเป็นข้อความที่เขียน และมันทำงานร่วมกับ Speech Separator สำหรับการบันทึกที่มีเสียงรบกวน เครดิตถูกใช้ร่วมกันระหว่าง AI Dubbing, Text to Speech, Voice Cloning, Speech to Text และ Speech Separator ดังนั้นทุกนาทีที่คุณประมวลผลจะดึงจากแหล่งเดียวกัน
การตัดสินใจนั้นง่าย หากการบันทึกมีดนตรี เสียงฝูงชน หรือเสียงก้องในห้อง เริ่มด้วย Speech Separator เพื่อแยกเสียงพูดออกมา หากเสียงสะอาดอยู่แล้ว ข้ามไปที่การถอดเสียงโดยตรง
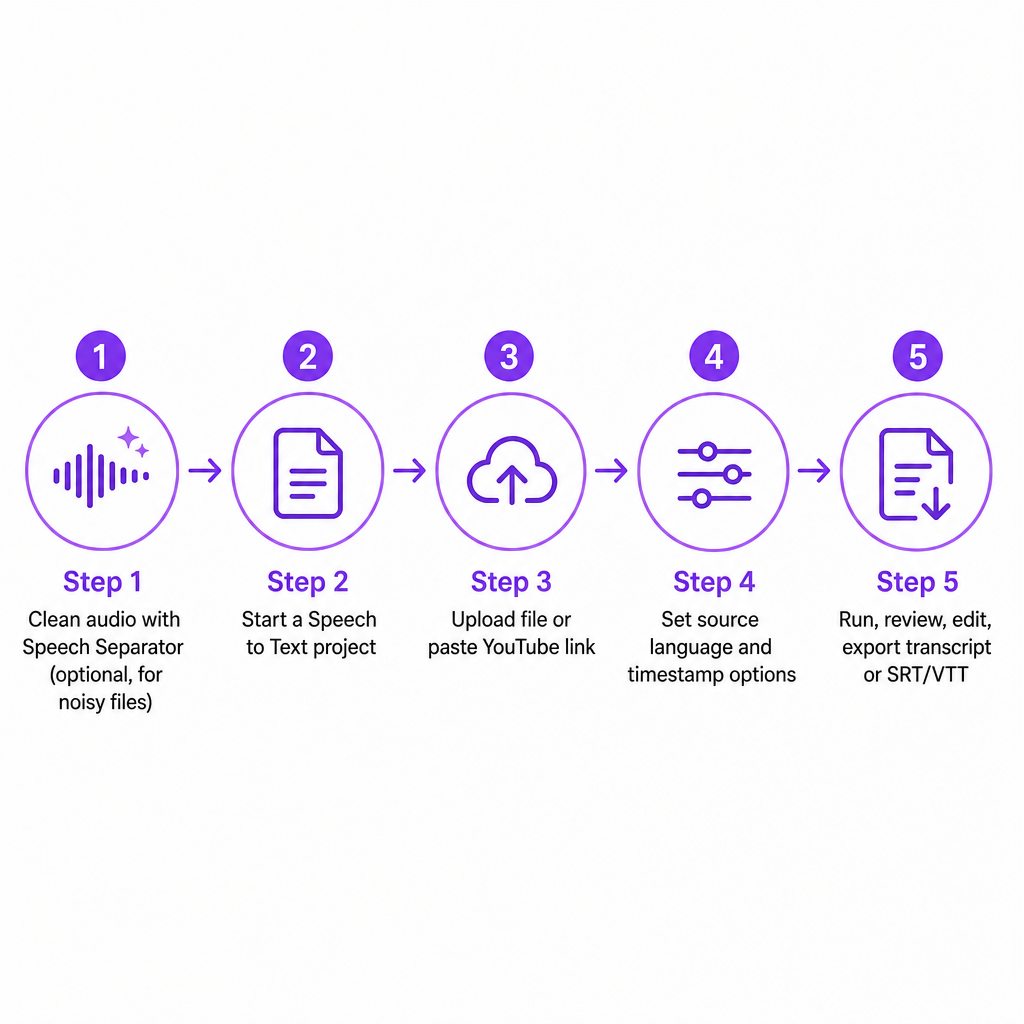
2. ทำความสะอาดเสียงด้วย Speech Separator (แนะนำ)
อินพุตคุณภาพสูงเป็นปัจจัยเดียวที่ใหญ่ที่สุดในการถอดเสียงอัตโนมัติที่แม่นยำ โดยเฉพาะสำหรับพอดแคสต์หลายผู้พูด การสัมภาษณ์ และการเสวนา Speech Separator แยกเสียงพูดออกจากดนตรีและเสียงรบกวนพื้นหลังในรูปแบบทั่วไป เช่น MP3, WAV และ AAC ทิ้งไว้เป็นแทร็กเสียงที่สะอาดขึ้น
- เปิดเครื่องมือ Speech Separator ในบัญชีของคุณ
- อัปโหลดเสียงหรือวิดีโอของคุณจากอุปกรณ์ หรือเลือกจากโปรเจกต์ของคุณ
- ให้ AI แยกเสียงพูดออกจากพื้นหลัง โดยปกติจะเสร็จภายในไม่กี่วินาทีถึงไม่กี่นาทีขึ้นอยู่กับความยาว
- บันทึกไฟล์เสียงที่สะอาดลงในคลังโปรเจกต์ของคุณ
ด้วยแทร็กที่ทำความสะอาดแล้วอยู่ในมือ ขั้นตอนการถอดเสียงจะสร้างข้อผิดพลาดน้อยลงและต้องการการแก้ไขด้วยตนเองน้อยลง
3. เริ่มโปรเจกต์ Speech to Text ใหม่
ขั้นตอนถูกออกแบบให้สั้นโดยเจตนา: เลือกฟีเจอร์ อัปโหลดสื่อ แก้ไข ส่งออก
- เข้าสู่ระบบและเปิดแดชบอร์ดพื้นที่ทำงาน
- เลือก Speech to Text จากรายการเครื่องมือ
- สร้างโปรเจกต์ใหม่และตั้งชื่อที่สื่อความหมาย เช่น "เว็บบินาร์ผลิตภัณฑ์ – ตุลาคม"
การตั้งชื่อโปรเจกต์ช่วยจัดระเบียบการถอดเสียงและทำให้ง่ายต่อการนำกลับมาใช้ซ้ำสำหรับการทำคำบรรยาย การพากย์เสียง หรือ text-to-speech ในภายหลัง
4. อัปโหลดเสียงหรือวิดีโอของคุณ
คุณสามารถอัปโหลดไฟล์โดยตรงหรือดึงจาก URL ของ YouTube ซึ่งสะดวกสำหรับครีเอเตอร์และเอเจนซีที่จัดการช่องของลูกค้า
- อัปโหลดเสียงหรือวิดีโอจากอุปกรณ์ของคุณในรูปแบบมาตรฐาน เช่น MP3, WAV และ MP4
- วาง URL ของ YouTube เพื่อนำวิดีโอเข้าสู่โปรเจกต์โดยตรง รวมถึงการอัปโหลด 1080p ในกรณีที่รองรับ
จากนั้น DubSmart จะวิเคราะห์ไฟล์ สกัดเสียง และเตรียมมันสำหรับการจดจำ
5. ตั้งค่าภาษาและตัวเลือกการจดจำ
Speech to Text รองรับ 60+ ภาษา รวมถึงภาษาอังกฤษ สเปน เยอรมัน ฮินดี ตุรกี โปรตุเกส ญี่ปุ่น รัสเซีย จีน และอาหรับ การตั้งค่าภาษาต้นฉบับที่ถูกต้องไม่ใช่รายละเอียดที่เลือกได้ เอนจินพึ่งพาโมเดลเฉพาะภาษาเพื่อถอดรหัสเสียงพูดเป็นข้อความ
- เลือกภาษาต้นฉบับที่ตรงกับการบันทึก สำหรับเนื้อหาหลายภาษา ให้เริ่มด้วยภาษาที่เด่นที่สุด
- หากมีผู้พูดหลายคน วางแผนที่จะเพิ่มป้ายกำกับผู้พูดระหว่างการแก้ไข
- ยืนยันตัวเลือกการประทับเวลาและการแบ่งส่วนหากคุณตั้งใจจะส่งออกคำบรรยาย SRT หรือ VTT แทนที่จะเป็นการถอดเสียงธรรมดา
สำหรับไฟล์ผู้พูดคนเดียวส่วนใหญ่ การจดจำทำงานที่หรือเร็วกว่าเวลาจริง ดังนั้นการประมวลผลมักเสร็จภายในความยาวของการบันทึก
6. รันการถอดเสียง
เริ่มกระบวนการและให้เอนจินทำงาน มันแบ่งส่วนเสียง ระบุหน่วยเสียงและคำ และใช้โมเดลภาษาเพื่อสร้างข้อความ สำหรับเสียงที่ชัดเจน ความแม่นยำสูงกว่า 95% ซึ่งลดภาระงานการแก้ไขของคุณอย่างมาก ในขณะที่มันทำงาน ให้เตรียมอภิธานศัพท์สั้นๆ ของชื่อ แบรนด์ หรือคำศัพท์ทางเทคนิคที่คุณรู้อยู่แล้วว่าจะต้องทำให้เป็นมาตรฐาน
7. ตรวจสอบและแก้ไขการถอดเสียง
ผลลัพธ์อัตโนมัติรวดเร็ว แต่ข้อความระดับมืออาชีพยังคงต้องการการตรวจสอบจากมนุษย์ โดยเฉพาะสำหรับชื่อ ตัวย่อ และศัพท์เฉพาะ แก้ไขโดยตรงภายในโปรแกรมแก้ไขโปรเจกต์:
- อ่านทวนในขณะที่ฟังส่วนสำคัญเพื่อจับคำที่ได้ยินผิด
- เพิ่มป้ายกำกับผู้พูด เช่น พิธีกร แขกรับเชิญ หรือ ผู้สอน เพื่อให้บทสนทนาติดตามได้ง่าย
- แก้ไขเครื่องหมายวรรคตอนและการใช้ตัวพิมพ์ใหญ่ ซึ่งส่งผลต่อทั้งความอ่านง่ายและจังหวะเวลาของคำบรรยาย
- ทำให้คำศัพท์เป็นมาตรฐาน เช่น ชื่อผลิตภัณฑ์ ศัพท์ทางการแพทย์ หรือวลีทางกฎหมาย เทียบกับอภิธานศัพท์แบรนด์หรือการปฏิบัติตามข้อกำหนดของคุณ
เนื่องจากการถอดเสียงเดียวกันสามารถป้อนให้ AI Dubbing เป็น 33+ ภาษา และ Text to Speech ด้วยเสียงกว่า 300 เสียงในภายหลัง การแก้ไขอย่างรอบคอบในตอนนี้จึงคุ้มค่าทุกครั้งที่คุณนำเนื้อหากลับมาใช้ใหม่
8. ส่งออกข้อความหรือคำบรรยาย
เมื่อการแก้ไขดูถูกต้องแล้ว ส่งออกในรูปแบบที่กรณีการใช้งานของคุณต้องการ:
- คำบรรยาย (SRT หรือ VTT) สำหรับ YouTube, แพลตฟอร์ม LMS และพอร์ทัลวิดีโอองค์กร
- ข้อความธรรมดา (TXT) หรือรูปแบบเอกสารสำหรับบล็อก บันทึกย่อรายการ คู่มือฝึกอบรม และบันทึกการประชุม
เลือกรูปแบบ จากนั้นดาวน์โหลดหรือบันทึกโปรเจกต์ที่เสร็จสมบูรณ์ นี่คือการเสร็จสิ้นขั้นตอนหลักสำหรับวิธีถอดเสียงเป็นข้อความใน DubSmart
เวลาและค่าใช้จ่าย: สิ่งที่ควรคาดหวัง
DubSmart ทำงานบนระบบที่ใช้เครดิตซึ่งใช้ได้ทั่ว AI Dubbing, Text to Speech, Voice Cloning, Speech to Text และ Speech Separator เครดิตสามารถใช้แทนกันได้ ดังนั้นแหล่งเดียวครอบคลุมนาทีการถอดเสียง การทำความสะอาดเสียง และการพากย์เสียง จากราคาที่เผยแพร่ของเรา:
| แผน | ราคารายเดือน | เครดิตรายเดือน | หมายเหตุ |
|---|---|---|---|
| Free | $0 | 2,000 | ประมาณ 2 นาทีของ AI Dubbing/TTS เพื่อทดสอบขั้นตอนการทำงาน |
| Starter | ~$20 | 50,000 | ประมาณ 50 นาทีของ AI Dubbing/TTS; เครดิตที่ไม่ได้ใช้ยกยอดไป |
| Standard | ~$50 | 150,000 | ปริมาณที่สูงขึ้นพร้อมต้นทุนต่อ 1,000 เครดิตที่ต่ำกว่า |
เนื่องจากเครดิตครอบคลุมการถอดเสียง การทำความสะอาดเสียง และการพากย์เสียง คุณสามารถมองไปป์ไลน์ทั้งหมดเป็นงบประมาณเดียวแทนที่จะเป็นเครื่องมือแยกกัน สำหรับครีเอเตอร์ส่วนใหญ่ นั่นหมายถึงการถอดเสียงวิดีโอสั้นหลายสิบรายการต่อเดือนในราคาระดับ Starter ในขณะที่ยังคงมีความจุเครดิตว่างสำหรับการพากย์เสียงและการบรรยายเสียง
ข้อผิดพลาดที่พบบ่อยและวิธีแก้ไข
การใช้เสียงที่มีเสียงรบกวนโดยไม่ทำความสะอาด ดนตรีพื้นหลัง เสียงฝูงชน หรือเสียงก้องทำให้เกิดการจดจำผิดและการแก้ไขเพิ่มเติม รันไฟล์ผ่าน Speech Separator ก่อน จากนั้นถอดเสียงแทร็กเสียงที่แยกออกมาเพื่อความแม่นยำที่สูงขึ้นและจังหวะเวลาคำบรรยายที่สะอาดขึ้น
การเลือกภาษาต้นฉบับผิด หากคุณปล่อยไว้ที่ภาษาอังกฤษในขณะที่เสียงเป็นภาษาสเปน เอนจินจะตีความหน่วยเสียงผิดและสร้างข้อความที่ใช้ไม่ได้ ตรวจสอบภาษาอีกครั้งก่อนเริ่ม และสำหรับวิดีโอหลายภาษา ให้แบ่งส่วนตามภาษาหรือจัดลำดับความสำคัญภาษาหลักสำหรับการผ่านครั้งแรก
การละเลยป้ายกำกับผู้พูด พอดแคสต์และการเสวนาที่มีผู้พูดหลายคนอ่านยากหากไม่มีการระบุที่มา เพิ่มป้ายกำกับ เช่น พิธีกร แขกรับเชิญ 1 หรือแท็กตามชื่อระหว่างการแก้ไข และให้สอดคล้องกันทุกตอน
การข้ามการตรวจสอบโดยมนุษย์สำหรับเนื้อหาที่มีความเสี่ยงสูง สำหรับเนื้อหาด้านกฎหมาย การแพทย์ หรือที่ละเอียดอ่อนต่อการปฏิบัติตามข้อกำหนด ข้อผิดพลาดเล็กน้อยสามารถเปลี่ยนความหมายได้ ให้ถือว่าการถอดเสียงอัตโนมัติเป็นร่างแรกและรันการตรวจสอบโดยมนุษย์อย่างเต็มรูปแบบ จับคู่กับผู้ตรวจสอบภายในหรือการตรวจสอบการปฏิบัติตามข้อกำหนดภายนอกตามความจำเป็น
การประมาณเครดิตผิด การรันแคตตาล็อกย้อนหลังขนาดใหญ่โดยไม่เข้าใจการใช้งานสามารถทำให้โควตาของคุณหมดได้ ตรวจสอบเครดิตรายเดือนและนโยบายการยกยอดของแผนคุณก่อน จากนั้นรันชุดนำร่องขนาดเล็กเพื่อวัดนาทีต่อเครดิตทั่ว Speech Separator และ Speech to Text ก่อนที่คุณจะตัดสินใจทำงานจำนวนมาก
ทำเองเทียบกับความช่วยเหลือจากมืออาชีพ: เส้นแบ่งอยู่ตรงไหน
DubSmart ถูกสร้างขึ้นสำหรับการใช้งานแบบบริการตนเองโดยครีเอเตอร์ ธุรกิจขนาดเล็ก ทีม e-learning และเอเจนซีที่ต้องการเนื้อหาหลายภาษาที่ปรับขนาดได้โดยไม่ต้องสลับไปมาระหว่างผู้ขาย เครื่องมือแบบเบราว์เซอร์ ระดับฟรี และโมเดลเครดิตที่ใช้ร่วมกันทำให้ผู้ใช้ส่วนใหญ่จัดการการถอดเสียง การทำความสะอาด และการพากย์เสียงด้วยตนเอง
บริการตนเองมักเพียงพอเมื่อ:
- คุณถอดเสียงเนื้อหาเป็นตอนๆ เช่น พอดแคสต์ วิดีโอ YouTube การสาธิตผลิตภัณฑ์ หรือการฝึกอบรมภายใน
- เสียงค่อนข้างสะอาดหรือสามารถปรับปรุงได้ด้วย Speech Separator
- ความแม่นยำต้องสูงแต่ไม่มีผลผูกพันทางกฎหมาย เช่น คำบรรยายเพื่อการเข้าถึง สื่อการเรียนการสอน หรือสื่อการตลาด
- ปริมาณรายเดือนของคุณพอดีกับเครดิตที่มีอยู่โดยมีพื้นที่เหลือสำหรับการพากย์เสียงหรือการบรรยายเสียง
เอนไปทางการสนับสนุนระดับมืออาชีพหรือองค์กรเมื่อ:
- คุณจัดการแคตตาล็อกขนาดใหญ่ หลายร้อยชั่วโมง ที่ต้องการ QA สไตล์ และคำศัพท์ที่สอดคล้องกันทั่วทุกภูมิภาค
- เนื้อหาของคุณอยู่ภายใต้มาตรฐานทางกฎหมายหรือการกำกับดูแลที่เข้มงวด เช่น กระบวนการพิจารณาคดี เอกสารทางการแพทย์ หรือการเปิดเผยทางการเงิน
- คุณต้องการรวม AI Dubbing API หรือ Text to Speech API ของเราเข้ากับขั้นตอนการทำงานที่ซับซ้อนพร้อมข้อกำหนดด้านเวลาทำงานและปริมาณงานสำหรับลูกค้า
ในกรณีเหล่านั้น การจับคู่ระบบอัตโนมัติของเรากับการตรวจสอบทางภาษาหรือการปฏิบัติตามข้อกำหนดโดยมืออาชีพให้ความสมดุลที่ดีที่สุดของความเร็ว ค่าใช้จ่าย และความเสี่ยง สำหรับการถอดเสียงในชีวิตประจำวันส่วนใหญ่ เส้นทางบริการตนเองเร็วกว่าและถูกกว่า และมันช่วยให้การถอดเสียงของคุณพร้อมที่จะกลายเป็นคำบรรยาย การพากย์เสียง หรือการบรรยายเสียงเมื่อใดก็ตามที่คุณต้องการ
คำถามที่พบบ่อย
DubSmart สามารถถอดเสียงเนื้อหาประเภทใดได้บ้าง?
Speech to Text จัดการพอดแคสต์ วิดีโอ YouTube เว็บบินาร์ การสัมภาษณ์ ภาพยนตร์ และการฝึกอบรมองค์กร ตราบใดที่เสียงมีให้ผ่านการอัปโหลดหรือลิงก์
ภาษาใดบ้างที่รองรับสำหรับการถอดเสียง?
Speech to Text รองรับ 60+ ภาษา รวมถึงภาษาอังกฤษ สเปน เยอรมัน ฮินดี ตุรกี โปรตุเกส ญี่ปุ่น รัสเซีย จีน และอาหรับ และแพลตฟอร์มเดียวกันพากย์เป็น 33 ภาษาเป้าหมาย
Speech to Text ของ DubSmart แม่นยำแค่ไหน?
สำหรับเสียงที่ชัดเจนพร้อมเลือกภาษาที่ถูกต้อง ความแม่นยำสูงกว่า 95% สอดคล้องกับการจดจำเสียงพูดอัตโนมัติสมัยใหม่
การถอดเสียงด้วย DubSmart มีค่าใช้จ่ายเท่าไหร่?
ราคาเริ่มต้นที่ $0/เดือนพร้อมระดับฟรี 2,000 เครดิต แผนแบบชำระเงิน เช่น Starter (ประมาณ $20/เดือน) และ Standard (ประมาณ $50/เดือน) เพิ่มเครดิตและลดต้นทุนต่อเครดิต และเครดิตถูกใช้ร่วมกันทั่วการถอดเสียง การพากย์เสียง และเครื่องมือที่เกี่ยวข้อง
ฉันสามารถใช้การถอดเสียงสำหรับการพากย์เสียงและการบรรยายเสียงได้หรือไม่?
ได้ ผลลัพธ์ของ Speech to Text สามารถป้อนเข้าสู่ AI Dubbing และ Text to Speech โดยตรงเพื่อสร้างเวอร์ชันพากย์เสียงหลายภาษาและการบรรยายเสียง AI โดยใช้เสียงที่ฟังดูเป็นธรรมชาติกว่า 300 เสียง