เมื่อผู้คนค้นหา ghostface text to speech พวกเขามักต้องการสิ่งเดียว นั่นคือการเปลี่ยนสคริปต์ที่เขียนไว้ให้เป็นเสียงที่มืดมนและข่มขู่ ชวนให้นึกถึงผู้โทรสวมหน้ากากจากภาพยนตร์ชุด Scream สิ่งที่พวกเขาแทบไม่เคยตระหนักก็คือ สิ่งนี้แทบไม่เคยหมายถึงการสร้างเสียงตัวละครอย่างเป็นทางการ ในภาพยนตร์ การแสดงนั้นเป็นของนักพากย์ Roger L. Jackson ที่ถ่ายทอดผ่านอุปกรณ์แปลงเสียงภายในเรื่อง เครื่องมือแปลงข้อความเป็นเสียงทำสิ่งที่แตกต่างออกไป นั่นคือ มันสร้างเสียงพูดใหม่ทั้งหมดจากข้อความของคุณโดยใช้โมเดลเสียงสังเคราะห์หรือที่ได้รับอนุญาต ดังนั้นคำถามที่แท้จริงจึงไม่ใช่ "ฉันจะได้เสียง Ghostface มาได้อย่างไร?" แต่เป็น "ฉันต้องการการแสดงที่มีลิขสิทธิ์ หรือเสียงสยองขวัญต้นฉบับที่มีคุณสมบัติชวนขนลุกเหมือนกัน—เสียงทุ้มต่ำ จังหวะที่ตั้งใจ การหยุดที่เต็มไปด้วยความหมาย และการถ่ายทอดที่ข่มขู่?"
ความแตกต่างนั้นกำหนดทุกตัวเลือกที่ตามมา ตั้งแต่เสียงที่คุณเลือกไปจนถึงสิ่งที่คุณเผยแพร่ได้อย่างถูกกฎหมาย เราจะพาไปดูวิธีการสร้างเสียงจริง ๆ ว่า DubSmart AI เข้ามามีบทบาทตรงไหน และจะทำอย่างไรให้อยู่ในฝั่งที่ถูกต้องของกฎสิทธิ์เกี่ยวกับเสียงในสหรัฐอเมริกา
สารบัญ
ghostface text to speech หมายถึงอะไรกันแน่
โดยพื้นฐานแล้ว ghostface text to speech เป็นกรณีการใช้งานการบรรยายสยองขวัญสำหรับเอนจินเสียง AI อเนกประสงค์ ครีเอเตอร์หยิบมันมาใช้เพื่อพากย์วิดีโอฮาโลวีน เรื่องผีสมมติ ตัวอย่างเกม สเก็ตช์สยองขวัญแนวตลก พอดแคสต์ลุ้นระทึก ตัวละครแอนิเมชัน และหนังสั้นที่มีนักแสดงต้นฉบับ
ระบบแปลงข้อความเป็นเสียงจะอ่านข้อความที่คุณเขียน แปลงคำเป็นข้อมูลการออกเสียงและภาษา คาดการณ์คุณลักษณะของเสียงพูดอย่างจังหวะ ระดับเสียง การเน้น และการหยุด จากนั้นสังเคราะห์คุณลักษณะเหล่านั้นให้เป็นคลื่นเสียง ผลลัพธ์ที่ได้คือการบันทึกเสียงใหม่ที่สร้างจากข้อความ ไม่ใช่บทพูดที่เก็บทีละบรรทัดจากนักแสดงมนุษย์ เครื่องมือ Text to Speech ของเราทำงานในกระบวนการนี้ทุกประการ โดยใช้อัลกอริทึมที่เลียนแบบน้ำเสียงของมนุษย์ในเสียงกว่า 300 แบบ หลายภาษาและสำเนียง พร้อมการควบคุมอัตราการพูด อารมณ์ และการเน้น รวมถึงเสียงที่ดาวน์โหลดได้
ลักษณะที่น่าหวาดกลัวที่คุณต้องการนั้นไม่ใช่ปุ่มกดเดียว มันเกิดขึ้นจากวิธีที่คุณผสมผสานเสียงที่คุณเลือกเข้ากับวิธีที่คุณเขียนและประมวลผลสคริปต์ หากคุณเพิ่งเริ่มต้นกับเทคโนโลยีเบื้องหลัง บทความอธิบายของเราเกี่ยวกับ วิธีการทำงานของ neural text to speech ครอบคลุมกระบวนการอย่างละเอียดมากขึ้น
มันคือเสียง Ghostface จริงหรือไม่?
โดยทั่วไปแล้ว ไม่ใช่—และนั่นสำคัญมากกว่าที่เห็นในตอนแรก "เสียง Ghostface" ที่เครื่องสร้างเสียงออนไลน์นำเสนอมักเป็นหนึ่งในสี่สิ่งนี้ ได้แก่ เสียงสยองขวัญทั่วไปที่สร้างให้ฟังมืดมนและมีมิติแบบละคร พรีเซ็ตเลียนแบบสไตล์ที่มุ่งสื่อถึงจังหวะและทัศนคติของตัวละคร เอฟเฟกต์แปลงเสียงที่ปรับแต่งการบันทึกด้วยการปรับระดับเสียงและการบิดเบือน หรือการจำลองที่ไม่ได้รับอนุญาตซึ่งฝึกมาให้เลียนแบบนักแสดงที่จดจำได้โดยไม่มีการอนุญาตที่ชัดเจน
สิ่งเหล่านี้ไม่สามารถใช้แทนกันได้ ไม่ว่าจะทางกฎหมายหรือทางเทคนิค เสียงที่ได้แรงบันดาลใจจากสยองขวัญต้นฉบับนั้นใช้ได้ดีสำหรับตัวละครที่คุณคิดขึ้นเอง ส่วนการเลียนแบบที่สมจริงของนักแสดงที่รู้จักหรือตัวละครสมมติที่เป็นแบรนด์นั้นดึงเอาคำถามเรื่องสิทธิ์และการอนุญาตเข้ามา ซึ่งไม่เกี่ยวข้องกับว่าเสียงจะฟังดูดีแค่ไหน
หน้า Text to Speech สาธารณะของเรามีรายการเสียงสำเร็จรูปและฟีเจอร์การโคลนเสียง มันไม่ได้มีเสียง Ghostface อย่างเป็นทางการจาก Scream หรือเสียงของ Roger L. Jackson ดังนั้นให้มองหน้าของบุคคลที่สามใด ๆ ที่ติดป้าย "Ghostface" ไว้บนพรีเซ็ตว่าเป็นการตลาด ไม่ใช่หลักฐานการอนุญาต อย่านำเสนอเสียงที่สร้างขึ้นว่าเป็นทางการ ได้รับการรับรอง หรือแสดงโดย Jackson เว้นแต่คุณจะมีการอนุญาตแยกต่างหาก
เสียงที่น่าหวาดกลัวถูกสร้างขึ้นอย่างไร
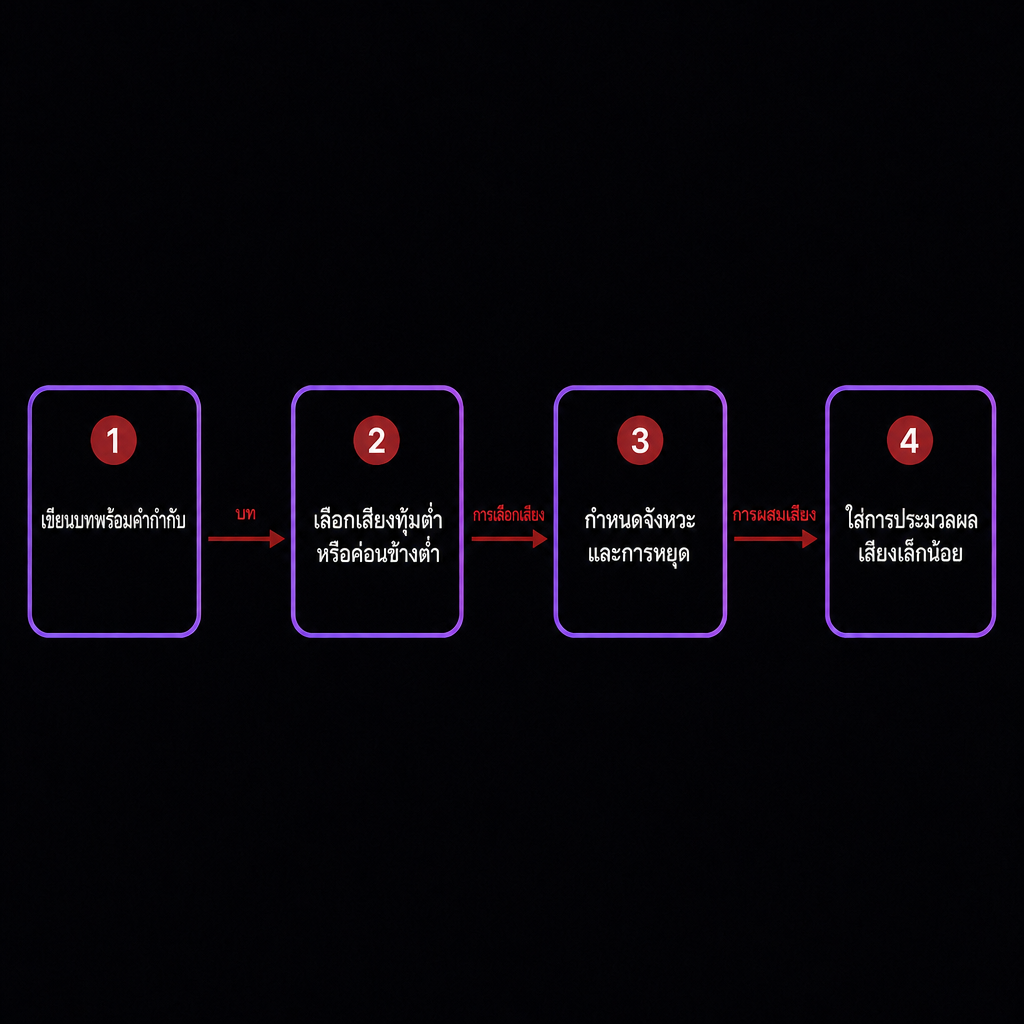
เอฟเฟกต์ที่จดจำได้นั้นมาจากตัวเลือกหลายชั้น ไม่ใช่สไลเดอร์เดียว แต่ละชั้นเป็นคันโยกที่คุณสามารถทดสอบได้อย่างอิสระ
ระดับเสียง ระดับเสียงที่ต่ำลงเพิ่มน้ำหนักและความข่มขู่ แต่การลดลงไปที่การตั้งค่าต่ำสุดที่มีมักให้ผลลัพธ์ที่ไม่เป็นธรรมชาติและบิดเบือน ควรตั้งเป้าให้ลดในระดับปานกลางที่ยังคงทำให้คำเข้าใจได้ชัดเจนทั้งบนลำโพงโทรศัพท์ ลำโพงแล็ปท็อป และหูฟัง
จังหวะที่ควบคุมได้ บทสนทนาสไตล์ Ghostface ให้ความรู้สึกตั้งใจ การถ่ายทอดที่ช้าลงทำให้ผู้ฟังคาดเดาบรรทัดถัดไปได้ และทำให้ประโยคสั้น ๆ กลายเป็นการเผชิญหน้า อัตราการพูดสามารถปรับได้ในเวิร์กโฟลว์ของเรา ซึ่งค่าเริ่มต้น 1.00x สามารถปรับแต่งได้ต่อโปรเจกต์ วิธีที่ชาญฉลาดคือการทำให้ช้าลงเฉพาะบรรทัดที่ข่มขู่ การทำให้ทุกอย่างช้าลงจะทำให้ความตึงเครียดหายไปและฟังดูเทียม
การหยุด ความเงียบสร้างความหวาดกลัวได้มากกว่าการบิดเบือนตลอดเวลา ใส่เครื่องหมายวรรคตอน การขึ้นบรรทัดใหม่ หรือแยกส่วนบทสนทนาในจุดที่ผู้พูดควรลังเล "คุณชอบหนังสยองขวัญไหม?" จะกลายเป็นชวนขนลุกมากขึ้นเป็น "คุณชอบ… หนังสยองขวัญไหม?" การหยุดสั้น ๆ ได้ผลดีที่สุดก่อนชื่อ การเปิดเผย การข่มขู่ หรือคำถาม
การเน้นผ่านการกำกับที่เขียนไว้ เสียงสังเคราะห์ตอบสนองต่อคำสั่งที่ชัดเจนได้ดีกว่าคำสั่งที่คลุมเครือ คุณสามารถใช้แท็กบทสนทนาเช่น "เขาพูดอย่างมีความสุข" หรือ "เขาตะโกนอย่างโกรธเกรี้ยว" เพื่อส่งสัญญาณน้ำเสียงทางอารมณ์ และตัวพิมพ์ใหญ่เพื่อเน้นสระ สำหรับสยองขวัญ ให้อธิบายการถ่ายทอดในสคริปต์เอง:
[เงียบ ควบคุมได้ ข่มขู่] คุณไม่ควรรับสายเลย
อย่าหักห้ามใจที่จะตะโกนด้วยตัวพิมพ์ใหญ่ทั้งหมดในทุกที่ การเน้นที่มากเกินไปอ่านออกมาเป็นการตะโกน ไม่ใช่การข่มขู่
ความยาวของประโยค บรรทัดสั้น ๆ ให้โมเดลมีพื้นที่มากขึ้นในการควบคุมเชิงดราม่า เปรียบเทียบ "ฉันเฝ้าดูคุณมาหลายนาทีแล้ว และฉันรู้แน่ชัดว่าคุณทำอะไรไปเมื่อคืน" กับ:
ฉันเห็นคุณ ฉันรู้ว่าคุณทำอะไรไป
เวอร์ชันที่แยกออกให้เสียงมีโอกาสมากขึ้นในการหยุดและเปลี่ยนความเข้มข้น
การประมวลผลเสียง TTS สร้างเสียง การตัดต่อปั้นความสยองขวัญ หลังจากที่คุณได้เทคที่สะอาดแล้ว ให้เพิ่มเสียงก้องของห้องเล็กน้อย การกรองช่วงความถี่โทรศัพท์ การอิ่มตัวเบา ๆ การบีบอัดที่ควบคุมได้ เสียงบรรยากาศพื้นหลัง และดนตรีหรือเอฟเฟกต์ที่ผสมอย่างระมัดระวัง ใช้สิ่งเหล่านี้ขั้นสุดท้าย การประมวลผลที่หนักตั้งแต่แรกจะซ่อนปัญหาการออกเสียงและกลบคำพูด
เสียงสำเร็จรูป การโคลนเสียง หรือนักพากย์มนุษย์
การแปลงข้อความเป็นเสียงและการโคลนเสียงแก้ปัญหาที่แตกต่างกัน และการเลือกผิดจะสร้างทั้งการแสดงที่อ่อนแอหรือปัญหาเรื่องสิทธิ์ที่ปวดหัว การเปรียบเทียบนี้แสดงถึงข้อแลกเปลี่ยน
| ตัวเลือก | เหมาะสำหรับ | อินพุตหลัก | ความเสี่ยงหลัก |
|---|---|---|---|
| เสียง AI สำเร็จรูป | การบรรยายที่รวดเร็ว ตัวละครต้นฉบับ | ข้อความ | เสียงอาจไม่ตรงกับตัวละครที่ตั้งใจ |
| การโคลนเสียง | การนำอัตลักษณ์ของผู้บรรยายที่ได้รับอนุญาตมาใช้ซ้ำ | ตัวอย่างเสียงที่สะอาดและข้อความ | ข้อกังวลเรื่องความยินยอมและการแอบอ้าง |
| การแปลงเสียง | การแปลงการแสดงที่มีอยู่ | เสียงพูดที่บันทึกไว้ | อาจเลียนแบบคนจริงใกล้เคียงเกินไป |
| นักพากย์มนุษย์ | งานตัวละครที่มีลิขสิทธิ์ การแสดงที่ละเอียดอ่อน | สคริปต์และการกำกับ | ต้นทุนและเวลาการผลิตที่สูงกว่า |
เราแยก Text to Speech และ Voice cloning เป็นเครื่องมือต่างหากด้วยเหตุผลนี้ ผลิตภัณฑ์ Text to Speech ของเรารองรับเสียงสำเร็จรูปและให้คุณโคลนเสียงเพื่อใช้ข้ามภาษา แต่หน้าสาธารณะของเราไม่ได้สร้างสิทธิ์ใด ๆ ในการโคลนคนดัง ตัวละครสมมติ หรือการแสดงที่มีลิขสิทธิ์โดยไม่ได้รับอนุญาต สำหรับตัวละครสยองขวัญที่คิดขึ้นเอง เสียงสำเร็จรูปพร้อมการกำกับที่เขียนไว้อย่างคมชัดมักเป็นเส้นทางที่ปลอดภัยและรวดเร็วกว่า สำหรับผู้บรรยายช่องที่ปรากฏซ้ำ ให้โคลนเสียงของคุณเองหรือใช้นักพากย์ที่ได้ให้การอนุญาตอย่างชัดเจน
การสร้างเสียงสยองขวัญต้นฉบับใน DubSmart AI
เวิร์กโฟลว์ Text to Speech ของเราเปลี่ยนสคริปต์เป็นเสียงที่สร้างขึ้น เปิด Text to Speech ป้อนข้อความของคุณ เลือกผู้พูด สร้างเสียงพูด แก้ไขโปรเจกต์ และดาวน์โหลดผลลัพธ์ สำหรับผลลัพธ์ที่ได้แรงบันดาลใจจาก Ghostface แต่เป็นต้นฉบับ นิสัยไม่กี่อย่างสร้างความแตกต่างระหว่างตัวร้ายที่น่าเชื่อถือกับหุ่นยนต์ที่เห็นได้ชัด
เลือกเสียงตามพฤติกรรม ไม่ใช่ตามชื่อ มองหาเสียงที่สงบมากกว่ามีพลัง ระดับต่ำหรือต่ำปานกลาง ชัดเจนที่ความเร็วช้าลง สามารถถ่ายทอดอารมณ์ได้อย่างควบคุม และเหมาะสมกับอายุและอัตลักษณ์ของตัวละคร หลีกเลี่ยงการเลือกเสียงเพียงเพราะหน้าหนึ่งติดป้ายว่า "Ghostface" ป้ายนั้นมักอธิบายถึงการเลียนแบบ ไม่ใช่การแสดงที่มีลิขสิทธิ์
เขียนการแสดงลงในสคริปต์โดยใช้การกำกับที่สงบ:
[ทุ้มต่ำ สงบ เกือบจะขบขัน] คุณรับสาย [หยุด] นั่นเป็นความผิดพลาด
เป้าหมายคือการชี้นำน้ำเสียงโดยไม่ขอให้ระบบจำลองการถ่ายทอดที่แน่นอนของนักแสดงที่มีชื่อ
แก้ไขการออกเสียงก่อนเพิ่มเอฟเฟกต์ หากชื่อหรือตัวเลขออกมาผิด ให้เขียนใหม่ตามการออกเสียงหรือสะกดออกมา—การเขียนตัวเลขเป็นคำช่วยได้เมื่อระบบออกเสียงผิด สร้างบรรทัดที่ยุ่งยากหลายเวอร์ชัน เทคที่สะอาดและถูกต้องเหนือกว่าเทคที่ผ่านการประมวลผลหนักจนไม่มีใครเข้าใจ
สุดท้าย เปรียบเทียบตัวอย่างทดสอบสั้น ๆ ก่อนตัดสินใจทำตอนเต็ม รันบรรทัดสามบรรทัดเดียวกันผ่านเสียงและอัตราต่าง ๆ ได้แก่ ประโยคกลาง ๆ บรรทัดที่กระซิบหรือเงียบ และการข่มขู่อย่างฉับพลัน เลือกเสียงที่ยังคงน่าเชื่อถือในทั้งสามแบบ เสียงที่ตื่นตาในประโยคเดียวอาจกลายเป็นกลไกเมื่อสคริปต์ยาวขึ้น หากเรื่องราวของคุณเดินทาง AI Dubbing ของเราสามารถนำเสียงเข้าสู่ภาษาอื่นได้—เพียงแค่ตรวจสอบแต่ละภาษา เพราะการแปลเปลี่ยนจังหวะและน้ำหนักทางวัฒนธรรมของการข่มขู่
สิทธิ์เกี่ยวกับเสียงและจริยธรรมในสหรัฐอเมริกา
การเลียนแบบเสียงเกี่ยวข้องมากกว่าลิขสิทธิ์ รายงานของสำนักงานลิขสิทธิ์สหรัฐฯ เกี่ยวกับการจำลองดิจิทัลกล่าวถึงเทคโนโลยีที่จำลองเสียงหรือรูปลักษณ์ของบุคคลอย่างสมจริง โดยระบุว่ากฎหมายลิขสิทธิ์ไม่ได้ลบล้างกฎหมายที่จำกัดการจำลองเสียงที่ไม่ได้รับอนุญาต และอภิปรายเกี่ยวกับสิทธิ์ในการเผยแพร่ โดยเฉพาะเมื่ออัตลักษณ์ของบุคคลถูกใช้เชิงพาณิชย์ คุณสามารถอ่านแหล่งข้อมูลหลักได้ใน รายงานการจำลองดิจิทัลของสำนักงานลิขสิทธิ์
แนวปฏิบัติที่ปลอดภัยที่สุดนั้นตรงไปตรงมา อย่าโคลนเสียงของบุคคลอื่นโดยไม่ได้รับอนุญาต อย่าอธิบายการเลียนแบบว่าเป็นเสียงอย่างเป็นทางการ อย่าใช้เสียงของนักแสดงที่จดจำได้เพื่อขายผลิตภัณฑ์โดยไม่มีการอนุญาต และอย่าใช้เสียงที่สร้างขึ้นเพื่อการฉ้อโกง การคุกคาม การข่มขู่ หรือการหลอกลวง เปิดเผยการมีส่วนร่วมของ AI เมื่อบริบทอาจทำให้ผู้ชมสับสน เก็บบันทึกความยินยอมและการใช้งานที่ได้รับอนุญาตสำหรับตัวอย่างเสียงใด ๆ และตรวจสอบสิทธิ์ที่ติดอยู่กับดนตรี คลิปภาพยนตร์ สคริปต์ และชื่อตัวละครแยกต่างหาก
มีเหตุผลในโลกจริงที่ต้องให้ความสำคัญกับการแอบอ้างอย่างจริงจัง คณะกรรมการการค้าแห่งสหพันธรัฐ (Federal Trade Commission) ได้เตือนว่าการโคลนเสียงทำให้การหลอกลวงน่าเชื่อถือมากขึ้น รวมถึงแผนการที่แอบอ้างเป็นญาติหรือผู้บริหารเพื่อขอเงินหรือข้อมูล คำแนะนำของพวกเขาเกี่ยวกับ การโคลนเสียงที่เป็นอันตราย ควรค่าแก่การอ่าน แม้ในความบันเทิง ก็ควรหลีกเลี่ยงการเลียนแบบที่สมจริงซึ่งอาจทำให้ผู้ฟังเข้าใจผิด นี่คือข้อมูลทั่วไป ไม่ใช่คำแนะนำทางกฎหมาย โปรเจกต์เชิงพาณิชย์ที่เกี่ยวข้องกับตัวละครหรือนักแสดงที่จดจำได้ควรได้รับการตรวจสอบโดยที่ปรึกษาที่มีคุณสมบัติหรือเจ้าของสิทธิ์ที่เกี่ยวข้อง
กรอบการตัดสินใจอย่างง่ายช่วยให้คุณชัดเจน เลือกเสียง AI สำเร็จรูปเมื่อตัวละครเป็นต้นฉบับ คุณต้องการการบรรยายที่รวดเร็ว หรือคุณกำลังผลิตเนื้อหาบ่อยครั้ง เลือกการโคลนเสียงที่ได้รับอนุญาตเมื่อคุณเป็นเจ้าของเสียงต้นทางหรือมีการอนุญาตเป็นลายลักษณ์อักษร ต้องการการบรรยายที่สม่ำเสมอข้ามตอน และสามารถบันทึกการใช้งานที่ได้รับอนุญาตได้ จ้างหรือขอลิขสิทธิ์นักพากย์มนุษย์เมื่อโปรเจกต์ขึ้นอยู่กับการแสดงตัวละครที่จดจำได้ เมื่อความละเอียดอ่อนทางอารมณ์เป็นหัวใจ หรือเมื่อเส้นแบ่งระหว่างแรงบันดาลใจและการเลียนแบบไม่เป็นที่ยอมรับสำหรับการเผยแพร่เชิงพาณิชย์
ก่อนที่คุณจะเผยแพร่ ให้ผ่านด่านตรวจอย่างรวดเร็ว เสียงถูกนำเสนอว่าเป็นต้นฉบับมากกว่าเป็นทางการหรือไม่? ทุกคำสามารถเข้าใจได้โดยไม่ต้องใช้หูฟังหรือไม่? การหยุดสร้างความระทึกแทนที่จะเป็นช่องว่างที่เงอะงะหรือไม่? ตัวละครฟังดูมั่นคงในทุกฉากหรือไม่? ชื่อ ตัวเลข และคำต่างประเทศถูกต้องหรือไม่? เสียงดังและชัดเจนกว่าดนตรีหรือไม่? ผู้ชมอาจเข้าใจผิดว่าเสียงเป็นการบันทึกอย่างเป็นทางการหรือไม่? คุณมีการอนุญาตสำหรับทุกตัวอย่างเสียง แทร็ก คลิป สคริปต์ และการอ้างอิงตัวละครหรือไม่? และมันยังคงใช้ได้ดีบนมือถือและแพลตฟอร์มแบบสั้นหรือไม่?
คำถามที่พบบ่อย
ghostface text to speech ฟรีหรือไม่?
เครื่องมือบางอย่างมีทดลองใช้ฟรีหรือการสร้างที่จำกัด แต่ความพร้อมใช้งานและสิทธิ์การใช้งานแตกต่างกันไป เราให้บริการ Text to Speech พร้อมเสียง AI สำเร็จรูปและฟังก์ชันการโคลนเสียง ตรวจสอบบัญชีปัจจุบันและเงื่อนไขเครดิตของคุณก่อนที่จะผลิตโปรเจกต์เชิงพาณิชย์
ฉันสามารถใช้เสียง AI ของ Ghostface บน YouTube ได้หรือไม่?
คุณสามารถใช้เสียง AI ที่ได้แรงบันดาลใจจากสยองขวัญต้นฉบับได้ตราบใดที่สคริปต์ เสียง ดนตรี และภาพของคุณได้รับการอนุญาตอย่างถูกต้อง และการนำเสนอไม่ได้บ่งบอกอย่างเป็นเท็จว่ามีส่วนเกี่ยวข้องกับ Scream อย่างเป็นทางการ การเลียนแบบที่จดจำได้อาจสร้างสิทธิ์เพิ่มเติมและความเสี่ยงต่อแพลตฟอร์ม
DubSmart AI สามารถสร้างเสียง Ghostface อย่างเป็นทางการได้หรือไม่?
หน้า Text to Speech สาธารณะของเราไม่ได้ระบุเสียง Ghostface อย่างเป็นทางการหรือเสียงของ Roger L. Jackson ใช้บริการนี้เพื่อสร้างการบรรยายสยองขวัญต้นฉบับหรือการโคลนเสียงที่ได้รับอนุญาต แทนที่จะสมมติว่าป้าย "Ghostface" ทั่วไปเป็นของทางการ
ฉันสามารถโคลนเสียงของ Roger L. Jackson ได้หรือไม่?
ไม่ได้ หากไม่มีการอนุญาตอย่างชัดแจ้งจากเจ้าของสิทธิ์และนักพากย์ที่เกี่ยวข้อง การจำลองเสียงของบุคคลอย่างสมจริงอาจก่อให้เกิดปัญหาสิทธิ์ในการเผยแพร่และการจำลองดิจิทัล โดยเฉพาะในการใช้งานเชิงพาณิชย์
อะไรทำให้เสียงฟังดูน่ากลัว?
จังหวะที่ควบคุมได้ การหยุดที่มีความหมาย การเน้นที่สงบ การออกเสียงที่ชัดเจน และระดับเสียงที่เหมาะสมมักสำคัญมากกว่าการปรับระดับเสียงอย่างสุดโต่ง การแสดงที่สะอาดและเข้าใจได้เหนือกว่าการแสดงที่บิดเบือนอย่างหนัก