Transformar um roteiro em narração para o YouTube costumava significar microfone, uma sala silenciosa e muitas regravações. Agora, o texto para fala do YouTube permite que você cole um roteiro, escolha uma voz e exporte uma narração que pode ser colocada em um vídeo, um Short, um tutorial ou uma versão traduzida de um upload que você já publicou. A decisão real não é se deve usar uma voz sintética ou não. É sobre qual método de produção se encaixa no vídeo específico à sua frente: uma voz de IA pronta, um clone personalizado, uma gravação humana ou alguma mistura dos três.
Este guia explica como a tecnologia realmente funciona, qual fluxo de trabalho atende a diferentes objetivos de canal e o que verificar sobre direitos e divulgação antes de publicar. É o ponto central do nosso conjunto mais amplo de explicações sobre fala e transcrição, então você encontrará links para análises mais profundas quando um único tópico merecer sua própria página.
Índice
O que realmente significa texto para fala do YouTube
Texto para fala do YouTube é simplesmente usar a tecnologia de texto para fala para gerar narração para conteúdo do YouTube. Você fornece um roteiro, escolhe uma voz e um idioma, ajusta como deve ser entregue e exporta um arquivo de áudio para editar ou fazer upload. Nos bastidores, um sistema de TTS converte texto, ou Speech Synthesis Markup Language (SSML), em dados de áudio como MP3 ou áudio compatível com WAV que você pode adicionar a vídeos e outras mídias.
Duas distinções esclarecem a maior parte da confusão. As legendas fazem o trabalho oposto ao do TTS: as legendas transformam áudio falado em texto, enquanto o texto para fala transforma texto escrito em áudio falado. A dublagem é ainda mais ampla. O TTS geralmente começa a partir de um roteiro escrito e produz uma nova faixa de voz, enquanto a dublagem geralmente traduz um vídeo existente e combina a fala substituta ao timing e significado originais. Se esses limites importam para o seu fluxo de trabalho, nossa explicação sobre quais idiomas a IA pode dublar cobre o lado da localização em detalhes.
Como o pipeline de síntese transforma um roteiro em uma voz
Um sistema de TTS combina quatro ingredientes: seu roteiro, um modelo de voz selecionado, informações de idioma e controles de entrega. A partir deles, ele passa por uma sequência curta que explica por que a mesma frase pode soar ótima ou estranha dependendo de como você a escreveu.
Primeiro vem a entrada de texto, que pode ser um roteiro completo do YouTube, um esboço expandido em narração, uma versão traduzida de um roteiro existente ou legendas reformuladas em locução. A qualidade da entrada determina a qualidade da saída. Frases longas, abreviações não explicadas, nomes incomuns e pontuação bagunçada podem fazer uma voz competente soar estranha. A solução é escrever para a escuta em vez da leitura silenciosa: frases mais curtas, transições claras, pausas deliberadas.
Em seguida, o motor analisa o texto para decidir como as palavras devem ser pronunciadas e agrupadas. Ele lê os limites das frases, pontuação e pausas, números e datas, abreviações, nomes e pistas de pronúncia regional. É por isso que a pontuação muda a entrega. Adicione uma vírgula, reescreva um número por extenso ou soletre uma sigla, e a voz responde.
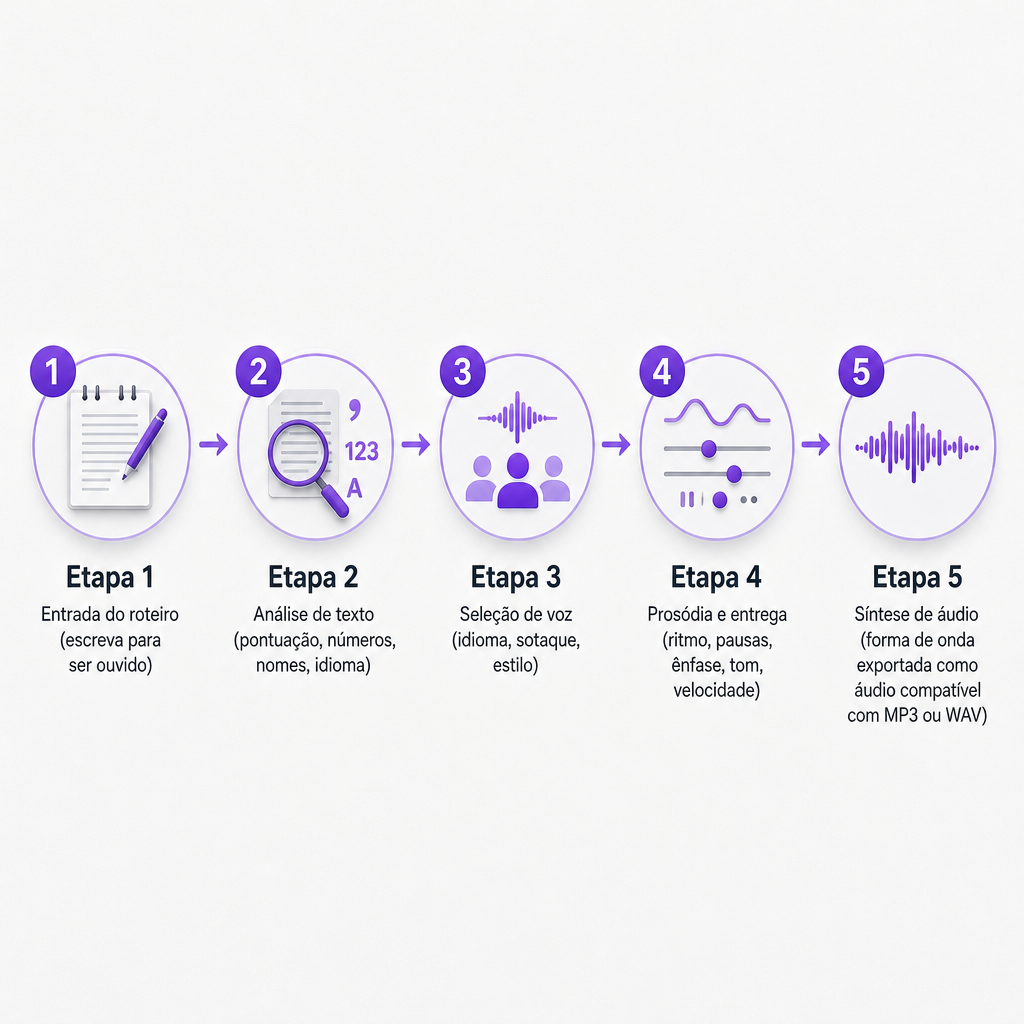
Depois você escolhe uma voz. As vozes diferem por idioma, sotaque, idade ou caráter vocal, apresentação de gênero, estilo de fala, energia e formalidade. As configurações de saída geralmente incluem velocidade de fala, tom, volume e taxa de amostragem. Para um canal, a consistência geralmente supera o drama. Uma voz reconhecível mantida ao longo dos vídeos faz o canal parecer coerente, o que importa mais do que escolher a opção mais teatral para um único upload.
O motor então gera a prosódia, o ritmo, as pausas, a ênfase, o movimento de tom e a entonação que separam a fala expressiva de palavras espaçadas uniformemente. Algumas ferramentas expõem esses controles diretamente; outras os inferem a partir da pontuação, estrutura da frase ou instruções de estilo. É aqui que surgem a maioria das falhas de qualidade. Uma voz pode pronunciar cada palavra corretamente e ainda parecer errada se o ritmo ou o tom emocional não combinarem com o vídeo.
Por fim, o modelo sintetiza o áudio, transformando o texto analisado em uma forma de onda que o serviço retorna como um arquivo para download. Um fluxo de trabalho com API pode devolver dados de áudio codificados que você decodifica em um arquivo reproduzível, enquanto as ferramentas hospedadas para criadores lidam com essa etapa para você. Mesmo assim, a narração não é um vídeo finalizado. Você ainda a coloca na linha do tempo, corta o ar morto, adiciona música e efeitos, combina com os visuais, equilibra os níveis, adiciona legendas e revisa a pronúncia e o timing. Para um vídeo explicativo, a voz deve seguir a sequência visual; uma faixa tecnicamente limpa ainda parece desleixada se as imagens mudarem antes de a frase correspondente começar. Se você quiser o panorama neural completo, nossa análise sobre como funciona o texto para fala neural aprofunda nos detalhes internos do modelo.
Quatro caminhos de produção e quando cada um vence
A maioria das narrações para o YouTube se resume a quatro opções, e a certa depende do que o vídeo precisa, em vez de qual soa mais avançada em uma prévia.
| Caminho | Melhor para | Principal compensação |
|---|---|---|
| Voz de IA padrão | Canais sem rosto, vídeos explicativos, tutoriais, resumos no estilo notícias, Shorts | Rápido e confiável, mas não vinculado a uma pessoa específica |
| Clone de voz personalizado | Manter uma identidade reconhecível em muitos vídeos | Requer uma voz que você esteja autorizado a reproduzir |
| TTS multilíngue ou dublagem | Vídeos explicativos traduzidos, vídeos de produto localizados, testes de novos mercados | Precisa de revisão de pronúncia e cultural por idioma |
| Locução humana | Atuação cheia de nuances, depoimentos, texto sensível ou crítico para a marca | Mais lento e difícil de escalar |
Uma voz padrão retirada da biblioteca de um provedor é o caminho mais rápido para conteúdo de alto volume, quando você não precisa que a narração soe como uma pessoa específica. A clonagem de voz personalizada constrói uma voz sintética a partir de uma amostra de áudio, o que ajuda um criador a manter uma identidade consistente sem gravar cada roteiro manualmente. Use a clonagem apenas com permissão e uma voz que você tenha o direito de reproduzir; um clone não é um atalho para possuir a identidade ou o desempenho de alguém. Nossa ferramenta de Texto para Fala dá acesso a vozes de IA e fluxos de clonagem, e nossa página de Clonagem de Voz é o lugar para começar quando você quer um narrador personalizado reutilizável em vez de um pronto.
A narração multilíngue permite traduzir um roteiro e sintetizar uma nova faixa de voz em outro idioma, o que é útil para expandir um canal educacional no exterior, localizar vídeos de produto ou testar a demanda em um novo mercado. O TTS começa com texto; nosso fluxo de trabalho de Dublagem com IA adiciona a camada de localização mais ampla, incluindo tradução e áudio substituto para um vídeo existente em 33 idiomas. Um narrador humano ainda vence quando o vídeo depende de atuação cheia de nuances, depoimento pessoal, assuntos sensíveis, humor complexo, texto jurídico ou crítico para a marca, ou da interpretação de um intérprete distinto. Muitos canais adotam um modelo híbrido: narração de IA para rascunhos, versões e uploads de alto volume, e voz humana para vídeos principais.
Quando o texto para fala conquista seu lugar em um canal
O TTS do YouTube compensa mais quando seu gargalo é a gravação, não a escrita. Se escrever o roteiro é fácil, mas agendar uma sessão de gravação é a parte lenta, a narração sintética elimina a etapa mais demorada.
Vídeos educacionais e instrucionais se beneficiam diretamente. Atualize um roteiro e regenere apenas a seção afetada em vez de organizar uma nova gravação, o que serve para tutoriais de software, integração e conteúdo de cursos que mudam com frequência. Canais sem rosto podem narrar vídeos construídos a partir de gravações de tela, imagens de banco, animação, slides ou visuais gerados, embora a voz ainda precise de direção editorial; áudio colocado sobre imagens não relacionadas corrói a confiança do espectador. Os Shorts ganham com o processamento rápido de roteiro para áudio, permitindo testar múltiplos ganchos ou variações de público, desde que a voz não soe apressada ou repetitiva.
A acessibilidade é outro uso legítimo. Uma versão falada de conteúdo escrito ajuda espectadores que preferem áudio ou têm dificuldade com texto na tela, mas a narração deve complementar legendas precisas e um design visual claro, em vez de substituí-los. E para expansão multilíngue, você pode produzir faixas de voz traduzidas sem executar um processo de produção separado por idioma. O recurso de Áudio em vários idiomas do YouTube permite que criadores elegíveis anexem faixas de áudio adicionais a um único vídeo ou Short, em vez de gerenciar um canal separado para cada mercado.
Escolhendo e testando uma voz antes de se comprometer
Avalie uma voz em relação aos requisitos reais do vídeo, não a uma prévia lisonjeira de dez segundos. Uma voz que acerta uma linha pode desmoronar ao longo de um roteiro completo, então teste-a sob pressão primeiro.
- Combine a voz com o formato. Uma entrega calma combina com um documentário ou tutorial; uma voz mais energética combina com um gancho de formato curto ou anúncio. Deixe o assunto, o ritmo e o público decidirem.
- Teste palavras difíceis. Antes de gerar um vídeo completo, teste seus nomes de marca recorrentes, nomes de lugares, siglas, termos científicos, palavras estrangeiras, unidades e nomes de pessoas. Uma voz que lida com frases comuns pode tropeçar no vocabulário do seu canal.
- Verifique a consistência em formato longo. Gere uma amostra mais longa e preste atenção a entonação repetitiva, pausas incorretas, ritmo não natural, mudanças de pronúncia e transições abruptas entre parágrafos.
- Considere o público regional. A narração em inglês pode precisar de pronúncia americana, britânica, australiana ou outra. Para outros idiomas, confirme que a voz soa natural para um ouvido nativo, não apenas que a ferramenta lista o idioma.
- Revise os direitos de uso. Antes de monetizar ou anunciar, leia os termos do provedor e confirme que a voz e a saída estão liberadas para conteúdo comercial no YouTube, trabalhos para clientes, anúncios pagos e versões derivadas.
Alguns hábitos de escrita também elevam a qualidade rapidamente. Escreva para a fala trocando prosa densa por frases conversacionais e usando a pontuação para guiar as pausas sem depender dela para a emoção. Soletre termos ambíguos para que o motor os leia corretamente, testando variantes como "AI" versus "A.I." ou "2026" versus "dois mil e vinte e seis". Gere em seções em vez de um arquivo gigante único para que você possa regenerar um único erro, reordenar cenas e combinar o áudio aos visuais. Depois adicione edição humana: assista ao vídeo completo com a faixa tocando, corte pausas estranhas, ajuste o timing e abaixe a música sob a fala. A IA reduz o tempo de gravação; ela não elimina a revisão editorial.
Direitos, divulgação e upload de uma faixa de segundo idioma
A parte que os criadores mais frequentemente pulam também é a parte que faz os vídeos serem removidos. Se você criar uma versão em idioma separado, pode publicá-la como um novo vídeo ou usar o recurso de Áudio em vários idiomas do YouTube onde disponível, mas a plataforma não cria essas faixas dubladas para você. Os criadores devem preparar e fazer upload de seus próprios arquivos de áudio em um formato somente áudio compatível, com aproximadamente a mesma duração do vídeo. O YouTube também pode remover um arquivo de áudio secundário se seu conteúdo protegido por direitos autorais diferir do original, o que torna essencial a revisão de direitos quando sua faixa dublada inclui música, clipes ou outro material protegido.
A divulgação é uma obrigação separada. O YouTube exige que os criadores divulguem conteúdo gerado ou alterado por IA que pareça realista, incluindo conteúdo que faça uma pessoa real parecer dizer ou fazer algo que não disse ou fez, altere imagens de um evento ou lugar real, ou fabrique uma cena realista. Notavelmente, o YouTube lista a clonagem da sua própria voz para locuções ou dublagens entre os exemplos que não exigem divulgação sob essa política específica. Isso não é uma licença para clonar a voz de outra pessoa, e rotular conteúdo sintético não autoriza o uso do rosto ou da voz de outra pessoa sem permissão.
Uma política editorial segura é usar sua própria voz ou uma licenciada, manter registros de permissão para quaisquer amostras de voz personalizadas, evitar imitar uma pessoa real sem autorização, verificar os termos de uso comercial, divulgar conteúdo sintético ou alterado realista quando o YouTube exigir, e revisar separadamente os direitos de música, imagens e áudio traduzido. Para equipes que geram narração repetidamente a partir de um sistema de conteúdo ou aplicativo, nossa API de Texto para Fala foi construída para geração programática de fala, para que você possa produzir faixas em volume sem reconstruir o fluxo de trabalho a cada vez.
Então, o texto para fala do YouTube vale a pena? É uma boa escolha quando você precisa de narração repetível, revisões rápidas, versões multilíngues ou uma locução sem equipamento de gravação. É uma escolha mais fraca quando o sucesso do vídeo depende de atuação cheia de nuances, depoimento pessoal ou de uma performance juridicamente sensível. O padrão que importa não é se os espectadores conseguem perceber que uma voz é sintética. É se a narração é clara, apropriada, consistente, legalmente utilizável e bem integrada ao vídeo.
Perguntas frequentes
Posso usar áudio de texto para fala no YouTube?
Sim. Você pode usar narração gerada em um vídeo do YouTube desde que respeite os termos de licenciamento do provedor de TTS, as políticas do YouTube e os direitos vinculados ao seu roteiro, música, imagens e voz.
O YouTube transforma automaticamente um roteiro em narração?
Não. O recurso de Áudio em vários idiomas do YouTube não cria suas faixas dubladas para você. Os criadores devem preparar e fazer upload de seus próprios arquivos de áudio.
Qual é a diferença entre o texto para fala do YouTube e a dublagem automática?
O texto para fala converte texto escrito em áudio falado. A dublagem automática é um processo de localização mais amplo que pode traduzir e gerar uma faixa de idioma substituto para conteúdo existente. Os recursos exatos dependem da plataforma e do fluxo de trabalho.
Posso clonar minha voz para vídeos do YouTube?
Você pode usar um clone de voz quando detém o direito de criá-lo e usá-lo. O YouTube lista a clonagem da sua própria voz para locuções ou dublagens como um exemplo que não exige divulgação sob sua política de conteúdo realista, embora outro conteúdo gerado ou alterado por IA ainda possa exigir divulgação.
Qual arquivo de áudio devo fazer upload para um segundo idioma?
Para o recurso de Áudio em vários idiomas do YouTube, o arquivo deve estar em um formato somente áudio compatível e com aproximadamente a mesma duração do vídeo. Verifique a interface atual de upload do YouTube Studio antes de exportar.