Pergunte como funciona a conversão neural de texto em fala e a resposta curta é esta: ela converte texto escrito em áudio realista, passando o seu roteiro por redes neurais profundas que modelam como os humanos realmente falam—pronúncia, ritmo e entonação em conjunto. Em vez de costurar fragmentos pré-gravados como faziam os sistemas mais antigos, o TTS neural gera a fala do zero, aprendendo padrões diretamente de grandes conjuntos de dados de gravações humanas reais associadas a texto. Essa distinção é o motivo pelo qual as vozes sintéticas modernas soam como um narrador que você poderia ouvir durante um vídeo inteiro, em vez de um anúncio robótico. Na DubSmart AI, construímos sobre essa mesma abordagem neural para alimentar nosso Texto em Fala, conectando-o à clonagem de voz e à dublagem para que um único roteiro possa viajar de um idioma para muitos.
Este guia percorre o mecanismo etapa por etapa, depois o traduz em decisões práticas: onde uma voz neural é forte o suficiente para se sustentar sozinha, onde você ainda quer uma performance humana e como as peças se encaixam dentro da nossa plataforma.
Índice
O que "como funciona a conversão neural de texto em fala" realmente significa
A conversão neural de texto em fala é uma forma de síntese de fala que usa redes neurais profundas para gerar fala do zero. A principal ruptura em relação aos métodos baseados em regras ou concatenativos é que o sistema aprende com grandes conjuntos de dados de gravações humanas associadas a texto, então ele consegue prever tanto como as palavras devem soar quanto como uma pessoa as pronunciaria naturalmente. Esse comportamento aprendido é o que captura a prosódia—ênfase, ritmo, pausas e tom emocional—tornando a voz resultante confortável ao longo de sessões de escuta prolongadas. Os principais provedores de nuvem descrevem essas vozes neurais como fala sintetizada de aparência humana cuja articulação reduz a fadiga auditiva em assistentes, ferramentas de acessibilidade e experiências de leitura em voz alta.
Nosso mecanismo de Texto em Fala segue esse caminho neural. Ele analisa seu roteiro, divide-o em fonemas, infere ritmo e entonação, e então usa modelos neurais para renderizar áudio fluido em vez da entrega monótona associada ao TTS legado. O resultado é uma fala realista gerada a partir de texto em segundos, extraída de uma biblioteca de mais de 300 vozes adaptadas a diferentes tons e casos de uso.
Por que o TTS neural importa para criadores e equipes
Para criadores do YouTube, pequenas empresas, produtores de e-learning, cineastas, podcasters e desenvolvedores, a verdadeira questão não é apenas como a tecnologia funciona, mas se devem apoiar-se nela em um pipeline de produção. O TTS neural importa porque tira as vozes sintéticas do território "utilitário"—instruções de GPS, avisos básicos—e as leva ao território de intérprete: boas o suficiente para conteúdo de primeira linha, narrar cursos completos e transmitir mensagens de marca sem soar obviamente artificiais. Combine-o com tradução e dublagem e ele se torna um multiplicador, permitindo que um único roteiro alcance dezenas de idiomas por uma fração do custo e do tempo do trabalho tradicional de estúdio.
Projetamos a DubSmart exatamente em torno dessa decisão. Texto em Fala, Clonagem de Voz, Dublagem por IA, Fala em Texto, Separador de Fala, Texto em Imagem e Imagem em Vídeo estão em um único pipeline, então o conteúdo falado vai do upload à exportação multilíngue sem malabarismos com ferramentas separadas. Você escolhe quanto automatizar e quanto personalizar em cada etapa—roteiro, voz, idioma, mixagem—dentro de um único ambiente.
Onde isso se aplica depende do que você produz:
- Expandindo um canal do YouTube para novos idiomas: o TTS neural mais a dublagem permitem que você reutilize roteiros e sincronização enquanto substitui por vozes localizadas.
- Localizando vídeos de marketing ou treinamento: você obtém narração de marca consistente entre idiomas sem contratar dubladores para cada atualização.
- Produzindo e-learning ou treinamento corporativo: a narração de formato longo se torna escalável e fácil de revisar quando o conteúdo muda.
- Rodando um podcast ou filme independente: você pode criar versões multilíngues, inserções de narração ou faixas de acessibilidade.
- Construindo aplicações: nossas APIs transformam a fala neural em um serviço acessível para URAs, agentes e ferramentas de conteúdo.
Entender o mecanismo ajuda você a avaliar onde uma voz neural pode se sustentar sozinha e onde uma gravação humana deve permanecer como fonte para clonagem ou dublagem.
Por dentro: o pipeline do TTS neural
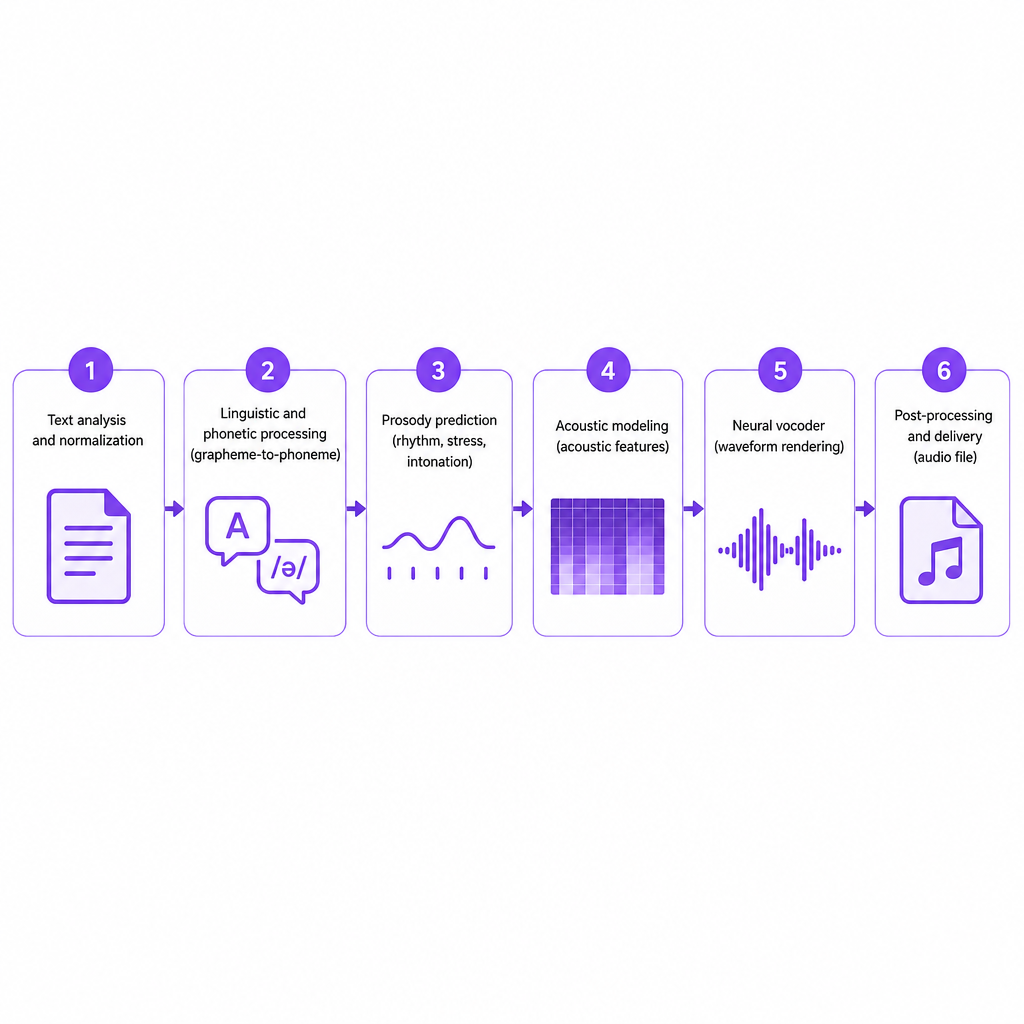
Os mecanismos diferem em detalhes, mas compartilham um pipeline amplamente semelhante descrito na documentação técnica e nas divulgações de IA responsável dos principais provedores, e nossas próprias explicações sobre como as narrações por IA são feitas se alinham a ele.
Análise e normalização de texto
Primeiro o sistema ingere seu texto e o normaliza em uma forma pronunciável. Isso significa expandir números ("2026" torna-se "dois mil e vinte e seis"), datas e abreviações; resolver tokens ambíguos como "US" versus "us" com base no contexto; e ler a pontuação e a estrutura para planejar pausas e ênfases. Nosso mecanismo interpreta a pontuação e a estrutura para inferir ritmo e fluxo em vez de tratar o texto como um fluxo plano de caracteres. Esta etapa tem peso real para roteiros mais longos—cursos, explicativos, podcasts—onde a estrutura de parágrafos e os títulos moldam como um humano leria naturalmente.
Processamento linguístico e fonético
O texto normalizado é convertido em fonemas, as unidades sonoras básicas de um idioma. Um modelo de grafema para fonema mapeia caracteres para sons, lidando com regras de pronúncia, exceções e entrada multilíngue. É isso que permite que nosso Texto em Fala aceite roteiros em muitos idiomas e produza a sequência fonética correta para o selecionado, seja você usando uma voz integrada ou uma voz clonada. Nossas vozes neurais cobrem mais de 33 idiomas, incluindo inglês, português, espanhol, francês, alemão, chinês e japonês.
Predição de prosódia
A prosódia—ritmo, ênfase e entonação—é a diferença entre uma voz robótica e uma performance de aparência humana. Os modelos neurais aprendem padrões prosódicos diretamente das gravações, então podem decidir onde pausar e por quanto tempo, escolher quais palavras carregam ênfase e ajustar o tom e a energia ao longo de uma frase ou parágrafo. As vozes neurais de alta definição vão além, detectando o sentimento no texto e ajustando o tom enquanto mantêm uma persona estável, o que possibilita uma entrega conversacional ou empática para conteúdo de suporte e narração. Nosso mecanismo infere a prosódia antes de sintetizar o áudio pelo mesmo motivo: evitar uma entrega monótona e produzir uma fala que você poderia ouvir durante um módulo inteiro.
Modelagem acústica
Uma vez definidos os fonemas e a prosódia, um modelo acústico neural converte essa representação em características acústicas—um plano para a onda sonora. As divulgações de IA responsável observam que, além das gravações de um dublador específico, esses modelos também recorrem a uma biblioteca de origem mais ampla com muitos locutores. Essa combinação ajuda a rede a aprender padrões gerais de fala enquanto ainda captura o timbre, o sotaque e o estilo de uma voz específica. Em nossa plataforma, é essa modelagem que permite que mais de 300 vozes soem distintas mas naturais, e ela sustenta a clonagem rápida de voz, na qual o sistema aprende a assinatura acústica e prosódica de uma voz a partir de uma amostra curta.
Vocoder e renderização de áudio
As características acústicas passam para um vocoder neural, que as renderiza em uma forma de onda de áudio completa. Os vocoders mais recentes produzem fala de alta fidelidade que é quase indistinguível de gravações de estúdio, com consoantes claras, vogais suaves e artefatos mínimos. A combinação de modelo acústico neural mais vocoder é o motivo pelo qual as vozes neurais soam muito mais naturais do que a tecnologia mais antiga usada em leitores de tela tradicionais e URAs. Usamos avanços semelhantes para que o áudio gerado esteja pronto para publicação direta ou para ser inserido em uma mixagem com música e efeitos sonoros.
Pós-processamento e entrega
Por fim, o sistema pode aplicar pós-processamento—modelagem de ruído, normalização de volume ou conversão de formato—antes de retornar o arquivo de áudio. Para fluxos de trabalho de API, isso é encapsulado em um endpoint RESTful que aceita texto e parâmetros de voz e retorna um ativo pronto para uso. Nosso Texto em Fala segue exatamente esse fluxo: cole ou envie texto, escolha idioma e voz, ajuste a entrega onde os controles estão expostos, gere e baixe áudio em formato padrão. O mesmo mecanismo está por trás da nossa Dublagem por IA, onde transcrição, tradução e síntese são encadeadas para criar versões multilíngues.
Opções dentro da DubSmart: vozes, clonagem, dublagem e APIs
Conhecer os mecanismos explica por que nosso conjunto de recursos é construído da maneira como é.
Texto em Fala para narração direta
Nossa ferramenta de Texto em Fala é a interface central para transformar roteiros em áudio. Você cola ou faz upload de texto em qualquer idioma compatível, escolhe entre as mais de 300 vozes de som natural, define o idioma e os controles básicos de entrega quando disponíveis, e gera fala em segundos. Ela abrange ganchos do YouTube e narração completa de vídeos, narrações explicativas e promocionais para pequenas empresas, módulos claros de e-learning e treinamento, e aberturas, encerramentos e inserções de podcast. Se você está avaliando ferramentas para esse trabalho, nossa seleção dos melhores softwares de dublagem por IA para criadores mostra como narração e localização se conectam.
Clonagem de voz: mantendo a voz da sua marca ou apresentador
A clonagem de voz se baseia nas mesmas etapas neurais—fonemas, prosódia, características acústicas—mas otimiza a rede para corresponder a um timbre e estilo específicos, para que você possa gerar novas falas nessa voz sem regravar. Nossa clonagem rápida de voz cria vozes personalizadas que você pode usar dentro do Texto em Fala ou da Dublagem por IA, o que significa que o conteúdo localizado ainda soa como seu apresentador, narrador ou marca. Essa continuidade importa mais para canais e empresas que investiram em uma identidade de voz reconhecível.
Dublagem por IA: encadeando fala em texto, tradução e TTS
A dublagem por IA usa o mecanismo de TTS como etapa final em uma cadeia mais longa: transcrevendo o áudio existente, traduzindo a transcrição e, então, sintetizando nova fala no idioma-alvo. Nossa Dublagem por IA mantém dublagem, texto em fala, fala em texto e clonagem dentro de um único fluxo de trabalho, para que o conteúdo vá do upload à exportação multilíngue sem sair da plataforma. Na prática, você pode fazer upload de um vídeo ou podcast, tê-lo transcrito e separado do áudio de fundo, traduzir para um ou mais idiomas e, então, gerar faixas dubladas usando vozes de catálogo ou clonadas que preservam a sincronização e o tom. Para um passo a passo sobre conteúdo falado, veja nosso guia sobre como traduzir um podcast para outro idioma.
APIs para desenvolvedores e agências
Disponibilizamos o TTS neural e a dublagem por meio de APIs para que desenvolvedores e agências possam integrar a geração de voz em seus próprios produtos. Nossa API de Texto em Fala é um serviço RESTful que aceita uma requisição POST com conteúdo de texto e preferências de voz e retorna áudio de alta qualidade, com acesso a vozes neurais premium em mais de 33 idiomas. A API de Dublagem por IA estende isso à dublagem multilíngue automatizada. Para agências que lidam com localização entre clientes, esses endpoints padronizam a geração de voz enquanto ainda personalizam idiomas e personas por marca.
Critérios de decisão: escolher e usar bem o TTS neural
Uma vez que o mecanismo esteja claro, o trabalho prático é decidir quando e como usá-lo.
Naturalidade e conforto auditivo. O teste central é se a voz é natural o suficiente para que seu público a aceite como narrador principal. Redes neurais profundas e vozes HD são construídas para reduzir a fadiga auditiva, mas a escolha certa ainda depende do tipo de conteúdo. Use nossa ampla biblioteca de vozes para testar personas—energéticas, calmas, brincalhonas, autoritárias—e, para cursos ou podcasts de formato longo, prefira vozes cuja prosódia pareça conversacional em vez de anunciativa.
Cobertura de idiomas e adequação de sotaque. Para a expansão multilíngue, você precisa tanto do idioma quanto de um sotaque apropriado para o público-alvo. Nossas vozes neurais abrangem mais de 33 idiomas nos principais mercados. Ao escolher faixas localizadas, decida se deseja um sotaque neutro ou específico da região, e teste amostras com falantes nativos sempre que possível.
Consistência de marca versus flexibilidade. A clonagem leva uma voz específica através de idiomas e projetos, mas introduz responsabilidades em torno de consentimento e divulgação. Use-a quando uma persona consistente for central para sua marca, e documente quem detém e controla essa voz—especialmente em trabalhos corporativos ou de agência.
Integração de fluxo de trabalho. O TTS neural entrega o maior valor quando se encaixa em como você já trabalha. Como nossas ferramentas combinam texto em fala, clonagem, dublagem, fala em texto e utilitários de mídia, você pode automatizar boa parte da cadeia de localização enquanto ainda edita roteiros e áudio. Criadores solo podem achar as ferramentas de navegador suficientes; desenvolvedores e agências obtêm endpoints programáveis para escalar.
Riscos, limites e uso responsável
Mesmo modelos avançados têm limites que vale a pena planejar.
- Nuance emocional: as vozes HD respondem ao sentimento, mas podem perder sinais sutis ou performances complexas que um ator habilidoso entregaria. Mensagens de marca críticas ou drama narrativo ainda podem justificar a gravação humana como fonte.
- Casos extremos de pronúncia: nomes raros, termos inéditos ou roteiros com idiomas misturados podem desafiar os modelos de grafema para fonema, então inclua verificações manuais.
- Ética da clonagem: as diretrizes de IA responsável enfatizam que vozes personalizadas devem ser construídas e usadas com consentimento explícito, contratos claros e divulgação ao público. Imitar pessoas sem permissão levanta preocupações legais e éticas.
- Viés e representação: os dados de treinamento moldam como as vozes lidam com sotaques e dialetos, então verifique se as vozes escolhidas representam de forma justa seu público e evitam reforçar estereótipos.
Como nosso fluxo de trabalho integrado facilita gerar e implantar fala sintética, a revisão interna importa mais, não menos—particularmente quando você lida com vozes de clientes ou funcionários. Um caminho concreto ajuda: um criador pode escrever um roteiro em inglês, gerar uma narração em inglês e, então, dublar versões em espanhol, português e alemão para canais adicionais, mantendo a mesma sincronização e entrega. Uma equipe de treinamento pode construir narração modular e regerá-la rapidamente sempre que as políticas mudarem. Essa é a real recompensa de entender o pipeline—você sabe qual etapa controlar e qual deixar o modelo cuidar.
Perguntas frequentes
O que é a conversão neural de texto em fala em termos simples?
A conversão neural de texto em fala é uma IA que transforma texto escrito em fala usando redes neurais profundas treinadas em grandes conjuntos de dados de gravações humanas, produzindo vozes que soam muito mais próximas de pessoas reais do que os sistemas de TTS mais antigos.
Como o Texto em Fala da DubSmart é diferente do TTS básico?
Usamos modelos neurais que analisam seu roteiro, inferem a prosódia e sintetizam a fala do zero, apoiados por mais de 300 vozes naturais e clonagem rápida de voz, para que o resultado funcione como narrador principal em vídeos, cursos e podcasts.
A DubSmart pode manter minha própria voz em outros idiomas?
Sim. Nossa clonagem de voz pode aprender sua voz a partir de gravações e, então, usá-la em texto em fala e dublagem por IA, para que as versões localizadas do seu conteúdo ainda soem como você ou o narrador da sua marca.
Como a dublagem por IA funciona com o TTS neural?
A dublagem por IA encadeia transcrição de fala em texto, tradução e conversão neural de texto em fala, transformando seu áudio existente em faixas dubladas multilíngues em um único fluxo de trabalho, usando vozes de catálogo ou sua voz clonada.
A conversão neural de texto em fala é segura e ética de usar?
Usado com consentimento, divulgação clara e salvaguardas apropriadas, o TTS neural é uma ferramenta poderosa para acessibilidade e localização. As diretrizes de IA responsável enfatizam o respeito aos direitos dos dubladores e evitar usos enganosos de vozes sintéticas.