Przekształcenie scenariusza w narrację na YouTube dawniej oznaczało mikrofon, ciche pomieszczenie i mnóstwo powtórek. Teraz youtube text to speech pozwala wkleić scenariusz, wybrać głos i wyeksportować narrację, którą można dodać do filmu, Shorta, poradnika lub przetłumaczonej wersji już opublikowanego materiału. Prawdziwa decyzja nie polega na tym, czy w ogóle użyć syntetycznego głosu. Chodzi o to, która metoda produkcji pasuje do konkretnego filmu, który masz przed sobą: gotowy głos AI, niestandardowy klon, nagranie człowieka lub jakaś kombinacja tych trzech.
Ten przewodnik wyjaśnia, jak ta technologia faktycznie działa, który proces pasuje do różnych celów kanału oraz co zweryfikować pod kątem praw i ujawniania informacji, zanim naciśniesz publikuj. To centralny punkt naszej szerszej kolekcji objaśnień dotyczących mowy i transkrypcji, więc znajdziesz tu linki do bardziej szczegółowych artykułów tam, gdzie dany temat zasługuje na własną stronę.
Spis treści
Co tak naprawdę oznacza YouTube text to speech
YouTube text to speech to po prostu wykorzystanie technologii zamiany tekstu na mowę do generowania narracji dla treści na YouTube. Dostarczasz scenariusz, wybierasz głos i język, dostosowujesz sposób jego wygłoszenia i eksportujesz plik audio do edycji lub przesłania. Pod maską system TTS przekształca tekst lub Speech Synthesis Markup Language (SSML) w dane audio, takie jak MP3 lub audio zgodne z WAV, które możesz dodać do filmu i innych mediów.
Dwa rozróżnienia rozwiewają większość nieporozumień. Napisy wykonują odwrotną pracę niż TTS: napisy zamieniają wypowiadane audio w tekst, podczas gdy text to speech zamienia napisany tekst w wypowiadane audio. Dubbing jest jeszcze szerszym pojęciem. TTS zazwyczaj zaczyna się od napisanego scenariusza i tworzy nową ścieżkę głosową, podczas gdy dubbing na ogół tłumaczy istniejący film i dopasowuje zastępczą mowę do oryginalnego czasu i znaczenia. Jeśli te granice mają znaczenie dla Twojego procesu, nasze objaśnienie dotyczące tego, na jakie języki AI może dubbingować szczegółowo omawia stronę lokalizacji.
Jak proces syntezy zamienia scenariusz w głos
System TTS łączy cztery składniki: Twój scenariusz, wybrany model głosu, informacje o języku oraz elementy sterujące wygłoszeniem. Na ich podstawie przechodzi przez krótką sekwencję, która wyjaśnia, dlaczego to samo zdanie może brzmieć świetnie lub niezręcznie, w zależności od tego, jak je napisałeś.
Najpierw pojawia się wprowadzony tekst, którym może być pełny scenariusz na YouTube, konspekt rozwinięty w narrację, przetłumaczona wersja istniejącego scenariusza lub napisy przekształcone w lektora. Jakość wprowadzonego tekstu decyduje o jakości wyniku. Długie zdania, niewyjaśnione skróty, nietypowe nazwy i bałaganiarska interpunkcja mogą sprawić, że dobry głos zabrzmi źle. Rozwiązaniem jest pisanie z myślą o słuchaniu, a nie o cichym czytaniu: krótsze zdania, wyraźne przejścia, celowe pauzy.
Następnie silnik analizuje tekst, aby zdecydować, jak słowa powinny być wymawiane i grupowane. Odczytuje granice zdań, interpunkcję i pauzy, liczby i daty, skróty, nazwy oraz regionalne wskazówki dotyczące wymowy. Dlatego interpunkcja zmienia wygłoszenie. Dodaj przecinek, zapisz liczbę słowami lub rozwiń akronim, a głos zareaguje.
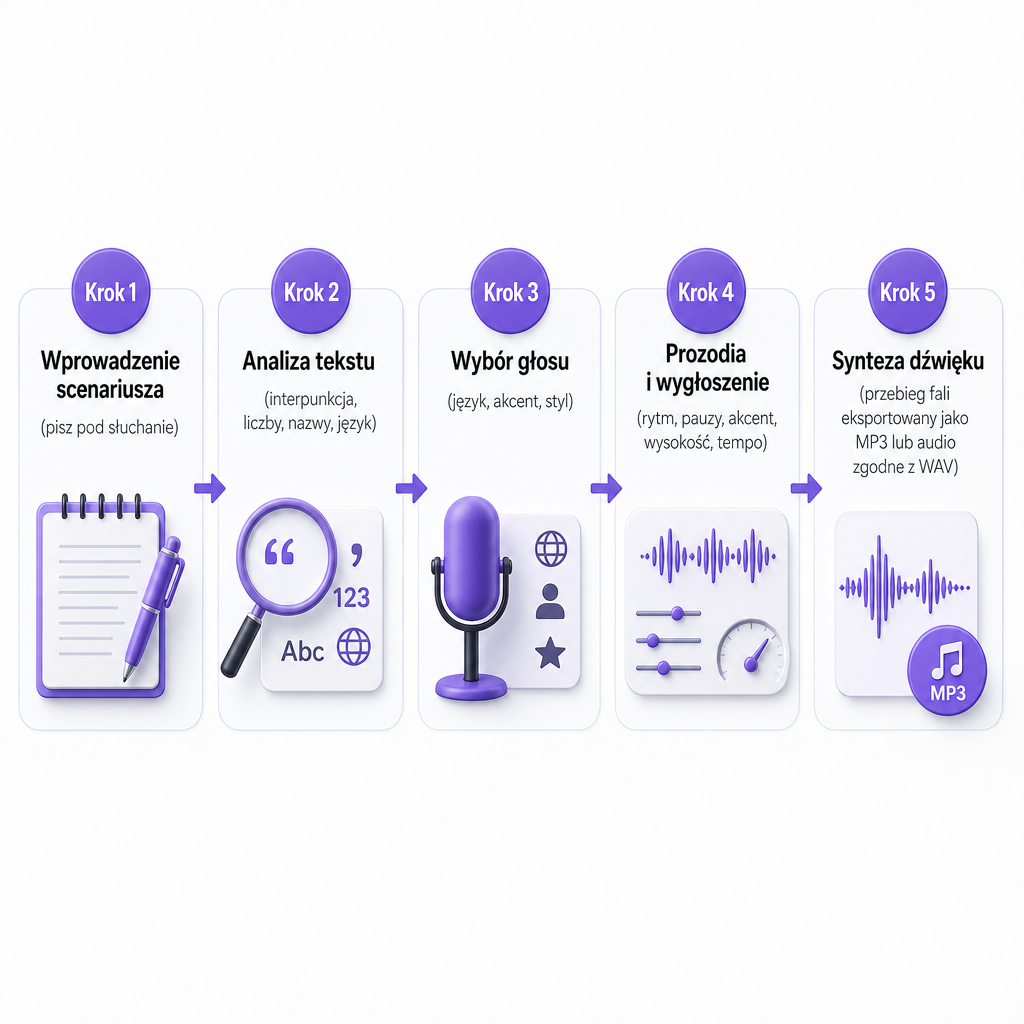
Potem wybierasz głos. Głosy różnią się językiem, akcentem, wiekiem lub charakterem wokalnym, prezentacją płci, stylem mówienia, energią i formalnością. Ustawienia wyjściowe często obejmują tempo mówienia, wysokość, głośność i częstotliwość próbkowania. Dla kanału spójność zazwyczaj przewyższa dramatyzm. Rozpoznawalny głos przeniesiony przez wszystkie filmy sprawia, że kanał wydaje się spójny, co ma większe znaczenie niż wybór najbardziej teatralnej opcji dla pojedynczego materiału.
Następnie silnik generuje prozodię — rytm, pauzy, akcenty, zmiany wysokości tonu i intonację, które odróżniają ekspresyjną mowę od równomiernie rozłożonych słów. Niektóre narzędzia udostępniają te elementy sterujące bezpośrednio; inne wnioskują je z interpunkcji, struktury zdań lub instrukcji stylu. To właśnie tutaj ujawnia się większość luk w jakości. Głos może wymawiać każde słowo poprawnie, a i tak brzmieć źle, jeśli tempo lub ton emocjonalny kłóci się z filmem.
Na koniec model syntetyzuje audio, przekształcając przeanalizowany tekst w przebieg fali, który usługa zwraca jako plik do pobrania. Proces API może zwrócić zakodowane dane audio, które dekodujesz do pliku możliwego do odtworzenia, podczas gdy hostowane narzędzia dla twórców wykonują ten krok za Ciebie. Nawet wtedy narracja nie jest gotowym filmem. Nadal umieszczasz ją na osi czasu, wycinasz martwą ciszę, dodajesz muzykę i efekty, dopasowujesz do obrazu, równoważysz poziomy, dodajesz napisy oraz sprawdzasz wymowę i synchronizację. W przypadku materiału objaśniającego głos powinien podążać za sekwencją wizualną; technicznie czysta ścieżka nadal sprawia wrażenie niechlujnej, jeśli obrazy zmieniają się, zanim rozpocznie się pasujące zdanie. Jeśli chcesz poznać pełny obraz neuronowy, nasze omówienie jak działa neuronowa zamiana tekstu na mowę wchodzi głębiej w wewnętrzne działanie modelu.
Cztery ścieżki produkcji i kiedy każda z nich wygrywa
Większość narracji na YouTube sprowadza się do czterech opcji, a właściwa zależy od tego, czego potrzebuje film, a nie od tego, która brzmi najbardziej zaawansowanie w podglądzie.
| Ścieżka | Najlepsza do | Główny kompromis |
|---|---|---|
| Standardowy głos AI | Kanały bez twarzy, materiały objaśniające, poradniki, podsumowania w stylu newsów, Shorty | Szybki i niezawodny, ale niepowiązany z konkretną osobą |
| Niestandardowy klon głosu | Utrzymanie jednej rozpoznawalnej tożsamości w wielu filmach | Wymaga głosu, do którego reprodukcji masz uprawnienia |
| Wielojęzyczny TTS lub dubbing | Przetłumaczone materiały objaśniające, zlokalizowane filmy produktowe, testy nowych rynków | Wymaga weryfikacji wymowy i kulturowej dla każdego języka |
| Lektor-człowiek | Niuanse aktorskie, świadectwa, wrażliwe lub kluczowe dla marki sformułowania | Wolniejszy i trudniejszy do skalowania |
Standardowy głos pobrany z biblioteki dostawcy to najszybsza ścieżka dla treści o dużej objętości, gdzie nie potrzebujesz, by narracja brzmiała jak jedna konkretna osoba. Niestandardowe klonowanie głosu buduje syntetyczny głos z próbki audio, co pomaga twórcy utrzymać spójną tożsamość bez ręcznego nagrywania każdego scenariusza. Używaj klonowania wyłącznie za zgodą i z głosem, do którego reprodukcji masz prawo; klon nie jest obejściem posiadania czyjejś tożsamości lub występu. Nasze narzędzie Text to Speech daje dostęp do głosów AI i procesów klonowania, a nasza strona Voice Cloning to miejsce, od którego warto zacząć, gdy chcesz mieć wielokrotnego, niestandardowego lektora, a nie gotowego.
Wielojęzyczna narracja pozwala przetłumaczyć scenariusz i zsyntetyzować nową ścieżkę głosową w innym języku, co jest przydatne przy rozwijaniu kanału edukacyjnego za granicą, lokalizowaniu filmów produktowych lub testowaniu popytu na nowym rynku. TTS zaczyna się od tekstu; nasz proces AI Dubbing dodaje szerszą warstwę lokalizacji, w tym tłumaczenie i zastępcze audio dla istniejącego filmu w 33 językach. Lektor-człowiek nadal wygrywa, gdy film opiera się na niuansach aktorskich, osobistym świadectwie, wrażliwych tematach, złożonym humorze, prawnie lub kluczowo związanych z marką sformułowaniach lub charakterystycznej interpretacji konkretnego wykonawcy. Wiele kanałów stosuje podejście hybrydowe: narracja AI do szkiców, wersji i materiałów o dużej objętości, głos ludzki do flagowych filmów.
Kiedy text to speech zasługuje na miejsce na kanale
YouTube TTS opłaca się najbardziej, gdy Twoim wąskim gardłem jest nagrywanie, a nie pisanie. Jeśli tworzenie scenariuszy jest łatwe, ale umawianie sesji nagraniowej to wolny etap, syntetyczna narracja eliminuje najwolniejszy krok.
Filmy edukacyjne i instruktażowe korzystają na tym bezpośrednio. Zaktualizuj scenariusz i wygeneruj ponownie tylko zmienioną sekcję zamiast organizować nowe nagranie, co pasuje do poradników dotyczących oprogramowania, onboardingu i treści kursów, które często się zmieniają. Kanały bez twarzy mogą opowiadać filmy zbudowane z nagrań ekranu, materiałów stockowych, animacji, slajdów lub generowanych wizualizacji, choć głos nadal potrzebuje reżyserii redakcyjnej; audio dodane nad niepowiązanym materiałem podważa zaufanie widzów. Shorty zyskują na szybkim przejściu od scenariusza do audio, pozwalając testować wiele haczyków lub wariantów dla widowni, o ile głos nie brzmi pospiesznie lub powtarzalnie.
Dostępność to kolejne uczciwe zastosowanie. Wypowiadana wersja treści pisemnej pomaga widzom, którzy wolą dźwięk lub mają trudności z tekstem na ekranie, ale narracja powinna uzupełniać dokładne napisy i przejrzysty projekt wizualny, a nie je zastępować. A w przypadku ekspansji wielojęzycznej możesz tworzyć przetłumaczone ścieżki głosowe bez prowadzenia osobnego procesu produkcji dla każdego języka. Funkcja wielojęzycznego audio YouTube pozwala uprawnionym twórcom dołączyć dodatkowe ścieżki audio do pojedynczego filmu lub Shorta zamiast zarządzać osobnym kanałem dla każdego rynku.
Wybór i testowanie głosu, zanim się zdecydujesz
Oceniaj głos pod kątem rzeczywistych wymagań filmu, a nie pochlebnego dziesięciosekundowego podglądu. Głos, który idealnie zaśpiewa jedną linijkę, może się rozsypać przy pełnym scenariuszu, więc najpierw poddaj go próbie pod presją.
- Dopasuj głos do formatu. Spokojne wygłoszenie pasuje do dokumentu lub poradnika; głos o większej energii nadaje się do krótkiego haczyka lub ogłoszenia. Niech temat, tempo i widownia zdecydują.
- Przetestuj trudne słowa. Przed wygenerowaniem całego filmu przetestuj powtarzające się nazwy marki, nazwy miejsc, akronimy, terminy naukowe, obce słowa, jednostki i nazwiska osób. Głos, który radzi sobie ze zwykłymi zdaniami, może potknąć się na słownictwie Twojego kanału.
- Sprawdź spójność w dłuższej formie. Wygeneruj dłuższą próbkę i wsłuchaj się w powtarzalną intonację, niewłaściwe pauzy, nienaturalny rytm, zmieniającą się wymowę i gwałtowne przejścia między akapitami.
- Weź pod uwagę regionalną widownię. Narracja po angielsku może wymagać wymowy amerykańskiej, brytyjskiej, australijskiej lub innej. W przypadku innych języków upewnij się, że głos brzmi naturalnie dla rodzimego ucha, a nie tylko że narzędzie wymienia dany język.
- Sprawdź prawa do użytkowania. Przed monetyzacją lub reklamą przeczytaj warunki dostawcy i potwierdź, że głos i wynik są dopuszczone do komercyjnych treści na YouTube, pracy dla klientów, płatnych reklam i wersji pochodnych.
Kilka nawyków pisarskich również szybko podnosi jakość. Pisz pod kątem mowy, zamieniając gęstą prozę na konwersacyjne zdania i używając interpunkcji do kierowania pauzami bez polegania na niej dla emocji. Rozpisz niejednoznaczne terminy, aby silnik odczytał je poprawnie, testując warianty takie jak „AI" kontra „A.I." czy „2026" kontra „dwa tysiące dwadzieścia sześć". Generuj w sekcjach, a nie w jednym gigantycznym pliku, aby móc ponownie wygenerować pojedynczy błąd, zmienić kolejność scen i dopasować audio do obrazu. Następnie dodaj edycję przez człowieka: obejrzyj cały film z odtwarzaną ścieżką, wytnij niezręczne pauzy, popraw synchronizację i przycisz muzykę pod mową. AI skraca czas nagrywania; nie usuwa redakcyjnej weryfikacji.
Prawa, ujawnianie informacji i przesyłanie ścieżki w drugim języku
Część, którą twórcy najczęściej pomijają, jest też tą, która powoduje usuwanie filmów. Jeśli zbudujesz osobną wersję językową, możesz opublikować ją jako nowy film lub skorzystać z funkcji wielojęzycznego audio YouTube tam, gdzie jest dostępna, ale platforma nie tworzy tych dubbingowanych ścieżek za Ciebie. Twórcy muszą przygotować i przesłać własne pliki audio w obsługiwanym formacie wyłącznie dźwiękowym, mniej więcej tej samej długości co film. YouTube może również usunąć dodatkowy plik audio, jeśli jego treść objęta prawami autorskimi różni się od oryginału, co sprawia, że weryfikacja praw jest niezbędna, gdy Twoja dubbingowana ścieżka zawiera muzykę, klipy lub inny chroniony materiał.
Ujawnianie informacji to osobny obowiązek. YouTube wymaga od twórców ujawniania treści wygenerowanych lub zmodyfikowanych przez AI, które wyglądają realistycznie, w tym treści, które sprawiają, że prawdziwa osoba zdaje się mówić lub robić coś, czego nie zrobiła, zmieniają nagranie rzeczywistego wydarzenia lub miejsca albo fabrykują realistyczną scenę. Co istotne, YouTube wymienia klonowanie własnego głosu do lektorów lub dubbingów wśród przykładów, które nie wymagają ujawniania w ramach tej konkretnej polityki. Nie jest to licencja na klonowanie cudzego głosu, a oznaczenie treści syntetycznych nie upoważnia do używania twarzy lub głosu innej osoby bez pozwolenia.
Bezpieczna polityka redakcyjna polega na używaniu własnego głosu lub licencjonowanego, przechowywaniu dokumentacji zgody na wszelkie niestandardowe próbki głosu, unikaniu naśladowania prawdziwej osoby bez upoważnienia, sprawdzaniu warunków użytkowania komercyjnego, ujawnianiu realistycznych treści syntetycznych lub zmodyfikowanych, gdy YouTube tego wymaga, oraz osobnej weryfikacji praw do muzyki, materiałów i przetłumaczonego audio. Dla zespołów wielokrotnie generujących narrację z systemu lub aplikacji treści nasze API Text to Speech jest stworzone do programowego generowania mowy, dzięki czemu możesz produkować ścieżki na dużą skalę bez przebudowywania procesu za każdym razem.
Czy więc YouTube text to speech jest tego wart? To świetne dopasowanie, gdy potrzebujesz powtarzalnej narracji, szybkich poprawek, wielojęzycznych wersji lub lektora bez sprzętu nagraniowego. Jest słabszym dopasowaniem, gdy sukces filmu zależy od niuansów aktorskich, osobistego świadectwa lub prawnie wrażliwego występu. Liczy się nie to, czy widzowie potrafią rozpoznać, że głos jest syntetyczny. Liczy się to, czy narracja jest klarowna, odpowiednia, spójna, dopuszczalna prawnie i dobrze zintegrowana z filmem.
Najczęściej zadawane pytania
Czy mogę używać audio z zamiany tekstu na mowę na YouTube?
Tak. Możesz używać wygenerowanej narracji w filmie na YouTube, o ile respektujesz warunki licencyjne dostawcy TTS, polityki YouTube oraz prawa związane z Twoim scenariuszem, muzyką, materiałami i głosem.
Czy YouTube automatycznie zamienia scenariusz w narrację?
Nie. Funkcja wielojęzycznego audio YouTube nie tworzy dubbingowanych ścieżek za Ciebie. Twórcy muszą przygotować i przesłać własne pliki audio.
Jaka jest różnica między YouTube text to speech a automatycznym dubbingiem?
Text to speech zamienia napisany tekst w wypowiadane audio. Automatyczny dubbing to szerszy proces lokalizacji, który może tłumaczyć i generować ścieżkę w języku zastępczym dla istniejącej treści. Dokładne funkcje zależą od platformy i procesu.
Czy mogę sklonować swój głos do filmów na YouTube?
Możesz użyć klona głosu, gdy masz prawo do jego stworzenia i wykorzystania. YouTube wymienia klonowanie własnego głosu do lektorów lub dubbingów jako przykład, który nie wymaga ujawniania w ramach swojej polityki dotyczącej treści realistycznych, choć inne treści wygenerowane lub zmodyfikowane przez AI mogą nadal wymagać ujawnienia.
Jaki plik audio powinienem przesłać dla drugiego języka?
W przypadku funkcji wielojęzycznego audio YouTube plik musi być w obsługiwanym formacie wyłącznie dźwiękowym i mniej więcej tej samej długości co film. Sprawdź aktualny interfejs przesyłania w YouTube Studio przed eksportem.