Zapytaj, jak działa neuronowa synteza mowy z tekstu, a krótka odpowiedź brzmi tak: przekształca ona pisany tekst w realistyczne audio, przepuszczając Twój scenariusz przez głębokie sieci neuronowe, które modelują sposób, w jaki ludzie faktycznie mówią — wymowę, rytm i intonację razem. Zamiast sklejać nagrane wcześniej fragmenty, jak robiły to starsze systemy, neuronowa syntezowa mowa (TTS) generuje mowę od zera, ucząc się wzorców bezpośrednio z dużych zbiorów danych zawierających prawdziwe ludzkie nagrania powiązane z tekstem. To rozróżnienie sprawia, że nowoczesne syntetyczne głosy brzmią jak narrator, którego mógłbyś słuchać przez cały film, a nie jak robotyczne ogłoszenie. W DubSmart AI opieramy się na tym samym neuronowym podejściu, aby zasilić naszą syntezę mowy z tekstu (Text to Speech), łącząc ją z klonowaniem głosu i dubbingiem, tak aby jeden scenariusz mógł przejść z jednego języka na wiele.
Ten przewodnik przeprowadza przez mechanizm etap po etapie, a następnie przekłada go na praktyczne decyzje: gdzie głos neuronowy jest wystarczająco dobry, by stanąć samodzielnie, gdzie nadal potrzebujesz ludzkiego wykonania i jak elementy pasują do siebie w naszej platformie.
Spis treści
Co naprawdę oznacza „jak działa neuronowa synteza mowy z tekstu”
Neuronowa synteza mowy z tekstu to forma syntezy mowy, która wykorzystuje głębokie sieci neuronowe do generowania mowy od zera. Kluczowe odejście od metod opartych na regułach lub konkatenacyjnych polega na tym, że system uczy się z dużych zbiorów ludzkich nagrań powiązanych z tekstem, dzięki czemu może przewidzieć zarówno to, jak słowa powinny brzmieć, jak i to, jak człowiek naturalnie by je wypowiedział. To wyuczone zachowanie odpowiada za uchwycenie prozodii — akcentu, rytmu, pauz i tonu emocjonalnego — sprawiając, że powstały głos jest komfortowy podczas długich sesji słuchania. Główni dostawcy chmury opisują te głosy neuronowe jako syntezowaną mowę przypominającą ludzką, której artykulacja zmniejsza zmęczenie słuchaniem w asystentach, narzędziach dostępności i doświadczeniach czytania na głos.
Nasz silnik Text to Speech podąża tą neuronową ścieżką. Analizuje Twój scenariusz, dzieli go na fonemy, wnioskuje rytm i intonację, a następnie używa modeli neuronowych do renderowania płynnego audio zamiast płaskiego przekazu kojarzonego ze starszym TTS. Rezultatem jest realistyczna mowa generowana z tekstu w kilka sekund, wybierana z biblioteki ponad 300 głosów dostosowanych do różnych tonów i zastosowań.
Dlaczego neuronowe TTS ma znaczenie dla twórców i zespołów
Dla twórców YouTube, małych firm, producentów e-learningu, filmowców, podcasterów i deweloperów prawdziwe pytanie brzmi nie tylko, jak technologia działa, ale czy oprzeć się na niej w potoku produkcyjnym. Neuronowe TTS ma znaczenie, ponieważ przenosi syntetyczne głosy z obszaru „użytkowego” — wskazówki GPS, podstawowe komunikaty — do obszaru wykonawców: wystarczająco dobre, by prowadzić treści, narrować całe kursy i przenosić markowe przekazy bez brzmienia wyraźnie sztucznie. Połącz je z tłumaczeniem i dubbingiem, a stanie się mnożnikiem, pozwalając jednemu scenariuszowi dotrzeć do dziesiątek języków za ułamek kosztu i czasu tradycyjnej pracy studyjnej.
Zaprojektowaliśmy DubSmart dokładnie wokół tej decyzji. Text to Speech, Klonowanie Głosu, Dubbing AI, Speech to Text, Separator Mowy, Text to Image i Image to Video znajdują się w jednym potoku, dzięki czemu treści mówione przechodzą od przesłania do wielojęzycznego eksportu bez żonglowania osobnymi narzędziami. Wybierasz, ile zautomatyzować, a ile dostosować na każdym etapie — scenariusz, głos, język, miks — w jednym środowisku.
Gdzie to trafia, zależy od tego, co tworzysz:
- Rozszerzanie kanału YouTube na nowe języki: neuronowe TTS plus dubbing pozwala ponownie wykorzystać scenariusze i synchronizację, jednocześnie podmieniając zlokalizowane głosy.
- Lokalizowanie filmów marketingowych lub szkoleniowych: uzyskujesz spójną narrację marki w różnych językach bez rezerwowania lektorów przy każdej aktualizacji.
- Produkcja e-learningu lub szkoleń korporacyjnych: długa narracja staje się skalowalna i łatwa do zmiany, gdy treść się zmienia.
- Prowadzenie podcastu lub filmu niezależnego: możesz tworzyć wersje wielojęzyczne, wstawki narracyjne lub ścieżki dostępności.
- Budowanie aplikacji: nasze API zamieniają mowę neuronową w wywoływalną usługę dla IVR, agentów i narzędzi do treści.
Zrozumienie mechanizmu pomaga ocenić, gdzie głos neuronowy może stanąć samodzielnie, a gdzie ludzkie nagranie powinno pozostać źródłem do klonowania lub dubbingu.
Pod maską: potok neuronowego TTS
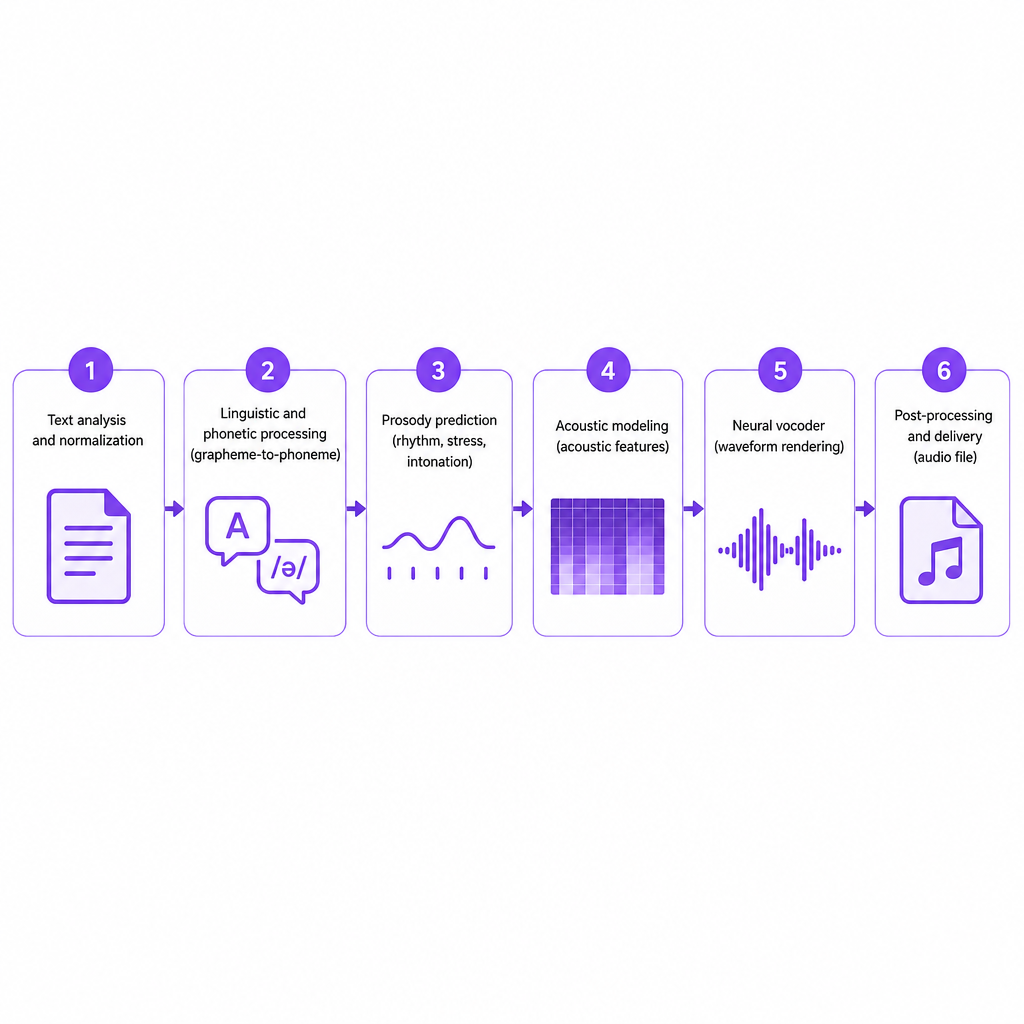
Silniki różnią się szczegółami, ale mają wspólny szeroko podobny potok opisany w dokumentacji technicznej i ujawnieniach odpowiedzialnej AI od głównych dostawców, a nasze własne wyjaśnienia dotyczące tworzenia lektorów AI są z nim zgodne.
Analiza tekstu i normalizacja
Najpierw system pobiera Twój tekst i normalizuje go do formy, którą można wypowiedzieć. Oznacza to rozwijanie liczb („2026” staje się „dwa tysiące dwadzieścia sześć”), dat i skrótów; rozwiązywanie niejednoznacznych tokenów, takich jak „US” kontra „us” na podstawie kontekstu; oraz odczytywanie interpunkcji i struktury w celu zaplanowania pauz i akcentów. Nasz silnik interpretuje interpunkcję i strukturę, aby wywnioskować rytm i przepływ, zamiast traktować tekst jako płaski strumień znaków. Ten etap ma realne znaczenie dla dłuższych scenariuszy — kursów, objaśnień, podcastów — gdzie struktura akapitów i nagłówki kształtują to, jak człowiek naturalnie by czytał.
Przetwarzanie lingwistyczne i fonetyczne
Znormalizowany tekst jest przekształcany w fonemy, podstawowe jednostki dźwiękowe języka. Model grafem-fonem mapuje znaki na dźwięki, obsługując reguły wymowy, wyjątki i dane wejściowe wielojęzyczne. To właśnie pozwala naszemu Text to Speech przyjmować scenariusze w wielu językach i produkować poprawną sekwencję fonetyczną dla wybranego z nich, niezależnie od tego, czy używasz wbudowanego głosu, czy głosu sklonowanego. Nasze głosy neuronowe obejmują ponad 33 języki, w tym angielski, portugalski, hiszpański, francuski, niemiecki, chiński i japoński.
Przewidywanie prozodii
Prozodia — rytm, akcent i intonacja — jest różnicą między głosem robotycznym a wykonaniem przypominającym ludzkie. Modele neuronowe uczą się wzorców prozodycznych bezpośrednio z nagrań, dzięki czemu mogą decydować, gdzie zrobić pauzę i jak długą, wybierać, które słowa niosą akcent, oraz dostosowywać wysokość i energię w zdaniu lub akapicie. Głosy neuronowe wysokiej rozdzielczości idą dalej, wykrywając nastrój w tekście i dostosowując ton przy zachowaniu stabilnej osobowości, co umożliwia konwersacyjny lub empatyczny przekaz dla treści wsparcia i narracji. Nasz silnik wnioskuje prozodię przed syntezowaniem audio z tego samego powodu: aby uniknąć płaskiego przekazu i wytworzyć mowę, której mógłbyś słuchać przez cały moduł.
Modelowanie akustyczne
Gdy fonemy i prozodia są ustalone, neuronowy model akustyczny przekształca tę reprezentację w cechy akustyczne — plan fali dźwiękowej. Ujawnienia odpowiedzialnej AI zauważają, że oprócz nagrań konkretnego lektora modele te czerpią również z szerszej biblioteki źródłowej wielu mówców. Ta mieszanka pomaga sieci uczyć się ogólnych wzorców mowy, jednocześnie uchwytując barwę, akcent i styl konkretnego głosu. W naszej platformie to modelowanie sprawia, że ponad 300 głosów brzmi odrębnie, a jednocześnie naturalnie, i stanowi podstawę szybkiego klonowania głosu, gdzie system uczy się akustycznej i prozodycznej sygnatury głosu z krótkiej próbki.
Wokoder i renderowanie audio
Cechy akustyczne przechodzą do neuronowego wokodera, który renderuje je w pełną falę dźwiękową. Nowsze wokodery produkują wysokiej wierności mowę, która jest niemal nieodróżnialna od nagrań studyjnych, z wyraźnymi spółgłoskami, płynnymi samogłoskami i minimalnymi artefaktami. Połączenie neuronowego modelu akustycznego i wokodera jest powodem, dla którego głosy neuronowe brzmią znacznie bardziej naturalnie niż starsza technologia stosowana w tradycyjnych czytnikach ekranu i IVR. Wykorzystujemy podobne osiągnięcia, więc generowane audio jest gotowe do bezpośredniej publikacji lub wstawienia do miksu z muzyką i efektami dźwiękowymi.
Przetwarzanie końcowe i dostarczanie
Na koniec system może zastosować przetwarzanie końcowe — kształtowanie szumu, normalizację głośności lub konwersję formatu — przed zwróceniem pliku audio. W przypadku przepływów pracy API jest to opakowane w punkt końcowy RESTful, który przyjmuje tekst i parametry głosu oraz zwraca gotowy do użycia zasób. Nasz Text to Speech podąża dokładnie tym przepływem: wklej lub wyślij tekst, wybierz język i głos, dostosuj przekaz tam, gdzie kontrolki są dostępne, wygeneruj i pobierz audio w standardowym formacie. Ten sam silnik znajduje się pod naszym Dubbingiem AI, gdzie transkrypcja, tłumaczenie i synteza są łączone w celu tworzenia wersji wielojęzycznych.
Opcje w DubSmart: głosy, klonowanie, dubbing i API
Znajomość mechaniki wyjaśnia, dlaczego nasz zestaw funkcji jest zbudowany tak, jak jest.
Text to Speech do bezpośredniej narracji
Nasze narzędzie Text to Speech to podstawowy interfejs do zamiany scenariuszy w audio. Wklejasz lub przesyłasz tekst w dowolnym obsługiwanym języku, wybierasz spośród ponad 300 naturalnie brzmiących głosów, ustawiasz język i podstawowe kontrolki przekazu tam, gdzie są dostępne, i generujesz mowę w kilka sekund. Obejmuje to hooki YouTube i pełną narrację wideo, lektory objaśniające i promocyjne dla małych firm, wyraźne moduły e-learningowe i szkoleniowe oraz intra, outra i wstawki podcastów. Jeśli rozważasz narzędzia do tej pracy, nasze zestawienie najlepszego oprogramowania do dubbingu AI dla twórców pokazuje, jak narracja i lokalizacja łączą się ze sobą.
Klonowanie głosu: zachowanie głosu Twojej marki lub prowadzącego
Klonowanie głosu opiera się na tych samych krokach neuronowych — fonemy, prozodia, cechy akustyczne — ale optymalizuje sieć, aby dopasować konkretną barwę i styl, dzięki czemu możesz generować nowe kwestie w tym głosie bez ponownego nagrywania. Nasze szybkie klonowanie głosu tworzy niestandardowe głosy, których możesz używać w Text to Speech lub Dubbingu AI, co oznacza, że zlokalizowane treści nadal brzmią jak Twój prowadzący, narrator lub marka. Ta ciągłość ma największe znaczenie dla kanałów i firm, które zainwestowały w rozpoznawalną tożsamość głosową.
Dubbing AI: łączenie speech to text, tłumaczenia i TTS
Dubbing AI wykorzystuje silnik TTS jako ostatni krok w dłuższym łańcuchu: transkrypcja istniejącego audio, tłumaczenie transkrypcji, a następnie syntezowanie nowej mowy w języku docelowym. Nasz Dubbing AI utrzymuje dubbing, text-to-speech, speech-to-text i klonowanie w jednym przepływie pracy, dzięki czemu treści przechodzą od przesłania do wielojęzycznego eksportu bez opuszczania platformy. W praktyce możesz przesłać film lub podcast, kazać go transkrybować i oddzielić od dźwięku tła, przetłumaczyć na jeden lub więcej języków, a następnie wygenerować ścieżki dubbingowe przy użyciu głosów standardowych lub sklonowanych, które zachowują synchronizację i ton. Aby zapoznać się z przewodnikiem po treściach mówionych, zobacz nasz poradnik na temat jak przetłumaczyć podcast na inny język.
API dla deweloperów i agencji
Udostępniamy neuronowe TTS i dubbing poprzez API, dzięki czemu deweloperzy i agencje mogą zintegrować generowanie głosu z własnymi produktami. Nasze API Text to Speech to usługa RESTful, która przyjmuje żądanie POST z treścią tekstową i preferencjami głosowymi oraz zwraca wysokiej jakości audio, z dostępem do premium głosów neuronowych w ponad 33 językach. API Dubbingu AI rozszerza to o zautomatyzowany dubbing wielojęzyczny. Dla agencji zajmujących się lokalizacją u wielu klientów te punkty końcowe standaryzują generowanie głosu, jednocześnie dostosowując języki i osobowości dla każdej marki.
Kryteria decyzyjne: dobre wybieranie i używanie neuronowego TTS
Gdy mechanizm jest jasny, praktyczna praca polega na decydowaniu, kiedy i jak go używać.
Naturalność i komfort słuchania. Podstawowy test polega na tym, czy głos jest wystarczająco naturalny, aby Twoja publiczność zaakceptowała go jako głównego narratora. Głębokie sieci neuronowe i głosy HD są zbudowane, aby zmniejszyć zmęczenie słuchaniem, ale właściwy wybór nadal zależy od typu treści. Użyj naszej dużej biblioteki głosów, aby przetestować osobowości — energiczne, spokojne, zabawne, autorytatywne — a dla długich kursów lub podcastów faworyzuj głosy, których prozodia jest konwersacyjna, a nie przypominająca ogłoszenia.
Pokrycie językowe i dopasowanie akcentu. Do ekspansji wielojęzycznej potrzebujesz zarówno języka, jak i akcentu odpowiedniego dla publiczności docelowej. Nasze głosy neuronowe obejmują ponad 33 języki na głównych rynkach. Wybierając zlokalizowane ścieżki, zdecyduj, czy chcesz akcentu neutralnego, czy specyficznego dla regionu, i testuj próbki z rodzimymi użytkownikami języka tam, gdzie to możliwe.
Spójność marki kontra elastyczność. Klonowanie przenosi konkretny głos przez języki i projekty, ale wprowadza obowiązki związane ze zgodą i ujawnieniem. Używaj go, gdy spójna osobowość jest kluczowa dla Twojej marki, i dokumentuj, kto jest właścicielem i kontroluje ten głos — szczególnie w pracy korporacyjnej lub agencyjnej.
Integracja przepływu pracy. Neuronowe TTS przynosi największą wartość, gdy wpasowuje się w to, jak już pracujesz. Ponieważ nasze narzędzia łączą text-to-speech, klonowanie, dubbing, speech to text i narzędzia medialne, możesz zautomatyzować dużą część łańcucha lokalizacyjnego, jednocześnie edytując scenariusze i audio. Twórcy pracujący solo mogą uznać narzędzia przeglądarkowe za wystarczające; deweloperzy i agencje otrzymują programowalne punkty końcowe do skalowania.
Ryzyka, ograniczenia i odpowiedzialne użycie
Nawet zaawansowane modele mają granice, wokół których warto planować.
- Niuans emocjonalny: Głosy HD reagują na nastrój, ale mogą przegapić subtelne sygnały lub złożone wykonania, które dostarczyłby wykwalifikowany aktor. Krytyczne przekazy marki lub dramat narracyjny mogą nadal uzasadniać ludzkie nagranie jako źródło.
- Przypadki brzegowe wymowy: Rzadkie nazwy, nowe terminy lub scenariusze mieszanojęzyczne mogą stanowić wyzwanie dla modeli grafem-fonem, więc wbuduj ręczne kontrole.
- Etyka klonowania: Wytyczne odpowiedzialnej AI podkreślają, że niestandardowe głosy powinny być tworzone i używane z wyraźną zgodą, jasnymi umowami i ujawnieniem wobec publiczności. Naśladowanie ludzi bez pozwolenia rodzi obawy prawne i etyczne.
- Uprzedzenia i reprezentacja: Dane treningowe kształtują to, jak głosy radzą sobie z akcentami i dialektami, więc sprawdź, czy wybrane głosy uczciwie reprezentują Twoją publiczność i unikają utrwalania stereotypów.
Ponieważ nasz zintegrowany przepływ pracy ułatwia generowanie i wdrażanie syntetycznej mowy, wewnętrzny przegląd ma większe, a nie mniejsze znaczenie — szczególnie gdy obsługujesz głosy klientów lub pracowników. Konkretna ścieżka pomaga: twórca może napisać jeden scenariusz po angielsku, wygenerować angielski lektor, a następnie dubbingować wersje hiszpańską, portugalską i niemiecką na dodatkowe kanały, zachowując tę samą synchronizację i przekaz. Zespół szkoleniowy może zbudować modułową narrację i szybko ją ponownie wygenerować, ilekroć zmieniają się zasady. To prawdziwa korzyść ze zrozumienia potoku — wiesz, który etap kontrolować, a który pozostawić modelowi.
Często zadawane pytania
Czym jest neuronowa synteza mowy z tekstu w prostych słowach?
Neuronowa synteza mowy z tekstu to AI, która zamienia pisany tekst w mowę przy użyciu głębokich sieci neuronowych wytrenowanych na dużych zbiorach ludzkich nagrań, produkując głosy brzmiące znacznie bliżej prawdziwych ludzi niż starsze systemy TTS.
Czym Text to Speech od DubSmart różni się od podstawowego TTS?
Używamy modeli neuronowych, które analizują Twój scenariusz, wnioskują prozodię i syntezują mowę od zera, wspierane przez ponad 300 naturalnych głosów i szybkie klonowanie głosu, dzięki czemu wynik działa jako główny narrator filmów, kursów i podcastów.
Czy DubSmart może zachować mój własny głos w innych językach?
Tak. Nasze klonowanie głosu może nauczyć się Twojego głosu z nagrań, a następnie używać go w text-to-speech i dubbingu AI, dzięki czemu zlokalizowane wersje Twoich treści nadal brzmią jak Ty lub narrator Twojej marki.
Jak dubbing AI działa z neuronowym TTS?
Dubbing AI łączy transkrypcję speech-to-text, tłumaczenie i neuronową syntezę mowy z tekstu, zamieniając Twoje istniejące audio w wielojęzyczne ścieżki dubbingowe w jednym przepływie pracy, używając głosów standardowych lub Twojego sklonowanego głosu.
Czy neuronowa synteza mowy z tekstu jest bezpieczna i etyczna w użyciu?
Używana za zgodą, z jasnym ujawnieniem i odpowiednimi zabezpieczeniami, neuronowa TTS jest silnym narzędziem do dostępności i lokalizacji. Wytyczne odpowiedzialnej AI podkreślają poszanowanie praw lektorów i unikanie zwodniczych zastosowań syntetycznych głosów.