Zamiana jednego podcastu w wielojęzyczny program brzmi jak projekt na miarę profesjonalnego studia, ale przy odpowiednim procesie wymaga mniej niż godziny praktycznej pracy na odcinek, gdy już poznasz kolejne kroki. Jeśli zastanawiałeś się, jak przetłumaczyć podcast na inny język bez ponownego nagrywania każdego odcinka, praktyczną odpowiedzią jest jeden potok lokalizacyjny, który transkrybuje, tłumaczy, ponownie udźwiękawia i synchronizuje twoje audio. Koszty dubbingu AI zwykle mieszczą się gdzieś między około 0,20 a 7 USD za gotową minutę, w zależności od tego, ile minut i języków dostarczasz oraz ile ręcznej kontroli jakości nakładasz.
Zbudowaliśmy DubSmart AI wokół dokładnie tej pracy skoncentrowanej na głosie: bierze treść mówioną z ponad 60 języków źródłowych i tworzy zdubbingowane wersje w 33 językach docelowych, łącząc zamianę mowy na tekst, tłumaczenie, syntezę mowy i klonowanie głosu w jednym miejscu. Ten przewodnik prowadzi przez pełną sekwencję, wskazuje błędy, które po cichu psują zdubbingowane odcinki, i pokazuje, gdzie natywny recenzent zarabia na swoje utrzymanie.
Spis treści
Czego potrzebujesz, zanim zaczniesz
Płynny przebieg lokalizacji zależy mniej od narzędzi, a bardziej od tego, czym je zasilasz. Uporządkuj te pięć rzeczy przed pierwszym projektem, a każdy kolejny krok stanie się szybszy.
- Czyste pliki źródłowe. Eksportuj każdy odcinek jako pojedynczy plik WAV lub MP3 o wysokim bitrate, z minimalnym szumem tła, bez przesterowania i ze znormalizowaną głośnością. Czysty materiał wejściowy bezpośrednio poprawia dokładność transkrypcji i redukuje artefakty podczas dubbingu, zwłaszcza gdy w grę wchodzi separacja mowy.
- Prawa do przekształcania audio. Potwierdź, że możesz tłumaczyć i redystrybuować treść mówioną, wypowiedzi gości oraz wszelką muzykę na każdym rynku, na którym planujesz publikować.
- Strategia języków docelowych. Zdecyduj, które języki traktujesz priorytetowo i czy każdy z nich otrzyma pełny zdubbingowany kanał, czy tylko wybrane odcinki. Każdy dodatkowy język mnoży twoje minuty i koszt, więc planuj świadomie, zamiast dubbingować wszystko naraz.
- Wytyczne dotyczące głosu. Zdecyduj, czy głos prowadzącego ma zostać sklonowany w nowym języku, czy zastąpiony głosem z biblioteki, i przygotuj notatki o wymowie nazw produktów, osób i technicznego żargonu.
- Zasilone konto. Nasza platforma działa w modelu opartym na kredytach obejmującym AI Dubbing, Speech to Text, Speech Separator i Text to Speech. Sprawdź swoje saldo, aby móc przetworzyć całe odcinki, zamiast zatrzymywać się w połowie.
Jeśli chcesz zrozumieć, jak transkrypcja, tłumaczenie i ponowne udźwiękowienie łączą się ze sobą, zanim zaczniesz projekt, nasze wyjaśnienie o tym, jak działa lokalizacja AI, obejmuje cały potok od początku do końca.
Proces dubbingu krok po kroku
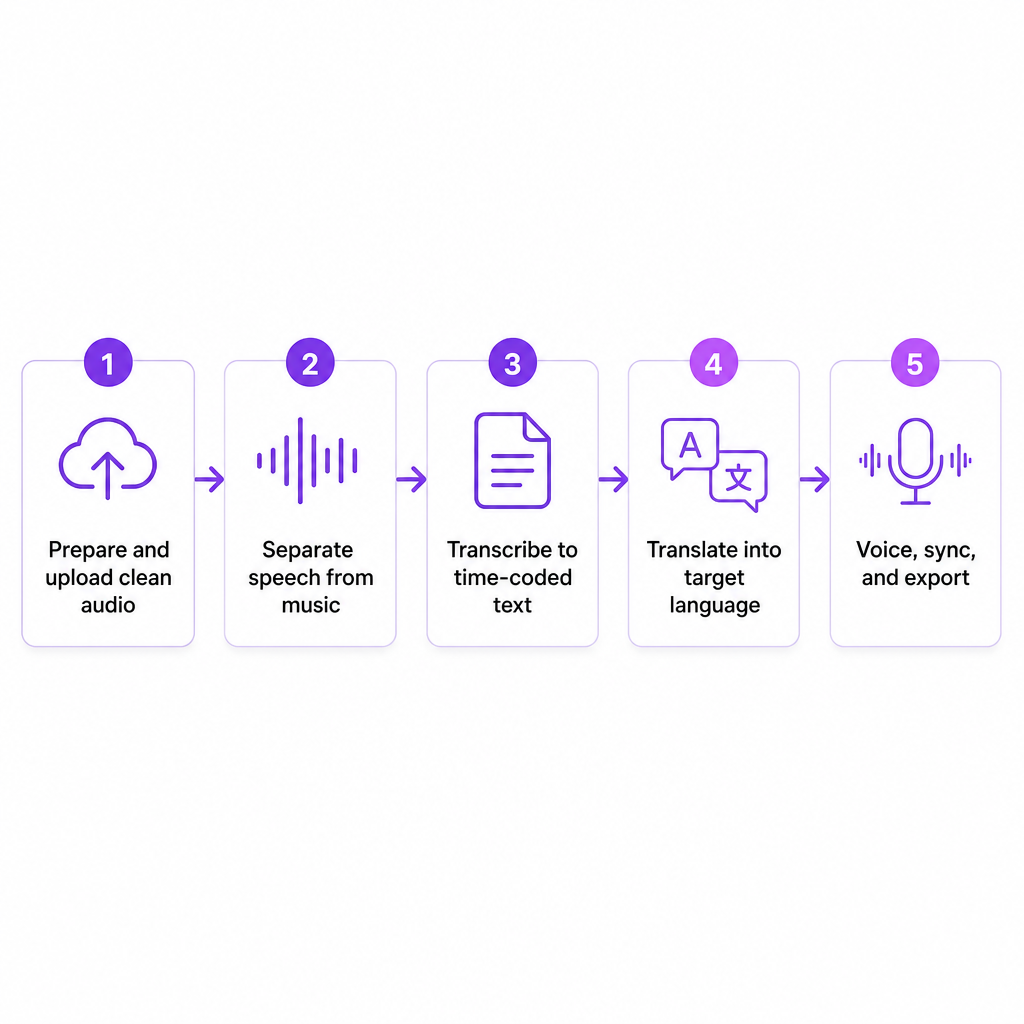
To praktyczna sekwencja, której używamy, aby przeprowadzić odcinek od surowego audio do gotowej, zdubbingowanej wersji. Każdy krok zasila kolejny, więc powstrzymaj się od pokusy pomijania etapów.
Krok 1: Wybierz format lokalizacji
Zdecyduj, co właściwie dostarczasz. Istnieją trzy sensowne opcje: w pełni zdubbingowane odcinki z nowymi ścieżkami audio, jedynie przetłumaczone transkrypcje i napisy, albo zarówno zdubbingowane audio, jak i przetłumaczony tekst. W przypadku YouTube i podcastów wideo dostarczenie obu daje słuchaczom i widzom wersję dopasowaną do sposobu, w jaki konsumują treści. Nasze narzędzie AI Dubbing obsługuje w pełni udźwiękowioną ścieżkę, natomiast Speech to Text daje edytowalne transkrypcje i napisy.
Krok 2: Przygotuj i prześlij odcinek
Eksportuj finalny miks jako pojedynczy plik, a następnie utwórz nowy projekt AI Dubbing z panelu. Prześlij audio bezpośrednio lub, jeśli odcinek jest już na YouTube, wklej link i pozwól systemowi go pobrać. Dodaj tytuł odcinka, język oryginalny oraz wszelkie notatki o mówcach czy segmentach. Poprawne zidentyfikowanie języka źródłowego ma większe znaczenie, niż się wydaje, ponieważ pomaga systemowi zoptymalizować zarówno dokładność transkrypcji, jak i tłumaczenia.
Krok 3: Oddziel mowę od dźwięku tła
Podcasty rzadko są suchym głosem. Muzyka intro, podkłady i dźwięk otoczenia przenikają do miksu, a dubbingowanie po nich tworzy mętny rezultat. Nasz Speech Separator izoluje dialog od muzyki i efektów, dzięki czemu nowa ścieżka głosowa nakłada się czysto na wierzch. Włącz krok separacji, jeśli nie jest jeszcze aktywny, a następnie odtwórz wyizolowaną mowę, aby potwierdzić, że głosy są wyraźne. Jeśli oryginalny miks jest wyjątkowo zaszumiony, lekko go zremasteruj i prześlij ponownie przed kontynuacją.
Krok 4: Transkrybuj za pomocą Speech to Text
Dokładna transkrypcja jest kręgosłupem całego procesu. Nasze narzędzie Speech to Text zamienia treść mówioną w tekst z kodami czasowymi zsynchronizowany z oryginalną osią czasu, który możesz przeglądać i edytować w edytorze projektu. Zrób tutaj trzy rzeczy: przypisz etykiety mówców prowadzącemu, współprowadzącym i gościom; popraw źle usłyszane słowa, nazwy marek i terminy techniczne; oraz usuń wypełniacze, które nic nie wnoszą w tłumaczeniu. To także moment na dostosowanie treści, które mogą nie pasować do niektórych rynków. Czyste transkrypcje na tym etapie zapobiegają narastaniu błędów później.
Krok 5: Przetłumacz na język docelowy
Mając czystą transkrypcję, potok tłumaczy skrypt z kodami czasowymi, zachowując kontekst, timing i intencję zgodne z oryginalnym audio. Wybierz języki docelowe, a następnie przejrzyj tłumaczenie maszynowe pod kątem tonu, idiomów i odniesień specyficznych kulturowo. Żarty i metafory rzadko przetrwają dosłowne tłumaczenie, więc dostosuj je tutaj. Jeśli język ma warianty regionalne, zdecyduj z góry, czy celujesz na przykład w hiszpański latynoamerykański czy europejski, i trzymaj się tego wyboru konsekwentnie w każdym odcinku.
Krok 6: Wybierz głosy i wygeneruj zlokalizowaną mowę
Nasz silnik Text to Speech zamienia przetłumaczony skrypt w realistyczne audio z biblioteki ponad 300 głosów obejmujących różne płcie, style i języki, a klonowanie głosu może odtworzyć wokalną tożsamość oryginalnego prowadzącego w nowym języku. Dla każdego oznaczonego mówcy wybierz głos pasujący do jego wieku, płci, energii i wizerunku marki. W przypadku programów prowadzonych przez jedną osobę sklonowanie głosu prowadzącego sprawia, że zdubbingowany odcinek pozostaje znajomy dla istniejących słuchaczy. Wygeneruj audio wewnątrz potoku dubbingu; system synchronizuje nową mowę z oryginalną osią czasu, zachowując tempo i granice segmentów. Następnie przesłuchaj całość, wygeneruj ponownie wszelkie niezręczne kwestie i zamień głosy, które nie pasują do marki.
Krok 7: Przeprowadź finalną kontrolę jakości i eksportuj
Przed publikacją zrób pełny przegląd. Zweryfikuj, że kluczowe komunikaty, wezwania do działania, zastrzeżenia, wypowiadane adresy URL i uchwyty w mediach społecznościowych są poprawne i dobrze wymawiane. Potwierdź, że głośność jest spójna, muzyka nie zagłusza mowy, a separacja nie pozostawiła echa ani artefaktów. Eksportuj w formacie i bitrate wymaganym przez twojego hosta. Jeśli tworzysz odcinki wideo i potrzebujesz zlokalizowanego tekstu ekranowego lub grafik, nasze narzędzie Image to Video pomaga zaktualizować materiały wizualne. Na koniec opublikuj każdy język jako osobny kanał lub playlistę i wyraźnie oznacz język w tytułach i opisach, aby słuchacze subskrybowali właściwą wersję.
Częste błędy i jak je naprawić
Większość problemów z dubbingiem nie jest egzotyczna. Skupiają się wokół kilku przewidywalnych punktów awarii, a każdy ma proste rozwiązanie.
- Słabe audio źródłowe. Zaszumione, nadmiernie skompresowane lub przesterowane nagrania dają słabe transkrypcje i niezręczne zdubbingowane audio. Oczyść i znormalizuj oryginalny miks, użyj separacji mowy i zastosuj lekką redukcję szumów w edytorze przed przesłaniem.
- Pomijanie czyszczenia transkrypcji. Bezkrytyczne ufanie automatycznej transkrypcji wprowadza błędy w nazwach, akronimach i żargonie, które następnie są błędnie tłumaczone. Zawsze edytuj transkrypcję przed tłumaczeniem, zwłaszcza w przypadku niszowych lub markowych terminów.
- Ignorowanie kontekstu kulturowego. Dosłowne tłumaczenia żartów i idiomów mogą brzmieć dziwnie lub źle wypaść. Adaptuj lub zastępuj odniesienia specyficzne kulturowo podczas przeglądu, a w razie potrzeby wyjaśniaj, zamiast tłumaczyć słowo w słowo.
- Niespójne udźwiękowienie mówców. Losowo przypisane głosy sprawiają, że goście i współprowadzący zlewają się ze sobą. Używaj etykiet mówców, stałych przypisań głosów i klonowania tam, gdzie to właściwe, aby zachować spójną obsadę w odcinkach.
- Niedocenianie kontroli jakości. Publikowanie bez pełnego przesłuchania pozostawia w twoim kanale usterki czasowe i błędy w wymowie. Przeprowadź kompletny przegląd audio QA w każdym języku i zaangażuj native speakera do kluczowych odcinków.
- Przeoczenie praw. Redystrybucja przetłumaczonego audio bez uregulowania praw do treści mówionej, wypowiedzi gości i muzyki może powodować problemy z prawami autorskimi. Potwierdź prawa dla każdego rynku przed publikacją.
Samodzielna praca kontra recenzja native speakera: gdzie postawić granicę
Nasz proces oparty na AI jest zbudowany tak, aby większość podcasterów mogła tłumaczyć i dubbingować odcinki samodzielnie, bez wynajmowania zespołu studyjnego. W przypadku programów rozrywkowych, komentatorskich i o ogólnym zainteresowaniu, a także w przypadku odcinków edukacyjnych, gdzie drobne niedoskonałości są dopuszczalne, samodzielny twórca przechodzący przez powyższe siedem kroków może samodzielnie wypuszczać dopracowane wielojęzyczne odcinki. Programy tworzone przez twórców na YouTube, Spotify i Apple Podcasts, gdzie zasięg i szybkość liczą się bardziej niż doskonałość na poziomie transmisji, naturalnie pasują do w pełni samoobsługowej ścieżki.
Rachunek zmienia się, gdy precyzja niesie realne konsekwencje. Zaangażuj profesjonalną lub natywną recenzję, gdy odcinki dotyczą tematów prawnych, medycznych, finansowych lub regulacyjnych, gdzie sformułowania muszą być dokładne; gdy twoja marka działa w ściśle regulowanych branżach lub regionach ze surowymi zasadami reklamowymi; lub gdy lokalizujesz flagowe treści, takie jak ogłoszenia premier, ważne kampanie czy szkolenia korporacyjne, gdzie ton i niuans są decydujące. Nawet wtedy zachowujesz efektywność: użyj platformy do transkrypcji, wstępnego tłumaczenia, generowania głosu i timingu, a następnie pozwól recenzentowi dopracować sformułowania i przeprowadzić finalne QA przed publikacją.
Najczęściej zadawane pytania
Ile czasu zajmuje przetłumaczenie i zdubbingowanie 60-minutowego odcinka?
Gdy oswoisz się z narzędziami, spodziewaj się mniej niż godziny praktycznej pracy na odcinek, plus zautomatyzowany czas przetwarzania na transkrypcję, tłumaczenie i generowanie głosu.
Ile kosztuje przetłumaczenie podcastu za pomocą dubbingu AI?
Praktyczne ceny dubbingu AI zwykle wahają się od około 0,20 do 7 USD za gotową minutę, w zależności od tego, ile minut przetwarzasz, ile języków dostarczasz i ile kontroli jakości dodajesz. Nasza platforma używa kredytów, więc twój efektywny koszt za minutę zależy od planu i użycia. Nasze zestawienie kosztu dubbingu AI za minutę omawia czynniki wpływające na cenę.
Czy mogę zachować głos oryginalnego prowadzącego w nowym języku?
Tak. Text to Speech i klonowanie głosu współpracują ze sobą, dzięki czemu możesz zachować wokalną tożsamość prowadzącego, jednocześnie ponownie udźwiękawiając odcinki w innych językach.
Czy mogę przetłumaczyć tylko część odcinka?
Możesz zdubbingować cały odcinek lub tylko wybrane segmenty, takie jak intro i outro. Zarządzanie tym w edytorze projektu pozwala skupić się na sekcjach, które najbardziej liczą się dla wielojęzycznego brandingu.
Czy potrzebuję osobnego kanału dla każdego języka?
Utrzymywanie odrębnych kanałów językowych lub playlist to najlepsza praktyka, aby słuchacze mogli subskrybować preferowaną wersję w różnych aplikacjach podcastowych i na YouTube.