Jak transkrybować wideo na tekst za pomocą AI w kilka minut
Masz przed sobą 45-minutowy wywiad, który potrzebuje transkrypcji do jutra. Freelancer, którego używałeś w poprzednim kwartale, wycenił pracę na 90 dolarów z trzydniowym czasem realizacji. Drugą opcją jest zrobienie tego samemu, co oznacza spędzenie całego popołudnia wpatrując się w falę dźwiękową, cofając się co pięć sekund i mając do tego wszystkiego dość. Istnieje trzecia ścieżka, która nie istniała dla większości twórców trzy lata temu: sztuczna inteligencja do transkrypcji wideo na tekst, która konwertuje twój plik w czasie, który zajmuje zaparze kawy.
Ten przewodnik wyjaśnia, co naprawdę dzieje się wewnątrz tych silników, jak wybrać właściwy format wyjściowy za pierwszym razem, proces krok po kroku od surowego pliku do wypolerowanej transkrypcji oraz przepływy pracy, które zamieniają jedną transkrypcję na pięć kanałów dystrybucji.
Spis treści
- Rzeczywisty koszt ręcznej transkrypcji wideo (i dlaczego większość twórców wciąż robi to źle)
- Jak naprawdę działają silniki AI do konwersji wideo na tekst w 2025 roku
- Wybór właściwego formatu wyjściowego przed kliknięciem „Transkrybuj"
- Przewodnik 6-krokowy — od surowego pliku wideo do wypolerowanej transkrypcji w mniej niż 5 minut
- Dokładność zależy od jakości audio, a nie od wyboru narzędzia — oto jak to udowodnić
- Co zrobić z transkrypcją, gdy ją już masz — pięć przepływów pracy o wysokiej wydajności
- Twoja pierwsza transkrypcja — lista kontrolna przed lotem, podczas lotu i po locie
Rzeczywisty koszt ręcznej transkrypcji wideo (i dlaczego większość twórców wciąż robi to źle)
Zacznij od matematyki czasu. Wyszkolony człowiek zajmujący się transkrypcją średnio spędza 4–6 godzin pracy na godzinę gotowego wideo, według dostawcy usług transkrypcji SpeakWrite. Dla niedoświadczonego twórcy transkrybującego własne nagrania realistyczne tempo to bliżej sześć minut pracy na każdą minutę wideo — co oznacza, że 45-minutowy wywiad pochłania cały dzień pracy, gdy weźmiesz pod uwagę przewijanie, sprawdzanie faktów i nieuniknione momenty „czekaj, co właśnie powiedział?".
AI kompresuje ten sam 45-minutowy wywiad do mniej więcej 5 minut czasu przetwarzania, zgodnie z wynikami opublikowanymi przez TrulyScribe. To nie jest 10% usprawnienie. To nie jest nawet 10-krotne usprawnienie. To zmiana kategorii w tym, jak transkrypcja pasuje do twojego przepływu pracy.
Teraz oblicz matematykę dolara. Freelancerska transkrypcja na rynku amerykańskim wynosi 1,50–3,00 dolara za minutę audio, plus 24–72 godziny realizacji. Miesięczna operacja podcast'u wydająca cztery 60-minutowe odcinki w środku tego zakresu kosztuje około 480 dolarów miesięcznie, zanim dojdzie do dodatkowych opłat za edycję. Tygodniowy kanał YouTube z 30-minutowym show'em kosztuje około 180–360 dolarów miesięcznie. W ciągu roku to 2000–5800 dolarów wydanych na tekst, który AI może teraz generować za ułamki dolara za godzinę.
Koszt w dolarach to oczywisty problem. Ukryty koszt jest gorszy.
Kiedy freelancer transkrybuje twoją zawartość, nie wie, że „Cura Nettis" powinno być „Kubernetes". Nie wie, że twoja dyrektor finansowa ma na imię Aoife, a nie Eva. Nie wie, że twój produkt uruchomił się jako „DubKit" i zmienił markę na „DubFlow" osiem miesięcy temu. Każdy termin specyficzny dla domeny — każde imię, każdy akronim, każda wewnętrzna nazwa kodowa — wymaga przejścia korektury z twojej strony w każdym razie. Płacisz 90 dolarów za szkic, który wciąż wymaga twojego spojrzenia na każdej linii.
Pytanie nie brzmi, czy transkrybować swoje wideo — pytanie brzmi, czy możesz sobie pozwolić na podatek czasowy sześciu godzin, gdy 5-minutowe przejście AI dostaje cię 95 procent w stronę celu.
Głębsza pułapka to sam przepływ pracy. Większość twórców opóźnia ręczną transkrypcję, ponieważ wydaje się opcjonalna. Napisy mogą czekać. Notatki do odcinka mogą czekać. Repurposing do bloga może czekać. Rezultat: archiwa wideo stają się niezbywalne. Zespół dysponujący 200 godzinami nagrań Zoom nie ma możliwości odpowiedzenia „kiedy rozmawialiśmy o zmianie cen Q3?" To archiwum nie jest aset — to stóg siana, w którym nigdy będziesz szukać.
Ręczna transkrypcja również psuje się strukturalnie, gdy twoja produkcja rośnie. Twórca publikujący dwa wideo tygodniowo może być transkrybować jedno z nich, źle, w niedzielę wieczorem. Zespół publikujący dwadzieścia wideo miesięcznie nie może. Rezygnują całkowicie i wydają wideo z auto-napisami, które nikt nie przejrzał. Wyszukiwanie traci. Dostępność traci. Lokalizacja jest poza stołem.
Transkrypcja AI nie tylko zwalnia koszt czasu i pieniędzy. Zmienia to, które przepływy pracy są w ogóle możliwe. Gdy 30-minutowe wideo staje się w pełni opatrzone znacznikami czasu transkrypcją w pięć minut za mniej niż dolara, przestajesz myśleć o transkrypcji jako o wydatku na wideo i zaczniesz traktować ją jako domyślny pierwszy krok po eksporcie. Następnie napisy. Następnie szkice bloga. Następnie tłumaczenie. Archiwum staje się przeszukiwalne. Matematyka nie jest już bliska.
Obrót jest prosty: transkrypcja AI dojrzała do punktu, w którym jedynym powodem, aby w dalszym ciągu płacić podatek czasowy, jest inercja. Przepływ pracy sztucznej inteligencji do transkrypcji wideo na tekst, który dostarcza dokładność 95%+ na czystym audio, w pięć minut, za centy za godzinę wideo — i pozwala ci wypolerować rezultat w kolejne dziesięć minut — przekroczył linię od „interesującego narzędzia" do „domyślnej infrastruktury" dla każdego, kto publikuje więcej niż dwa wideo miesięcznie.
Reszta tego przewodnika zakłada, że podjąłeś tę decyzję i teraz chcesz naprawdę dobrze używać zamianę mowy na tekst, a nie tylko na nią wskazać i mieć nadzieję.
Jak naprawdę działają silniki AI do konwersji wideo na tekst w 2025 roku
Nie musisz czytać artykułu badawczego, aby dobrze używać transkrypcji AI, ale zrozumienie potoku informuje cię, które pokrętła mają znaczenie i które skargi dotyczą naprawdę audio, a nie algorytmów.
Nowoczesny silnik transkrypcji AI przenosi twój plik przez pięć odrębnych etapów:
- Ekstrakcja audio i normalizacja. Zanim cokolwiek innego, system przejmuje ścieżkę audio z kontenera (MP4, MOV, WebM) i normalizuje głośność, aby sekcje ciche i głośne siedziały na porównywalnych poziomach. Im czystsze to wejście, tym lepiej wszystko w dół. Audio poniżej ~65 dB stosunek sygnału do szumu wymaga ciężkiego wstępnego przetwarzania, podczas gdy transkrypcja profesjonalnej klasy broadcast oczekuje ≥85 dB SNR, zgodnie z Podręcznikiem inżynierskim Narodowego Stowarzyszenia Nadawców.
- Rozpoznawanie mowy (wnioskowanie ASR). Model akustyczny sieci neuronowej — zazwyczaj wariant transformatora Whisper, NVIDIA Canary lub równoważny system własnościowy — konwertuje przebiegi audio w fonemy, a fonemy w słowa. Współczynnik błędu słowa na studiu audio wynosi 3–5%, ale wzrasta do 15–30% na hałaśliwych nagraniach polowych, zgodnie z wynikami opublikowanymi przez WhisperBot. To etap, któremu przypisuje się winę za „niedokładną transkrypcję AI", gdy rzeczywisty problem był prawie zawsze wcześniej w procesie.
- Identyfikacja języka i przełączanie kodu. Nowoczesne silniki automatycznie wykrywają język z pierwszych 5–15 sekund audio i potrafią obsługiwać przełączanie kodu w środku zdania w ponad 60 językach źródłowych. Dokładność spada o 15–30% w przypadku mówiących nieniedźwiędzi i terminologii technicznej, zgodnie z ocenami NIST rozpoznawania mowy — dlatego ręczne ustawienie języka pokonuje ufanie automatycznym wykrywaniem, gdy wiesz źródło.
- Identyfikacja mówcy (warstwa „kto powiedział co"). Oddzielny model klastruje segmenty audio wg tożsamości mówcy. W kontrolowanych środowiskach z dwoma mówcami dokładność osiąga 78–85%. W naturalnej rozmowie z częstym zmianą tur i krzyżowymi wypowiedziami spada do 45–60%, zgodnie z wynikami NVIDIA Canary-1B, do których odnosi się wideo badawcze Latenode. Identyfikacja mówcy to etap, który większość potoków traktuje jako niedopatrzenie, i tu wielogłosowa zawartość najczęściej upadła.
- Wyrównanie znacznika czasu i przetwarzanie końcowe. Każde słowo otrzymuje znacznik czasu na poziomie milisekundy, co umożliwia transkrypcje interaktywne, napisy dokładne do klatki i wyszukiwanie na poziomie słowa. Profesjonalne standardy broadcast wymagają dryfu timecodu poniżej 150 ms na godzinę, zgodnie z SMPTE, a silniki wysokiej jakości pozostają dobrze wewnątrz tej tolerancji.

Oto dlaczego to jest teraz pięciominutowe zadanie zamiast pięciogodzinnego: wnioskowanie GPU w chmurze na A100s i H100s przetwarza audio z prędkością 50–100x szybciej niż rzeczywisty czas. Powodem, dla którego transkrypcja AI na poziomie konsumenta nie była opłacalna w 2018 roku, nie były złe algorytmy — naukowcy mieli przyzwoite modele akustyczne dziesięć lat temu. Wąskim gardłem było to, że nikt nie mógł sobie pozwolić na wynajęcie mocy obliczeniowej. Dziś koszt obliczeniowy na minutę dla wnioskowania ASR wynosi ułamki centa, co jest powodem, dla którego platformy oparte na kredytach mogą pobierać jednocyfrowe dolary za godzinę konwersji wideo na tekst i nadal działać zrównoważenie. Potok silnika nie zmienił się z dnia na dzień. Ekonomika wokół niego się zmieniła, i to jest to, co ostatecznie wpychało transkrypcję AI do domyślnego statusu narzędzia.
Wybór właściwego formatu wyjściowego przed kliknięciem „Transkrybuj"
Wybierz format wyjściowy przed przesłaniem, nie po. Ponowne uruchomienie 90-minutowego pliku, ponieważ wyeksportowałeś TXT, gdy potrzebowałeś SRT, to 20-minutowy błąd, który nie musi się zdarzyć.
| Format | Najlepszy przypadek użycia | Szczegół znacznika czasu | Długość linii | Gdzie się łączy |
|---|---|---|---|---|
| Zwykły tekst (TXT) | Posty na blogu, baza wiedzy, wejście do podsumowania AI | Brak | Bez limitu | Notion, Google Docs, wklejanie CMS |
| SRT (SubRip) | YouTube, napisy do wideo społeczności | Dokładne do klatki, HH:MM:SS,ms | 42 znaki/linia, 2 linie maks. | YouTube Studio, Premiere, DaVinci |
| WebVTT (.vtt) | Wideo HTML5, stylizowane napisy | Dokładne do klatki + stylizacja CSS | 42 znaki/linia rekomendowane | JW Player, Video.js, odtwarzacze internetowe |
| Tekst z znacznikiem czasu | Notatki do odcinka podcast'u, linki nawigacyjne | Na akapit lub na mówcę | Bez limitu | Hosty podcast'u, osadzenia bloga |
| JSON | Przepływy pracy API, indeksowanie wyszukiwania, aplikacje niestandardowe | Znaczniki czasu na poziomie słowa | N/A (strukturyzowane) | Potoki dla programistów, bazy danych |
Ograniczenie 42 znaków na linię, dwa linie na klatkę w SRT nie jest arbitralne — to specyfikacja SubRip i powód, dla którego platformy odrzucają pliki SRT, które ją naruszają. Warstwa stylizacji CSS WebVTT jest zdefiniowana w specyfikacji W3C WebVTT, a szersze formatowanie tekstu czasowanego dla przesyłania strumieniowego podlega ISO/IEC 23009-1.
Teraz konsekwencje wybrania źle. Trzy przepływy pracy, trzy formaty, trzy różne decyzje:
Twórca YouTube lokalizujący globalnie powinien eksportować SRT najpierw. YouTube Studio bezpośrednio przyjmuje SRT dla napisów, a ten sam plik SRT staje się wejściem dla tłumaczonego generowania napisów i dokumentem źródła prawdy dla każdego tłumaczonego narzędu do napisów i lekarzy pracujących nagrań głosu, które produkujesz dalej. Wybierz TXT tutaj i wyrzuciłeś znaczniki czasu; będziesz albo ponownie transkrybować albo ręcznie wznowić czas każdej linii.
Podcast'er B2B budujący notatki do odcinków powinien eksportować tekst z znacznikiem czasu. Słuchacze klikają znaczniki czasu, aby przejść do tematów. Konstruktory notatek pokazów takie jak Descript, Castos i Podpage analizują format natywnie. SRT byłoby technicznie pracować, ale jego ograniczenia długości linii walczą z naturalnym rytmem akapitu notatek podcast'u, i spędzałbyś czas usuwając nawiasowe kody czasu z tekstu.
Programista budujący narzędzie do wyszukiwania wideo powinien eksportować JSON ze znacznikami czasu na poziomie słowa. Teraz każde słowo kluczowe w transkrypcji może prowadzić do dokładnej milisekundy w wideo. Użytkownik szuka „strategii cenowej" i wynik przeskakuje odtwarzacz do sekundy 1847. To jest niemożliwe z dokładnością na poziomie SRT, gdzie znaczniki czasu oznaczają tylko bloki napisów, nie pojedyncze słowa.
Jeszcze jedna kwestia, jeśli twojej ostatecznym celem jest wielojęzyczne zasięgi: plik SRT, który generujesz dziś, staje się dokumentem źródła prawdy dla jutrzejszych tłumaczonych napisów i pracowników dubbingu. Wybranie SRT teraz oznacza, że potok lokalizacji rozpoczyna się, gdy jesteś gotowy — nie później, gdy musisz cofnąć się, aby wygenerować znaczniki czasu, które pominąłeś.
Przewodnik 6-krokowy — od surowego pliku wideo do wypolerowanej transkrypcji w mniej niż 5 minut
To ścieżka kliknięcia od początku do końca. Całkowity czas upłynął dla 30-minutowego wideo: około 15 minut łącznie z przejściem edycji.
Krok 1 — Przygotuj swój plik (90 sekund)
Najpierw potwierdź kompatybilność formatu: MP4, MOV, WebM, M4A, WAV i MP3 są uniwersalnie obsługiwane na wszystkich głównych platformach. Większość silników ogranicza przesłania indywidualne do 1–2 GB lub 4 godzin czasu trwania; podziel dłuższe wideo, zanim zaczniesz. Jeśli twoje audio jest hałaśliwe — wywiady nagrywane telefonem, mikrofony w sali konferencyjnej, nagrania na świeżym powietrzu z wiatrem lub ruchem — najpierw uruchom je przez separator mowy, aby wyodrębnić głos z szumu tła. Ten pojedynczy krok przetwarzania wstępnego może obniżyć współczynnik błędu słowa z 18% do poniżej 5%, co jest różnicą między transkrypcją, którą wypolerują w dziesięć minut, a taką, na którą poświęcisz godzinę naprawiania.
Krok 2 — Przesłaj i wybierz język (30 sekund)
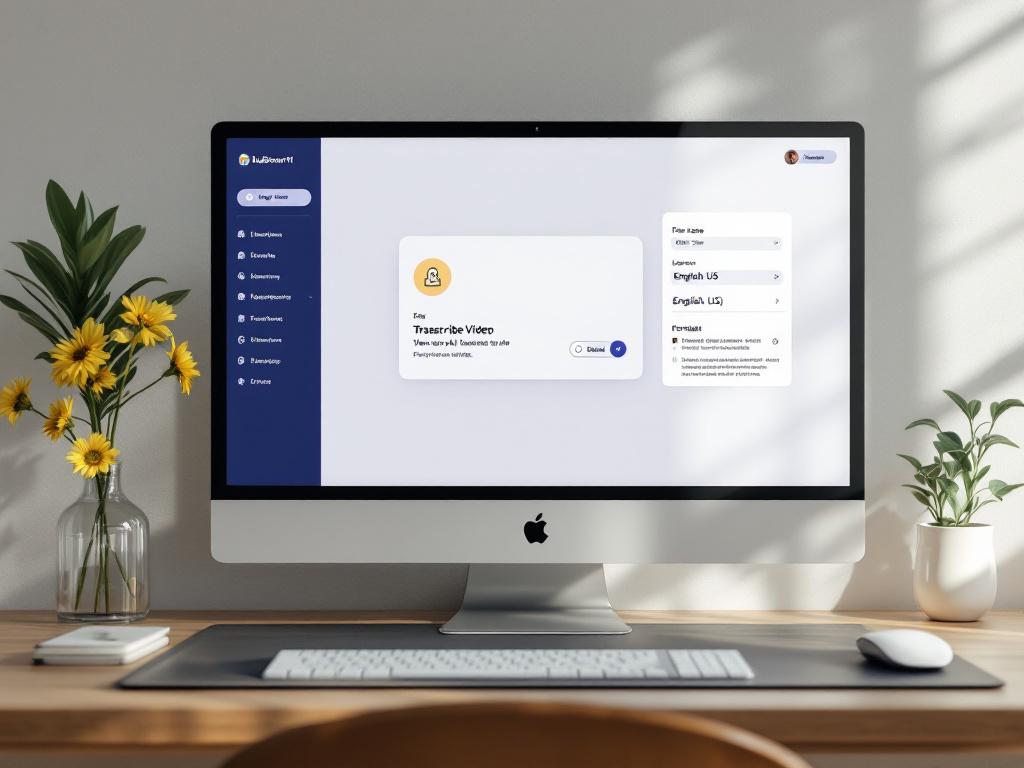
Przeciągnij plik do strefy przesyłania platformy. Jawnie ustaw język źródłowy, gdy go znasz, zamiast polegać na automatycznym wykrywaniu. Ręczny wybór unika błędów identyfikacji języka w pierwszych 10 sekundach audio — co jest dokładnie tam, gdzie auto-detect podejmuje decyzję, i dokładnie tam, gdzie intro, muzyka i cisza zwykle żyją.
Krok 3 — Wybierz format wyjściowy i rozpocznij przetwarzanie (15 sekund)
Odwołaj się do tabeli formatów z poprzedniej sekcji: TXT dla blogów, SRT dla napisów, tekst z czasem dla podcast'ów, JSON dla programistów. Włącz identyfikację mówcy dla każdego wideo z więcej niż jednym głosem. Kliknij transkrybuj.
Krok 4 — Produktywnie wykorzystaj okno przetwarzania (3–5 minut)
30-minutowe wideo zazwyczaj przetwarza się w 3–5 minut na nowoczesnej infrastrukturze chmurowej. Nie siedź patrząc na pasek postępu. Opracuj swój opis YouTube'a, napisz nagłówek bloga, umieść w kolejce następne wideo do przesłania lub odpowiadaj na e-maile. Największy zysk przepływu pracy z transkrypcji AI nie jest sama transkrypcja — to jest to, że możesz multitaskować, podczas gdy działa. Ręczna transkrypcja blokuje twoją uwagę na godziny. Transkrypcja AI zwraca ją w mniej niż pięć minut.
Krok 5 — Przejrzyj pierwszy przebieg i napraw przewidywalne błędy (8–10 minut)
AI zazwyczaj osiąga dokładność 95–99% na czystym audio, zgodnie z wynikami opublikowanymi przez TechSmith, ale porażki skupiają się przewidywalnie:
- Nazwy własne — ostatnie imię twojego gościa, nazwa twojego produktu, nazwy miast o niezwykłych pisowniach.
- Żargon techniczny — Kubernetes, OAuth, FFmpeg, cokolwiek specyficznego dla domeny.
- Homofony — their/there/they're, to/two/too, szczególnie w mowie potocznej, gdzie prosody jest jedynym rozróżnikiem.
- Krzyżujące się wypowiedzi — gdy dwaj mówcy przerywaję sobie nawzajem, a ASR musi zgadnąć, który głos podążać.
Użyj funkcji wyszukaj i zamień edytora, aby naprawić powtarzające się błędy w jednym przejściu zamiast poprawiać każdą instancję indywidualnie. Jeśli imię gościa to „Siobhan" a transkrypcja napisała „Shavon" jedenaście razy, to jeden replace'u, a nie jedenaście ręcznych poprawek. Pełne przejście edycji zazwyczaj wynosi 8–12 minut na godzinę wideo dla czystego audio — uzywaj dziesięć minut dla 30-minutowego pliku.
Krok 6 — Eksportuj i kieruj do twojego przepływu pracy
Pobierz plik w wybranym formacie. Prześlij SRT bezpośrednio do YouTube Studio dla błyskawicznych napisów. Wklej TXT do twojego CMS jako szkic bloga. Wyślij JSON do twojego indeksu wyszukiwania lub przegotuj to przez przepływ pracy programowego TTS do przetwarzania wsadowego. Transkrypcja jest teraz zasobem ze stałym domem — przeszukiwalnym, wielokrotnym użytecznym, wielokrotnie użytkowym — nie tymczasowym plikiem gnijącym w folderze pobierania. To pojedyncze przesunięcie, od „transkrypcji jako jednorazowego zadania" do „transkrypcji jako trwałego zasobu", jest tym, co sprawia, że sztuczna inteligencja do transkrypcji wideo na tekst warta jest zintegrowania jako domyślna infrastruktura, a nie jednorazowy eksperyment.
Dokładność zależy od jakości audio, a nie od wyboru narzędzia — oto jak to udowodnić
Większość skarg „to narzędzie AI jest niedokładne" to naprawdę skargi „moje audio było złe" w przebraniu. Poprawka prawie nigdy nie zmienia narzędzi. Poprawka to naprawienie audio.
Większość skarg o niedokładności transkrypcji AI to naprawdę skargi o jakości audio ubrane w kostium.
Dr Jane Chen, kierowniczka badań technologii mowy na Uniwersytecie Carnegie Mellon, powiedziała to wprost w MIT Technology Review: „Fundamentalnym ograniczeniem obecnej transkrypcji AI nie jest sama technologia, ale niedopasowanie między oczekiwaniami użytkownika a rzeczywistością audio. Większość skarg dotyczących dokładności wynika ze słabego audio źródłowego, a nie z błędów transkrypcji."
To powiedziawszy, jakość audio nie jest jedyną zmienną. Istnieje trudniejszy kontrargument warty poznania, zanim założysz, że czysta nagranie gwarantuje czysty rezultat. Badania lingwisty ze Stanforda, dr Lisy Kim (Stanford News, 2024) pokazują, że transkrypcja AI systematycznie zniekształca niestandard akcenty i dialekty — co oznacza, że jeśli twoja zawartość zawiera mówców z akcentami regionalnymi, AAVE, czy nierodzemymi mówiącymi po angielsku, powinieneś spodziewać się wyższego współczynnika błędu, który nie jest twojej winy i nie można go naprawić po prostu zmieniając platformy. Równoległy znajdujący się w Journal of the American Medical Informatics Association dokumentuje transkrypcję AI systematycznie pomijającą lub zniekształcającą terminologię medyczną z potencjalnie niebezpiecznym konsekwencjami w ustawieniach opieki zdrowotnej — ostrzeżenie, które dotyczy, w mniejszym wymiarze, każdej zawartości technicznej lub specjalistycznej.
Same roszczenia dokładności dostawcy zasługują na sceptycyzm. Komunikat Federalnej Komisji Handlu z 2023 roku ostrzegł, że roszczenia „99% dokładności" są zazwyczaj oparte na warunkach laboratoryjnych — jeden mówca, mikrofon studyjny, brak szumu tła, popularne słownictwo — i nie odzwierciedlają scenariusze użycia w świecie rzeczywistym. Dr Marcus Rodriguez, IEEE Senior Member, poczynił pokrewny punkt w IEEE Spectrum o identyfikacji mówcy są traktowani jako niedopatrzenie w większości potoków, co tworzy kaskadowe błędy w zawartości wielomówcy, nawet gdy podstawowe ASR jest doskonałe.

Praktyczne wyjście: możesz przewidzieć jakość transkrypcji przed kiedykolwiek przesłaniu, i możesz naprawić większość tego na etapie audio. Oto lista kontrolna przed transkrypcją warta uruchomienia w każdym pliku, na którym ci zależy.
- Zmierz swój pokój, zanim zaczniesz nagrywać. Jeśli możesz usłyszeć klimatyzator, lodówkę lub ruch uliczny, AI również może. Dążenie do słyszalnego piętra szumu poniżej 65 dB SNR; transkrypcja profesjonalnej klasy oczekuje ≥85 dB SNR zgodnie ze standardami NAB.
- Użyj mikrofonu lavalier lub dynamicznego, a nie laptopa. Wbudowane mikrofony laptopa zbierają hałas klawiatury, szum wentylatora i odbicia z powierzchni biurka. Nawet 40-dolarowy lav obniża twój WER o mniej więcej połowę na tej samej zawartości źródłowej.
- Nagraj każdego mówcę na oddzielnej ścieżce, gdy to możliwe. Nagranie dwu-ścieżkowe pozwala silnikowi czysty diaryzuj, ponieważ identyfikacja mówcy staje się problemem routingu zamiast problemu klastrowania. Jeden mikrofon rejestrujący krzyżujące się wypowiedzi spada identyfikacja mówcy z ~85% do ~55%.
- Wstępnie izoluj głos z muzyki tła lub szumu. Jeśli źródło ma muzykę, szum otoczenia lub wiele nakładających się głosów, najpierw uruchom przejście izolacji audio. Ten pojedynczy krok przetwarzania wstępnego jest często różnicą między dokładnością 96% a 78% na tym samym nagraniu bazowym.
- Zbuduj słownik nazw własnych i żargonu. Poświęć 60 sekund wpisując nazwy, terminy produktu i akronimy używane w wideo. Wiele platform akceptuje plik słownictwa niestandardowego; jeśli twoja nie, przechowuj listę jako arkusz zmienności wyszukaj-zamień dla post-pierwszego przejścia.
- Testuj klipem 60-sekundowym, zanim transkrybować plik 90-minutowy. Jeśli testowy klip wysiada poniżej 90% dokładności, napraw audio, zanim zmarnujesz kredyty transkrybując pełny plik. Pięć minut na test zapobiega godzinie, którą spędzasz zmagając się ze złym rezultatem.
- Audytowe znaczniki czasu na 25%, 50% i 75% markami. Dryfowaniu czasowemu jest rzadkie na nowoczesnych silnikach, ale katastrofalne, gdy się zdarzy. Dryfowanie 30-sekund w 60-minutowym wideo zsynchronizuje twój cały plik napisu i zmusi do pełnego re-eksportu.
- Dla mówiących nieniedźwiędzi po angielsku, oczekuj dokładności 12–18% niższej i budżetu czasu edycji w odpowiednich. Jest to udokumentowana systemowa luka, zgodnie z badaniem MIT CSAIL na zakres mowy i zmiana akcentu. Zaplanuj dodatkowe przejście edycji zamiast być zaskoczonym przez to.
Uruchom tę listę kontrolną raz lub dwa razy, a staje się ona mięśniem pamięciowym. Twórcy, którzy narzekają na dokładność transkrypcji wideo głośniej, zwykle pomijają elementy 1, 2 i 4. Twórcy, którzy cicho uzyskują czyste transkrypcje za każdym razem, nie używają lepszego narzędzia — karmiią to samo narzędzie lepszym audio.
Co zrobić z transkrypcją, gdy ją już masz — pięć przepływów pracy o wysokiej wydajności
Transkrypcja nie jest metą. To linia startowa dla pięciu różnych kanałów dystrybucji, każdy z nich zwielokrotnić wartość oryginalnego nagrania.
- Transkrypcja-jako-post-na-blogu dla złożonego SEO. 60-minutowe wideo treningowe opublikowane jako tekst na twojej stronie może być ranking dla 20–30 słów kluczowych o długim ogonie, które samo wideo nie mogło dotknąć. Google indeksuje tekst, YouTube indeksuje wideo, i podwoiłeś swoją powierzchnię odkrycia z jednej produkcji. Dr Elena Petrova, badaczka dostępności mediów na USC, powiedziała dobrze w Journal of Digital Media & Policy: „Największym błędem, jaki twórcy zawartości robią, jest traktowanie transkrypcji AI jako gotowej zawartości zamiast materiału surowego. Faza edycji to gdzie prawdziwa wartość jest tworzona dla konsumpcji odbiorcy." Tłumaczenie: nie wklejaj surowej transkrypcji i nazwij ją postem. Edytuj to jak robiłby to pisarz — usuń filler, dodaj podtytułu, zaostroż otwarcie — i masz artykuł opublikowany w mniej niż godzinę.
- Pliki napisów do dostępności i podniesienia zaangażowania. Dodanie napisów SRT lub WebVTT poprawia czas oglądania na platformach społeczności o podwójne procenty, ponieważ większość oglądania mobilnego odbywa się z wyłączonym dźwiękiem. Napisy również rozszerzają zasięg do głuchych i słabosłyszących odbiorców — zobowiązanie dostępności, nie tylko gra zaangażowania. Ten sam plik SRT, który przesłałeś do YouTube'a, może być ponownie wykorzystany dla Instagram Reels, TikTok i wideo natywnemu LinkedIn bez re-transkrypcji.
- Potoki tłumaczenia i dubbingu. Twoja transkrypcja jest dokumentem źródła prawdy dla lokalizacji. Czyste angielskie SRT mogą zasilać systemy dubbingu AI, które generują audio o dopasowanym głosie w ponad 33 językach docelowych, zamieniając jedno angielskie wideo w bibliotekę wielojęzyczną bez przefilmowania czegokolwiek. Łącz z klonowaniem głosu a wersje dublowane brzmią jak ty, a nie jak generyczy syntetyzowany narrator. Jedno angielskie przesłanie staje się powierzchnią dystrybucji hiszańskiej, portugalskiej, niemieckiej, japońskiej i hindskiej w ciągu popołudnia.
- Przeszukiwana baza wiedzy zespołu. Potok transkrypcji jako JSON lub indeksowany TXT w twojej zespołowej wiki, bazy danych Notion lub narzędzia wyszukiwania wewnętrznego. Teraz „co powiedzieliśmy o planie Q3 na all-handach?" staje się zapytaniem przeszukiwalnym, nie projektem archeologii. Dla zespołów uruchamiających tygodniowe all-hands, miesięczne wywiady z klientami i kwartalne przeglądy strategii, ta zmiana pojedynczego przepływu pracy odblokowuje lata zarejestrowanego kontekstu, który był wcześniej zablokowany w niezbywanych plikach wideo.
- Paliwo do repurposingu dla zawartości krótkoformatowej. Uruchom twoją transkrypcję przez krok podsumowania i zidentyfikuj 6–10 najbardziej wpływowych cytatów. Każdy staje się postem LinkedIn, klipem Instagram Reel, wątkiem X, lub wyciągiem biuletynu. Godzina zawartości źródłowego wideo staje się miesiącem materiału dystrybucji. Łącz wyróżniające się cytaty z generatorem obrazu AI, aby utworzyć pasujące wizualizacje dla każdego postu, a transkrypcja to szew między „myśleniem długoformatowym przechwyconym raz" a „dystrybucją krótkoformatową działającą przez tygodnie."
Transkrypcja nie jest dostarczaną. To zasobem piasty, który zasilają pięć oddzielnych kanałów dystrybucji — i gdy widzisz to w ten sposób, matematyka na temat kosztu transkrypcji zmienia się całkowicie.
Połącz punkty: z jednego zasobu piasty tworzysz napisy, zawartość bloga, tłumaczenia i wersje dublowane, indeksowanie wyszukiwania i paliwo krótkoformatowe — pięć wyników z jednego wejścia. Ekonomika zmienia się dramatycznie, gdy przestajesz traktować transkrypcję jako koszt na wideo i zaczynasz traktować ją jako wejście, które odblokowuje pięć kanałów wyjściowych. Dla twórców lub zespołów produkujących więcej niż 4–5 wideo miesięcznie, automatyzowanie tego łańcucha via transkrypcja i API dubbingu sprawia, że cały potok jest praktycznie niereagujący — przesłij do folderu, wróć napisów, tłumaczenia i indeksowany tekst bez ręcznych kroków. To jest wtedy, gdy sztuczna inteligencja do transkrypcji wideo na tekst przestaje być narzędziem, do którego sięgasz, i zaczyna być infrastrukturą, o której nie myślisz.
Twoja pierwsza transkrypcja — lista kontrolna przed lotem, podczas lotu i po locie
Przeczytałeś teorię. Oto wersja operacyjna, zorganizowana w trzy fazy plus brama decyzyjną.
Przed lotem (przed przesłaniem)
- Potwierdź format pliku i rozmiar. MP4, MOV, WebM, MP3, WAV, M4A są uniwersalnie obsługiwane. Pozostań poniżej limitów rozmiaru platformy (zazwyczaj 1–2 GB lub 4 godzin czasu trwania). Podziel dłuższe pliki przed przesłaniem.
- Zidentyfikuj podstawowy język mówiony. Flaga każdy segment przełączania kodu mentalnie, więc wiesz, gdzie audytować rezultat. Jeśli 90% wideo to angielski z 30 sekundą hiszpańskiego, spodziewaj się dodatkowej uwagi do segmentu hiszpańskiego.
- Zbuduj 60-sekundowy słownik nazw własnych. Wpisz imiona, terminy produktu, akronimy i niezwykłe słownictwo specyficzne dla tego wideo. Zapisz go obok pliku. Użyjesz go do wyszukaj-zamień później.
- Najpierw uruchom 60-sekundowy testowy klip. Jeśli test wysiada poniżej 90% dokładności, napraw audio — ponownie izoluj głos, zmniejsz szum, przełącz pliki źródłowe — zanim transkrybować pełne wideo. Pięć minut testowania zapobiega godzinie zmagania się ze złym rezultatem.
- Wybierz format wyjściowy na podstawie miejsca przeznaczenia. SRT dla YouTube i napisów. TXT dla blogów i podsumowania AI. Tekst z czasem dla podcast'ów. JSON dla programistów i indeksowania wyszukiwania. Decyduj przed przesłaniem, nie po.
Podczas lotu (podczas przetwarzania)
- Nie patrz na pasek postępu. 30-minutowy plik przetwarza się w 3–5 minut. Użyj tego okna do napisania opisu wideo, napisania nagłówka bloga lub umieszczenia następnego pliku w kolejce. Cały punkt transkrypcji AI to to, że uwalnia twoją uwagę, podczas gdy to działa.
- Parzystuj, gdy to możliwe. Jeśli przetwarzasz wiele plików, umieść je w kolejce i pójdź. Większość platform przetwarza równolegle, co oznacza, że dziesięć 30-minutowych plików kończy się w mniej więcej tym samym rzeczywistym czasem, co jeden.
Po locie (po eksporcie)
- Sprawdź punkt 10% na początku i na końcu. Błędy skupiają się na krawędziach — gdy ASR nadal się kalibruje na początku i gdy jakość audio často dryfuje na końcu (energia spada, artefakty nagrania, fade-outy). Słuchaj-i-czytaj te segmenty specjalnie.
- Uruchom wyszukaj i zamień na swój słownik. Weź 60-sekundowy słownik z kroku 3 i wykonaj go w jednym przejściu. Napraw każdą instancję „Cura Nettis" → „Kubernetes" na raz, nie jedenaście oddzielnych razy.
- Weryfikuj znaczniki czasu na 25%, 50% i 75%. Otwórz wideo w każdym markerie, sprawdzić czy znacznik czasu transkrypcji pasuje do audio. Dryfowanie jest rzadkie, ale korozywne, gdy się zdarzy.
- Kieruj plik do jego miejsca przeznaczenia natychmiast. Prześlij SRT do YouTube Studio. Wklej TXT do szkicu CMS. Wyślij JSON do indeksu. Pliki, które siedziały w folderze pobierania, stają się plikami, które zapomnij istnieją.
Brama decyzji — którego wyjścia potrzebujesz?
Zanim przesłasz, przejdź przez tę gałąź:
- Napisywanie wideo? → Eksportuj SRT lub WebVTT, prześlij bezpośrednio do platformy wideo.
- Pisanie posta na blogu lub artykułu? → Eksportuj TXT, edytuj dla czytelności (wytnij filler, dodaj podtytułu), publikuj.
- Budowanie notatek do odcinka podcast'u? → Eksportuj tekst z czasem, łącz znaczniki czasu jako nawigację w notatkach do odcinka.
- Budowanie wielojęzycznej biblioteki zawartości? → Eksportuj SRT, następnie zasilaj go przepływem pracy dubbingu AI, aby wygenerować wersje o dopasowanym głosie w twoich językach docelowych.
- Indeksowanie dla wyszukiwania zespołu lub budowanie aplikacji? → Eksportuj JSON ze znacznikami czasu na poziomie słowa, przegotuj do backend'u wyszukiwania lub bazy wiedzy.
Wybierz rezultat, który pasuje do miejsca przeznaczenia, kliknij transkrybuj, a następne cztery kroki przepływu pracy odblokowują się sami.