Czysty transkrypt z 30-minutowego podcastu lub filmu szkoleniowego jest realny w niecałe 10 minut dzięki DubSmart AI, a większość twórców obsługuje to za kwotę od 0 do mniej więcej 20–50 USD miesięcznie, w zależności od ilości materiału. Jeśli chcesz wiedzieć, jak przekształcić dźwięk w tekst bez zestawiania osobnej aplikacji do transkrypcji, narzędzia do usuwania szumów i edytora napisów, nasz silnik Speech to Text wykonuje całe zadanie w jednym miejscu pracy: wgraj multimedia, wygeneruj tekst z dokładnością powyżej 95% na czystym dźwięku, edytuj etykiety mówców i interpunkcję, a następnie wyeksportuj transkrypt lub napisy gotowe do publikacji.
Prawdziwą zaletą nie jest tu tylko szybkość. Ponieważ transkrypcja, czyszczenie dźwięku, dubbing i lektor korzystają z tej samej puli kredytów, ten sam transkrypt, który tworzysz dziś, może później zasilić AI Dubbing na 33 języki docelowe lub Text to Speech z ponad 300 głosami. To ma znaczenie, jeśli prowadzisz kanał na YouTube, tworzysz kursy e-learningowe lub lokalizujesz szkolenia korporacyjne.
Spis treści
Czego potrzebujesz, zanim zaczniesz
Jakość transkrypcji jest przesądzona, zanim naciśniesz choćby jeden przycisk. Najpierw przejdź przez tę listę kontrolną:
- Konto DubSmart z dostępem do Speech to Text i Speech Separator w planie Free, Starter lub wyższym.
- Gotowe pliki źródłowe: odcinki podcastów, webinary, wywiady lub link do YouTube.
- Prawa i pozwolenie na transkrypcję treści, co ma największe znaczenie przy pracy dla klientów i nagraniach stron trzecich.
- Jasno określony docelowy format wyjściowy: pełny transkrypt (DOC/TXT), napisy (SRT/VTT) lub skrypt do dubbingu i lektora.
- Podstawowe informacje o nagraniu: język źródłowy, liczba mówców oraz to, czy występuje muzyka lub silny szum tła.
- Dla zespołów podlegających regulacjom — wewnętrzne wytyczne dotyczące obsługi danych osobowych lub wrażliwych w narzędziach chmurowych.
Znajomość formatu wyjściowego z góry oszczędza dodatkowej pracy. Zadanie polegające na przygotowaniu notatek do bloga wymaga zwykłego tekstu; przesłanie na YouTube wymaga napisów z czasem; zadanie lokalizacyjne wymaga czystego skryptu, który można od razu przekazać do dubbingu.
Krok po kroku: przekształć dźwięk w tekst za pomocą DubSmart
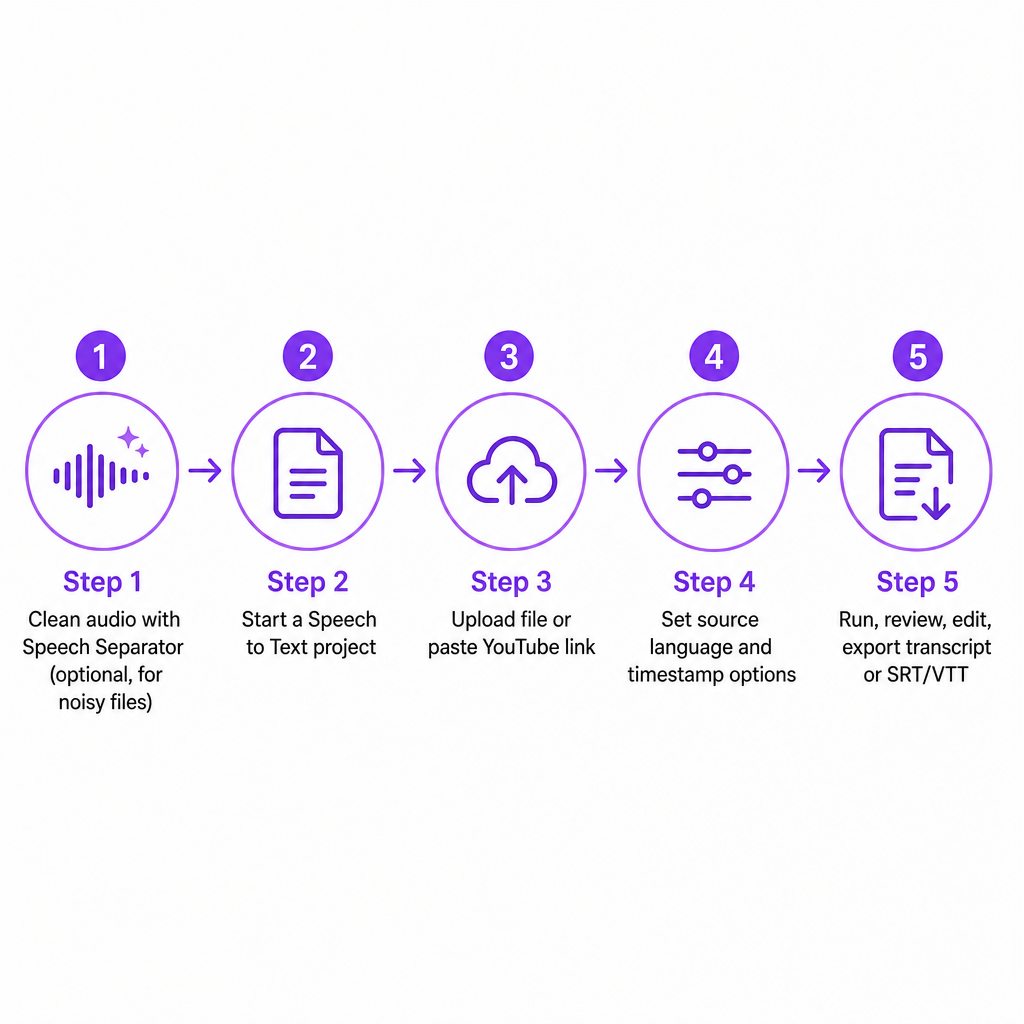
1. Dobierz odpowiednie narzędzia do nagrania
Speech to Text przekształca mówiony dźwięk w tekst pisany i współpracuje ze Speech Separator w przypadku głośnych nagrań. Kredyty są współdzielone między AI Dubbing, Text to Speech, Voice Cloning, Speech to Text i Speech Separator, więc każda przetworzona minuta czerpie z tej samej puli.
Decyzja jest prosta. Jeśli nagranie zawiera muzykę, gwar tłumu lub echo pomieszczenia, zacznij od Speech Separator, aby wyodrębnić głosy. Jeśli dźwięk jest już czysty, przejdź bezpośrednio do transkrypcji.
2. Wyczyść dźwięk za pomocą Speech Separator (zalecane)
Wysokiej jakości materiał wejściowy to najważniejszy czynnik decydujący o dokładnej automatycznej transkrypcji, zwłaszcza w przypadku podcastów, wywiadów i paneli z wieloma mówcami. Speech Separator wyodrębnia mowę z muzyki i szumu tła w popularnych formatach, takich jak MP3, WAV i AAC, pozostawiając czystszą ścieżkę wokalną.
- Otwórz narzędzie Speech Separator na swoim koncie.
- Wgraj dźwięk lub wideo z urządzenia albo wybierz je ze swoich projektów.
- Pozwól AI oddzielić głos od tła; zwykle zajmuje to od kilku sekund do kilku minut, w zależności od długości.
- Zapisz czysty plik głosowy w bibliotece projektów.
Mając tak oczyszczoną ścieżkę, etap transkrypcji generuje mniej błędów i wymaga mniej ręcznych poprawek.
3. Rozpocznij nowy projekt Speech to Text
Proces jest celowo krótki: wybierz funkcję, wgraj multimedia, edytuj, eksportuj.
- Zaloguj się i otwórz panel przestrzeni roboczej.
- Wybierz Speech to Text z listy narzędzi.
- Utwórz nowy projekt i nadaj mu opisową nazwę, np. „Webinar produktowy – październik”.
Nazywanie projektów utrzymuje transkrypty w porządku i ułatwia ich późniejsze ponowne wykorzystanie do napisów, dubbingu lub text-to-speech.
4. Wgraj swój dźwięk lub wideo
Możesz wgrywać pliki bezpośrednio lub pobierać je z adresu URL YouTube, co jest wygodne dla twórców i agencji zarządzających kanałami klientów.
- Wgraj dźwięk lub wideo z urządzenia w standardowych formatach, takich jak MP3, WAV i MP4.
- Wklej adres URL YouTube, aby wczytać wideo bezpośrednio do projektu, w tym materiały 1080p tam, gdzie są obsługiwane.
DubSmart następnie analizuje plik, wyodrębnia dźwięk i przygotowuje go do rozpoznawania.
5. Ustaw język i opcje rozpoznawania
Speech to Text obsługuje ponad 60 języków, w tym angielski, hiszpański, niemiecki, hindi, turecki, portugalski, japoński, rosyjski, chiński i arabski. Ustawienie poprawnego języka źródłowego nie jest szczegółem opcjonalnym; silnik opiera się na modelach specyficznych dla języka, aby przekształcić mowę w tekst.
- Wybierz język źródłowy odpowiadający nagraniu. W przypadku treści wielojęzycznych zacznij od języka dominującego.
- Jeśli występuje wielu mówców, zaplanuj dodanie etykiet mówców podczas edycji.
- Potwierdź opcje znaczników czasu i segmentacji, jeśli zamierzasz eksportować napisy SRT lub VTT zamiast zwykłego transkryptu.
W przypadku większości plików z jednym mówcą rozpoznawanie przebiega w tempie równym lub szybszym od rzeczywistego, więc przetwarzanie często kończy się w czasie trwania nagrania.
6. Uruchom transkrypcję
Rozpocznij proces i pozwól silnikowi pracować. Dzieli on dźwięk na segmenty, identyfikuje fonemy i słowa oraz stosuje modele językowe, aby wygenerować tekst. Na czystym dźwięku dokładność sięga ponad 95%, co znacznie ogranicza nakład pracy przy korektach. W trakcie działania przygotuj krótki słowniczek nazwisk, marek lub terminów technicznych, które już wiesz, że będziesz musiał ujednolicić.
7. Przejrzyj i edytuj transkrypt
Automatyczny wynik jest szybki, ale tekst na poziomie profesjonalnym nadal wymaga sprawdzenia przez człowieka, zwłaszcza w przypadku nazwisk, akronimów i żargonu. Edytuj bezpośrednio w edytorze projektu:
- Przeczytaj całość, słuchając kluczowych fragmentów, aby wychwycić błędnie usłyszane słowa.
- Dodaj etykiety mówców, takie jak Prowadzący, Gość lub Instruktor, aby dialog był łatwy do śledzenia.
- Popraw interpunkcję i wielkie litery, które wpływają zarówno na czytelność, jak i na synchronizację napisów.
- Ujednolić terminologię, taką jak nazwy produktów, terminy medyczne lub zwroty prawne, zgodnie ze słownikiem marki lub wymogami zgodności.
Ponieważ ten sam transkrypt może później zasilić AI Dubbing na ponad 33 języki oraz Text to Speech z ponad 300 głosami, staranna edycja teraz opłaca się za każdym razem, gdy ponownie wykorzystujesz treść.
8. Eksportuj tekst lub napisy
Gdy poprawki wyglądają dobrze, eksportuj w formacie, którego wymaga Twój przypadek użycia:
- Napisy (SRT lub VTT) dla YouTube, platform LMS i korporacyjnych portali wideo.
- Zwykły tekst (TXT) lub formaty dokumentów dla blogów, notatek do odcinków, podręczników szkoleniowych i protokołów ze spotkań.
Wybierz format, a następnie pobierz lub zapisz ukończony projekt. To kończy podstawowy proces, jak przekształcić dźwięk w tekst w DubSmart.
Czas i koszt: czego się spodziewać
DubSmart działa w oparciu o system kredytowy obejmujący AI Dubbing, Text to Speech, Voice Cloning, Speech to Text i Speech Separator. Kredyty są wymienne, więc jedna pula pokrywa minuty transkrypcji, czyszczenie dźwięku i dubbing. Zgodnie z naszym opublikowanym cennikiem:
| Plan | Cena miesięczna | Miesięczne kredyty | Uwagi |
|---|---|---|---|
| Free | 0 USD | 2 000 | Około 2 minuty AI Dubbing/TTS do przetestowania procesu |
| Starter | ~20 USD | 50 000 | Około 50 minut AI Dubbing/TTS; niewykorzystane kredyty przechodzą na kolejny okres |
| Standard | ~50 USD | 150 000 | Większa ilość przy niższym koszcie za 1 000 kredytów |
Ponieważ kredyty obejmują transkrypcję, czyszczenie głosu i dubbing, cały proces można traktować jako jeden budżet zamiast osobnych narzędzi. Dla większości twórców oznacza to transkrypcję dziesiątek krótkich filmów miesięcznie w cenie planu Starter, przy jednoczesnym zachowaniu wolnej puli kredytów na dubbing i lektorów.
Częste błędy i jak je naprawić
Używanie głośnego dźwięku bez jego oczyszczenia. Muzyka w tle, gwar tłumu lub echo powodują błędy rozpoznawania i dodatkową edycję. Najpierw przepuść plik przez Speech Separator, a następnie przetranskrybuj wyodrębnioną ścieżkę głosową, aby uzyskać wyższą dokładność i czystszą synchronizację napisów.
Wybór niewłaściwego języka źródłowego. Jeśli pozostawisz angielski, gdy dźwięk jest po hiszpańsku, silnik błędnie zinterpretuje fonemy i wygeneruje bezużyteczny tekst. Sprawdź dwukrotnie język przed rozpoczęciem, a w przypadku filmów wielojęzycznych podziel je według języka lub nadaj priorytet głównemu językowi przy pierwszym przejściu.
Ignorowanie etykiet mówców. Podcasty i panele z wieloma mówcami są trudne do czytania bez przypisania wypowiedzi. Dodaj etykiety takie jak Prowadzący, Gość 1 lub oznaczenia oparte na nazwiskach podczas edycji i utrzymuj ich spójność między odcinkami.
Pomijanie weryfikacji przez człowieka w przypadku treści o wysokiej stawce. W przypadku materiałów prawnych, medycznych lub wrażliwych pod względem zgodności niewielki błąd może zmienić znaczenie. Traktuj automatyczny transkrypt jako pierwszą wersję roboczą i przeprowadź pełną walidację przez człowieka, łącząc ją z wewnętrznymi recenzentami lub zewnętrznymi kontrolami zgodności tam, gdzie to konieczne.
Błędne oszacowanie kredytów. Przetwarzanie dużego archiwum bez zrozumienia zużycia może wyczerpać Twój limit. Najpierw sprawdź miesięczne kredyty i zasady przenoszenia w swoim planie, a następnie uruchom małą partię pilotażową, aby zmierzyć liczbę minut na kredyt dla Speech Separator i Speech to Text, zanim zdecydujesz się na pracę masową.
Samodzielnie czy z pomocą profesjonalisty: gdzie wyznaczyć granicę
DubSmart jest zbudowany do samodzielnego użytku przez twórców, małe firmy, zespoły e-learningowe i agencje, które chcą skalowalnych treści wielojęzycznych bez żonglowania dostawcami. Narzędzia działające w przeglądarce, darmowy poziom i współdzielony model kredytowy pozwalają większości użytkowników samodzielnie obsłużyć transkrypcję, czyszczenie i dubbing.
Samodzielna obsługa zwykle wystarcza, gdy:
- Transkrybujesz treści odcinkowe, takie jak podcasty, filmy na YouTube, dema produktów lub szkolenia wewnętrzne.
- Dźwięk jest w miarę czysty lub można go poprawić za pomocą Speech Separator.
- Dokładność musi być wysoka, ale nie jest prawnie wiążąca, np. napisy ułatwiające dostępność, materiały kursowe lub materiały marketingowe.
- Twoja miesięczna ilość mieści się w dostępnych kredytach z zapasem na dubbing lub lektorów.
Skłaniaj się ku profesjonalnemu lub korporacyjnemu wsparciu, gdy:
- Zarządzasz dużymi katalogami, setkami godzin, które wymagają spójnej kontroli jakości, stylu i terminologii w różnych regionach.
- Twoje treści podlegają surowym standardom prawnym lub regulacyjnym, takim jak postępowania sądowe, dokumentacja medyczna lub ujawnienia finansowe.
- Musisz zintegrować nasze AI Dubbing API lub Text to Speech API ze złożonymi procesami z wymaganiami dotyczącymi dostępności i przepustowości dla klientów.
W takich przypadkach połączenie naszej automatyzacji z profesjonalną weryfikacją językową lub weryfikacją zgodności daje najlepszą równowagę między szybkością, kosztem a ryzykiem. W przypadku większości codziennej transkrypcji droga samodzielna jest szybsza i tańsza, a transkrypt pozostaje gotowy, aby stać się napisami, dubbingami lub lektorami, kiedy tylko ich potrzebujesz.
Często zadawane pytania
Jakie rodzaje treści może transkrybować DubSmart?
Speech to Text obsługuje podcasty, filmy na YouTube, webinary, wywiady, filmy i szkolenia korporacyjne, o ile dźwięk jest dostępny przez wgranie lub link.
Które języki są obsługiwane w transkrypcji?
Speech to Text obsługuje ponad 60 języków, w tym angielski, hiszpański, niemiecki, hindi, turecki, portugalski, japoński, rosyjski, chiński i arabski, a ta sama platforma dubbinguje na 33 języki docelowe.
Jak dokładny jest Speech to Text w DubSmart?
Na czystym dźwięku przy wybranym poprawnym języku dokładność sięga ponad 95%, zgodnie z nowoczesnym automatycznym rozpoznawaniem mowy.
Ile kosztuje transkrypcja za pomocą DubSmart?
Cennik zaczyna się od 0 USD/miesiąc z darmowym poziomem 2 000 kredytów. Płatne plany, takie jak Starter (około 20 USD/miesiąc) i Standard (około 50 USD/miesiąc), dodają kredyty i obniżają koszt za kredyt, a kredyty są współdzielone między transkrypcję, dubbing i powiązane narzędzia.
Czy mogę wykorzystać transkrypt do dubbingu i lektorów?
Tak. Wynik Speech to Text może być bezpośrednio przekazany do AI Dubbing i Text to Speech, aby tworzyć wielojęzyczne wersje dubbingowane i lektorów AI z wykorzystaniem ponad 300 naturalnie brzmiących głosów.