DubSmart AIを使えば、30分のポッドキャストやトレーニング動画からきれいな文字起こしを10分以内に作成することが現実的に可能で、ほとんどのクリエイターは利用量に応じて月額0ドルからおよそ20〜50ドルの範囲で対応しています。別々の文字起こしアプリ、ノイズ除去ツール、字幕エディターを継ぎ接ぎせずに音声をテキストに変換する方法を知りたい方へ。私たちのSpeech to Textエンジンは、1つのワークスペースで全作業を完結させます。メディアをアップロードし、クリアな音声なら95%以上の精度でテキストを生成、話者ラベルや句読点を編集し、公開できる文字起こしや字幕としてエクスポートできます。
ここでの本当の利点は、単なるスピードだけではありません。文字起こし、音声クリーンアップ、吹き替え、ナレーションが同じクレジットプールを共有しているため、今日作成した文字起こしを、後からAI Dubbingで33の対象言語へ、またはText to Speechで300以上の音声へと活用できます。これはYouTubeチャンネルを運営している方、eラーニングコースを作成している方、企業研修をローカライズしている方にとって重要です。
目次
始める前に必要なもの
文字起こしの品質は、ボタンを1つ押す前に決まります。まずはこのチェックリストに目を通しましょう:
- Free、Starter、またはそれ以上のプランでSpeech to TextとSpeech SeparatorにアクセスできるDubSmartアカウント。
- すぐに使えるソースファイル:ポッドキャストのエピソード、ウェビナー、インタビュー、またはYouTubeのリンク。
- コンテンツを文字起こしする権利と許可。これはクライアント業務や第三者の録音で特に重要です。
- 明確な出力目標:完全な文字起こし(DOC/TXT)、字幕(SRT/VTT)、または吹き替え・ナレーション用のスクリプト。
- 録音に関する基本情報:ソース言語、話者の数、音楽や大きな背景ノイズの有無。
- 規制対象のチームの場合、クラウドツールでの個人情報や機密データの取り扱いに関する社内ガイドライン。
出力形式を事前に把握しておくことで、作業のやり直しを防げます。ブログのショーノート作業にはプレーンテキストが適しており、YouTubeへのアップロードにはタイミング付きの字幕が、ローカライズ作業には吹き替えにそのまま使えるきれいなスクリプトが求められます。
ステップバイステップ:DubSmartで音声をテキストに変換する
1. 録音に適したツールを選ぶ
Speech to Textは話された音声を書き起こしテキストに変換し、ノイズの多い録音ではSpeech Separatorと連携して機能します。クレジットはAI Dubbing、Text to Speech、Voice Cloning、Speech to Text、Speech Separatorで共有されるため、処理するすべての分数が同じプールから引かれます。
判断はシンプルです。録音に音楽、群衆のノイズ、または部屋の反響がある場合は、まずSpeech Separatorで音声を分離します。音声がすでにクリアな場合は、文字起こしに直接進んでください。
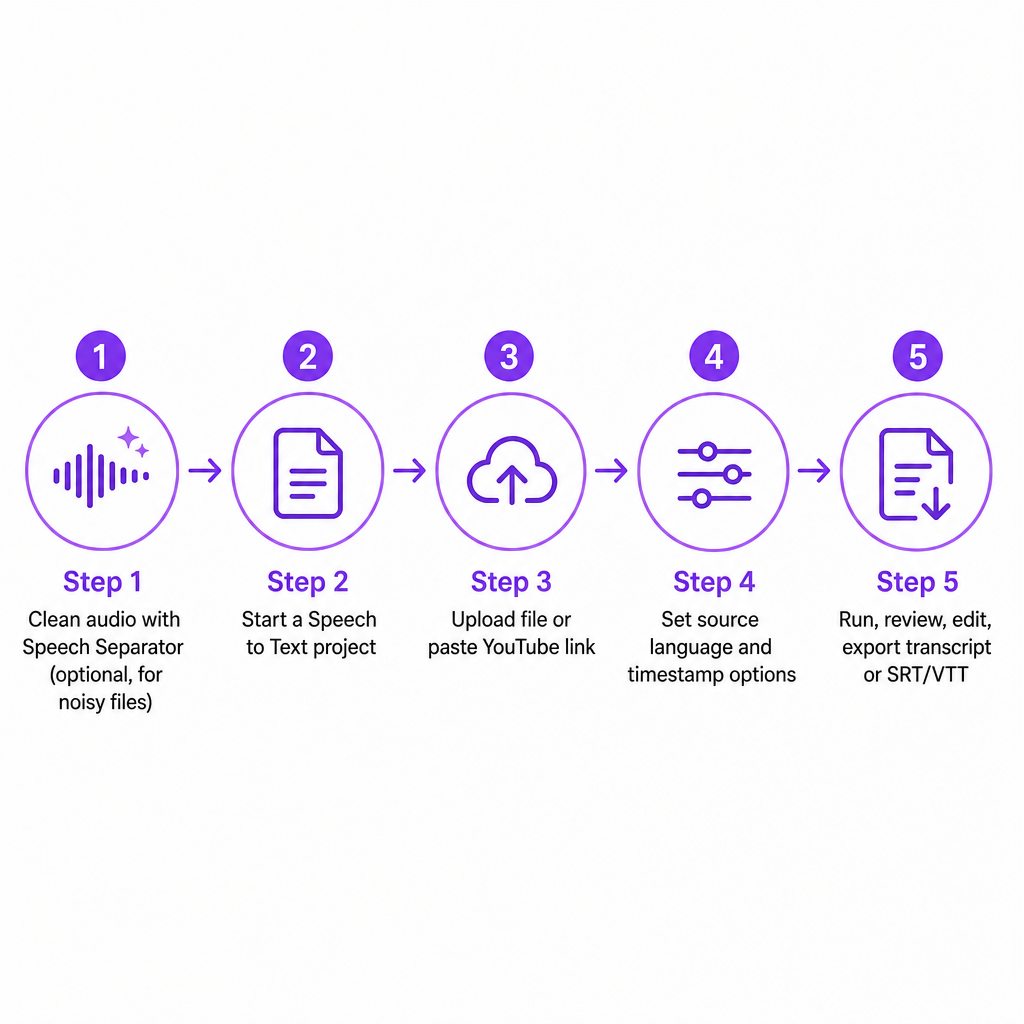
2. Speech Separatorで音声をクリーンアップする(推奨)
高品質な入力は、特に複数の話者がいるポッドキャスト、インタビュー、パネルディスカッションにおいて、正確な自動文字起こしの最大の要因となります。Speech Separatorは、MP3、WAV、AACなどの一般的な形式で音楽や背景ノイズから音声を分離し、よりクリアなボーカルトラックを残します。
- アカウントでSpeech Separatorツールを開きます。
- デバイスから音声または動画をアップロードするか、プロジェクトから選択します。
- AIに音声を背景から分離させます。これは通常、長さに応じて数秒から数分で完了します。
- クリーンな音声ファイルをプロジェクトライブラリに保存します。
そのクリーンアップされたトラックを使えば、文字起こしの段階でエラーが少なくなり、手動での修正も少なくて済みます。
3. 新しいSpeech to Textプロジェクトを開始する
フローは意図的に短く設計されています:機能を選択、メディアをアップロード、編集、エクスポート。
- ログインしてワークスペースのダッシュボードを開きます。
- ツールリストからSpeech to Textを選択します。
- 新しいプロジェクトを作成し、「製品ウェビナー – 10月」のようなわかりやすい名前を付けます。
プロジェクトに名前を付けることで文字起こしが整理され、後で字幕作成、吹き替え、テキスト読み上げに再利用しやすくなります。
4. 音声または動画をアップロードする
ファイルを直接アップロードするか、YouTubeのURLから取り込むことができます。これはクライアントのチャンネルを管理するクリエイターや代理店にとって便利です。
- MP3、WAV、MP4などの標準形式でデバイスから音声または動画をアップロードします。
- YouTubeのURLを貼り付けて、対応している場合は1080pのアップロードを含め、動画を直接プロジェクトに取り込みます。
その後、DubSmartがファイルを分析し、音声を抽出し、認識用に準備します。
5. 言語と認識オプションを設定する
Speech to Textは、英語、スペイン語、ドイツ語、ヒンディー語、トルコ語、ポルトガル語、日本語、ロシア語、中国語、アラビア語を含む60以上の言語に対応しています。正しいソース言語の設定はオプションの細かい点ではありません。エンジンは言語固有のモデルに依存して音声をテキストにデコードします。
- 録音に合ったソース言語を選択します。多言語コンテンツの場合は、主要な言語から始めます。
- 複数の話者がいる場合は、編集中に話者ラベルを追加する予定を立てます。
- プレーンな文字起こしではなくSRTやVTTの字幕をエクスポートする予定の場合は、タイムスタンプとセグメンテーションのオプションを確認します。
ほとんどの単一話者ファイルでは、認識はリアルタイム以上の速度で実行されるため、処理は録音の長さの範囲内で完了することがよくあります。
6. 文字起こしを実行する
プロセスを開始し、エンジンに処理させます。音声をセグメント化し、音素と単語を識別し、言語モデルを適用してテキストを生成します。クリアな音声では精度が95%以上に達し、修正作業の負担が大幅に軽減されます。処理中に、標準化が必要になることがすでにわかっている名前、ブランド、専門用語の短い用語集を準備しておきましょう。
7. 文字起こしを確認して編集する
自動出力は高速ですが、特に名前、略語、専門用語については、プロ品質のテキストには人間による確認が依然として必要です。プロジェクトエディター内で直接編集します:
- 重要なセクションを聞きながら読み通して、聞き間違えた単語を見つけます。
- Host、Guest、Instructorなどの話者ラベルを追加して、会話を追いやすくします。
- 句読点と大文字・小文字の使い方を修正します。これは読みやすさと字幕のタイミングの両方に影響します。
- 製品名、医療用語、法律用語などの用語を、ブランドやコンプライアンスの用語集に照らして標準化します。
同じ文字起こしは後からAI Dubbingで33以上の言語へ、Text to Speechで300以上の音声へと活用できるため、今丁寧に編集しておくことで、コンテンツを再利用するたびにその成果が得られます。
8. テキストまたは字幕をエクスポートする
編集が問題なければ、ユースケースに必要な形式でエクスポートします:
- YouTube、LMSプラットフォーム、企業向け動画ポータル用の字幕(SRTまたはVTT)。
- ブログ、ショーノート、トレーニングマニュアル、議事録用のプレーンテキスト(TXT)またはドキュメント形式。
形式を選択し、完成したプロジェクトをダウンロードまたは保存します。これでDubSmartで音声をテキストに変換する方法のコアワークフローが完了します。
時間とコスト:何を期待できるか
DubSmartは、AI Dubbing、Text to Speech、Voice Cloning、Speech to Text、Speech Separatorにまたがって適用されるクレジットベースのシステムで動作します。クレジットは相互に利用可能なので、1つのプールで文字起こしの分数、音声クリーンアップ、吹き替えをカバーします。公開されている価格設定より:
| プラン | 月額料金 | 月間クレジット | 備考 |
|---|---|---|---|
| Free | $0 | 2,000 | ワークフローをテストするためのAI Dubbing/TTS約2分 |
| Starter | 約$20 | 50,000 | AI Dubbing/TTS約50分;未使用のクレジットは繰り越し |
| Standard | 約$50 | 150,000 | 1,000クレジットあたりのコストが低く、より大量に利用可能 |
クレジットは文字起こし、音声クリーンアップ、吹き替えにまたがっているため、パイプライン全体を別々のツールではなく1つの予算として扱うことができます。ほとんどのクリエイターにとって、これはStarterレベルの価格で月に数十本の短い動画を文字起こししながら、吹き替えやナレーション用のクレジット容量を確保しておけることを意味します。
よくある間違いとその修正方法
ノイズの多い音声をクリーンアップせずに使用する。 背景音楽、群衆のノイズ、反響は、認識ミスや余分な編集の原因になります。まずファイルをSpeech Separatorに通してから、分離された音声トラックを文字起こしすることで、より高い精度ときれいな字幕のタイミングが得られます。
間違ったソース言語を選択する。 音声がスペイン語なのに英語のままにしておくと、エンジンは音素を誤って解釈し、使えないテキストを生成します。開始前に言語を再確認し、多言語の動画では言語ごとにセグメント化するか、最初のパスではメイン言語を優先してください。
話者ラベルを無視する。 複数の話者がいるポッドキャストやパネルは、話者の区別がないと読みにくくなります。編集中にHost、Guest 1、または名前ベースのタグなどのラベルを追加し、エピソード間で一貫性を保ちます。
重要度の高いコンテンツで人間による確認を省く。 法律、医療、またはコンプライアンスに敏感な素材では、小さなエラーが意味を変える可能性があります。自動文字起こしを初稿として扱い、必要に応じて社内レビュアーや外部のコンプライアンスチェックと組み合わせて、完全な人間による検証を行ってください。
クレジットの見積もりを誤る。 使用量を理解せずに大量のバックカタログを処理すると、割り当てを使い果たす可能性があります。まずプランの月間クレジットと繰り越しポリシーを確認し、大量の作業に取り組む前に、小規模なパイロットバッチを実行してSpeech SeparatorとSpeech to Text全体でのクレジットあたりの分数を測定してください。
DIYか専門家の支援か:線引きの基準
DubSmartは、ベンダーを掛け持ちすることなくスケーラブルな多言語コンテンツを求めるクリエイター、中小企業、eラーニングチーム、代理店によるセルフサービス利用のために作られています。ブラウザベースのツール、無料ティア、共有クレジットモデルにより、ほとんどのユーザーが文字起こし、クリーンアップ、吹き替えを自分で処理できます。
セルフサービスで通常十分なのは次の場合です:
- ポッドキャスト、YouTube動画、製品デモ、社内研修などのエピソード形式のコンテンツを文字起こしする場合。
- 音声が比較的クリアであるか、Speech Separatorで改善できる場合。
- アクセシビリティ字幕、コース教材、マーケティング資料など、精度は高くする必要があるが法的拘束力はない場合。
- 月間の処理量が、吹き替えやナレーション用の余地を残しつつ利用可能なクレジット内に収まる場合。
専門家またはエンタープライズレベルのサポートに傾くべきなのは次の場合です:
- 地域間で一貫したQA、スタイル、用語を必要とする大規模なカタログ(数百時間)を管理する場合。
- コンテンツが、裁判手続き、医療文書、財務開示など、厳格な法律や規制の基準に該当する場合。
- クライアント向けの稼働時間やスループットの要件を伴う複雑なワークフローに、私たちのAI Dubbing APIまたはText to Speech APIを統合する必要がある場合。
そのような場合、私たちの自動化を専門的な言語またはコンプライアンスのレビューと組み合わせることで、スピード、コスト、リスクの最適なバランスが得られます。日常的な文字起こしのほとんどでは、セルフサービスの方が速くて安く、必要なときにいつでも字幕、吹き替え、ナレーションにできるよう文字起こしを準備しておけます。
よくある質問
DubSmartはどのような種類のコンテンツを文字起こしできますか?
Speech to Textは、アップロードまたはリンクを通じて音声が利用できる限り、ポッドキャスト、YouTube動画、ウェビナー、インタビュー、映画、企業研修を処理します。
文字起こしに対応している言語は何ですか?
Speech to Textは、英語、スペイン語、ドイツ語、ヒンディー語、トルコ語、ポルトガル語、日本語、ロシア語、中国語、アラビア語を含む60以上の言語に対応しており、同じプラットフォームで33の対象言語に吹き替えできます。
DubSmartのSpeech to Textの精度はどのくらいですか?
正しい言語が選択されたクリアな音声では、精度は95%以上に達し、最新の自動音声認識と同等です。
DubSmartで文字起こしするのにいくらかかりますか?
料金は、2,000クレジットの無料ティアで月額0ドルから始まります。Starter(月額約20ドル)やStandard(月額約50ドル)などの有料プランでは、クレジットが追加され、クレジットあたりのコストが下がります。また、クレジットは文字起こし、吹き替え、関連ツール全体で共有されます。
文字起こしを吹き替えやナレーションに使用できますか?
はい。Speech to Textの出力は、AI DubbingとText to Speechに直接取り込んで、300以上の自然な音声を使用した多言語の吹き替えバージョンやAIナレーションを作成できます。