Trasformare uno script in una narrazione per YouTube significava un tempo usare un microfono, una stanza silenziosa e tantissime riprese ripetute. Ora la sintesi vocale per YouTube ti permette di incollare uno script, scegliere una voce ed esportare una narrazione da inserire in un video, uno Short, un tutorial o una versione tradotta di un caricamento che hai già pubblicato. La vera decisione non è se usare o meno una voce sintetica. È quale metodo di produzione si adatta allo specifico video che hai davanti: una voce AI standard, un clone personalizzato, una registrazione umana o un mix dei tre.
Questa guida spiega come funziona realmente la tecnologia, quale flusso di lavoro si adatta ai diversi obiettivi di un canale e cosa verificare in materia di diritti e divulgazione prima di premere pubblica. È il punto centrale della nostra più ampia raccolta di approfondimenti su sintesi vocale e trascrizione, quindi troverai collegamenti ad analisi più approfondite laddove un singolo argomento merita una pagina dedicata.
Indice dei contenuti
Cosa significa realmente la sintesi vocale per YouTube
La sintesi vocale per YouTube consiste semplicemente nell'usare la tecnologia text-to-speech per generare narrazioni per i contenuti YouTube. Fornisci uno script, scegli una voce e una lingua, regoli come deve essere pronunciato ed esporti un file audio da modificare o caricare. Dietro le quinte, un sistema TTS converte il testo, o lo Speech Synthesis Markup Language (SSML), in dati audio come MP3 o audio compatibile con WAV che puoi aggiungere a video e altri contenuti multimediali.
Due distinzioni chiariscono gran parte della confusione. I sottotitoli svolgono il lavoro opposto del TTS: i sottotitoli trasformano l'audio parlato in testo, mentre la sintesi vocale trasforma il testo scritto in audio parlato. Il doppiaggio è ancora più ampio. Il TTS di solito parte da uno script scritto e produce una nuova traccia vocale, mentre il doppiaggio generalmente traduce un video esistente e fa corrispondere la voce sostitutiva al timing e al significato originali. Se questi confini sono importanti per il tuo flusso di lavoro, il nostro approfondimento su in quali lingue può doppiare l'AI tratta in dettaglio il lato della localizzazione.
Come la pipeline di sintesi trasforma uno script in una voce
Un sistema TTS combina quattro ingredienti: il tuo script, un modello vocale selezionato, informazioni sulla lingua e controlli di pronuncia. A partire da questi, procede attraverso una breve sequenza che spiega perché la stessa frase può suonare benissimo o goffa a seconda di come l'hai scritta.
Prima arriva l'input testuale, che può essere uno script YouTube completo, una scaletta espansa in narrazione, una versione tradotta di uno script esistente o sottotitoli rimodellati in voiceover. La qualità dell'input determina la qualità dell'output. Frasi lunghe, abbreviazioni non spiegate, nomi insoliti e punteggiatura disordinata possono far suonare male una voce capace. La soluzione è scrivere per l'ascolto piuttosto che per la lettura silenziosa: frasi più brevi, transizioni chiare, pause deliberate.
Successivamente il motore analizza il testo per decidere come le parole devono essere pronunciate e raggruppate. Legge i confini delle frasi, la punteggiatura e le pause, numeri e date, abbreviazioni, nomi e indizi di pronuncia regionale. Ecco perché la punteggiatura cambia la pronuncia. Aggiungi una virgola, riscrivi un numero in lettere o scrivi per esteso un acronimo, e la voce risponde.
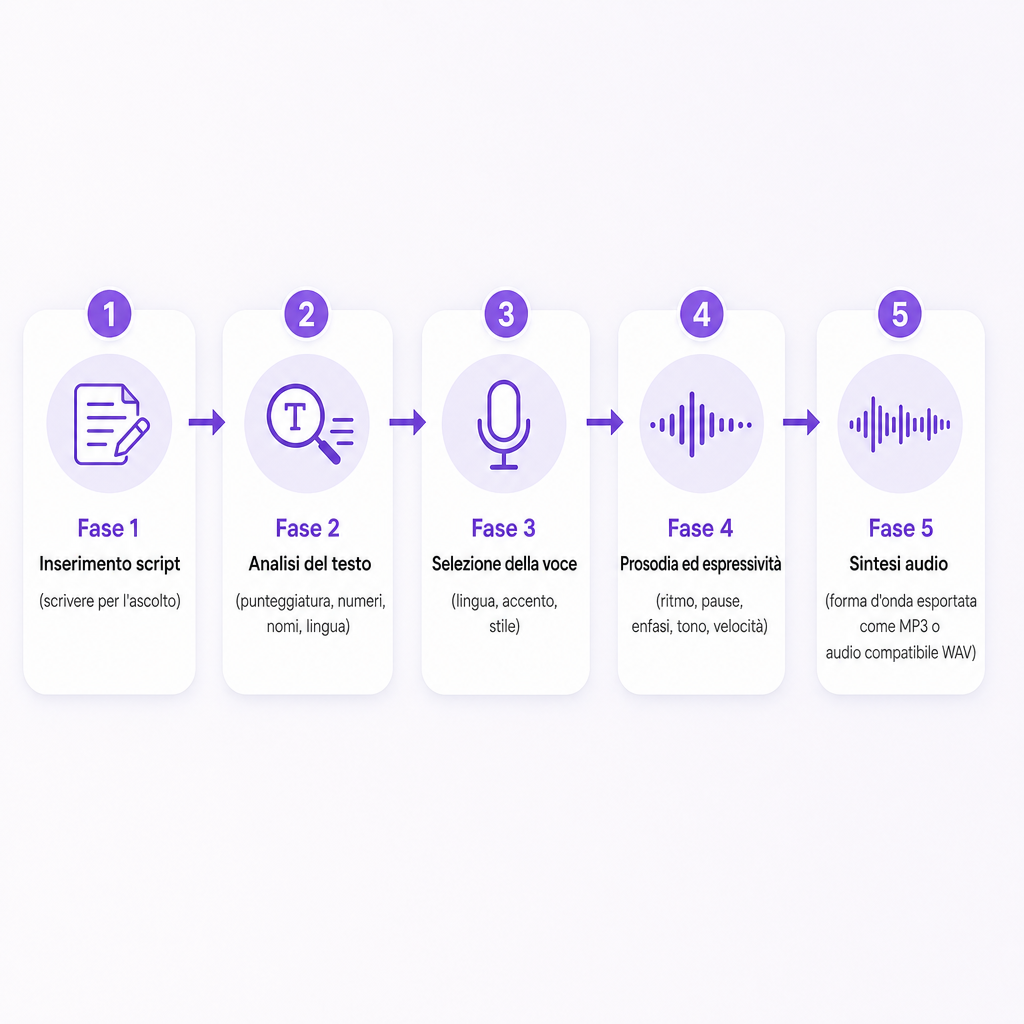
Poi scegli una voce. Le voci differiscono per lingua, accento, età o carattere vocale, presentazione di genere, stile di pronuncia, energia e formalità. Le impostazioni di output spesso includono velocità di pronuncia, intonazione, volume e frequenza di campionamento. Per un canale, la coerenza di solito batte il dramma. Una voce riconoscibile mantenuta attraverso i video rende il canale coerente, il che conta più che scegliere l'opzione più teatrale per un singolo caricamento.
Il motore genera quindi la prosodia, ovvero il ritmo, le pause, l'enfasi, i movimenti di intonazione e l'intonazione che distinguono un discorso espressivo da parole distanziate in modo uniforme. Alcuni strumenti espongono questi controlli direttamente; altri li deducono dalla punteggiatura, dalla struttura della frase o dalle istruzioni di stile. È qui che emerge la maggior parte delle lacune di qualità. Una voce può pronunciare ogni parola correttamente e sembrare comunque sbagliata se il ritmo o il tono emotivo contrastano con il video.
Infine il modello sintetizza l'audio, trasformando il testo analizzato in una forma d'onda che il servizio restituisce come file scaricabile. Un flusso di lavoro API può restituire dati audio codificati che decodifichi in un file riproducibile, mentre gli strumenti per creator ospitati gestiscono quel passaggio per te. Anche allora, la narrazione non è un video finito. Devi comunque posizionarla sulla timeline, tagliare i silenzi, aggiungere musica ed effetti, farla corrispondere alle immagini, bilanciare i livelli, aggiungere sottotitoli e rivedere pronuncia e timing. Per un video esplicativo, la voce dovrebbe seguire la sequenza visiva; una traccia tecnicamente pulita sembra comunque sciatta se le immagini cambiano prima che inizi la frase corrispondente. Se vuoi il quadro neurale completo, la nostra analisi di come funziona la sintesi vocale neurale approfondisce i dettagli interni del modello.
Quattro percorsi di produzione e quando ciascuno vince
La maggior parte delle narrazioni per YouTube si riduce a quattro opzioni, e quella giusta dipende da ciò di cui ha bisogno il video piuttosto che da quale suona più avanzata in un'anteprima.
| Percorso | Ideale per | Compromesso principale |
|---|---|---|
| Voce AI standard | Canali senza volto, video esplicativi, tutorial, riepiloghi in stile notiziario, Shorts | Veloce e affidabile, ma non legata a una persona specifica |
| Clone vocale personalizzato | Mantenere un'identità riconoscibile in molti video | Richiede una voce che sei autorizzato a riprodurre |
| TTS multilingue o doppiaggio | Video esplicativi tradotti, video di prodotto localizzati, test su nuovi mercati | Necessita di revisione della pronuncia e culturale per ogni lingua |
| Voiceover umano | Recitazione sfumata, testimonianze, formulazioni sensibili o critiche per il brand | Più lento e più difficile da scalare |
Una voce standard presa dalla libreria di un provider è il percorso più rapido per contenuti ad alto volume in cui non hai bisogno che la narrazione suoni come una persona in particolare. La clonazione vocale personalizzata crea una voce sintetica a partire da un campione audio, il che aiuta un creator a mantenere un'identità coerente senza registrare ogni script a mano. Usa la clonazione solo con il permesso e con una voce che hai il diritto di riprodurre; un clone non è una scorciatoia per possedere l'identità o la performance di qualcuno. Il nostro strumento di sintesi vocale ti dà accesso a voci AI e flussi di lavoro di clonazione, e la nostra pagina di clonazione vocale è il punto di partenza quando vuoi un narratore personalizzato riutilizzabile invece di uno standard.
La narrazione multilingue ti permette di tradurre uno script e sintetizzare una nuova traccia vocale in un'altra lingua, il che è utile per far crescere un canale educativo all'estero, localizzare video di prodotto o testare la domanda in un nuovo mercato. Il TTS parte dal testo; il nostro flusso di lavoro di doppiaggio AI aggiunge il più ampio livello di localizzazione, inclusa la traduzione e l'audio sostitutivo per un video esistente in 33 lingue. Un narratore umano vince comunque quando il video si basa su recitazione sfumata, testimonianza personale, argomenti sensibili, umorismo complesso, formulazioni legali o critiche per il brand, o sull'interpretazione di un performer distintivo. Molti canali adottano un approccio ibrido: narrazione AI per bozze, versioni e caricamenti ad alto volume, voce umana per i video di punta.
Quando la sintesi vocale si guadagna un posto su un canale
Il TTS per YouTube dà i suoi frutti soprattutto quando il tuo collo di bottiglia è la registrazione, non la scrittura. Se scrivere lo script è facile ma prenotare una sessione di registrazione è la parte lenta, la narrazione sintetica elimina il passaggio più lento.
I video educativi e didattici ne beneficiano direttamente. Aggiorna uno script e rigenera solo la sezione interessata invece di organizzare una nuova registrazione, il che si adatta a tutorial software, onboarding e contenuti di corsi che cambiano spesso. I canali senza volto possono narrare video costruiti da registrazioni dello schermo, filmati stock, animazioni, diapositive o immagini generate, anche se la voce ha comunque bisogno di una direzione editoriale; l'audio sovrapposto a filmati non correlati erode la fiducia degli spettatori. Gli Shorts beneficiano di un rapido passaggio da script ad audio, permettendoti di testare più hook o varianti di pubblico purché la voce non suoni affrettata o ripetitiva.
L'accessibilità è un altro uso legittimo. Una versione parlata di contenuti scritti aiuta gli spettatori che preferiscono l'audio o che faticano con il testo su schermo, ma la narrazione dovrebbe integrare sottotitoli accurati e un design visivo chiaro piuttosto che sostituirli. E per l'espansione multilingue, puoi produrre tracce vocali tradotte senza eseguire un processo di produzione separato per ogni lingua. La funzione Audio multilingue di YouTube consente ai creator idonei di allegare tracce audio aggiuntive a un singolo video o Short invece di gestire un canale separato per ogni mercato.
Scegliere e testare una voce prima di impegnarsi
Valuta una voce in base ai requisiti reali del video, non a un'anteprima lusinghiera di dieci secondi. Una voce che azzecca una battuta può crollare lungo uno script completo, quindi mettila alla prova prima.
- Abbina la voce al formato. Una pronuncia calma si adatta a un documentario o a un tutorial; una voce più energica si adatta a un hook o a un annuncio in formato breve. Lascia che siano l'argomento, il ritmo e il pubblico a decidere.
- Testa le parole difficili. Prima di generare un video completo, prova i tuoi nomi di brand ricorrenti, nomi di luoghi, acronimi, termini scientifici, parole straniere, unità di misura e nomi di persone. Una voce che gestisce frasi ordinarie può inciampare sul vocabolario del tuo canale.
- Verifica la coerenza nei formati lunghi. Genera un campione più lungo e ascolta per individuare intonazioni ripetitive, pause errate, ritmo innaturale, pronuncia variabile e transizioni brusche tra paragrafi.
- Considera il pubblico regionale. La narrazione in inglese può richiedere una pronuncia statunitense, britannica, australiana o altra. Per le altre lingue, conferma che la voce suoni naturale a un orecchio madrelingua, non solo che lo strumento elenchi la lingua.
- Esamina i diritti d'uso. Prima di monetizzare o fare pubblicità, leggi i termini del provider e conferma che la voce e l'output siano autorizzati per contenuti YouTube commerciali, lavori per clienti, annunci a pagamento e versioni derivate.
Anche alcune abitudini di scrittura migliorano rapidamente la qualità. Scrivi per il parlato sostituendo la prosa densa con frasi colloquiali e usando la punteggiatura per guidare le pause senza affidarti ad essa per l'emozione. Scrivi per esteso i termini ambigui così che il motore li legga correttamente, testando varianti come "AI" rispetto a "A.I." o "2026" rispetto a "ventiventisei". Genera per sezioni invece che in un unico file gigantesco così da poter rigenerare un singolo errore, riordinare le scene e far corrispondere l'audio alle immagini. Poi aggiungi la revisione umana: guarda il video completo con la traccia in riproduzione, taglia le pause imbarazzanti, correggi il timing e abbassa la musica sotto il parlato. L'AI riduce il tempo di registrazione; non elimina la revisione editoriale.
Diritti, divulgazione e caricamento di una traccia in una seconda lingua
La parte che i creator saltano più spesso è anche la parte che fa rimuovere i video. Se crei una versione in una lingua separata, puoi pubblicarla come nuovo video o usare la funzione Audio multilingue di YouTube dove disponibile, ma la piattaforma non crea per te quelle tracce doppiate. I creator devono preparare e caricare i propri file audio in un formato audio supportato, all'incirca della stessa lunghezza del video. YouTube può anche rimuovere un file audio secondario se il suo contenuto protetto da copyright differisce dall'originale, il che rende essenziale la revisione dei diritti quando la tua traccia doppiata include musica, clip o altro materiale protetto.
La divulgazione è un obbligo separato. YouTube richiede ai creator di divulgare contenuti generati o modificati dall'AI che sembrano realistici, inclusi contenuti che fanno apparire una persona reale mentre dice o fa qualcosa che non ha fatto, alterano filmati di un evento o luogo reale, o fabbricano una scena realistica. In particolare, YouTube elenca la clonazione della propria voce per voiceover o doppiaggi tra gli esempi che non richiedono divulgazione secondo quella specifica policy. Questa non è una licenza per clonare la voce di qualcun altro, e l'etichettatura di contenuti sintetici non autorizza l'uso del volto o della voce di un'altra persona senza permesso.
Una politica editoriale sicura consiste nell'usare la propria voce o una con licenza, conservare i documenti di autorizzazione per qualsiasi campione vocale personalizzato, evitare di imitare una persona reale senza autorizzazione, verificare i termini d'uso commerciale, divulgare contenuti sintetici o alterati realistici quando YouTube lo richiede e rivedere separatamente i diritti su musica, filmati e audio tradotto. Per i team che generano ripetutamente narrazioni da un sistema di contenuti o da un'app, la nostra API di sintesi vocale è progettata per la generazione vocale programmatica così da poter produrre tracce in volume senza ricostruire ogni volta il flusso di lavoro.
Quindi, vale la pena usare la sintesi vocale per YouTube? È una scelta valida quando hai bisogno di narrazioni ripetibili, revisioni rapide, versioni multilingue o un voiceover senza attrezzatura di registrazione. È una scelta meno adatta quando il successo del video dipende da una recitazione sfumata, da una testimonianza personale o da una performance legalmente sensibile. Lo standard che conta non è se gli spettatori possono capire che una voce è sintetica. È se la narrazione è chiara, appropriata, coerente, utilizzabile legalmente e ben integrata con il video.
Domande frequenti
Posso usare audio con sintesi vocale su YouTube?
Sì. Puoi usare la narrazione generata in un video YouTube purché rispetti i termini di licenza del provider TTS, le policy di YouTube e i diritti legati al tuo script, musica, filmati e voce.
YouTube trasforma automaticamente uno script in narrazione?
No. La funzione Audio multilingue di YouTube non crea per te le tracce doppiate. I creator devono preparare e caricare i propri file audio.
Qual è la differenza tra la sintesi vocale per YouTube e il doppiaggio automatico?
La sintesi vocale converte il testo scritto in audio parlato. Il doppiaggio automatico è un processo di localizzazione più ampio che può tradurre e generare una traccia in una lingua sostitutiva per contenuti esistenti. Le funzionalità esatte dipendono dalla piattaforma e dal flusso di lavoro.
Posso clonare la mia voce per i video YouTube?
Puoi usare un clone vocale quando hai il diritto di crearlo e usarlo. YouTube elenca la clonazione della propria voce per voiceover o doppiaggi come un esempio che non richiede divulgazione secondo la sua policy sui contenuti realistici, anche se altri contenuti generati o alterati dall'AI potrebbero comunque richiedere la divulgazione.
Quale file audio devo caricare per una seconda lingua?
Per la funzione Audio multilingue di YouTube, il file deve essere in un formato audio supportato e all'incirca della stessa lunghezza del video. Controlla l'attuale interfaccia di caricamento di YouTube Studio prima di esportare.