Chiedi come funziona la sintesi vocale neurale e la risposta breve è questa: converte il testo scritto in audio realistico eseguendo il tuo script attraverso reti neurali profonde che modellano il modo in cui gli esseri umani parlano realmente—pronuncia, ritmo e intonazione insieme. Invece di ricucire insieme frammenti pre-registrati come facevano i sistemi più vecchi, il TTS neurale genera il parlato da zero, apprendendo schemi direttamente da grandi dataset di registrazioni umane reali abbinate al testo. Questa distinzione è il motivo per cui le voci sintetiche moderne suonano come un narratore che potresti ascoltare per un intero video piuttosto che come un annuncio robotico. Da DubSmart AI, ci basiamo su questo stesso approccio neurale per alimentare il nostro Text to Speech, collegandolo alla clonazione vocale e al doppiaggio in modo che un singolo script possa viaggiare da una lingua a molte.
Questa guida illustra il meccanismo fase per fase, per poi tradurlo in decisioni pratiche: dove una voce neurale è abbastanza forte da reggersi da sola, dove vuoi ancora una performance umana, e come i pezzi si incastrano all'interno della nostra piattaforma.
Indice dei contenuti
Cosa significa davvero "come funziona la sintesi vocale neurale"
La sintesi vocale neurale è una forma di sintesi del parlato che utilizza reti neurali profonde per generare il parlato da zero. La differenza fondamentale rispetto ai metodi basati su regole o concatenativi è che il sistema apprende da grandi dataset di registrazioni umane abbinate al testo, così può prevedere sia come dovrebbero suonare le parole sia come una persona le pronuncerebbe naturalmente. Questo comportamento appreso è ciò che cattura la prosodia—accento, ritmo, pause e tono emotivo—rendendo la voce risultante piacevole durante lunghe sessioni di ascolto. I principali provider cloud descrivono queste voci neurali come parlato sintetizzato simile a quello umano la cui articolazione riduce l'affaticamento uditivo in assistenti, strumenti di accessibilità ed esperienze di lettura ad alta voce.
Il nostro motore Text to Speech segue questo percorso neurale. Analizza il tuo script, lo scompone in fonemi, deduce ritmo e intonazione, poi utilizza modelli neurali per rendere un audio fluido invece della resa piatta associata al TTS tradizionale. Il risultato è un parlato realistico generato dal testo in pochi secondi, tratto da una libreria di oltre 300 voci adattate a diversi toni e casi d'uso.
Perché il TTS neurale conta per creator e team
Per creator di YouTube, piccole imprese, produttori di e-learning, filmmaker, podcaster e sviluppatori, la vera domanda non è solo come funziona la tecnologia ma se affidarcisi in una pipeline di produzione. Il TTS neurale conta perché sposta le voci sintetiche fuori dal territorio "utilitario"—indicazioni GPS, prompt di base—verso il territorio della performance: abbastanza buone da essere in prima linea nei contenuti, narrare corsi completi e veicolare messaggi di brand senza suonare ovviamente artificiali. Abbinalo alla traduzione e al doppiaggio e diventa un moltiplicatore, permettendo a un singolo script di raggiungere decine di lingue a una frazione del costo e del tempo del lavoro tradizionale in studio.
Abbiamo progettato DubSmart proprio attorno a questa decisione. Text to Speech, Voice Cloning, AI Dubbing, Speech to Text, Speech Separator, Text to Image e Image to Video risiedono in un'unica pipeline, così i contenuti parlati passano dal caricamento all'esportazione multilingue senza dover destreggiarsi tra strumenti separati. Scegli quanto automatizzare e quanto personalizzare in ogni fase—script, voce, lingua, mix—all'interno di un unico ambiente.
Dove tutto questo si concretizza dipende da cosa produci:
- Espandere un canale YouTube in nuove lingue: il TTS neurale più il doppiaggio ti permettono di riutilizzare script e timing sostituendo voci localizzate.
- Localizzare video di marketing o formazione: ottieni una narrazione di brand coerente in tutte le lingue senza ingaggiare voce ogni volta che aggiorni.
- Produrre e-learning o formazione aziendale: la narrazione di formato lungo diventa scalabile e facile da revisionare quando i contenuti cambiano.
- Gestire un podcast o un film indipendente: puoi creare versioni multilingue, inserti di narrazione o tracce di accessibilità.
- Costruire applicazioni: le nostre API trasformano il parlato neurale in un servizio richiamabile per IVR, agenti e strumenti di contenuto.
Comprendere il meccanismo ti aiuta a valutare dove una voce neurale può reggersi da sola e dove una registrazione umana dovrebbe rimanere la fonte per la clonazione o il doppiaggio.
Sotto il cofano: la pipeline del TTS neurale
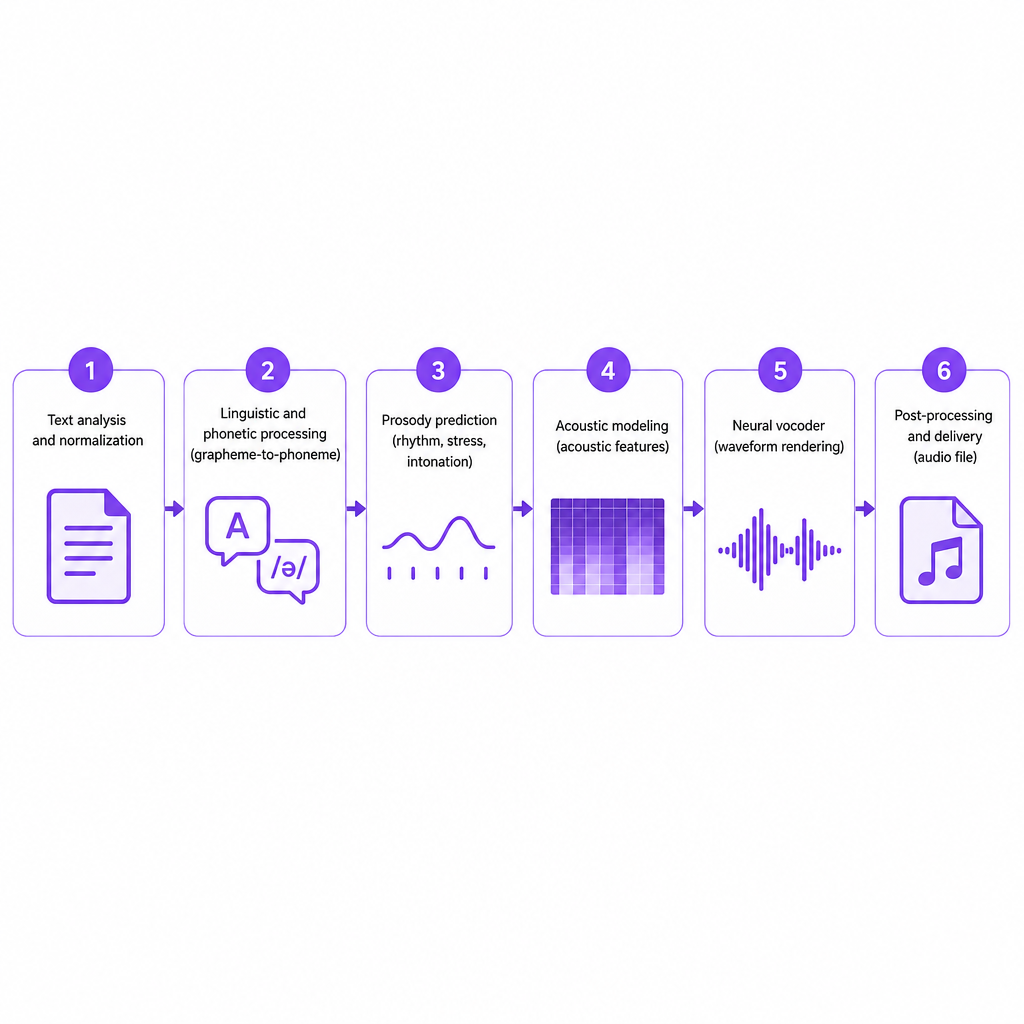
I motori differiscono nei dettagli, ma condividono una pipeline ampiamente simile descritta nella documentazione tecnica e nelle dichiarazioni di AI responsabile dei principali provider, e le nostre spiegazioni su come vengono creati i voiceover AI si allineano con essa.
Analisi e normalizzazione del testo
Prima il sistema acquisisce il tuo testo e lo normalizza in una forma pronunciabile. Ciò significa espandere numeri ("2026" diventa "duemilaventisei"), date e abbreviazioni; risolvere token ambigui come "US" contro "us" in base al contesto; e leggere punteggiatura e struttura per pianificare pause ed enfasi. Il nostro motore interpreta punteggiatura e struttura per dedurre ritmo e flusso invece di trattare il testo come un flusso piatto di caratteri. Questa fase ha un peso reale per gli script più lunghi—corsi, spiegazioni, podcast—dove la struttura dei paragrafi e i titoli modellano il modo in cui una persona leggerebbe naturalmente.
Elaborazione linguistica e fonetica
Il testo normalizzato viene convertito in fonemi, le unità sonore di base di una lingua. Un modello grafema-fonema mappa i caratteri sui suoni, gestendo regole di pronuncia, eccezioni e input multilingue. Questo è ciò che permette al nostro Text to Speech di accettare script in molte lingue e produrre la sequenza fonetica corretta per quella selezionata, che tu usi una voce integrata o una voce clonata. Le nostre voci neurali coprono più di 33 lingue, tra cui inglese, portoghese, spagnolo, francese, tedesco, cinese e giapponese.
Previsione della prosodia
La prosodia—ritmo, accento e intonazione—è la differenza tra una voce robotica e una performance simile a quella umana. I modelli neurali apprendono i pattern prosodici direttamente dalle registrazioni, così possono decidere dove fare pausa e per quanto tempo, scegliere quali parole enfatizzare e regolare tono ed energia lungo una frase o un paragrafo. Le voci neurali ad alta definizione vanno oltre, rilevando il sentiment nel testo e regolando il tono mantenendo una persona stabile, il che è ciò che consente una resa conversazionale o empatica per contenuti di supporto e narrazione. Il nostro motore deduce la prosodia prima di sintetizzare l'audio per lo stesso motivo: evitare una resa piatta e produrre un parlato che potresti ascoltare per un intero modulo.
Modellazione acustica
Una volta stabiliti fonemi e prosodia, un modello acustico neurale converte quella rappresentazione in caratteristiche acustiche—un progetto per l'onda sonora. Le dichiarazioni di AI responsabile notano che, insieme alle registrazioni di una specifica voce professionale, questi modelli attingono anche a una libreria sorgente più ampia di molti oratori. Questo mix aiuta la rete ad apprendere pattern generali del parlato pur catturando il timbro, l'accento e lo stile di una particolare voce. Nella nostra piattaforma, questa modellazione è ciò che permette a oltre 300 voci di suonare distinte ma naturali, e sta alla base della clonazione vocale rapida, dove il sistema apprende la firma acustica e prosodica di una voce da un breve campione.
Vocoder e resa audio
Le caratteristiche acustiche passano a un vocoder neurale, che le rende in una forma d'onda audio completa. I vocoder più recenti producono un parlato ad alta fedeltà quasi indistinguibile dalle registrazioni in studio, con consonanti chiare, vocali fluide e artefatti minimi. La combinazione di modello acustico neurale più vocoder è il motivo per cui le voci neurali suonano molto più naturali della tecnologia più vecchia usata negli screen reader e negli IVR tradizionali. Utilizziamo progressi simili così l'audio generato è pronto per essere pubblicato direttamente o inserito in un mix con musica ed effetti sonori.
Post-elaborazione e consegna
Infine il sistema può applicare la post-elaborazione—modellazione del rumore, normalizzazione del volume o conversione di formato—prima di restituire il file audio. Per i flussi di lavoro API, ciò è racchiuso in un endpoint RESTful che accetta parametri di testo e voce e restituisce un asset pronto all'uso. Il nostro Text to Speech segue esattamente questo flusso: incolla o invia il testo, scegli lingua e voce, regola la resa dove i controlli sono esposti, genera e scarica audio in formato standard. Lo stesso motore sta alla base del nostro AI Dubbing, dove trascrizione, traduzione e sintesi sono concatenate per creare versioni multilingue.
Opzioni in DubSmart: voci, clonazione, doppiaggio e API
Conoscere i meccanismi spiega perché il nostro set di funzionalità è costruito nel modo in cui è.
Text to Speech per la narrazione diretta
Il nostro strumento Text to Speech è l'interfaccia principale per trasformare gli script in audio. Incolli o carichi il testo in qualsiasi lingua supportata, scegli tra le oltre 300 voci dal suono naturale, imposti lingua e controlli di resa di base dove disponibili, e generi il parlato in pochi secondi. Copre hook per YouTube e narrazione completa di video, voiceover esplicativi e promozionali per piccole imprese, moduli di e-learning e formazione chiari, e intro, outro e mid-roll di podcast. Se stai valutando strumenti per quel lavoro, la nostra panoramica del miglior software di doppiaggio AI per creator mostra come narrazione e localizzazione si collegano.
Clonazione vocale: mantenere la voce del tuo brand o del tuo conduttore
La clonazione vocale si basa sugli stessi passaggi neurali—fonemi, prosodia, caratteristiche acustiche—ma ottimizza la rete per corrispondere a un timbro e uno stile specifici, così puoi generare nuove battute in quella voce senza ri-registrare. La nostra clonazione vocale rapida crea voci personalizzate che puoi usare all'interno di Text to Speech o AI Dubbing, il che significa che i contenuti localizzati suonano ancora come il tuo conduttore, narratore o brand. Questa continuità conta di più per i canali e le aziende che hanno investito in un'identità vocale riconoscibile.
AI Dubbing: concatenare speech to text, traduzione e TTS
Il doppiaggio AI utilizza il motore TTS come ultimo passaggio in una catena più lunga: trascrivere l'audio esistente, tradurre la trascrizione, poi sintetizzare il nuovo parlato nella lingua di destinazione. Il nostro AI Dubbing mantiene doppiaggio, text-to-speech, speech-to-text e clonazione all'interno di un unico flusso di lavoro così i contenuti passano dal caricamento all'esportazione multilingue senza lasciare la piattaforma. In pratica puoi caricare un video o un podcast, farlo trascrivere e separare dall'audio di sottofondo, tradurre in una o più lingue, poi generare tracce doppiate usando voci di repertorio o clonate che preservano timing e tono. Per una guida sui contenuti parlati, consulta la nostra guida su come tradurre un podcast in un'altra lingua.
API per sviluppatori e agenzie
Esponiamo il TTS neurale e il doppiaggio tramite API così sviluppatori e agenzie possono integrare la generazione vocale nei loro prodotti. La nostra API Text to Speech è un servizio RESTful che accetta una richiesta POST con contenuto testuale e preferenze vocali e restituisce audio di alta qualità, con accesso a voci neurali premium in più di 33 lingue. L'API AI Dubbing estende ciò al doppiaggio multilingue automatizzato. Per le agenzie che gestiscono la localizzazione tra clienti, questi endpoint standardizzano la generazione vocale pur personalizzando lingue e persona per ogni brand.
Criteri decisionali: scegliere e usare bene il TTS neurale
Una volta che il meccanismo è chiaro, il lavoro pratico consiste nel decidere quando e come usarlo.
Naturalezza e comfort d'ascolto. Il test fondamentale è se la voce è abbastanza naturale da essere accettata dal tuo pubblico come narratore principale. Le reti neurali profonde e le voci HD sono costruite per ridurre l'affaticamento uditivo, ma la scelta giusta dipende comunque dal tipo di contenuto. Usa la nostra ampia libreria di voci per testare le persona—energica, calma, giocosa, autorevole—e per corsi o podcast di formato lungo, prediligi voci la cui prosodia sembra conversazionale piuttosto che da annuncio.
Copertura linguistica e adeguatezza dell'accento. Per l'espansione multilingue hai bisogno sia della lingua sia di un accento appropriato per il pubblico di destinazione. Le nostre voci neurali coprono più di 33 lingue nei principali mercati. Quando scegli tracce localizzate, decidi se vuoi un accento neutro o specifico per regione, e testa i campioni con madrelingua ove possibile.
Coerenza del brand rispetto alla flessibilità. La clonazione porta una voce specifica attraverso lingue e progetti, ma introduce responsabilità in materia di consenso e divulgazione. Usala quando una persona coerente è centrale per il tuo brand, e documenta chi possiede e controlla quella voce—specialmente nel lavoro aziendale o di agenzia.
Integrazione del flusso di lavoro. Il TTS neurale offre il massimo valore quando si inserisce nel modo in cui già lavori. Poiché i nostri strumenti combinano text-to-speech, clonazione, doppiaggio, speech to text e utility multimediali, puoi automatizzare gran parte della catena di localizzazione pur modificando script e audio. I creator solitari possono trovare sufficienti gli strumenti nel browser; sviluppatori e agenzie ottengono endpoint programmabili per scalare.
Rischi, limiti e uso responsabile
Anche i modelli avanzati hanno confini che vale la pena pianificare.
- Sfumature emotive: le voci HD rispondono al sentiment, ma possono perdere segnali sottili o performance complesse che un attore esperto offrirebbe. Messaggi di brand critici o drammi narrativi possono comunque richiedere una registrazione umana come fonte.
- Casi limite di pronuncia: nomi rari, termini nuovi o script multilingue possono mettere in difficoltà i modelli grafema-fonema, quindi inserisci controlli manuali.
- Etica della clonazione: le linee guida sull'AI responsabile sottolineano che le voci personalizzate dovrebbero essere costruite e usate con consenso esplicito, contratti chiari e divulgazione al pubblico. Imitare persone senza permesso solleva preoccupazioni legali ed etiche.
- Bias e rappresentazione: i dati di addestramento modellano il modo in cui le voci gestiscono accenti e dialetti, quindi verifica che le voci scelte rappresentino equamente il tuo pubblico ed evitino di rafforzare gli stereotipi.
Poiché il nostro flusso di lavoro integrato rende facile generare e distribuire parlato sintetico, la revisione interna conta di più, non di meno—in particolare quando gestisci voci di clienti o dipendenti. Un percorso concreto aiuta: un creator può scrivere un singolo script in inglese, generare un voiceover in inglese, poi doppiare versioni in spagnolo, portoghese e tedesco per canali aggiuntivi mantenendo lo stesso timing e la stessa resa. Un team di formazione può costruire narrazione modulare e rigenerarla rapidamente ogni volta che le policy cambiano. Questa è la vera ricompensa nel comprendere la pipeline—sai quale fase controllare e quale lasciare gestire al modello.
Domande frequenti
Cos'è la sintesi vocale neurale in termini semplici?
La sintesi vocale neurale è un'IA che trasforma il testo scritto in parlato usando reti neurali profonde addestrate su grandi dataset di registrazioni umane, producendo voci che suonano molto più vicine a persone reali rispetto ai sistemi TTS più vecchi.
In cosa il Text to Speech di DubSmart è diverso dal TTS di base?
Utilizziamo modelli neurali che analizzano il tuo script, deducono la prosodia e sintetizzano il parlato da zero, supportati da oltre 300 voci naturali e dalla clonazione vocale rapida, così l'output funziona come narratore principale per video, corsi e podcast.
DubSmart può mantenere la mia voce in altre lingue?
Sì. La nostra clonazione vocale può apprendere la tua voce dalle registrazioni e poi usarla nel text-to-speech e nel doppiaggio AI, così le versioni localizzate dei tuoi contenuti suonano ancora come te o il narratore del tuo brand.
Come funziona il doppiaggio AI con il TTS neurale?
Il doppiaggio AI concatena trascrizione speech-to-text, traduzione e sintesi vocale neurale, trasformando il tuo audio esistente in tracce doppiate multilingue in un unico flusso di lavoro, usando voci di repertorio o la tua voce clonata.
La sintesi vocale neurale è sicura ed etica da usare?
Usato con consenso, chiara divulgazione e adeguate salvaguardie, il TTS neurale è uno strumento potente per l'accessibilità e la localizzazione. Le linee guida sull'AI responsabile enfatizzano il rispetto dei diritti delle voci professionali e l'evitare usi ingannevoli delle voci sintetiche.