Una trascrizione pulita da un podcast o video di formazione di 30 minuti è realistica in meno di 10 minuti con DubSmart AI, e la maggior parte dei creator la gestisce per una cifra compresa tra $0 e circa $20–$50 al mese a seconda del volume. Se vuoi sapere come trascrivere audio in testo senza dover combinare un'app di trascrizione separata, un riduttore di rumore e un editor di sottotitoli, il nostro motore Speech to Text esegue l'intero lavoro in un unico spazio di lavoro: carica il contenuto multimediale, genera testo con una precisione superiore al 95% su audio chiaro, modifica le etichette degli speaker e la punteggiatura, quindi esporta una trascrizione o sottotitoli pronti per la pubblicazione.
Il vero vantaggio qui non è solo la velocità. Poiché trascrizione, pulizia audio, doppiaggio e voiceover condividono lo stesso pool di crediti, la stessa trascrizione che crei oggi può alimentare in seguito AI Dubbing in 33 lingue di destinazione o Text to Speech con oltre 300 voci. Questo è importante se gestisci un canale YouTube, crei corsi di e-learning o localizzi formazione aziendale.
Indice dei contenuti
Cosa ti serve prima di iniziare
La qualità della trascrizione si decide prima di premere un solo pulsante. Esamina prima questa checklist:
- Un account DubSmart con accesso a Speech to Text e Speech Separator con piano Free, Starter o superiore.
- I tuoi file sorgente pronti all'uso: episodi di podcast, webinar, interviste o un link YouTube.
- I diritti e il permesso di trascrivere il contenuto, cosa che conta soprattutto per il lavoro con i clienti e le registrazioni di terze parti.
- Un output di destinazione chiaro in mente: una trascrizione completa (DOC/TXT), sottotitoli (SRT/VTT) o uno script per doppiaggio e voiceover.
- Informazioni di base sulla registrazione: lingua sorgente, numero di speaker e se è presente musica o rumore di fondo intenso.
- Per i team regolamentati, le tue linee guida interne sulla gestione di dati personali o sensibili negli strumenti cloud.
Conoscere in anticipo il formato di output ti evita un passaggio extra. Un lavoro di note di blog richiede testo semplice; un caricamento su YouTube richiede sottotitoli temporizzati; un lavoro di localizzazione richiede uno script pulito che puoi inviare direttamente al doppiaggio.
Passo dopo passo: trascrivere audio in testo con DubSmart
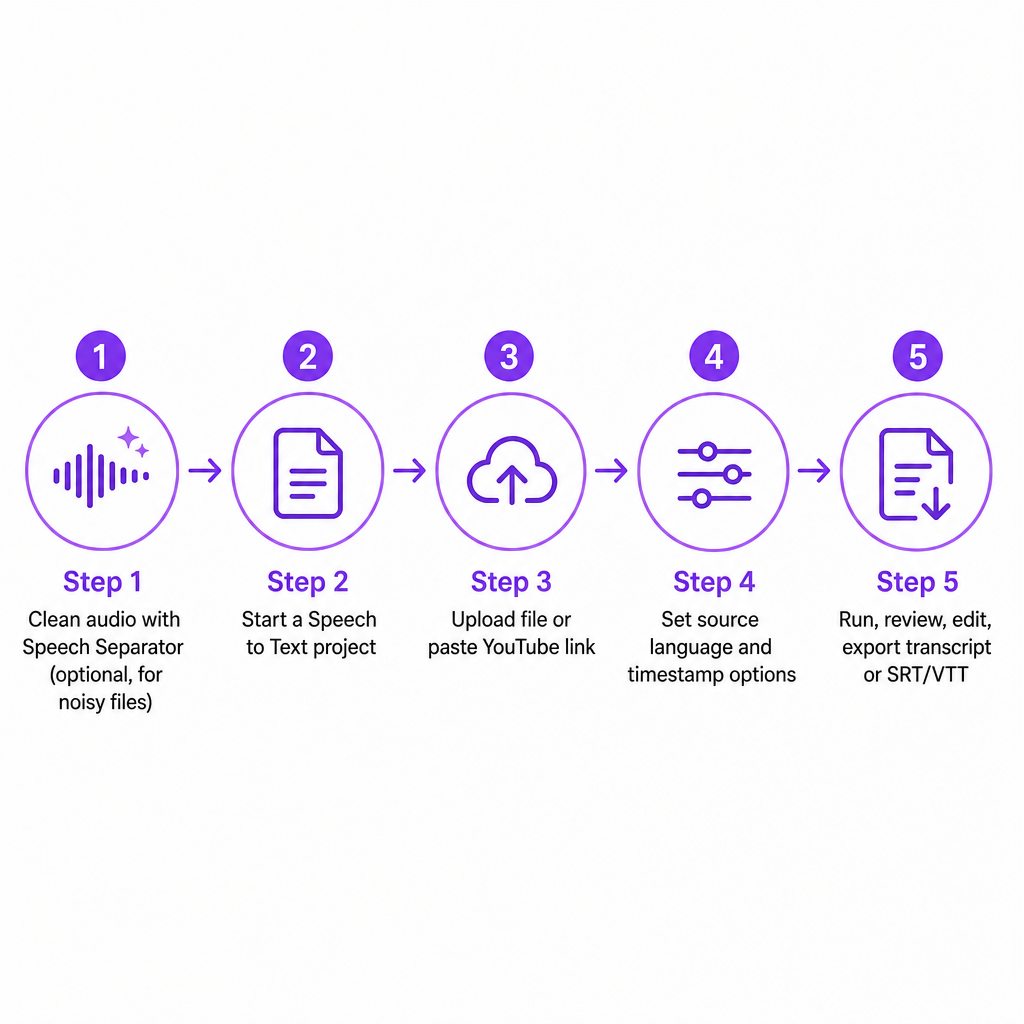
1. Scegli gli strumenti giusti per la registrazione
Speech to Text converte l'audio parlato in testo scritto e funziona insieme a Speech Separator per le registrazioni rumorose. I crediti sono condivisi tra AI Dubbing, Text to Speech, Voice Cloning, Speech to Text e Speech Separator, quindi ogni minuto che elabori attinge dallo stesso pool.
La decisione è semplice. Se la registrazione presenta musica, rumore di folla o eco della stanza, inizia con Speech Separator per isolare le voci. Se l'audio è già pulito, passa direttamente alla trascrizione.
2. Pulisci l'audio con Speech Separator (consigliato)
Un input di alta qualità è il singolo fattore più importante per una trascrizione automatica accurata, specialmente per podcast, interviste e panel con più speaker. Speech Separator isola la voce dalla musica e dal rumore di fondo nei formati comuni come MP3, WAV e AAC, lasciando una traccia vocale più pulita.
- Apri lo strumento Speech Separator nel tuo account.
- Carica il tuo audio o video dal tuo dispositivo, oppure selezionalo dai tuoi progetti.
- Lascia che l'IA separi la voce dal sottofondo; di solito si completa in pochi secondi o minuti a seconda della durata.
- Salva il file vocale pulito nella libreria del tuo progetto.
Con quella traccia pulita in mano, la fase di trascrizione produce meno errori e richiede meno correzioni manuali.
3. Avvia un nuovo progetto Speech to Text
Il flusso è volutamente breve: seleziona la funzione, carica il contenuto multimediale, modifica, esporta.
- Accedi e apri la dashboard dello spazio di lavoro.
- Scegli Speech to Text dall'elenco degli strumenti.
- Crea un nuovo progetto e dagli un nome descrittivo, come "Webinar sul prodotto – Ottobre".
Nominare i progetti mantiene le trascrizioni organizzate e le rende facili da riutilizzare in seguito per sottotitolazione, doppiaggio o text-to-speech.
4. Carica il tuo audio o video
Puoi caricare i file direttamente o importarli da un URL di YouTube, cosa utile per creator e agenzie che gestiscono i canali dei clienti.
- Carica audio o video dal tuo dispositivo in formati standard come MP3, WAV e MP4.
- Incolla un URL di YouTube per importare il video direttamente nel progetto, inclusi i caricamenti in 1080p dove supportati.
DubSmart analizza quindi il file, estrae l'audio e lo prepara per il riconoscimento.
5. Imposta la lingua e le opzioni di riconoscimento
Speech to Text supporta oltre 60 lingue tra cui inglese, spagnolo, tedesco, hindi, turco, portoghese, giapponese, russo, cinese e arabo. Impostare la lingua sorgente corretta non è un dettaglio opzionale; il motore si affida a modelli specifici per lingua per decodificare il parlato in testo.
- Scegli la lingua sorgente che corrisponde alla registrazione. Per contenuti multilingue, inizia con la lingua dominante.
- Se ci sono più speaker, pianifica di aggiungere le etichette degli speaker durante la modifica.
- Conferma le opzioni di timestamp e segmentazione se intendi esportare sottotitoli SRT o VTT invece di una trascrizione semplice.
Per la maggior parte dei file con un singolo speaker, il riconoscimento avviene al ritmo del tempo reale o più velocemente, quindi l'elaborazione spesso si completa entro la durata della registrazione.
6. Esegui la trascrizione
Avvia il processo e lascia che il motore lavori. Segmenta l'audio, identifica fonemi e parole e applica i modelli linguistici per produrre testo. Su audio chiaro, la precisione raggiunge oltre il 95%, riducendo drasticamente il carico di correzione. Mentre è in esecuzione, prepara un breve glossario di nomi, brand o termini tecnici che già sai dovrai standardizzare.
7. Rivedi e modifica la trascrizione
L'output automatico è veloce, ma un testo di livello professionale richiede comunque una revisione umana, specialmente per nomi, acronimi e gergo. Modifica direttamente all'interno dell'editor del progetto:
- Leggi tutto ascoltando le sezioni chiave per individuare parole fraintese.
- Aggiungi etichette degli speaker come Host, Ospite o Istruttore così il dialogo è facile da seguire.
- Correggi la punteggiatura e le maiuscole, che influenzano sia la leggibilità sia la temporizzazione dei sottotitoli.
- Standardizza la terminologia, come nomi di prodotti, termini medici o frasi legali, in base al tuo glossario di brand o di conformità.
Poiché la stessa trascrizione può in seguito alimentare AI Dubbing in oltre 33 lingue e Text to Speech con oltre 300 voci, una modifica attenta ora dà i suoi frutti ogni volta che riutilizzi il contenuto.
8. Esporta testo o sottotitoli
Quando le modifiche sembrano corrette, esporta nel formato di cui ha bisogno il tuo caso d'uso:
- Sottotitoli (SRT o VTT) per YouTube, piattaforme LMS e portali video aziendali.
- Testo semplice (TXT) o formati documento per blog, note di show, manuali di formazione e verbali di riunione.
Scegli il formato, poi scarica o salva il progetto finito. Questo completa il flusso di lavoro principale su come trascrivere audio in testo in DubSmart.
Tempo e costo: cosa aspettarsi
DubSmart funziona con un sistema basato su crediti che si applica ad AI Dubbing, Text to Speech, Voice Cloning, Speech to Text e Speech Separator. I crediti sono intercambiabili, quindi un unico pool copre i minuti di trascrizione, la pulizia audio e il doppiaggio. Dai nostri prezzi pubblicati:
| Piano | Prezzo mensile | Crediti mensili | Note |
|---|---|---|---|
| Free | $0 | 2.000 | Circa 2 minuti di AI Dubbing/TTS per testare il flusso di lavoro |
| Starter | ~$20 | 50.000 | Circa 50 minuti di AI Dubbing/TTS; i crediti non utilizzati vengono riportati |
| Standard | ~$50 | 150.000 | Volume più elevato con un costo inferiore per 1.000 crediti |
Poiché i crediti coprono trascrizione, pulizia della voce e doppiaggio, puoi trattare l'intera pipeline come un unico budget invece di strumenti separati. Per la maggior parte dei creator questo significa trascrivere decine di video brevi al mese con i prezzi del piano Starter mantenendo libera la capacità di crediti per doppiaggi e voiceover.
Errori comuni e come correggerli
Usare audio rumoroso senza pulirlo. Musica di sottofondo, rumore di folla o eco causano errori di riconoscimento e modifiche aggiuntive. Fai prima passare il file attraverso Speech Separator, poi trascrivi la traccia vocale isolata per una maggiore precisione e una temporizzazione dei sottotitoli più pulita.
Selezionare la lingua sorgente sbagliata. Se la lasci sull'inglese quando l'audio è in spagnolo, il motore interpreta male i fonemi e produce testo inutilizzabile. Ricontrolla la lingua prima di iniziare e, per i video multilingue, segmenta per lingua o dai priorità alla lingua principale per la prima passata.
Ignorare le etichette degli speaker. Podcast e panel con più speaker sono difficili da leggere senza attribuzione. Aggiungi etichette come Host, Ospite 1 o tag basati sui nomi durante la modifica e mantienile coerenti tra gli episodi.
Saltare la revisione umana per contenuti ad alto rischio. Per materiale legale, medico o sensibile alla conformità, un piccolo errore può cambiare il significato. Tratta la trascrizione automatica come una prima bozza ed esegui una validazione umana completa, abbinandola a revisori interni o a controlli di conformità esterni dove necessario.
Stimare male i crediti. Elaborare un ampio catalogo arretrato senza comprendere l'utilizzo può prosciugare la tua quota. Controlla prima i crediti mensili del tuo piano e la politica di riporto, poi esegui un piccolo lotto pilota per misurare i minuti per credito tra Speech Separator e Speech to Text prima di impegnarti in un lavoro in blocco.
Fai da te vs aiuto professionale: dove tracciare il confine
DubSmart è pensato per l'uso in self-service da parte di creator, piccole imprese, team di e-learning e agenzie che desiderano contenuti multilingue scalabili senza dover destreggiarsi tra più fornitori. Strumenti basati su browser, un piano gratuito e un modello di crediti condivisi permettono alla maggior parte degli utenti di gestire autonomamente trascrizione, pulizia e doppiaggio.
Il self-service è di solito sufficiente quando:
- Trascrivi contenuti episodici come podcast, video YouTube, demo di prodotti o formazione interna.
- L'audio è ragionevolmente pulito o può essere migliorato con Speech Separator.
- La precisione deve essere elevata ma non legalmente vincolante, come sottotitoli per l'accessibilità, materiali didattici o materiale di marketing.
- Il tuo volume mensile rientra nei crediti disponibili con spazio residuo per doppiaggi o voiceover.
Orientati verso un supporto professionale o a livello enterprise quando:
- Gestisci cataloghi di grandi dimensioni, centinaia di ore, che necessitano di QA, stile e terminologia coerenti tra le regioni.
- I tuoi contenuti ricadono sotto rigorosi standard legali o normativi, come procedimenti giudiziari, documentazione medica o informative finanziarie.
- Devi integrare la nostra AI Dubbing API o la Text to Speech API in flussi di lavoro complessi con requisiti di uptime e throughput per i clienti.
In questi casi, abbinare la nostra automazione a una revisione linguistica o di conformità professionale ti offre il miglior equilibrio tra velocità, costo e rischio. Per la maggior parte delle trascrizioni quotidiane, il percorso self-service è più veloce ed economico, e mantiene la tua trascrizione pronta a diventare sottotitoli, doppiaggi o voiceover ogni volta che ne hai bisogno.
Domande frequenti
Quali tipi di contenuto può trascrivere DubSmart?
Speech to Text gestisce podcast, video YouTube, webinar, interviste, film e formazione aziendale, purché l'audio sia disponibile tramite caricamento o link.
Quali lingue sono supportate per la trascrizione?
Speech to Text supporta oltre 60 lingue, tra cui inglese, spagnolo, tedesco, hindi, turco, portoghese, giapponese, russo, cinese e arabo, e la stessa piattaforma doppia in 33 lingue di destinazione.
Quanto è accurato lo Speech to Text di DubSmart?
Su audio chiaro con la lingua corretta selezionata, la precisione raggiunge oltre il 95%, in linea con il moderno riconoscimento vocale automatico.
Quanto costa trascrivere con DubSmart?
I prezzi partono da $0/mese con un piano gratuito di 2.000 crediti. I piani a pagamento come Starter (circa $20/mese) e Standard (circa $50/mese) aggiungono crediti e abbassano il costo per credito, e i crediti sono condivisi tra trascrizione, doppiaggio e strumenti correlati.
Posso usare la trascrizione per doppiaggi e voiceover?
Sì. L'output di Speech to Text può alimentare direttamente AI Dubbing e Text to Speech per produrre versioni doppiate multilingue e voiceover con IA utilizzando oltre 300 voci dal suono naturale.