Jika Anda sedang mempertimbangkan voiceforge text to speech untuk sebuah proyek, pertanyaan sebenarnya jarang menyangkut apakah suaranya terdengar menarik. Pertanyaannya adalah apakah alat tersebut cocok dengan panjang naskah Anda, hak publikasi Anda, dan jenis konten yang benar-benar Anda buat. VoiceForge adalah layanan text-to-speech berbasis peramban yang dibangun di sekitar suara karakter yang khas. Ia mengubah naskah menjadi audio yang dapat diunduh menggunakan mesin sintesis seleksi-unit yang menyatukan segmen ucapan rekaman dari pembicara manusia alih-alih menghasilkan setiap suara dari satu gelombang matematis tunggal. Keputusan praktisnya bermuara pada empat kebutuhan: suara yang menyenangkan dan mudah dikenali untuk proyek pribadi; audio berlisensi untuk media yang dimonetisasi; kontrol yang presisi atas pelafalan dan tempo; atau alur kerja multibahasa yang dapat diskalakan. Hanya tiga kebutuhan pertama yang selaras dengan rapi pada generator suara karakter, dan celah itulah yang membuat sebagian besar kreator tersandung.
Kami menerbitkan panduan ini karena kebingungan yang sama muncul berulang kali: orang menghasilkan audio pada uji coba gratis, berasumsi mereka dapat memonetisasinya, lalu menemukan bahwa lisensi terikat pada paket tertentu. Di bawah ini, kami uraikan cara kerja mesinnya, apa yang bisa dan tidak bisa dilakukannya, serta kapan alat kebaruan suara tunggal adalah pilihan tepat dibandingkan alur kerja lokalisasi penuh.
Daftar isi
Apa itu VoiceForge text to speech sebenarnya
VoiceForge mengubah kata-kata tertulis menjadi audio yang diucapkan: Anda memasukkan naskah, memilih suara, menghasilkan klip, melihat pratinjaunya, dan mengunduh hasilnya ketika paket Anda mengizinkan. Yang membedakannya dari pustaka narasi umum adalah orientasinya. VoiceForge cenderung pada suara dengan kepribadian alih-alih penyampaian korporat yang netral, yang membuatnya cocok secara alami untuk sketsa YouTube, klip game, karakter animasi, meme, pengumuman kebaruan, dan proyek musik.
Fokus yang mengutamakan karakter itu merupakan fitur untuk sebagian konten dan beban untuk konten lainnya. Suara komikal atau sengaja sintetis dapat mengusung parodi atau NPC game, tetapi suara yang sama menjadi mengganggu dalam kursus e-learning, demo produk, atau iklan merek premium. Jadi filter pertama bukanlah "apakah ini terdengar seperti manusia?" Melainkan "apakah suara ini pantas berada di hadapan audiens spesifik saya?"
Jika Anda masih memutuskan apakah generator suara stok sesuai dengan kebutuhan Anda sama sekali, penjelasan kami tentang apa yang dilakukan generator suara AI membahas kategori yang lebih luas dan bagaimana alat-alat ini berbeda dari kloning dan dubbing.
Bagaimana mesin seleksi-unit membangun suara
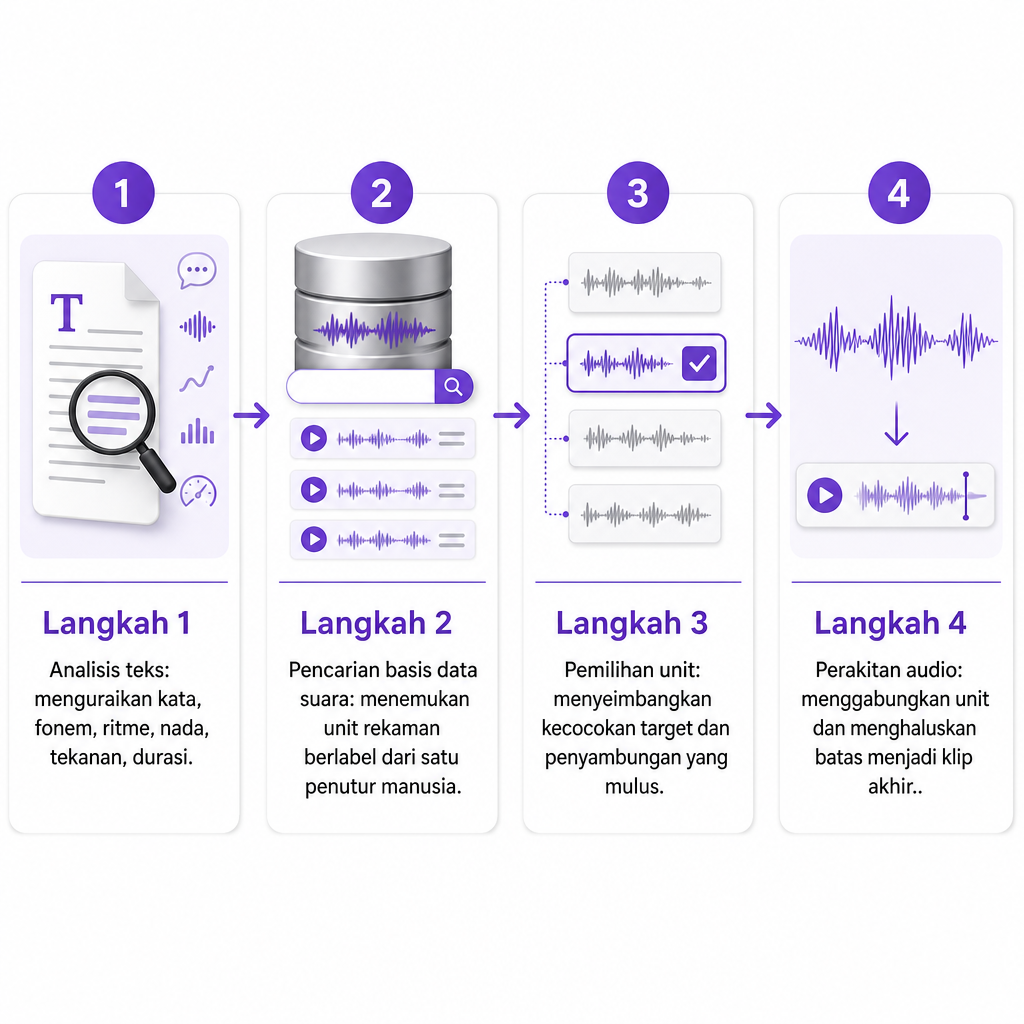
VoiceForge menggunakan sintesis seleksi-unit, yang juga disebut sintesis konkatenatif. Alih-alih menghasilkan seluruh rekaman dari satu gelombang yang diproduksi model, sistem mencari basis data segmen ucapan rekaman dan menyambungkan potongan yang paling cocok ke dalam kalimat Anda. Memahami alur ini menjelaskan baik mengapa suaranya terdengar mudah dikenali maupun mengapa suaranya berperilaku seperti itu saat berada di bawah tekanan.
Prosesnya berjalan dalam beberapa tahap. Pertama, analisis teks: mesin mengurai kata, struktur kalimat, fonem, ritme, nada, tekanan, dan durasi untuk menentukan bagaimana sebuah baris harus diucapkan. Selanjutnya, pencarian basis data suara: setiap suara dibangun dari rekaman seorang pembicara manusia, dipotong menjadi unit-unit lebih kecil dan diberi label menurut suara dan konteks. Kemudian seleksi unit, di mana mesin menyeimbangkan dua tujuan yang saling bersaing sekaligus — pencocokan target, yang memilih unit dengan suara, nada, durasi, dan konteks yang tepat, serta penyambungan yang mulus, yang mengutamakan unit-unit yang berdekatan yang terhubung tanpa sambungan yang jelas. Terakhir, perakitan audio menyatukan urutan yang dipilih dan menerapkan penghalusan ringan pada batas-batasnya.
Karena keluarannya dirakit dari rekaman nyata, setiap suara mempertahankan identitas yang khas. Pertukarannya adalah bahwa metode ini tidak dirancang untuk menawarkan pengarahan emosional yang tak terbatas atau penyampaian yang sepenuhnya dapat disesuaikan seperti yang diasosiasikan dengan sistem generatif yang lebih baru. Frasa yang tidak biasa, pergeseran cepat, atau kombinasi pelafalan yang canggung dapat mengekspos sambungan antar unit, menghasilkan hasil yang terdengar kurang konsisten dibandingkan rekaman manusia yang berkesinambungan. Jika Anda ingin melihat bagaimana alur yang sepenuhnya generatif berbeda, uraian kami tentang bagaimana neural text to speech bekerja menjelaskan pendekatan deep-learning yang menggantikan konkatenasi.
Suara, SSML, dan batas 500 karakter
VoiceForge mendaftarkan 42 suara unik, masing-masing direkam oleh pembicara yang berbeda dengan timbre dan gaya bicaranya sendiri. Itu sudah cukup ketika suara itu sendiri merupakan bagian dari konsep kreatif — narator komikal untuk film pendek, kepribadian aneh untuk video game, nada sintetis untuk meme. Namun, itu merupakan katalog yang lebih kecil bagi tim yang membutuhkan banyak varian regional atau narator yang dicocokkan dengan cermat di beberapa pasar.
Untuk kontrol penyampaian, VoiceForge mendukung sebagian dari Speech Synthesis Markup Language (SSML). Alih-alih hanya mengandalkan tanda baca, Anda menyematkan instruksi langsung ke dalam naskah.
| Kontrol SSML | Apa yang dilakukannya |
|---|---|
<break> |
Menyisipkan jeda |
<emphasis> |
Menekankan sebuah kata atau frasa |
<prosody> |
Menyesuaikan nada, laju bicara, atau volume |
<phoneme> |
Memaksakan pelafalan yang tepat |
<sub> |
Mengucapkan pengganti untuk teks yang terlihat |
<p> / <s> |
Menandai sebuah paragraf atau kalimat |
Tag-tag ini berguna ketika mesin salah membaca nama produk, akronim, atau istilah teknis. Membungkus singkatan dalam <sub alias="application programming interface">API</sub> membuatnya mengucapkan frasa lengkap, dan <phoneme> mengunci nama yang rumit. Sebuah <break time="500ms"/> di antara baris menambahkan ketukan yang disengaja di tempat yang tidak dapat diberikan oleh tanda baca.
Inilah kendala yang mengubah cara Anda menulis untuknya: input teks dibatasi hingga 500 karakter, dan markup SSML dihitung dalam batas itu. Setiap tag yang Anda tambahkan memakan ruang yang tersedia untuk kata-kata sebenarnya. Narasi panjang harus dibagi menjadi beberapa generasi, dan markup yang berat memperkecil setiap potongan lebih jauh. Dalam praktiknya, itu berarti merencanakan naskah Anda dalam bagian-bagian pendek yang berdiri sendiri alih-alih menempelkan seluruh halaman.
Uji coba gratis vs. lisensi komersial: keputusan yang penting
VoiceForge menawarkan uji coba gratis yang terbatas, tetapi uji coba bukanlah lisensi publikasi. Paket-paketnya menarik garis yang jelas antara penggunaan pribadi dan komersial, dan garis itulah tempat sebagian besar kesalahan terjadi.
Tingkatan Fan Voice ditujukan untuk lelucon, video, game, animasi, dan meme yang tidak dimonetisasi. Paket Publisher adalah langganan yang memberikan lisensi komersial untuk audio TTS dalam konten yang dimonetisasi atau komersial — video yang dimonetisasi, game indie, dan musik — serta mengiklankan unduhan tanpa batas. Uji coba gratis ada agar Anda dapat menguji layanan sebelum berkomitmen.
Aturan operasionalnya sederhana: jika sebuah proyek menghasilkan uang, mempromosikan sebuah bisnis, muncul dalam media yang dimonetisasi, atau dirilis secara komersial, pastikan paket yang berlaku sebelum Anda mempublikasikan. Audio yang Anda hasilkan selama uji coba gratis tidak secara otomatis membawa hak komersial hanya karena ia diunduh. Ketentuan lisensi juga dapat berubah, jadi halaman paket adalah titik awal, bukan pengganti tinjauan khusus proyek ketika taruhannya tinggi — hasil kerja klien, iklan berbayar, kampanye bermerek, atau peluncuran aplikasi.
Kekuatan dan keterbatasan untuk proyek nyata
Kekuatan VoiceForge berpusat pada kepribadian dan kesederhanaan. Suara-suara karakternya menonjol ketika timbre merupakan bagian dari lelucon atau merek sebuah kanal. Karena fondasinya adalah ucapan manusia yang direkam, suara-suaranya mempertahankan karakteristik vokal yang alami dan identitas yang mudah dikenali. Kontrol pelafalan SSML memberi Anda kendali nyata atas akronim, nama, dan istilah aneh. Dan paket Publisher membuat pertanyaan penggunaan komersial lebih eksplisit dibandingkan alat yang memisahkan akses pembuatan dari detail lisensi.
Keterbatasannya pun sama konkretnya. Batas 500 karakter memaksa naskah panjang menjadi banyak generasi kecil, dan markup membuat setiap generasi lebih pendek. Katalog 42 suara tergolong sederhana di samping pustaka besar, yang menjadi penting jika Anda membutuhkan ratusan opsi atau banyak aksen regional. Gaya yang mengutamakan karakter yang bersinar dalam hiburan dapat merusak konten hukum, medis, instruksional, atau merek premium. Batasan paket mudah membuat orang tersandung, karena kemampuan menghasilkan audio tidak sama dengan hak untuk memonetisasinya. Dan karena mesin menyambungkan unit-unit rekaman, frasa tertentu dapat memunculkan artefak penyambungan yang tidak akan muncul pada rekaman berkesinambungan.
Tidak satu pun dari ini yang mendiskualifikasi dengan sendirinya. Semuanya hanya mendefinisikan titik idealnya: klip pendek, berorientasi kepribadian, satu bahasa, di mana suaranya menjadi intinya.
Kapan suara karakter cocok dan kapan alur kerja lokalisasi menang
VoiceForge adalah pilihan yang tepat ketika kepribadian suara menjadi inti, naskah Anda terbagi rapi menjadi bagian-bagian pendek, Anda membutuhkan kontrol pelafalan dan tempo dasar, dan Anda memproduksi video, meme, animasi, musik, atau konten game indie — baik pribadi (Fan Voice) maupun dimonetisasi dengan langganan yang sesuai.
Alur kerja yang lebih luas lebih melayani Anda ketika Anda membutuhkan narator netral yang terpoles, banyak bahasa dan aksen, suara kloning Anda sendiri, narasi berdurasi panjang, pembaruan komersial yang sering, integrasi API, atau suara yang konsisten di seluruh katalog besar di mana kebaruan kurang penting daripada keandalan. Sebuah kanal yang berkembang secara internasional menggambarkan pembagian ini dengan baik: VoiceForge mungkin menyediakan suara karakter untuk sketsa berbahasa Inggris, sementara pengaturan TTS dan dubbing multibahasa menghasilkan versi yang dilokalkan untuk audiens lain.
Skenario kedua itulah yang menjadi fokus kami. Alat Text to Speech kami menawarkan 300+ suara AI, sulih suara multibahasa, kontrol laju bicara, dan proyek yang dapat diunduh yang dibangun untuk produksi alih-alih kebaruan sekali pakai. Kreator yang ingin mempertahankan identitas mereka sendiri di setiap video dapat menggunakan Voice Cloning alih-alih puas dengan karakter stok, dan pengembang yang membutuhkan pembuatan ucapan di dalam aplikasi dapat membangun di atas Text to Speech API kami. Ketika tujuannya adalah mengubah satu klip menjadi rilis lokal penuh, AI Dubbing membawa naskah yang sama ke berbagai bahasa tambahan di satu tempat.
Daftar periksa kualitas sebelum publikasi
Sebelum Anda merilis audio VoiceForge, lakukan pemeriksaan cepat pada hal-hal yang paling sering bermasalah. Menghasilkan bagian uji pendek terlebih dahulu sepadan dengan beberapa menit tambahan, karena suara yang pas dalam satu kalimat bisa menjadi melelahkan atau mengganggu sepanjang video penuh.
- Pelafalan: Apakah nama, singkatan, angka, dan istilah teknis diucapkan dengan benar?
- Tempo: Apakah jeda jatuh secara alami, bukan di tengah frasa?
- Konsistensi karakter: Apakah suara yang sama cocok untuk setiap adegan, bukan hanya pembuka?
- Transisi audio: Apakah ada lonjakan yang terdengar di antara klip yang dihasilkan secara terpisah?
- Lisensi: Apakah paket Anda saat ini benar-benar mencakup penggunaan yang dimonetisasi atau komersial?
- Kecocokan audiens: Apakah gaya karakter sesuai untuk platform dan subjek?
- Penyelarasan: Apakah audio terpasang rapi terhadap video, musik, atau dialog game Anda?
- Hak: Apakah Anda memiliki izin untuk naskah, nama, atau referensi pihak ketiga apa pun yang disertakan dalam audio?
Pertanyaan yang Sering Diajukan
Apa itu VoiceForge text to speech?
Ia adalah layanan berbasis peramban yang mengubah teks tertulis menjadi audio yang diucapkan menggunakan pustaka suara karakter yang khas. Ia mengandalkan sintesis seleksi-unit, yang merakit segmen ucapan rekaman dari basis data suara manusia alih-alih menghasilkan audio dari satu gelombang model tunggal.
Apakah VoiceForge dihasilkan AI?
Ia adalah layanan sintesis ucapan, tetapi metode yang terdokumentasi adalah seleksi unit, bukan sistem suara neural yang sepenuhnya generatif. Mesin memilih dan menyambungkan unit ucapan manusia yang direkam untuk menghasilkan setiap ucapan.
Berapa banyak suara VoiceForge yang tersedia?
VoiceForge mendaftarkan 42 suara unik, masing-masing dikaitkan dengan pembicara dan kepribadian vokal yang berbeda.
Apa batas karakter VoiceForge?
Layanan ini mendokumentasikan batas 500 karakter per input teks, dan markup SSML apa pun yang Anda tambahkan dihitung dalam batas itu. Naskah yang lebih panjang perlu dibagi menjadi beberapa generasi.
Bisakah saya menggunakan audio VoiceForge di YouTube?
Anda bisa, tetapi konten yang dimonetisasi memerlukan langganan komersial yang sesuai. Paket Publisher digambarkan sebagai lisensi untuk audio TTS yang digunakan dalam konten yang dimonetisasi atau komersial, jadi pastikan paket Anda sebelum mempublikasikan video yang dimonetisasi.
Apakah VoiceForge sama dengan kloning suara?
Tidak. VoiceForge menggunakan pustaka suaranya yang sudah ada, sedangkan kloning suara menciptakan suara sintetis khusus dari rekaman yang diotorisasi dari pembicara tertentu. Kami menjelaskan alur kerja terpisah itu pada halaman Voice Cloning kami.