Transkrip bersih dari podcast atau video pelatihan berdurasi 30 menit realistis diselesaikan dalam waktu kurang dari 10 menit dengan DubSmart AI, dan sebagian besar kreator menanganinya dengan biaya antara $0 dan sekitar $20–$50 per bulan tergantung volume. Jika Anda ingin tahu cara mentranskripsi audio menjadi teks tanpa harus menggabungkan aplikasi transkripsi terpisah, pembersih kebisingan, dan editor teks, mesin Speech to Text kami menjalankan seluruh pekerjaan dalam satu ruang kerja: unggah media, hasilkan teks dengan akurasi di atas 95% pada audio jernih, edit label pembicara dan tanda baca, lalu ekspor transkrip atau subtitle yang siap dipublikasikan.
Keunggulan sesungguhnya di sini bukan hanya kecepatan. Karena transkripsi, pembersihan audio, dubbing, dan voiceover berbagi kumpulan kredit yang sama, transkrip yang Anda buat hari ini dapat digunakan untuk AI Dubbing ke 33 bahasa target atau Text to Speech dengan 300+ suara nantinya. Itu penting jika Anda menjalankan saluran YouTube, membuat kursus e-learning, atau melokalkan pelatihan perusahaan.
Daftar isi
Apa yang Anda butuhkan sebelum memulai
Kualitas transkripsi ditentukan sebelum Anda menekan satu tombol pun. Lakukan daftar periksa ini terlebih dahulu:
- Akun DubSmart dengan akses ke Speech to Text dan Speech Separator pada paket Free, Starter, atau paket yang lebih tinggi.
- File sumber Anda siap digunakan: episode podcast, webinar, wawancara, atau tautan YouTube.
- Hak dan izin untuk mentranskripsi konten, yang paling penting untuk pekerjaan klien dan rekaman pihak ketiga.
- Output target yang jelas dalam benak: transkrip lengkap (DOC/TXT), subtitle (SRT/VTT), atau naskah untuk dubbing dan voiceover.
- Fakta dasar tentang rekaman: bahasa sumber, jumlah pembicara, dan apakah ada musik atau kebisingan latar belakang yang berat.
- Untuk tim yang teregulasi, pedoman internal Anda tentang menangani data pribadi atau sensitif di alat berbasis cloud.
Mengetahui format output Anda sejak awal menghemat perjalanan bolak-balik. Pekerjaan show-notes blog membutuhkan teks biasa; unggahan YouTube membutuhkan teks bertanda waktu; pekerjaan pelokalan membutuhkan naskah bersih yang bisa Anda dorong langsung ke dubbing.
Langkah demi langkah: mentranskripsi audio menjadi teks dengan DubSmart
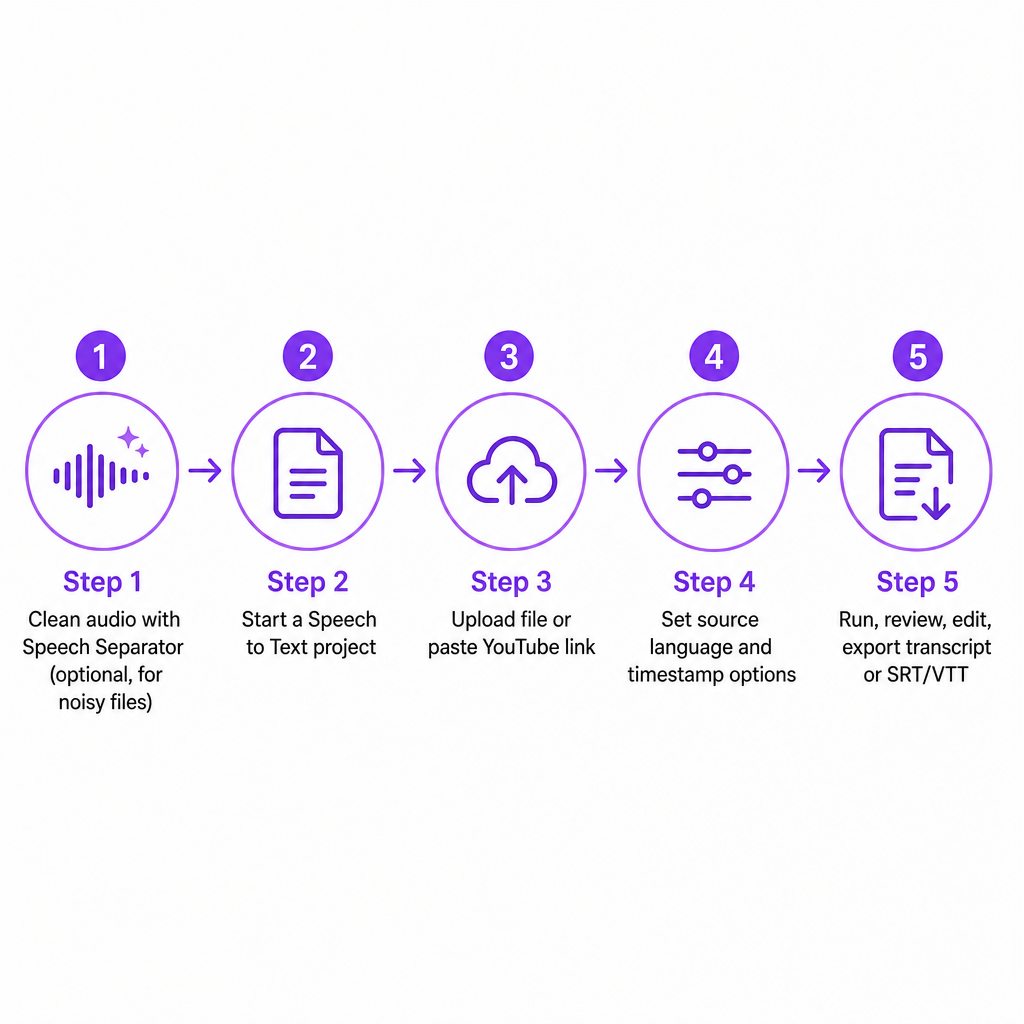
1. Pilih alat yang tepat untuk rekaman
Speech to Text mengubah audio ucapan menjadi teks tertulis, dan bekerja bersama Speech Separator untuk rekaman yang bising. Kredit dibagikan di seluruh AI Dubbing, Text to Speech, Voice Cloning, Speech to Text, dan Speech Separator, sehingga setiap menit yang Anda proses mengambil dari kumpulan yang sama.
Keputusannya sederhana. Jika rekaman memiliki musik, kebisingan kerumunan, atau gema ruangan, mulailah dengan Speech Separator untuk mengisolasi suara. Jika audio sudah bersih, langsung lompat ke transkripsi.
2. Bersihkan audio dengan Speech Separator (direkomendasikan)
Input berkualitas tinggi adalah faktor terbesar tunggal dalam transkripsi otomatis yang akurat, terutama untuk podcast multi-pembicara, wawancara, dan panel. Speech Separator mengisolasi ucapan dari musik dan kebisingan latar belakang dalam format umum seperti MP3, WAV, dan AAC, meninggalkan trek vokal yang lebih bersih.
- Buka alat Speech Separator di akun Anda.
- Unggah audio atau video Anda dari perangkat, atau pilih dari proyek Anda.
- Biarkan AI memisahkan suara dari latar belakang; ini biasanya selesai dalam hitungan detik hingga menit tergantung durasi.
- Simpan file suara bersih ke pustaka proyek Anda.
Dengan trek bersih itu di tangan, tahap transkripsi menghasilkan lebih sedikit kesalahan dan membutuhkan lebih sedikit koreksi manual.
3. Mulai proyek Speech to Text baru
Alurnya sengaja dibuat singkat: pilih fitur, unggah media, edit, ekspor.
- Masuk dan buka dasbor ruang kerja.
- Pilih Speech to Text dari daftar alat.
- Buat proyek baru dan beri nama deskriptif, seperti "Webinar produk – Oktober."
Memberi nama proyek membuat transkrip tetap terorganisir dan memudahkan untuk digunakan kembali untuk teks, dubbing, atau text-to-speech nantinya.
4. Unggah audio atau video Anda
Anda dapat mengunggah file secara langsung atau menarik dari URL YouTube, yang berguna bagi kreator dan agensi yang mengelola saluran klien.
- Unggah audio atau video dari perangkat Anda dalam format standar seperti MP3, WAV, dan MP4.
- Tempel URL YouTube untuk membawa video langsung ke dalam proyek, termasuk unggahan 1080p jika didukung.
DubSmart kemudian menganalisis file, mengekstrak audio, dan mempersiapkannya untuk pengenalan.
5. Atur bahasa dan opsi pengenalan
Speech to Text mendukung 60+ bahasa termasuk Inggris, Spanyol, Jerman, Hindi, Turki, Portugis, Jepang, Rusia, Mandarin, dan Arab. Mengatur bahasa sumber yang benar bukanlah detail opsional; mesin mengandalkan model khusus bahasa untuk mendekode ucapan menjadi teks.
- Pilih bahasa sumber yang sesuai dengan rekaman. Untuk konten multibahasa, mulailah dengan bahasa yang dominan.
- Jika ada beberapa pembicara, rencanakan untuk menambahkan label pembicara selama pengeditan.
- Konfirmasikan opsi stempel waktu dan segmentasi jika Anda bermaksud mengekspor subtitle SRT atau VTT daripada transkrip biasa.
Untuk sebagian besar file pembicara tunggal, pengenalan berjalan pada atau lebih cepat dari waktu nyata, sehingga pemrosesan sering selesai dalam durasi rekaman.
6. Jalankan transkripsi
Mulai proses dan biarkan mesin bekerja. Mesin menyegmentasi audio, mengidentifikasi fonem dan kata, dan menerapkan model bahasa untuk menghasilkan teks. Pada audio jernih, akurasi mencapai di atas 95%, yang secara tajam memangkas beban kerja koreksi Anda. Saat berjalan, siapkan glosarium singkat berisi nama, merek, atau istilah teknis yang sudah Anda tahu perlu distandarisasi.
7. Tinjau dan edit transkrip
Output otomatis cepat, tetapi teks berkualitas profesional tetap membutuhkan tinjauan manusia, terutama untuk nama, akronim, dan jargon. Edit langsung di dalam editor proyek:
- Baca sambil mendengarkan bagian-bagian kunci untuk menangkap kata-kata yang salah dengar.
- Tambahkan label pembicara seperti Pembawa Acara, Tamu, atau Instruktur agar dialog mudah diikuti.
- Perbaiki tanda baca dan kapitalisasi, yang memengaruhi keterbacaan dan waktu teks.
- Standarisasi terminologi, seperti nama produk, istilah medis, atau frasa hukum, sesuai dengan glosarium merek atau kepatuhan Anda.
Karena transkrip yang sama nantinya dapat digunakan untuk AI Dubbing ke 33+ bahasa dan Text to Speech dengan 300+ suara, pengeditan yang cermat sekarang akan menguntungkan setiap kali Anda menggunakan ulang konten.
8. Ekspor teks atau subtitle
Ketika hasil pengeditan terlihat tepat, ekspor dalam format yang dibutuhkan kasus penggunaan Anda:
- Subtitle (SRT atau VTT) untuk YouTube, platform LMS, dan portal video perusahaan.
- Teks biasa (TXT) atau format dokumen untuk blog, catatan acara, manual pelatihan, dan notulen rapat.
Pilih format, lalu unduh atau simpan proyek yang sudah selesai. Itu menyelesaikan alur kerja inti tentang cara mentranskripsi audio menjadi teks di DubSmart.
Waktu dan biaya: apa yang bisa diharapkan
DubSmart berjalan pada sistem berbasis kredit yang berlaku di seluruh AI Dubbing, Text to Speech, Voice Cloning, Speech to Text, dan Speech Separator. Kredit dapat ditukar, sehingga satu kumpulan mencakup menit transkripsi, pembersihan audio, dan dubbing. Dari harga yang kami publikasikan:
| Paket | Harga bulanan | Kredit bulanan | Catatan |
|---|---|---|---|
| Free | $0 | 2.000 | Sekitar 2 menit AI Dubbing/TTS untuk menguji alur kerja |
| Starter | ~$20 | 50.000 | Sekitar 50 menit AI Dubbing/TTS; kredit yang tidak terpakai diteruskan |
| Standard | ~$50 | 150.000 | Volume lebih tinggi dengan biaya per-1.000-kredit yang lebih rendah |
Karena kredit mencakup transkripsi, pembersihan suara, dan dubbing, Anda dapat memperlakukan seluruh alur sebagai satu anggaran daripada alat terpisah. Untuk sebagian besar kreator, itu berarti mentranskripsi puluhan video pendek sebulan dengan harga tingkat Starter sambil menjaga kapasitas kredit tetap tersedia untuk dubbing dan voiceover.
Kesalahan umum dan cara memperbaikinya
Menggunakan audio yang bising tanpa membersihkannya. Musik latar belakang, kebisingan kerumunan, atau gema menyebabkan salah pengenalan dan pengeditan tambahan. Jalankan file melalui Speech Separator terlebih dahulu, lalu transkripsi trek suara yang terisolasi untuk akurasi yang lebih tinggi dan waktu subtitle yang lebih bersih.
Memilih bahasa sumber yang salah. Jika Anda membiarkannya di bahasa Inggris saat audio berbahasa Spanyol, mesin salah menafsirkan fonem dan menghasilkan teks yang tidak dapat digunakan. Periksa kembali bahasa sebelum Anda memulai, dan untuk video multibahasa, segmentasikan berdasarkan bahasa atau prioritaskan bahasa utama untuk tinjauan pertama.
Mengabaikan label pembicara. Podcast dan panel multi-pembicara sulit dibaca tanpa atribusi. Tambahkan label seperti Pembawa Acara, Tamu 1, atau tag berbasis nama selama pengeditan, dan jaga konsistensinya di seluruh episode.
Melewatkan tinjauan manusia untuk konten berisiko tinggi. Untuk materi yang sensitif secara hukum, medis, atau kepatuhan, kesalahan kecil dapat mengubah makna. Perlakukan transkrip otomatis sebagai draf pertama dan jalankan validasi manusia penuh, memasangkannya dengan peninjau internal atau pemeriksaan kepatuhan eksternal bila diperlukan.
Salah memperkirakan kredit. Menjalankan katalog lama yang besar tanpa memahami penggunaan dapat menguras kuota Anda. Periksa kredit bulanan dan kebijakan penerusan paket Anda terlebih dahulu, lalu jalankan batch percobaan kecil untuk mengukur menit-per-kredit di seluruh Speech Separator dan Speech to Text sebelum Anda berkomitmen untuk pekerjaan massal.
DIY vs bantuan profesional: di mana harus menarik garis
DubSmart dibangun untuk penggunaan mandiri oleh kreator, bisnis kecil, tim e-learning, dan agensi yang menginginkan konten multibahasa yang dapat diskalakan tanpa repot mengelola vendor. Alat berbasis browser, tingkat gratis, dan model kredit bersama memungkinkan sebagian besar pengguna menangani transkripsi, pembersihan, dan dubbing sendiri.
Penggunaan mandiri biasanya cukup ketika:
- Anda mentranskripsi konten episodik seperti podcast, video YouTube, demo produk, atau pelatihan internal.
- Audio cukup bersih atau dapat ditingkatkan dengan Speech Separator.
- Akurasi perlu tinggi tetapi tidak mengikat secara hukum, seperti teks aksesibilitas, materi kursus, atau materi pemasaran.
- Volume bulanan Anda sesuai dengan kredit yang tersedia dengan sisa ruang untuk dubbing atau voiceover.
Condonglah ke dukungan tingkat profesional atau enterprise ketika:
- Anda mengelola katalog besar, ratusan jam, yang membutuhkan QA, gaya, dan terminologi yang konsisten di seluruh wilayah.
- Konten Anda termasuk dalam standar hukum atau regulasi yang ketat, seperti proses pengadilan, dokumentasi medis, atau pengungkapan keuangan.
- Anda perlu mengintegrasikan AI Dubbing API atau Text to Speech API kami ke dalam alur kerja yang kompleks dengan persyaratan waktu aktif dan throughput untuk klien.
Dalam kasus tersebut, memasangkan otomatisasi kami dengan tinjauan linguistik atau kepatuhan profesional memberikan keseimbangan terbaik antara kecepatan, biaya, dan risiko. Untuk sebagian besar transkripsi sehari-hari, jalur mandiri lebih cepat dan lebih murah, dan menjaga transkrip Anda siap menjadi subtitle, dubbing, atau voiceover kapan pun Anda membutuhkannya.
Pertanyaan yang sering diajukan
Jenis konten apa yang dapat ditranskripsi DubSmart?
Speech to Text menangani podcast, video YouTube, webinar, wawancara, film, dan pelatihan perusahaan, selama audio tersedia melalui unggahan atau tautan.
Bahasa apa saja yang didukung untuk transkripsi?
Speech to Text mendukung 60+ bahasa, termasuk Inggris, Spanyol, Jerman, Hindi, Turki, Portugis, Jepang, Rusia, Mandarin, dan Arab, dan platform yang sama men-dubbing ke 33 bahasa target.
Seberapa akurat Speech to Text DubSmart?
Pada audio jernih dengan bahasa yang benar dipilih, akurasi mencapai di atas 95%, sejalan dengan pengenalan ucapan otomatis modern.
Berapa biaya untuk mentranskripsi dengan DubSmart?
Harga mulai dari $0/bulan dengan tingkat gratis sebesar 2.000 kredit. Paket berbayar seperti Starter (sekitar $20/bulan) dan Standard (sekitar $50/bulan) menambahkan kredit dan menurunkan biaya per-kredit, dan kredit dibagikan di seluruh transkripsi, dubbing, dan alat terkait.
Dapatkah saya menggunakan transkrip untuk dubbing dan voiceover?
Ya. Output Speech to Text dapat langsung digunakan untuk AI Dubbing dan Text to Speech untuk menghasilkan versi dubbing multibahasa dan voiceover AI menggunakan 300+ suara yang terdengar alami.