Ketika orang mencari ghostface text to speech, mereka biasanya menginginkan satu hal: mengubah naskah tertulis menjadi suara yang gelap dan mengancam, yang mengingatkan pada penelepon bertopeng dari film Scream. Yang jarang mereka sadari adalah hal ini hampir tidak pernah berarti menghasilkan suara karakter resmi. Dalam film, penampilan itu milik pengisi suara Roger L. Jackson, yang disampaikan melalui perangkat pengubah suara di dalam cerita. Alat text-to-speech melakukan sesuatu yang berbeda: ia menghasilkan ucapan yang benar-benar baru dari teks Anda menggunakan model suara sintetis atau berlisensi. Jadi pertanyaan sebenarnya bukan "bagaimana cara saya mendapatkan suara Ghostface?" Melainkan "apakah saya butuh penampilan berlisensi, atau suara horor orisinal dengan kualitas meresahkan yang sama—register rendah, tempo yang disengaja, jeda penuh makna, dan penyampaian yang mengancam?"
Perbedaan itu membentuk setiap pilihan yang mengikutinya, mulai dari suara mana yang Anda pilih hingga apa yang secara hukum boleh Anda publikasikan. Kita akan membahas bagaimana suara itu sebenarnya dibangun, di mana DubSmart AI berperan, dan bagaimana tetap berada di sisi yang benar dari aturan hak suara di Amerika Serikat.
Daftar isi
Apa arti sebenarnya ghostface text to speech
Pada intinya, ghostface text to speech adalah kasus penggunaan narasi horor untuk mesin suara AI serbaguna. Para kreator menggunakannya untuk mengisi suara video Halloween, cerita seram fiksi, trailer game, sketsa komedi-horor, podcast ketegangan, karakter animasi, dan film pendek dengan pemeran orisinal.
Sistem text-to-speech membaca teks tertulis Anda, mengubah kata-kata menjadi informasi pelafalan dan bahasa, memprediksi fitur ucapan seperti ritme, nada, penekanan, dan jeda, lalu mensintesis fitur-fitur tersebut menjadi gelombang audio. Hasilnya adalah rekaman baru yang dihasilkan dari teks, bukan baris-baris yang direkam satu per satu dari aktor manusia. Alat Text to Speech kami menjalankan persis proses ini, menggunakan algoritma yang meniru intonasi manusia di lebih dari 300 suara, berbagai bahasa dan aksen, dengan kontrol untuk kecepatan bicara, emosi, dan penekanan, plus audio yang dapat diunduh.
Karakter mengancam yang Anda cari bukanlah satu tombol. Ia muncul dari cara Anda menggabungkan suara yang Anda pilih dengan cara Anda menulis dan memproses naskah. Jika Anda baru mengenal teknologi yang mendasarinya, penjelasan kami tentang cara kerja neural text to speech membahas alurnya secara lebih mendalam.
Apakah itu suara Ghostface yang asli?
Biasanya, tidak—dan hal itu lebih penting dari yang terlihat pada awalnya. "Suara Ghostface" yang ditawarkan oleh generator daring cenderung menjadi salah satu dari empat hal: suara horor generik yang dibangun agar terdengar gelap dan teatrikal; preset peniruan gaya yang dimaksudkan untuk membangkitkan tempo dan sikap karakter; efek konversi suara yang membentuk ulang rekaman dengan nada dan distorsi; atau replika tanpa izin yang dilatih untuk meniru pengisi suara yang dikenal tanpa izin yang jelas.
Keempatnya tidak dapat dipertukarkan, baik secara hukum maupun teknis. Suara orisinal yang terinspirasi horor baik-baik saja untuk karakter yang Anda ciptakan. Peniruan realistis dari aktor terkenal atau karakter fiksi bermerek menarik pertanyaan hak dan lisensi yang tidak ada hubungannya dengan seberapa bagus audionya terdengar.
Halaman Text to Speech publik kami mencantumkan suara stok dan fitur kloning suara; halaman tersebut tidak menawarkan suara Ghostface Scream resmi atau suara Roger L. Jackson. Jadi anggaplah halaman pihak ketiga mana pun yang menempelkan label "Ghostface" pada sebuah preset sebagai pemasaran, bukan bukti lisensi. Jangan menyajikan audio yang dihasilkan sebagai resmi, didukung, atau dibawakan oleh Jackson kecuali Anda memegang otorisasi terpisah.
Bagaimana suara mengancam itu direkayasa
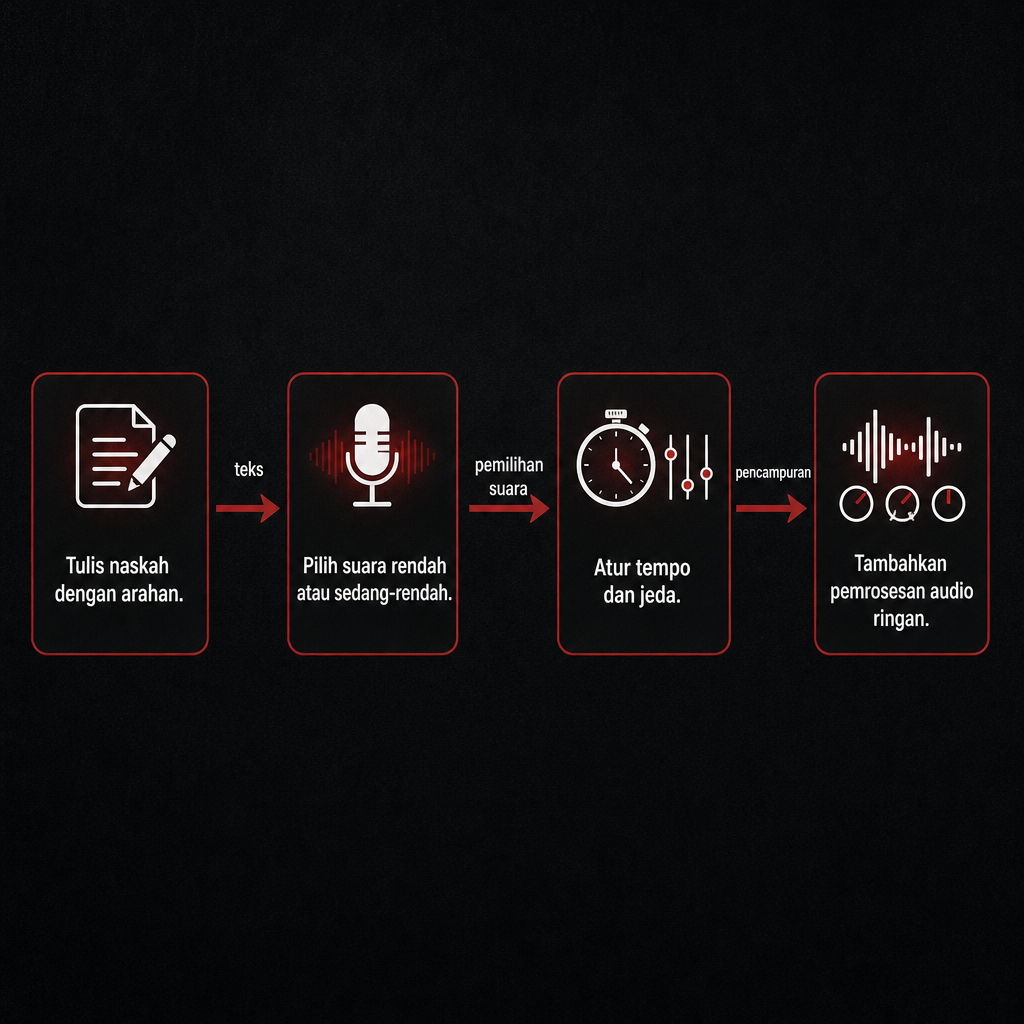
Efek yang dikenali itu berasal dari pilihan berlapis, bukan satu slider. Setiap lapisan adalah tuas yang dapat Anda uji secara independen.
Register vokal. Nada yang lebih rendah menambah bobot dan ancaman, tetapi menurunkannya ke pengaturan terendah yang tersedia biasanya menghasilkan hasil yang tidak alami dan terdistorsi. Targetkan pengurangan sedang yang menjaga kata-kata tetap dapat dipahami di speaker ponsel, speaker laptop, maupun headphone.
Tempo terkontrol. Dialog gaya Ghostface terasa disengaja. Penyampaian yang lebih lambat memungkinkan pendengar mengantisipasi baris berikutnya dan membuat kalimat pendek terasa seperti konfrontasi. Kecepatan bicara dapat disesuaikan dalam alur kerja kami, di mana default 1,00x dapat disetel per proyek. Langkah cerdasnya adalah memperlambat hanya baris-baris yang mengancam; memperlambat semuanya meratakan ketegangan dan terdengar artifisial.
Jeda. Keheningan menciptakan lebih banyak ketakutan daripada distorsi yang terus-menerus. Sisipkan tanda baca, jeda baris, atau segmen dialog terpisah di tempat pembicara seharusnya ragu. "Apakah kamu suka film seram?" menjadi jauh lebih meresahkan sebagai "Apakah kamu suka… film seram?" Jeda singkat bekerja paling baik tepat sebelum sebuah nama, pengungkapan, ancaman, atau pertanyaan.
Penekanan melalui arahan tertulis. Suara sintetis merespons instruksi yang jelas lebih baik daripada yang samar. Anda dapat menggunakan tag dialog seperti "katanya dengan gembira" atau "teriaknya dengan marah" untuk menandakan nada emosional, dan huruf kapital untuk menekankan sebuah vokal. Untuk horor, deskripsikan penyampaiannya dalam naskah itu sendiri:
[tenang, terkendali, mengancam] Kamu seharusnya tidak menjawab.
Tahan keinginan untuk berteriak dengan huruf kapital di mana-mana. Penekanan yang berlebihan terbaca sebagai teriakan, bukan ancaman.
Panjang kalimat. Baris pendek memberi model lebih banyak ruang untuk kontrol dramatis. Bandingkan "Aku sudah mengawasimu selama beberapa menit, dan aku tahu persis apa yang kamu lakukan tadi malam" dengan:
Aku melihatmu. Aku tahu apa yang kamu lakukan.
Versi yang terpecah memberi suara lebih banyak kesempatan untuk berhenti dan mengubah intensitas.
Pemrosesan audio. TTS menghasilkan suara; penyuntingan membentuk horornya. Setelah Anda memiliki hasil yang bersih, tambahkan reverb ruangan halus, penyaringan pita telepon, saturasi ringan, kompresi terkontrol, ambiens latar belakang, serta musik atau efek yang dicampur dengan hati-hati. Terapkan ini di akhir. Pemrosesan berat di awal menyembunyikan masalah pelafalan dan mengubur kata-kata.
Suara stok, kloning, atau pengisi suara manusia
Text to speech dan kloning suara menyelesaikan masalah yang berbeda, dan pilihan yang salah menciptakan entah penampilan yang lemah atau sakit kepala soal hak. Perbandingan ini memetakan trade-off-nya.
| Opsi | Terbaik untuk | Input utama | Risiko utama |
|---|---|---|---|
| Suara AI stok | Narasi cepat, karakter orisinal | Teks | Suara mungkin tidak cocok dengan karakter yang dimaksud |
| Kloning suara | Menggunakan kembali identitas narator yang berizin | Sampel suara bersih dan teks | Kekhawatiran persetujuan dan peniruan identitas |
| Konversi suara | Mengubah penampilan yang sudah ada | Ucapan terekam | Dapat meniru orang asli terlalu mirip |
| Pengisi suara manusia | Pekerjaan karakter berlisensi, akting yang bernuansa | Naskah dan arahan | Biaya lebih tinggi dan waktu produksi |
Kami menjaga Text to Speech dan Kloning suara sebagai alat terpisah karena alasan ini. Produk Text to Speech kami mendukung suara stok dan memungkinkan Anda mengkloning suara untuk digunakan di berbagai bahasa, tetapi halaman publik kami tidak menetapkan hak apa pun untuk mengkloning selebriti, karakter fiksi, atau penampilan berhak cipta tanpa izin. Untuk karakter horor rekaan, suara stok dengan arahan tertulis yang tajam biasanya merupakan jalur yang lebih aman dan lebih cepat. Untuk narator saluran yang berulang, kloning suara Anda sendiri atau gunakan pengisi suara yang telah memberikan izin yang jelas.
Membangun suara horor orisinal di DubSmart AI
Alur kerja Text to Speech kami mengubah naskah menjadi audio yang dihasilkan: buka Text to Speech, masukkan teks Anda, pilih pembicara, hasilkan ucapan, sunting proyek, dan unduh hasilnya. Untuk hasil yang terinspirasi Ghostface tetapi orisinal, beberapa kebiasaan membuat perbedaan antara penjahat yang meyakinkan dan robot yang jelas.
Pilih suara berdasarkan perilaku, bukan berdasarkan nama. Carilah suara yang tenang alih-alih energik, rendah atau mid-rendah dalam register, artikulatif pada kecepatan lebih lambat, mampu melakukan penyampaian emosional yang terkendali, dan sesuai dengan usia dan identitas karakter Anda. Hindari memilih suara hanya karena sebuah halaman memberinya label "Ghostface"; label itu sering menggambarkan peniruan, bukan penampilan berlisensi.
Tulis penampilan ke dalam naskah menggunakan arahan yang terkendali:
[rendah, tenang, hampir geli] Kamu mengangkat teleponnya. [jeda] Itu sebuah kesalahan.
Tujuannya adalah memandu nada tanpa meminta sistem mereproduksi penyampaian persis dari aktor yang disebutkan namanya.
Perbaiki pelafalan sebelum menambahkan efek. Jika sebuah nama atau angka terdengar salah, tulis ulang secara fonetis atau ejakan—menulis angka sebagai kata membantu ketika sistem salah melafalkannya. Hasilkan beberapa versi untuk baris yang sulit; hasil yang bersih dan akurat mengalahkan hasil yang diproses berat yang tak seorang pun bisa menguraikannya.
Terakhir, bandingkan sampel uji singkat sebelum berkomitmen pada satu episode penuh. Jalankan tiga baris yang sama melalui beberapa suara dan kecepatan: pernyataan netral, baris berbisik atau pelan, dan ancaman mendadak. Pilih suara yang tetap dapat dipercaya di ketiganya. Suara yang memukau dalam satu kalimat bisa menjadi mekanis pada naskah yang lebih panjang. Jika cerita Anda menjangkau lebih jauh, AI Dubbing kami dapat membawa suara itu ke bahasa lain—tinjau saja setiap bahasa, karena penerjemahan mengubah ritme dan bobot budaya dari sebuah ancaman.
Hak suara dan etika di Amerika Serikat
Peniruan suara melibatkan lebih dari sekadar hak cipta. Laporan Kantor Hak Cipta A.S. tentang replika digital membahas teknologi yang secara realistis mereproduksi suara atau penampilan seseorang; laporan itu mencatat bahwa hukum hak cipta tidak mengesampingkan hukum yang membatasi replika suara tanpa izin dan membahas hak publisitas, terutama ketika identitas seseorang digunakan secara komersial. Anda dapat membaca sumber utamanya di laporan replika digital Kantor Hak Cipta.
Praktik teraman cukup sederhana: jangan mengkloning suara orang lain tanpa izin; jangan mendeskripsikan peniruan sebagai suara resmi; jangan menggunakan suara aktor yang dikenal untuk menjual produk tanpa otorisasi; dan jangan pernah menggunakan audio yang dihasilkan untuk penipuan, pelecehan, ancaman, atau tipu daya. Ungkapkan keterlibatan AI ketika konteks dapat membingungkan pemirsa, simpan catatan persetujuan dan penggunaan yang diizinkan untuk sampel suara apa pun, dan tinjau hak yang melekat pada musik, klip film, naskah, dan nama karakter secara terpisah.
Ada alasan dunia nyata untuk menanggapi peniruan identitas dengan serius. Komisi Perdagangan Federal telah memperingatkan bahwa kloning suara membuat penipuan lebih meyakinkan, termasuk skema yang meniru kerabat atau eksekutif untuk meminta uang atau informasi; panduannya tentang kloning suara yang berbahaya layak dibaca. Bahkan dalam hiburan, hindari peniruan realistis yang dapat menyesatkan pendengar. Ini adalah informasi umum, bukan nasihat hukum; proyek komersial yang melibatkan karakter atau pengisi suara yang dikenal harus ditinjau oleh penasihat hukum yang berkualifikasi atau pemegang hak yang relevan.
Kerangka keputusan sederhana menjaga Anda tetap jelas: pilih suara AI stok ketika karakternya orisinal, Anda membutuhkan narasi cepat, atau Anda memproduksi konten yang sering. Pilih kloning suara yang berizin ketika Anda memiliki suara sumber atau memiliki izin tertulis, membutuhkan narasi yang konsisten di berbagai episode, dan dapat mendokumentasikan penggunaan yang diizinkan. Pekerjakan atau lisensikan pengisi suara manusia ketika proyek bergantung pada akting karakter yang dikenali, ketika nuansa emosional menjadi pusat, atau ketika garis antara inspirasi dan peniruan tidak dapat diterima untuk rilis komersial.
Sebelum Anda mempublikasikan, jalankan gerbang cepat: Apakah suara disajikan sebagai orisinal alih-alih resmi? Dapatkah setiap kata dipahami tanpa headphone? Apakah jeda menciptakan ketegangan alih-alih celah yang canggung? Apakah karakter terdengar stabil di seluruh adegan? Apakah nama, angka, dan kata asing sudah benar? Apakah suara lebih keras dan jernih daripada musik? Bisakah pemirsa salah mengira audio tersebut sebagai rekaman resmi? Apakah Anda memiliki izin untuk setiap sampel suara, trek, klip, naskah, dan referensi karakter? Dan apakah masih pas di platform seluler dan format pendek?
Pertanyaan yang sering diajukan
Apakah ghostface text to speech gratis?
Beberapa alat menawarkan uji coba gratis atau pembuatan terbatas, tetapi ketersediaan dan hak penggunaan bervariasi. Kami menyediakan Text to Speech dengan suara AI stok dan fungsi kloning suara; periksa akun dan ketentuan kredit Anda saat ini sebelum memproduksi proyek komersial.
Bisakah saya menggunakan suara AI Ghostface di YouTube?
Anda dapat menggunakan suara AI yang terinspirasi horor orisinal selama naskah, audio, musik, dan visual Anda dilisensikan dengan benar dan penyajiannya tidak secara keliru menyiratkan keterlibatan Scream resmi. Peniruan yang dikenali dapat menciptakan risiko hak dan platform tambahan.
Dapatkah DubSmart AI menghasilkan suara Ghostface resmi?
Halaman Text to Speech publik kami tidak mengidentifikasi suara Ghostface resmi atau Roger L. Jackson. Gunakan layanan ini untuk membuat narasi horor orisinal atau kloning suara yang berizin alih-alih berasumsi bahwa label "Ghostface" generik adalah resmi.
Bisakah saya mengkloning suara Roger L. Jackson?
Tidak tanpa otorisasi eksplisit dari pemegang hak dan pengisi suara yang relevan. Replika realistis dari suara seseorang dapat memunculkan masalah hak publisitas dan replika digital, terutama dalam penggunaan komersial.
Apa yang membuat suara terdengar menyeramkan?
Tempo terkontrol, jeda yang bermakna, penekanan yang terkendali, pelafalan yang jelas, dan register yang tepat biasanya lebih penting daripada pergeseran nada yang ekstrem. Penampilan yang bersih dan dapat dipahami mengalahkan yang terdistorsi berat.