Transformer un script en narration YouTube signifiait autrefois un microphone, une pièce silencieuse et beaucoup de prises. Aujourd'hui, la synthèse vocale pour YouTube vous permet de coller un script, de choisir une voix et d'exporter une narration que vous pouvez intégrer dans une vidéo, un Short, un tutoriel ou une version traduite d'une vidéo que vous avez déjà publiée. La vraie décision n'est pas de savoir s'il faut ou non utiliser une voix synthétique. C'est de déterminer quelle méthode de production convient à la vidéo spécifique que vous avez devant vous : une voix IA standard, un clone personnalisé, un enregistrement humain, ou un mélange des trois.
Ce guide explique comment la technologie fonctionne réellement, quel flux de travail convient aux différents objectifs de chaîne, et ce qu'il faut vérifier concernant les droits et la divulgation avant de publier. C'est le point central de notre ensemble plus large d'explications sur la parole et la transcription, vous y trouverez donc des liens vers des analyses plus approfondies lorsqu'un sujet mérite sa propre page.
Table des matières
Ce que signifie réellement la synthèse vocale pour YouTube
La synthèse vocale pour YouTube consiste simplement à utiliser la technologie de synthèse vocale pour générer une narration destinée à du contenu YouTube. Vous fournissez un script, choisissez une voix et une langue, ajustez la manière dont elle doit être prononcée, et exportez un fichier audio à éditer ou à télécharger. En coulisses, un système de synthèse vocale convertit du texte, ou du langage de balisage de synthèse vocale (SSML), en données audio telles que de l'audio compatible MP3 ou WAV que vous pouvez ajouter à une vidéo et à d'autres médias.
Deux distinctions dissipent la plupart des confusions. Les sous-titres font le travail inverse de la synthèse vocale : les sous-titres transforment l'audio parlé en texte, tandis que la synthèse vocale transforme le texte écrit en audio parlé. Le doublage est encore plus large. La synthèse vocale part généralement d'un script écrit et produit une nouvelle piste vocale, tandis que le doublage traduit généralement une vidéo existante et fait correspondre la parole de remplacement au rythme et au sens originaux. Si ces frontières comptent pour votre flux de travail, notre explication sur les langues dans lesquelles l'IA peut doubler couvre en détail l'aspect localisation.
Comment le pipeline de synthèse transforme un script en voix
Un système de synthèse vocale combine quatre ingrédients : votre script, un modèle de voix sélectionné, les informations linguistiques et les contrôles de prononciation. À partir de ceux-ci, il suit une courte séquence qui explique pourquoi la même phrase peut sonner excellente ou maladroite selon la façon dont vous l'avez écrite.
Vient d'abord la saisie du texte, qui peut être un script YouTube complet, un plan développé en narration, une version traduite d'un script existant, ou des sous-titres transformés en voix off. La qualité de la saisie détermine la qualité du résultat. Les phrases longues, les abréviations non expliquées, les noms inhabituels et la ponctuation désordonnée peuvent faire sonner mal une voix pourtant performante. La solution consiste à écrire pour l'écoute plutôt que pour la lecture silencieuse : phrases plus courtes, transitions claires, pauses délibérées.
Ensuite, le moteur analyse le texte pour décider comment les mots doivent être prononcés et regroupés. Il lit les limites de phrases, la ponctuation et les pauses, les nombres et les dates, les abréviations, les noms et les indices de prononciation régionale. C'est pourquoi la ponctuation modifie la prononciation. Ajoutez une virgule, réécrivez un nombre en toutes lettres, ou épelez un acronyme, et la voix réagit.
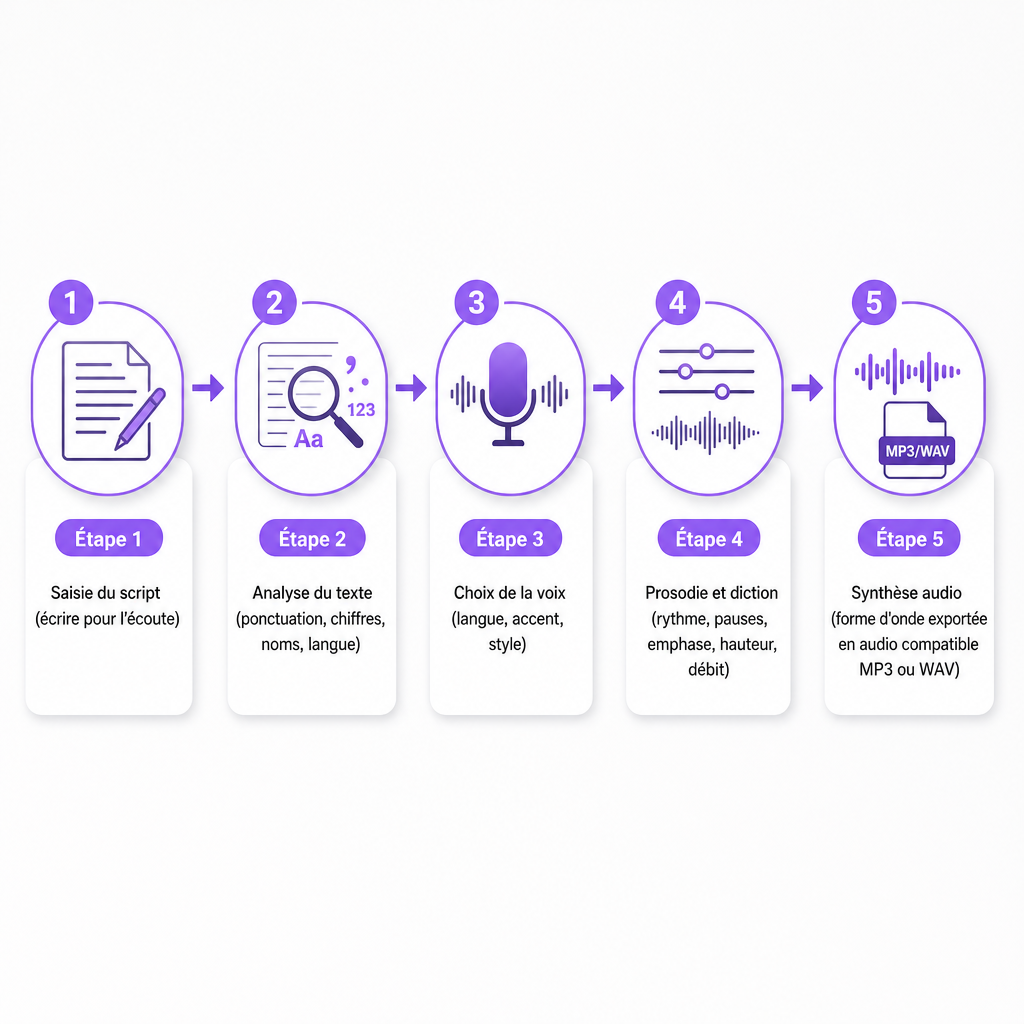
Ensuite, vous choisissez une voix. Les voix diffèrent par la langue, l'accent, l'âge ou le caractère vocal, la présentation du genre, le style de parole, l'énergie et la formalité. Les paramètres de sortie incluent souvent la vitesse d'élocution, la hauteur, le volume et le taux d'échantillonnage. Pour une chaîne, la cohérence l'emporte généralement sur le spectaculaire. Une voix reconnaissable utilisée à travers les vidéos rend la chaîne cohérente, ce qui compte plus que de choisir l'option la plus théâtrale pour une seule vidéo.
Le moteur génère ensuite la prosodie, c'est-à-dire le rythme, les pauses, l'accentuation, les mouvements de hauteur et l'intonation qui distinguent une parole expressive de mots espacés uniformément. Certains outils exposent ces contrôles directement ; d'autres les déduisent de la ponctuation, de la structure des phrases ou des instructions de style. C'est là qu'apparaissent la plupart des écarts de qualité. Une voix peut prononcer chaque mot correctement et sembler néanmoins fausse si le rythme ou le ton émotionnel entre en conflit avec la vidéo.
Enfin, le modèle synthétise l'audio, transformant le texte analysé en une forme d'onde que le service renvoie sous forme de fichier téléchargeable. Un flux de travail par API peut renvoyer des données audio encodées que vous décodez en un fichier lisible, tandis que les outils de création hébergés gèrent cette étape pour vous. Même alors, la narration n'est pas une vidéo finie. Vous devez encore la placer sur la timeline, couper les silences, ajouter de la musique et des effets, la faire correspondre aux visuels, équilibrer les niveaux, ajouter des sous-titres, et vérifier la prononciation et le rythme. Pour une vidéo explicative, la voix doit suivre la séquence visuelle ; une piste techniquement propre semble néanmoins bâclée si les images changent avant que la phrase correspondante ne commence. Si vous voulez le tableau neuronal complet, notre analyse de comment fonctionne la synthèse vocale neuronale approfondit les rouages internes du modèle.
Quatre méthodes de production, et quand chacune l'emporte
La plupart des narrations YouTube se résument à quatre options, et la bonne dépend de ce dont la vidéo a besoin plutôt que de celle qui semble la plus avancée dans un aperçu.
| Méthode | Idéale pour | Principal compromis |
|---|---|---|
| Voix IA standard | Chaînes sans visage, vidéos explicatives, tutoriels, récapitulatifs de style actualités, Shorts | Rapide et fiable, mais pas liée à une personne spécifique |
| Clone vocal personnalisé | Conserver une identité reconnaissable à travers de nombreuses vidéos | Nécessite une voix que vous êtes autorisé à reproduire |
| Synthèse vocale multilingue ou doublage | Vidéos explicatives traduites, vidéos produit localisées, tests de nouveaux marchés | Nécessite une révision de la prononciation et culturelle par langue |
| Voix off humaine | Jeu d'acteur nuancé, témoignage, formulations sensibles ou critiques pour la marque | Plus lente et plus difficile à mettre à l'échelle |
Une voix standard tirée de la bibliothèque d'un fournisseur est le chemin le plus rapide pour du contenu à fort volume où vous n'avez pas besoin que la narration ressemble à une personne en particulier. Le clonage vocal personnalisé construit une voix synthétique à partir d'un échantillon audio, ce qui aide un créateur à conserver une identité cohérente sans enregistrer chaque script à la main. N'utilisez le clonage qu'avec autorisation et avec une voix que vous avez le droit de reproduire ; un clone n'est pas un raccourci pour posséder l'identité ou la performance de quelqu'un. Notre outil de synthèse vocale vous donne accès à des voix IA et à des flux de travail de clonage, et notre page Clonage vocal est le point de départ lorsque vous souhaitez un narrateur personnalisé réutilisable plutôt qu'un narrateur standard.
La narration multilingue vous permet de traduire un script et de synthétiser une nouvelle piste vocale dans une autre langue, ce qui est utile pour développer une chaîne éducative à l'étranger, localiser des vidéos produit ou tester la demande sur un nouveau marché. La synthèse vocale commence par du texte ; notre flux de travail de doublage IA ajoute la couche de localisation plus large, y compris la traduction et l'audio de remplacement pour une vidéo existante dans 33 langues. Un narrateur humain l'emporte toujours lorsque la vidéo repose sur un jeu d'acteur nuancé, un témoignage personnel, des sujets sensibles, un humour complexe, des formulations juridiques ou critiques pour la marque, ou l'interprétation d'un interprète distinctif. De nombreuses chaînes fonctionnent en mode hybride : narration IA pour les brouillons, les versions et les téléchargements à fort volume, voix humaine pour les vidéos phares.
Quand la synthèse vocale mérite sa place sur une chaîne
La synthèse vocale pour YouTube est surtout rentable lorsque votre goulot d'étranglement est l'enregistrement, et non l'écriture. Si écrire un script est facile mais que réserver une session d'enregistrement est la partie lente, la narration synthétique élimine l'étape la plus lente.
Les vidéos éducatives et pédagogiques en bénéficient directement. Mettez à jour un script et régénérez uniquement la section concernée au lieu d'organiser un nouvel enregistrement, ce qui convient aux tutoriels logiciels, à l'intégration et au contenu de cours qui change souvent. Les chaînes sans visage peuvent narrer des vidéos construites à partir d'enregistrements d'écran, de séquences de stock, d'animation, de diapositives ou de visuels générés, bien que la voix nécessite toujours une direction éditoriale ; de l'audio déposé sur des séquences sans rapport érode la confiance des spectateurs. Les Shorts bénéficient d'une transformation rapide du script en audio, vous permettant de tester plusieurs accroches ou variations d'audience tant que la voix ne semble pas précipitée ou répétitive.
L'accessibilité est un autre usage honnête. Une version parlée du contenu écrit aide les spectateurs qui préfèrent l'audio ou qui ont du mal avec le texte à l'écran, mais la narration doit compléter des sous-titres précis et une conception visuelle claire plutôt que de les remplacer. Et pour l'expansion multilingue, vous pouvez produire des pistes vocales traduites sans exécuter un processus de production distinct par langue. La fonctionnalité Audio multilingue de YouTube permet aux créateurs éligibles d'attacher des pistes audio supplémentaires à une seule vidéo ou à un Short au lieu de gérer une chaîne distincte pour chaque marché.
Choisir et tester une voix avant de vous engager
Évaluez une voix par rapport aux exigences réelles de la vidéo, et non à un aperçu flatteur de dix secondes. Une voix qui réussit une seule ligne peut s'effondrer sur un script complet, alors mettez-la à l'épreuve d'abord.
- Adaptez la voix au format. Une prononciation calme convient à un documentaire ou à un tutoriel ; une voix plus énergique convient à une accroche de format court ou à une annonce. Laissez le sujet, le rythme et l'audience décider.
- Testez les mots difficiles. Avant de générer une vidéo complète, testez vos noms de marque récurrents, noms de lieux, acronymes, termes scientifiques, mots étrangers, unités et noms de personnes. Une voix qui gère des phrases ordinaires peut trébucher sur le vocabulaire de votre chaîne.
- Vérifiez la cohérence sur format long. Générez un échantillon plus long et écoutez s'il y a une intonation répétitive, des pauses incorrectes, un rythme non naturel, une prononciation changeante et des transitions abruptes entre les paragraphes.
- Tenez compte de l'audience régionale. Une narration en anglais peut nécessiter une prononciation américaine, britannique, australienne ou autre. Pour les autres langues, confirmez que la voix sonne naturellement à une oreille native, et pas seulement que l'outil liste la langue.
- Vérifiez les droits d'utilisation. Avant de monétiser ou de faire de la publicité, lisez les conditions du fournisseur et confirmez que la voix et le résultat sont autorisés pour du contenu YouTube commercial, du travail client, des publicités payantes et des versions dérivées.
Quelques habitudes d'écriture améliorent aussi rapidement la qualité. Écrivez pour la parole en remplaçant la prose dense par des phrases conversationnelles et en utilisant la ponctuation pour guider les pauses sans vous reposer dessus pour l'émotion. Épelez les termes ambigus afin que le moteur les lise correctement, en testant des variantes comme « IA » contre « I.A. » ou « 2026 » contre « deux mille vingt-six ». Générez par sections plutôt qu'en un seul fichier géant afin de pouvoir régénérer une seule erreur, réorganiser les scènes et faire correspondre l'audio aux visuels. Ajoutez ensuite une édition humaine : regardez la vidéo entière avec la piste en cours de lecture, coupez les pauses maladroites, corrigez le rythme et baissez la musique sous la parole. L'IA réduit le temps d'enregistrement ; elle ne supprime pas la révision éditoriale.
Droits, divulgation et téléchargement d'une piste audio dans une seconde langue
La partie que les créateurs sautent le plus souvent est aussi celle qui fait retirer les vidéos. Si vous créez une version linguistique distincte, vous pouvez la publier en tant que nouvelle vidéo ou utiliser la fonctionnalité Audio multilingue de YouTube lorsqu'elle est disponible, mais la plateforme ne crée pas ces pistes doublées pour vous. Les créateurs doivent préparer et télécharger leurs propres fichiers audio dans un format audio uniquement pris en charge, d'une durée à peu près identique à celle de la vidéo. YouTube peut également supprimer un fichier audio secondaire si son contenu protégé par le droit d'auteur diffère de l'original, ce qui rend la révision des droits essentielle lorsque votre piste doublée inclut de la musique, des clips ou d'autres éléments protégés.
La divulgation est une obligation distincte. YouTube exige des créateurs qu'ils divulguent le contenu généré ou modifié par l'IA qui semble réaliste, y compris le contenu qui fait apparaître une personne réelle en train de dire ou de faire quelque chose qu'elle n'a pas fait, modifie des séquences d'un événement ou d'un lieu réel, ou fabrique une scène réaliste. Notamment, YouTube cite le clonage de votre propre voix pour des voix off ou des doublages parmi les exemples qui ne nécessitent pas de divulgation en vertu de cette politique spécifique. Ce n'est pas une autorisation de cloner la voix de quelqu'un d'autre, et étiqueter du contenu synthétique n'autorise pas l'utilisation du visage ou de la voix d'une autre personne sans permission.
Une politique éditoriale sûre consiste à utiliser votre propre voix ou une voix sous licence, à conserver les enregistrements d'autorisation pour tous les échantillons de voix personnalisés, à éviter d'imiter une personne réelle sans autorisation, à vérifier les conditions d'utilisation commerciale, à divulguer le contenu synthétique ou modifié réaliste lorsque YouTube l'exige, et à examiner séparément les droits sur la musique, les séquences et l'audio traduit. Pour les équipes qui génèrent de la narration de façon répétée à partir d'un système de contenu ou d'une application, notre API de synthèse vocale est conçue pour la génération de parole programmatique afin que vous puissiez produire des pistes en volume sans reconstruire le flux de travail à chaque fois.
Alors, la synthèse vocale pour YouTube en vaut-elle la peine ? Elle convient parfaitement lorsque vous avez besoin d'une narration reproductible, de révisions rapides, de versions multilingues ou d'une voix off sans équipement d'enregistrement. Elle convient moins bien lorsque le succès de la vidéo repose sur un jeu d'acteur nuancé, un témoignage personnel ou une performance juridiquement sensible. Le critère qui compte n'est pas de savoir si les spectateurs peuvent détecter qu'une voix est synthétique. C'est de savoir si la narration est claire, appropriée, cohérente, juridiquement utilisable et bien intégrée à la vidéo.
Foire aux questions
Puis-je utiliser de l'audio de synthèse vocale sur YouTube ?
Oui. Vous pouvez utiliser une narration générée dans une vidéo YouTube tant que vous respectez les conditions de licence du fournisseur de synthèse vocale, les politiques de YouTube et les droits liés à votre script, votre musique, vos séquences et votre voix.
YouTube transforme-t-il automatiquement un script en narration ?
Non. La fonctionnalité Audio multilingue de YouTube ne crée pas vos pistes doublées pour vous. Les créateurs doivent préparer et télécharger leurs propres fichiers audio.
Quelle est la différence entre la synthèse vocale pour YouTube et le doublage automatique ?
La synthèse vocale convertit le texte écrit en audio parlé. Le doublage automatique est un processus de localisation plus large qui peut traduire et générer une piste de langue de remplacement pour du contenu existant. Les fonctionnalités exactes dépendent de la plateforme et du flux de travail.
Puis-je cloner ma voix pour des vidéos YouTube ?
Vous pouvez utiliser un clone vocal lorsque vous détenez le droit de le créer et de l'utiliser. YouTube cite le clonage de votre propre voix pour des voix off ou des doublages comme exemple qui ne nécessite pas de divulgation en vertu de sa politique sur le contenu réaliste, bien que d'autres contenus générés ou modifiés par l'IA puissent toujours nécessiter une divulgation.
Quel fichier audio dois-je télécharger pour une seconde langue ?
Pour la fonctionnalité Audio multilingue de YouTube, le fichier doit être dans un format audio uniquement pris en charge et d'une durée à peu près identique à celle de la vidéo. Vérifiez l'interface de téléchargement actuelle de YouTube Studio avant d'exporter.