Demandez comment fonctionne la synthèse vocale neuronale et la réponse courte est celle-ci : elle convertit du texte écrit en audio réaliste en faisant passer votre script à travers des réseaux de neurones profonds qui modélisent la façon dont les humains parlent réellement—prononciation, rythme et intonation réunis. Au lieu d'assembler des fragments préenregistrés comme le faisaient les anciens systèmes, la synthèse vocale neuronale génère la parole à partir de zéro, en apprenant des schémas directement à partir de vastes ensembles de données d'enregistrements humains réels associés à du texte. Cette distinction explique pourquoi les voix synthétiques modernes ressemblent à un narrateur que vous pourriez écouter pendant une vidéo entière plutôt qu'à une annonce robotique. Chez DubSmart AI, nous nous appuyons sur cette même approche neuronale pour alimenter notre synthèse vocale, en la reliant au clonage de voix et au doublage afin qu'un seul script puisse voyager d'une langue vers plusieurs.
Ce guide parcourt le mécanisme étape par étape, puis le traduit en décisions concrètes : où une voix neuronale est suffisamment solide pour se suffire à elle-même, où vous souhaitez encore une performance humaine, et comment les pièces s'assemblent au sein de notre plateforme.
Table des matières
Ce que signifie vraiment « comment fonctionne la synthèse vocale neuronale »
La synthèse vocale neuronale est une forme de synthèse de la parole qui utilise des réseaux de neurones profonds pour générer la parole à partir de zéro. La différence essentielle par rapport aux méthodes fondées sur des règles ou concaténatives est que le système apprend à partir de vastes ensembles de données d'enregistrements humains associés à du texte, de sorte qu'il peut prédire à la fois comment les mots devraient sonner et comment une personne les prononcerait naturellement. Ce comportement appris est ce qui capture la prosodie—l'accentuation, le rythme, les pauses et le ton émotionnel—rendant la voix résultante agréable au cours de longues sessions d'écoute. Les grands fournisseurs de cloud décrivent ces voix neuronales comme une parole synthétisée semblable à celle d'un humain dont l'articulation réduit la fatigue d'écoute dans les assistants, les outils d'accessibilité et les expériences de lecture à voix haute.
Notre moteur de synthèse vocale suit cette voie neuronale. Il analyse votre script, le décompose en phonèmes, déduit le rythme et l'intonation, puis utilise des modèles neuronaux pour produire un audio fluide au lieu de la diction plate associée aux anciennes technologies de synthèse vocale. Le résultat est une parole réaliste générée à partir de texte en quelques secondes, puisée dans une bibliothèque de plus de 300 voix adaptées à différents tons et cas d'usage.
Pourquoi la synthèse vocale neuronale compte pour les créateurs et les équipes
Pour les créateurs YouTube, les petites entreprises, les producteurs de formations en ligne, les cinéastes, les podcasteurs et les développeurs, la vraie question n'est pas seulement de savoir comment fonctionne la technologie, mais s'il faut s'y appuyer dans un pipeline de production. La synthèse vocale neuronale compte parce qu'elle fait sortir les voix synthétiques du territoire « utilitaire »—instructions GPS, invites basiques—pour les faire entrer dans le territoire de la performance : suffisamment bonnes pour porter du contenu de premier plan, narrer des cours entiers et véhiculer des messages de marque sans sonner ouvertement artificielles. Associez-la à la traduction et au doublage et elle devient un multiplicateur, permettant à un seul script d'atteindre des dizaines de langues pour une fraction du coût et du temps du travail de studio traditionnel.
Nous avons conçu DubSmart précisément autour de cette décision. La synthèse vocale, le clonage de voix, le doublage IA, la reconnaissance vocale, le séparateur de voix, le texte vers image et l'image vers vidéo s'inscrivent dans un même pipeline, de sorte que le contenu parlé passe de l'importation à l'export multilingue sans jongler entre des outils distincts. Vous choisissez le degré d'automatisation et de personnalisation à chaque étape—script, voix, langue, mixage—au sein d'un seul environnement.
Où cela s'applique dépend de ce que vous produisez :
- Étendre une chaîne YouTube à de nouvelles langues : la synthèse vocale neuronale plus le doublage vous permettent de réutiliser scripts et minutage tout en remplaçant par des voix localisées.
- Localiser des vidéos marketing ou de formation : vous obtenez une narration de marque cohérente à travers les langues sans engager de talents vocaux pour chaque mise à jour.
- Produire des formations en ligne ou des formations d'entreprise : la narration longue devient évolutive et facile à réviser lorsque le contenu change.
- Gérer un podcast ou un film indépendant : vous pouvez créer des versions multilingues, des inserts de narration ou des pistes d'accessibilité.
- Développer des applications : nos API transforment la parole neuronale en un service appelable pour les SVI, les agents et les outils de contenu.
Comprendre le mécanisme vous aide à juger où une voix neuronale peut se suffire à elle-même et où un enregistrement humain devrait rester la source pour le clonage ou le doublage.
Sous le capot : le pipeline de synthèse vocale neuronale
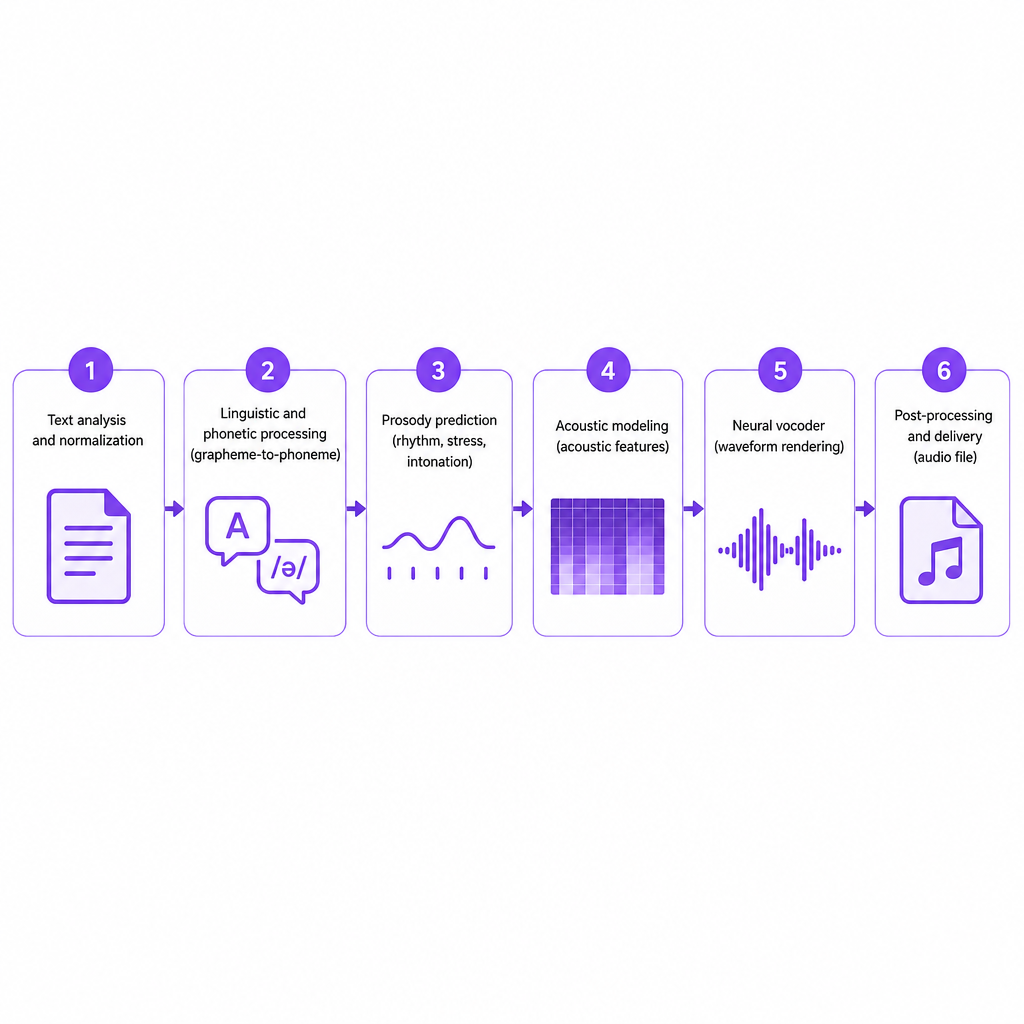
Les moteurs diffèrent dans le détail, mais ils partagent un pipeline globalement similaire décrit dans la documentation technique et les divulgations sur l'IA responsable des grands fournisseurs, et nos propres explications sur la façon dont les voix off IA sont créées s'y alignent.
Analyse et normalisation du texte
Le système ingère d'abord votre texte et le normalise en une forme prononçable. Cela signifie développer les nombres (« 2026 » devient « deux mille vingt-six »), les dates et les abréviations ; résoudre les jetons ambigus tels que « US » contre « us » selon le contexte ; et lire la ponctuation et la structure pour planifier les pauses et l'emphase. Notre moteur interprète la ponctuation et la structure pour déduire le rythme et le flux plutôt que de traiter le texte comme un flux de caractères plat. Cette étape a un réel poids pour les scripts plus longs—cours, tutoriels explicatifs, podcasts—où la structure des paragraphes et les titres façonnent la façon dont un humain lirait naturellement.
Traitement linguistique et phonétique
Le texte normalisé est converti en phonèmes, les unités sonores de base d'une langue. Un modèle graphème-vers-phonème associe les caractères aux sons, en gérant les règles de prononciation, les exceptions et les entrées multilingues. C'est ce qui permet à notre synthèse vocale d'accepter des scripts dans de nombreuses langues et de produire la séquence phonétique correcte pour celle qui est sélectionnée, que vous utilisiez une voix intégrée ou une voix clonée. Nos voix neuronales couvrent plus de 33 langues, dont l'anglais, le portugais, l'espagnol, le français, l'allemand, le chinois et le japonais.
Prédiction de la prosodie
La prosodie—rythme, accentuation et intonation—fait la différence entre une voix robotique et une performance semblable à celle d'un humain. Les modèles neuronaux apprennent les schémas prosodiques directement à partir des enregistrements, de sorte qu'ils peuvent décider où faire une pause et pour combien de temps, choisir quels mots portent l'emphase, et ajuster la hauteur et l'énergie à travers une phrase ou un paragraphe. Les voix neuronales haute définition vont plus loin, en détectant le sentiment dans le texte et en ajustant le ton tout en maintenant une personnalité stable, ce qui permet une diction conversationnelle ou empathique pour le contenu d'assistance et la narration. Notre moteur déduit la prosodie avant de synthétiser l'audio pour la même raison : éviter une diction plate et produire une parole que vous pourriez écouter pendant un module entier.
Modélisation acoustique
Une fois les phonèmes et la prosodie établis, un modèle acoustique neuronal convertit cette représentation en caractéristiques acoustiques—un plan pour l'onde sonore. Les divulgations sur l'IA responsable notent que, outre les enregistrements d'un talent vocal spécifique, ces modèles s'appuient également sur une bibliothèque source plus large de nombreux locuteurs. Ce mélange aide le réseau à apprendre des schémas de parole généraux tout en capturant le timbre, l'accent et le style d'une voix particulière. Dans notre plateforme, c'est cette modélisation qui permet à plus de 300 voix de sonner distinctes tout en restant naturelles, et elle sous-tend le clonage rapide de voix, où le système apprend la signature acoustique et prosodique d'une voix à partir d'un court échantillon.
Vocodeur et restitution audio
Les caractéristiques acoustiques passent à un vocodeur neuronal, qui les restitue en une forme d'onde audio complète. Les vocodeurs plus récents produisent une parole haute fidélité presque indiscernable des enregistrements en studio, avec des consonnes nettes, des voyelles fluides et un minimum d'artefacts. La combinaison d'un modèle acoustique neuronal et d'un vocodeur est la raison pour laquelle les voix neuronales sonnent bien plus naturelles que l'ancienne technologie utilisée dans les lecteurs d'écran traditionnels et les SVI. Nous utilisons des avancées similaires afin que l'audio généré soit prêt à publier directement ou à intégrer dans un mixage avec de la musique et des effets sonores.
Post-traitement et restitution
Enfin, le système peut appliquer un post-traitement—mise en forme du bruit, normalisation du volume ou conversion de format—avant de renvoyer le fichier audio. Pour les flux de travail via API, cela est encapsulé dans un point de terminaison RESTful qui accepte le texte et les paramètres de voix et renvoie un actif prêt à l'emploi. Notre synthèse vocale suit exactement ce flux : collez ou envoyez du texte, choisissez la langue et la voix, ajustez la diction là où des contrôles sont exposés, générez et téléchargez de l'audio au format standard. Le même moteur se trouve sous notre doublage IA, où la transcription, la traduction et la synthèse sont enchaînées pour créer des versions multilingues.
Options dans DubSmart : voix, clonage, doublage et API
Connaître les mécanismes explique pourquoi notre ensemble de fonctionnalités est construit comme il l'est.
Synthèse vocale pour la narration directe
Notre outil de synthèse vocale est l'interface centrale pour transformer des scripts en audio. Vous collez ou importez du texte dans n'importe quelle langue prise en charge, choisissez parmi les plus de 300 voix naturelles, définissez la langue et les contrôles de diction de base lorsqu'ils sont disponibles, et générez la parole en quelques secondes. Il couvre les accroches YouTube et la narration vidéo complète, les voix off explicatives et promotionnelles pour les petites entreprises, les modules de formation en ligne et de formation clairs, ainsi que les intros, outros et pauses publicitaires de podcasts. Si vous évaluez des outils pour ce travail, notre tour d'horizon des meilleurs logiciels de doublage IA pour les créateurs montre comment la narration et la localisation se connectent.
Clonage de voix : conserver la voix de votre marque ou de votre animateur
Le clonage de voix s'appuie sur les mêmes étapes neuronales—phonèmes, prosodie, caractéristiques acoustiques—mais optimise le réseau pour correspondre à un timbre et à un style spécifiques, afin que vous puissiez générer de nouvelles lignes dans cette voix sans réenregistrer. Notre clonage rapide de voix crée des voix personnalisées que vous pouvez utiliser dans la synthèse vocale ou le doublage IA, ce qui signifie que le contenu localisé sonne toujours comme votre animateur, votre narrateur ou votre marque. Cette continuité compte le plus pour les chaînes et les entreprises qui ont investi dans une identité vocale reconnaissable.
Doublage IA : enchaîner reconnaissance vocale, traduction et synthèse vocale
Le doublage IA utilise le moteur de synthèse vocale comme dernière étape d'une chaîne plus longue : transcrire l'audio existant, traduire la transcription, puis synthétiser une nouvelle parole dans la langue cible. Notre doublage IA maintient le doublage, la synthèse vocale, la reconnaissance vocale et le clonage au sein d'un seul flux de travail afin que le contenu passe de l'importation à l'export multilingue sans quitter la plateforme. En pratique, vous pouvez importer une vidéo ou un podcast, le faire transcrire et séparer de l'audio de fond, le traduire dans une ou plusieurs langues, puis générer des pistes doublées en utilisant des voix de stock ou clonées qui préservent le minutage et le ton. Pour une démonstration sur le contenu parlé, consultez notre guide sur comment traduire un podcast dans une autre langue.
API pour les développeurs et les agences
Nous exposons la synthèse vocale neuronale et le doublage via des API afin que les développeurs et les agences puissent intégrer la génération de voix dans leurs propres produits. Notre API de synthèse vocale est un service RESTful qui accepte une requête POST avec du contenu textuel et des préférences de voix et renvoie de l'audio de haute qualité, avec accès à des voix neuronales premium dans plus de 33 langues. L'API de doublage IA l'étend au doublage multilingue automatisé. Pour les agences qui gèrent la localisation à travers plusieurs clients, ces points de terminaison standardisent la génération de voix tout en personnalisant les langues et les personnalités par marque.
Critères de décision : bien choisir et utiliser la synthèse vocale neuronale
Une fois le mécanisme clair, le travail pratique consiste à décider quand et comment l'utiliser.
Naturel et confort d'écoute. Le test central est de savoir si la voix est suffisamment naturelle pour que votre public l'accepte comme narrateur principal. Les réseaux de neurones profonds et les voix HD sont conçus pour réduire la fatigue d'écoute, mais le bon choix dépend toujours du type de contenu. Utilisez notre grande bibliothèque de voix pour tester des personnalités—énergiques, calmes, ludiques, autoritaires—et pour les cours ou podcasts longs, privilégiez les voix dont la prosodie semble conversationnelle plutôt qu'annonciatrice.
Couverture linguistique et adéquation de l'accent. Pour une expansion multilingue, vous avez besoin à la fois de la langue et d'un accent approprié au public cible. Nos voix neuronales couvrent plus de 33 langues sur les principaux marchés. Lors du choix des pistes localisées, décidez si vous voulez un accent neutre ou spécifique à une région, et testez les échantillons avec des locuteurs natifs lorsque c'est possible.
Cohérence de marque contre flexibilité. Le clonage transporte une voix spécifique à travers les langues et les projets, mais il introduit des responsabilités en matière de consentement et de divulgation. Utilisez-le lorsqu'une personnalité cohérente est centrale pour votre marque, et documentez qui possède et contrôle cette voix—en particulier dans le travail d'entreprise ou d'agence.
Intégration au flux de travail. La synthèse vocale neuronale offre le plus de valeur lorsqu'elle s'insère dans votre façon de travailler actuelle. Comme nos outils combinent synthèse vocale, clonage, doublage, reconnaissance vocale et utilitaires multimédias, vous pouvez automatiser une grande partie de la chaîne de localisation tout en éditant les scripts et l'audio. Les créateurs solos peuvent trouver les outils navigateur suffisants ; les développeurs et les agences obtiennent des points de terminaison programmables pour passer à l'échelle.
Risques, limites et usage responsable
Même les modèles avancés ont des limites qu'il vaut la peine d'anticiper.
- Nuance émotionnelle : Les voix HD réagissent au sentiment, mais peuvent manquer des indices subtils ou des performances complexes qu'un acteur qualifié apporterait. Les messages de marque critiques ou le drame narratif peuvent encore justifier un enregistrement humain comme source.
- Cas limites de prononciation : Les noms rares, les termes nouveaux ou les scripts mêlant plusieurs langues peuvent mettre à l'épreuve les modèles graphème-vers-phonème, alors prévoyez des vérifications manuelles.
- Éthique du clonage : Les recommandations sur l'IA responsable soulignent que les voix personnalisées doivent être créées et utilisées avec un consentement explicite, des contrats clairs et une divulgation au public. Imiter des personnes sans autorisation soulève des préoccupations juridiques et éthiques.
- Biais et représentation : Les données d'entraînement façonnent la façon dont les voix gèrent les accents et les dialectes, alors vérifiez que les voix que vous choisissez représentent équitablement votre public et évitent de renforcer les stéréotypes.
Parce que notre flux de travail intégré facilite la génération et le déploiement de parole synthétique, la revue interne compte davantage, et non moins—en particulier lorsque vous manipulez les voix de clients ou d'employés. Un chemin concret aide : un créateur peut écrire un script en anglais, générer une voix off en anglais, puis doubler des versions en espagnol, en portugais et en allemand pour des chaînes supplémentaires tout en conservant le même minutage et la même diction. Une équipe de formation peut construire une narration modulaire et la régénérer rapidement chaque fois que les politiques changent. C'est là le véritable avantage de comprendre le pipeline—vous savez quelle étape contrôler et laquelle laisser au modèle.
Questions fréquentes
Qu'est-ce que la synthèse vocale neuronale en termes simples ?
La synthèse vocale neuronale est une IA qui transforme du texte écrit en parole à l'aide de réseaux de neurones profonds entraînés sur de vastes ensembles de données d'enregistrements humains, produisant des voix qui sonnent bien plus proches de vraies personnes que les anciens systèmes de synthèse vocale.
En quoi la synthèse vocale de DubSmart est-elle différente d'une synthèse vocale basique ?
Nous utilisons des modèles neuronaux qui analysent votre script, déduisent la prosodie et synthétisent la parole à partir de zéro, soutenus par plus de 300 voix naturelles et un clonage rapide de voix, de sorte que le résultat fonctionne comme un narrateur principal pour les vidéos, les cours et les podcasts.
DubSmart peut-il conserver ma propre voix dans d'autres langues ?
Oui. Notre clonage de voix peut apprendre votre voix à partir d'enregistrements, puis l'utiliser dans la synthèse vocale et le doublage IA, de sorte que les versions localisées de votre contenu sonnent toujours comme vous ou comme le narrateur de votre marque.
Comment le doublage IA fonctionne-t-il avec la synthèse vocale neuronale ?
Le doublage IA enchaîne la transcription par reconnaissance vocale, la traduction et la synthèse vocale neuronale, transformant votre audio existant en pistes doublées multilingues dans un seul flux de travail, en utilisant soit des voix de stock, soit votre voix clonée.
La synthèse vocale neuronale est-elle sûre et éthique à utiliser ?
Utilisée avec consentement, une divulgation claire et des garde-fous appropriés, la synthèse vocale neuronale est un outil puissant pour l'accessibilité et la localisation. Les recommandations sur l'IA responsable insistent sur le respect des droits des talents vocaux et sur l'évitement des usages trompeurs des voix synthétiques.